

Test Durbina-Watsona – wzór i przykład krok po kroku
Test Durbina-Watsona sprawdza, czy reszty modelu regresji z kolejnych pomiarów są ze sobą skorelowane (autokorelacja). Typowe pytanie z pracy dyplomowej: czy w danych zbieranych tydzień po tygodniu błędy modelu są od siebie niezależne?
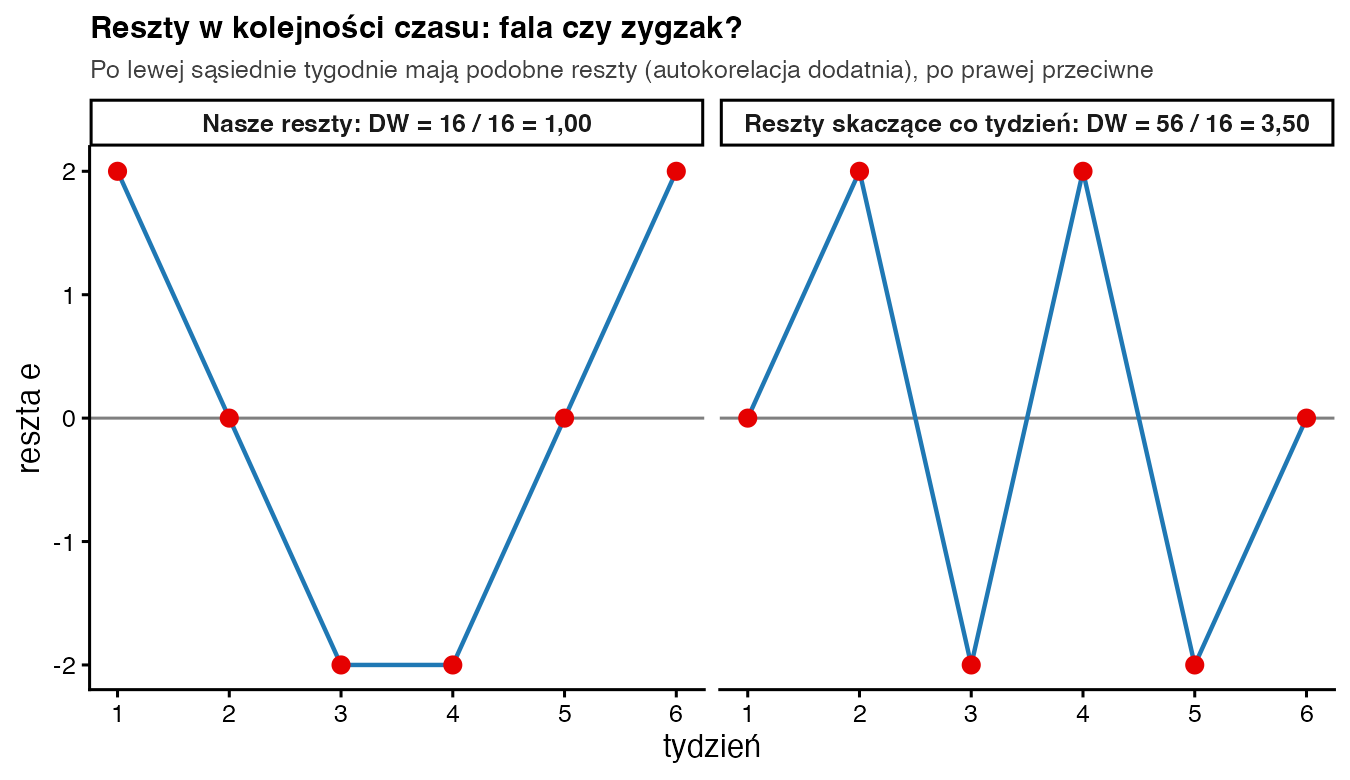
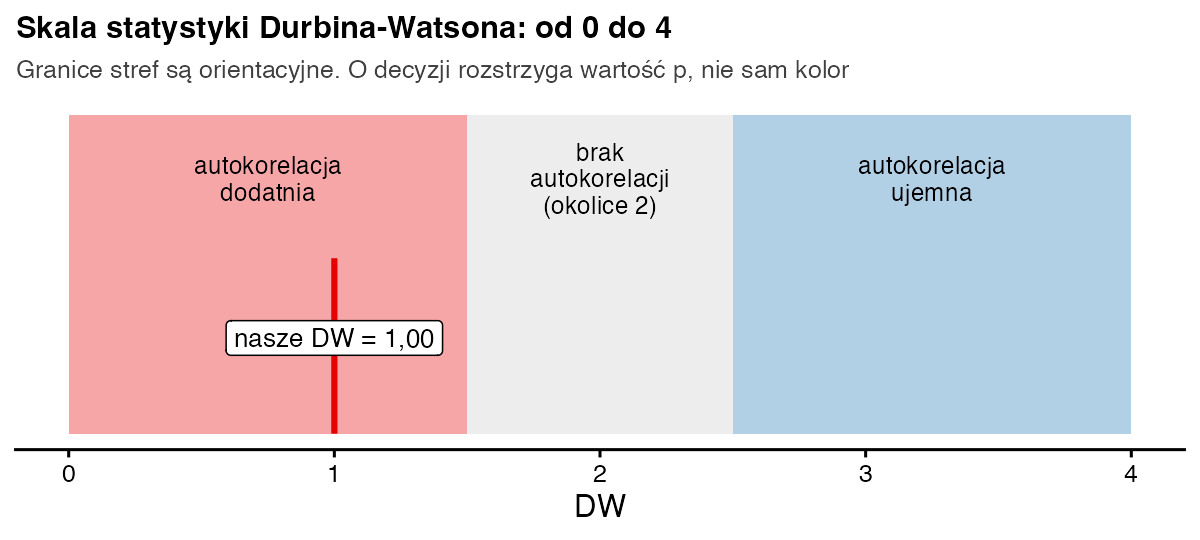
W prostych słowachRegresja zakłada, że pomyłka modelu w jednym tygodniu nic nie mówi o pomyłce w następnym. Jeśli jednak model kilka tygodni z rzędu zaniża wynik, a potem kilka tygodni z rzędu go zawyża, reszty układają się w falę. To autokorelacja dodatnia. Statystyka Durbina-Watsona porównuje, jak bardzo różnią się reszty sąsiednich pomiarów, z tym, jak duże są same reszty. Wartość około 2 oznacza brak autokorelacji, wartości bliżej 0 – falę, a bliżej 4 – zygzak.
Kiedy stosować test Durbina-Watsona?
- masz regresję liniową na danych uporządkowanych w czasie: kolejne dni, tygodnie, miesiące, lata;
- badasz jedną osobę, klasę lub firmę w wielu kolejnych pomiarach (szereg czasowy);
- kolejność wierszy w pliku ma znaczenie i nie jest przypadkowa;
- chcesz sprawdzić założenie o niezależności reszt.
Jeśli każdy wiersz to inna osoba z ankiety, a kolejność wierszy jest przypadkowa, test nie ma sensu – SPSS podaje go wtedy z przyzwyczajenia, a wynik zależy tylko od tego, jak posortowałeś plik. Gdy każdą osobę mierzysz kilka razy, zamiast regresji użyj ANOVA z powtarzanymi pomiarami albo modelu mieszanego. Sam model opisujemy w haśle o regresji liniowej, a drugie założenie o resztach – w haśle o homoskedastyczności i teście Breuscha-Pagana.
Wzór na statystykę Durbina-Watsona
- \(e_t\)
- reszta modelu w pomiarze numer t: prawdziwy wynik minus wynik przewidziany
- \(e_{t-1}\)
- reszta w pomiarze poprzednim (tydzień wcześniej)
- \(e_t - e_{t-1}\)
- o ile zmieniła się reszta między sąsiednimi pomiarami
- \(n\)
- liczba pomiarów; w liczniku jest n − 1 różnic, bo pierwszy pomiar nie ma poprzednika
- \(r_1\)
- autokorelacja reszt rzędu 1: korelacja każdej reszty z resztą poprzednią
- \(DW\)
- statystyka testu, zawsze między 0 a 4
Jak przeczytać wzór na głos: „suma kwadratów różnic między sąsiednimi resztami podzielona przez sumę kwadratów reszt”. Gdy sąsiednie reszty są podobne, różnice są małe i DW spada poniżej 2. Gdy reszty skaczą z plusa na minus, różnice są duże i DW rośnie powyżej 2.
Przykład krok po kroku
Przez 6 kolejnych tygodni zapisujesz swój wynik z cotygodniowej kartkówki (0–10 punktów). Regresja wyniku na numerze tygodnia daje trend ŷ = 2 + 1 · tydzień: co tydzień średnio punkt więcej.
| tydzień t | y | ŷ = 2 + t | e = y − ŷ | e² | et − et−1 | (et − et−1)² | et · et−1 |
|---|---|---|---|---|---|---|---|
| 1 | 5 | 2 + 1 = 3 | 5 − 3 = 2 | 4 | – | – | – |
| 2 | 4 | 2 + 2 = 4 | 4 − 4 = 0 | 0 | 0 − 2 = −2 | 4 | 0 · 2 = 0 |
| 3 | 3 | 2 + 3 = 5 | 3 − 5 = −2 | 4 | −2 − 0 = −2 | 4 | −2 · 0 = 0 |
| 4 | 4 | 2 + 4 = 6 | 4 − 6 = −2 | 4 | −2 − (−2) = 0 | 0 | (−2) · (−2) = 4 |
| 5 | 7 | 2 + 5 = 7 | 7 − 7 = 0 | 0 | 0 − (−2) = 2 | 4 | 0 · (−2) = 0 |
| 6 | 10 | 2 + 6 = 8 | 10 − 8 = 2 | 4 | 2 − 0 = 2 | 4 | 2 · 0 = 0 |
| Σ = 21 | Σ = 33 | Σ = 33 | 0 | 16 | – | 16 | 4 |
- Reszty. Odejmij przewidywanie od wyniku, np. w tygodniu 3: 3 − 5 = −2. Reszty to 2, 0, −2, −2, 0, 2: na początku i na końcu model zaniża wynik, w środku semestru go zawyża.
- Mianownik. Suma kwadratów reszt: 4 + 0 + 4 + 4 + 0 + 4 = 16.
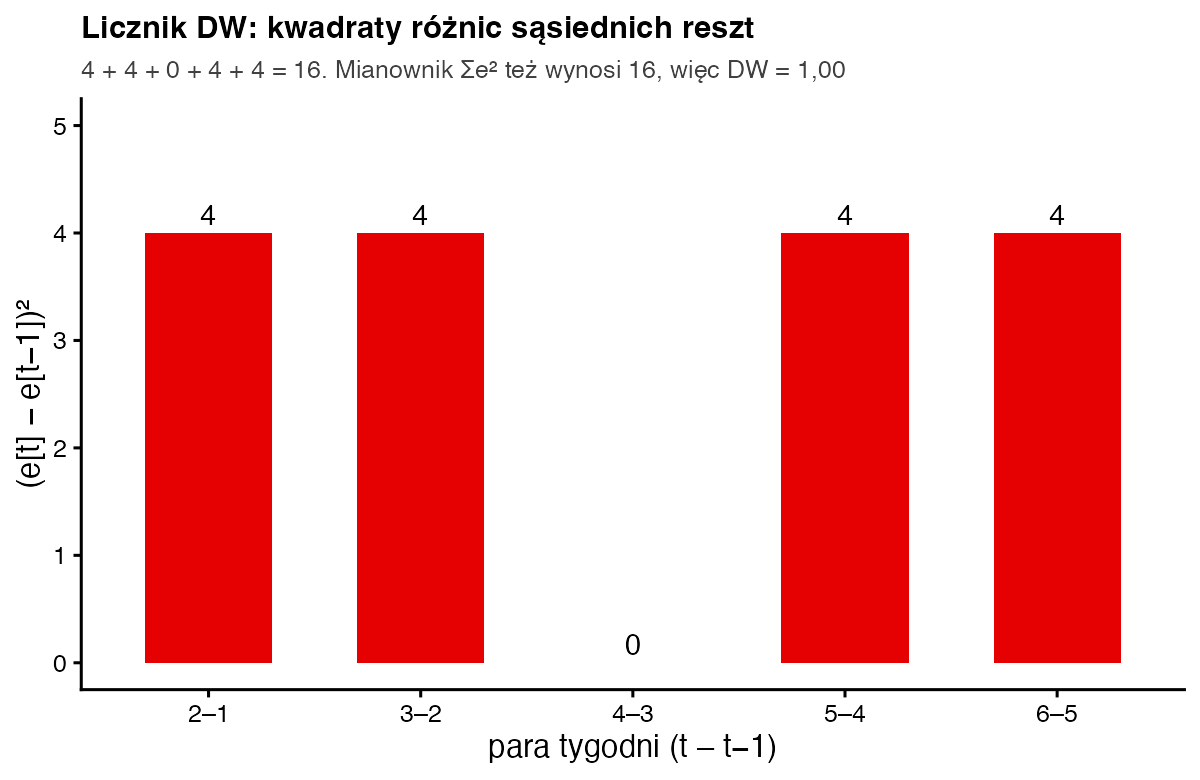
- Różnice sąsiadów. Od każdej reszty (od tygodnia 2) odejmij poprzednią, np. tydzień 5: 0 − (−2) = 2. Kwadraty różnic: 4, 4, 0, 4, 4.
- Licznik. 4 + 4 + 0 + 4 + 4 = 16.
- DW. DW = 16 / 16 = 1,00. To wyraźnie mniej niż 2, więc reszty sąsiednich tygodni są do siebie podobne.
- Kontrola przez autokorelację. r1 = Σ et · et−1 / Σ e² = 4 / 16 = 0,25. Wzór przybliżony daje 2 · (1 − 0,25) = 1,50. Różnica bierze się z pierwszej i ostatniej reszty, które mają tylko po jednym sąsiedzie. Dokładnie: DW = 1,50 − (2² + 2²) / 16 = 1,50 − 0,50 = 1,00. Przy małym n przybliżenie jest więc zgrubne.
- Wartość p. Hipoteza zerowa: brak autokorelacji. Klasyczne tablice Durbina-Watsona podają dla danego n i liczby predyktorów dwie granice, dolną dL i górną dU. Między nimi test jest nierozstrzygający. R oblicza p bezpośrednio dla Twoich danych:
lmtest::dwtest()daje p = 0,008 (test jednostronny, autokorelacja dodatnia). Przy sześciu pomiarach jest to przybliżenie i R o tym ostrzega.
Jak zinterpretować i opisać wynik?
DW = 1,00 i p = 0,008 oznaczają, że reszty sąsiednich tygodni są dodatnio skorelowane. Model z prostym trendem „nie widzi” spadku formy w środku semestru. Skutek praktyczny: błędy standardowe współczynników są zwykle zaniżone, a wartości p – zbyt optymistyczne. Nieistotny wynik nie dowodzi niezależności reszt, zwłaszcza przy kilku pomiarach.
Zapis w stylu APA: Test Durbina-Watsona wskazał na dodatnią autokorelację reszt, DW = 1,00; p = 0,008, co oznacza, że założenie o niezależności reszt nie zostało spełnione.
Jak policzyć test Durbina-Watsona w R?
tydzien <- 1:6
punkty  <- c(5, 4, 3, 4, 7, 10)   # wynik kartkówki w kolejnych tygodniach
model <- lm(punkty ~ tydzien)
e <- round(resid(model), 10)      # reszty: 2 0 -2 -2 0 2

# 1) „ręcznie”: DW = Σ(e_t − e_t−1)² / Σe_t²
licznik   <- sum(diff(e)^2)       # 16
mianownik <- sum(e^2)             # 16
c(licznik = licznik, mianownik = mianownik, DW = licznik / mianownik)

# 2) gotowa funkcja: H1 – autokorelacja dodatnia
lmtest::dwtest(model)
Wynik w konsoli R:
  licznik mianownik        DW
       16        16         1

	Durbin-Watson test

data:  model
DW = 1, p-value = 0.008258
alternative hypothesis: true autocorrelation is greater than 0

Warning message:
In lmtest::dwtest(model) :
  exact p value cannot be computed (not in [0,1]), approximate p value will be used
Ostrzeżenie na końcu znaczy, że dokładnego p nie dało się obliczyć dla tak krótkiego szeregu, więc R podał przybliżenie. Funkcja car::durbinWatsonTest() liczy p metodą bootstrapu, więc jej wynik może się nieco różnić przy każdym uruchomieniu.
Autokorelacja reszt – co zrobić?
Najpierw pomyśl, czego brakuje w modelu. Fala w resztach często znaczy, że pominąłeś zmienną zmieniającą się w czasie, np. liczbę innych egzaminów w danym tygodniu. Jeśli nie da się jej dodać, użyj modelu, który uwzględnia autokorelację błędów, np. nlme::gls() z correlation = corAR1(), albo błędów standardowych Neweya-Westa. Przy kilku osobach mierzonych wielokrotnie właściwy będzie model mieszany. Zwykła korelacja Pearsona dwóch szeregów czasowych też bywa myląca – oba mogą rosnąć tylko dlatego, że mija czas.
Najczęstsze błędy
- Raportowanie DW dla danych przekrojowych z ankiety, gdzie kolejność wierszy jest przypadkowa.
- Liczenie DW na danych posortowanych według zmiennej wyjaśnianej albo predyktora – wtedy test „wykryje” sztuczną autokorelację.
- Traktowanie reguły „1,5–2,5” jako testu istotności.
- Zapominanie, że DW sprawdza tylko zależność między sąsiednimi pomiarami (rząd 1). Zależność co 7 dni albo co miesiąc wymaga innego testu, np. Breuscha-Godfreya.
- Pisanie „reszty są niezależne”, gdy wynik jest tylko nieistotny – poprawnie: „brak podstaw do odrzucenia hipotezy o braku autokorelacji”.
Bibliografia
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409–428.
- Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression: II. Biometrika, 38(1/2), 159–178.
- Savin, N. E., & White, K. J. (1977). The Durbin-Watson test for serial correlation with extreme sample sizes or many regressors. Econometrica, 45(8), 1989–1996.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówHomoskedastyczność i test Breuscha-Pagana
- Słownik wzorówReszty standaryzowane
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.