

PLS-SEM czy CB-SEM – co wybrać do modelu równań strukturalnych?
PLS-SEM i CB-SEM to dwie rodziny metod szacowania modeli równań strukturalnych. Różnią się tym, czym jest dla nich konstrukt, co optymalizują i jakie wnioski pozwalają wyciągnąć. Typowe pytanie z artykułu lub doktoratu brzmi: mam trzy skale z ankiety i model ścieżkowy – którą metodę wybrać i jak uzasadnić ten wybór przed recenzentem?
W skrócieCB-SEM traktuje konstrukt jak czynnik wspólny, odtwarza macierz kowariancji i daje test dopasowania całego modelu – to narzędzie do sprawdzania teorii. PLS-SEM zastępuje konstrukt ważoną sumą pytań (kompozytem) i maksymalizuje wyjaśnioną wariancję – to narzędzie do predykcji i modeli z konstruktami formatywnymi. Wybór zależy od celu badania i natury konstruktów, a nie od tego, że „próba jest mała”. Na tych samych danych PLS daje wyższe ładunki i niższe ścieżki niż CB-SEM.
Czym różnią się PLS-SEM i CB-SEM?
W CB-SEM (ang. covariance-based) każdy konstrukt jest zmienną ukrytą, która „powoduje” odpowiedzi na pytania. To, czego pytania nie dzielą, trafia do błędu pomiaru. Metoda szuka takich parametrów, żeby macierz kowariancji odtworzona z modelu była jak najbliższa macierzy z danych. Stąd bierze się test χ² i wskaźniki dopasowania CFI, RMSEA i SRMR (Kline, 2016).
W PLS-SEM (ang. partial least squares) konstrukt jest ważoną sumą swoich pytań. Wagi dobiera algorytm tak, żeby kompozyty dobrze wyjaśniały konstrukty zależne. Kompozyt zawiera jednak część błędu pomiaru, dlatego przy skalach refleksyjnych ładunki są zawyżone, a ścieżki zaniżone (Sarstedt i in., 2016). Poprawką jest spójny PLS (PLSc; Dijkstra i Henseler, 2015), który przybliża wyniki do CB-SEM.
Tabela porównawcza: PLS-SEM a CB-SEM
| Kryterium | CB-SEM (lavaan, AMOS, Mplus) | PLS-SEM (seminr, cSEM, SmartPLS) |
|---|---|---|
| Cel badania | testowanie teorii: czy model jako całość zgadza się z danymi | predykcja i wyjaśnienie wariancji konstruktów zależnych, modele eksploracyjne |
| Wielkość próby | zależy od modelu; w symulacjach od ok. 30 do ponad 400 osób (Wolf i in., 2013) | liczy się stabilnie przy małej próbie, ale nie zwiększa mocy; minimalną próbę liczysz metodą odwrotnego pierwiastka (Kock i Hadaya, 2018) |
| Rozkłady | estymator ML zakłada wielowymiarową normalność; przy skośnych danych użyj MLR, przy pytaniach porządkowych – WLSMV | nie zakłada normalności; istotność ścieżek oceniasz bootstrapem |
| Model formatywny | możliwy, ale wymaga dodatkowych ograniczeń (np. model MIMIC) | naturalny – konstrukt jest kompozytem |
| Dopasowanie modelu | test χ² oraz CFI, TLI, RMSEA, SRMR | brak testu dopasowania w sensie CB-SEM; ocena przez R², f², AVE i rzetelność złożoną, HTMT i PLSpredict |
Krótka reguła: jeśli Twoje hipotezy dotyczą tego, czy teoria pasuje do danych, a skale są refleksyjne (pytania są wymiennymi przejawami tej samej cechy), wybierz CB-SEM. Jeśli celem jest przewidywanie wyniku albo model zawiera indeksy składane z różnych elementów, wybierz PLS-SEM – a przy skalach refleksyjnych w PLS-SEM użyj PLSc (Hair i in., 2019).
Ten sam model w obu metodach – przykład na danych CRUIZE
W zbiorze demonstracyjnym CRUIZE, na którym powstały przykładowe raporty SZTOS, 303 osoby oceniły autonomiczny samochód na trzech skalach po cztery pytania (odpowiedzi 1–5): łatwość korzystania (L), użyteczność (U) i intencję kupna (I). Model pochodzi z modelu akceptacji technologii (Davis, 1989): łatwość → użyteczność, użyteczność → intencja oraz ścieżka bezpośrednia łatwość → intencja. Ten sam model policzyliśmy w lavaan (CB-SEM) oraz w seminr jako zwykły PLS-SEM i jako PLSc.
| Wynik | CB-SEM (lavaan) | PLS-SEM (seminr) | PLSc (seminr) |
|---|---|---|---|
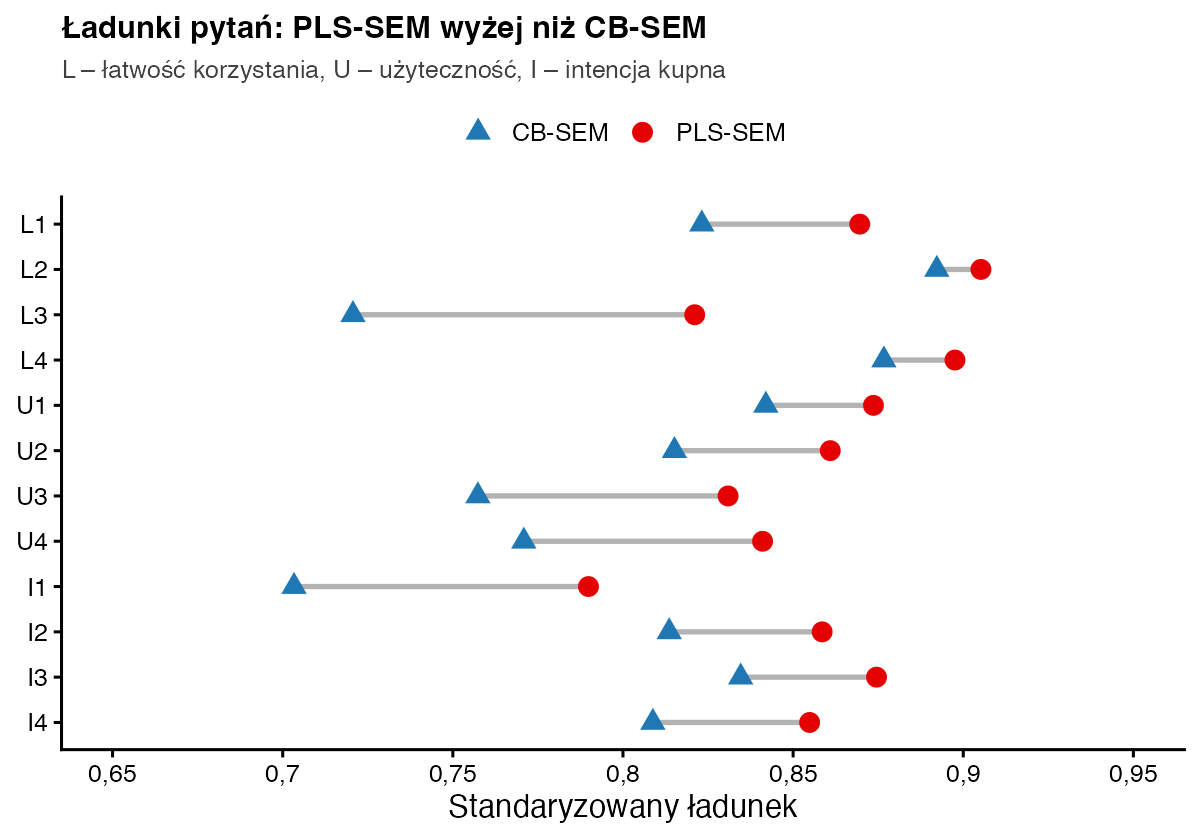
| Ładunki pytań | 0,70–0,89 | 0,79–0,91 | – |
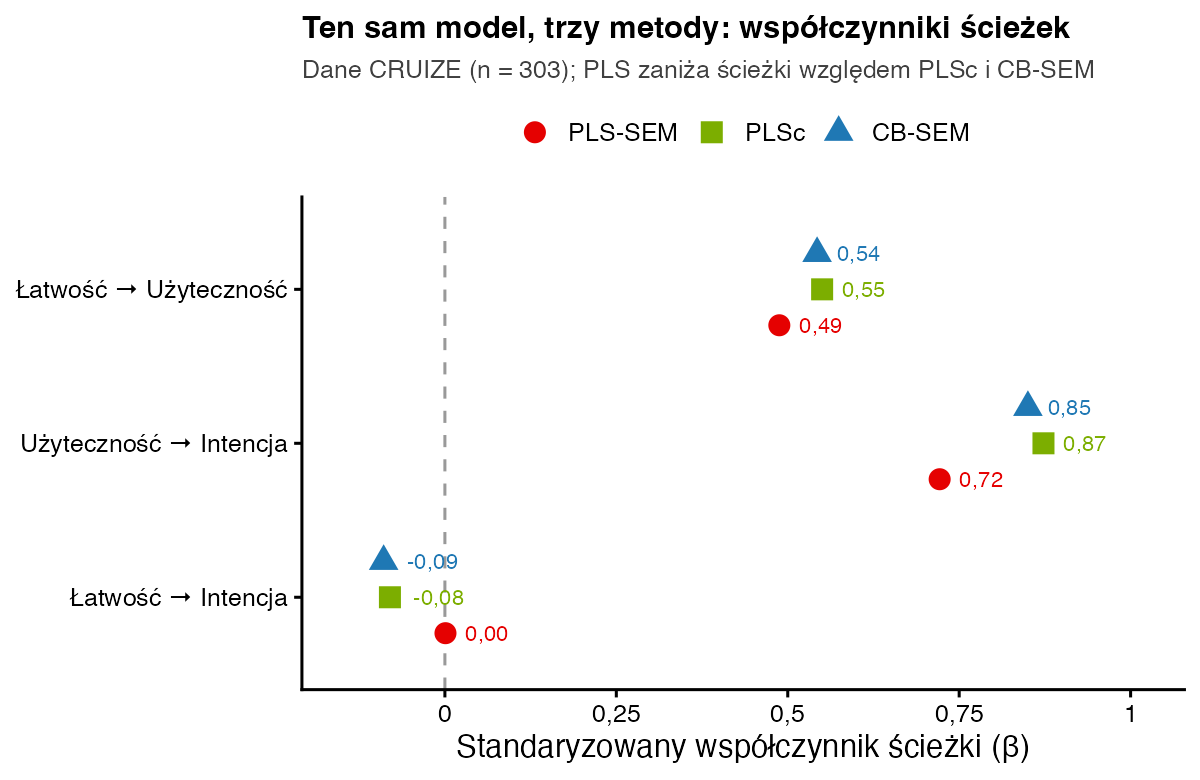
| Łatwość → użyteczność | 0,54 [0,45; 0,64] | 0,49 [0,38; 0,59] | 0,55 |
| Użyteczność → intencja | 0,85 [0,76; 0,94] | 0,72 [0,65; 0,79] | 0,87 |
| Łatwość → intencja | −0,09 [−0,20; 0,02] | 0,00 [−0,09; 0,09] | −0,08 |
| R² użyteczności / intencji | 0,29 / 0,65 | 0,24 / 0,52 | 0,30 / 0,69 |
| Dopasowanie | χ²(51) = 150,05; CFI = 0,957; RMSEA = 0,080; SRMR = 0,048 | nie dotyczy | nie dotyczy |
Wnioski merytoryczne są zgodne: łatwość korzystania wiąże się z użytecznością, użyteczność silnie wiąże się z intencją kupna, a ścieżka bezpośrednia od łatwości do intencji jest bliska zeru (w CB-SEM p = 0,124). Mamy więc obraz mediacji: efekt pośredni łatwość → użyteczność → intencja w PLS-SEM wynosi 0,35; 95% CI [0,27; 0,44]. Jak opisać taki efekt, pokazuje przykład analizy mediacji. Pamiętaj, że to dane przekrojowe – model opisuje związki, a nie dowodzi przyczynowości.
Różnią się wielkości. PLS-SEM daje ładunki wyższe o 0,01–0,10 i ścieżki niższe niż CB-SEM, a R² intencji spada z 0,65 do 0,52. PLSc prawie dokładnie odtwarza wyniki CB-SEM. To jest właśnie skutek traktowania kompozytu jak bezbłędnego pomiaru.
Co mówi dopasowanie CB-SEM, a czego nie powie PLS-SEM?
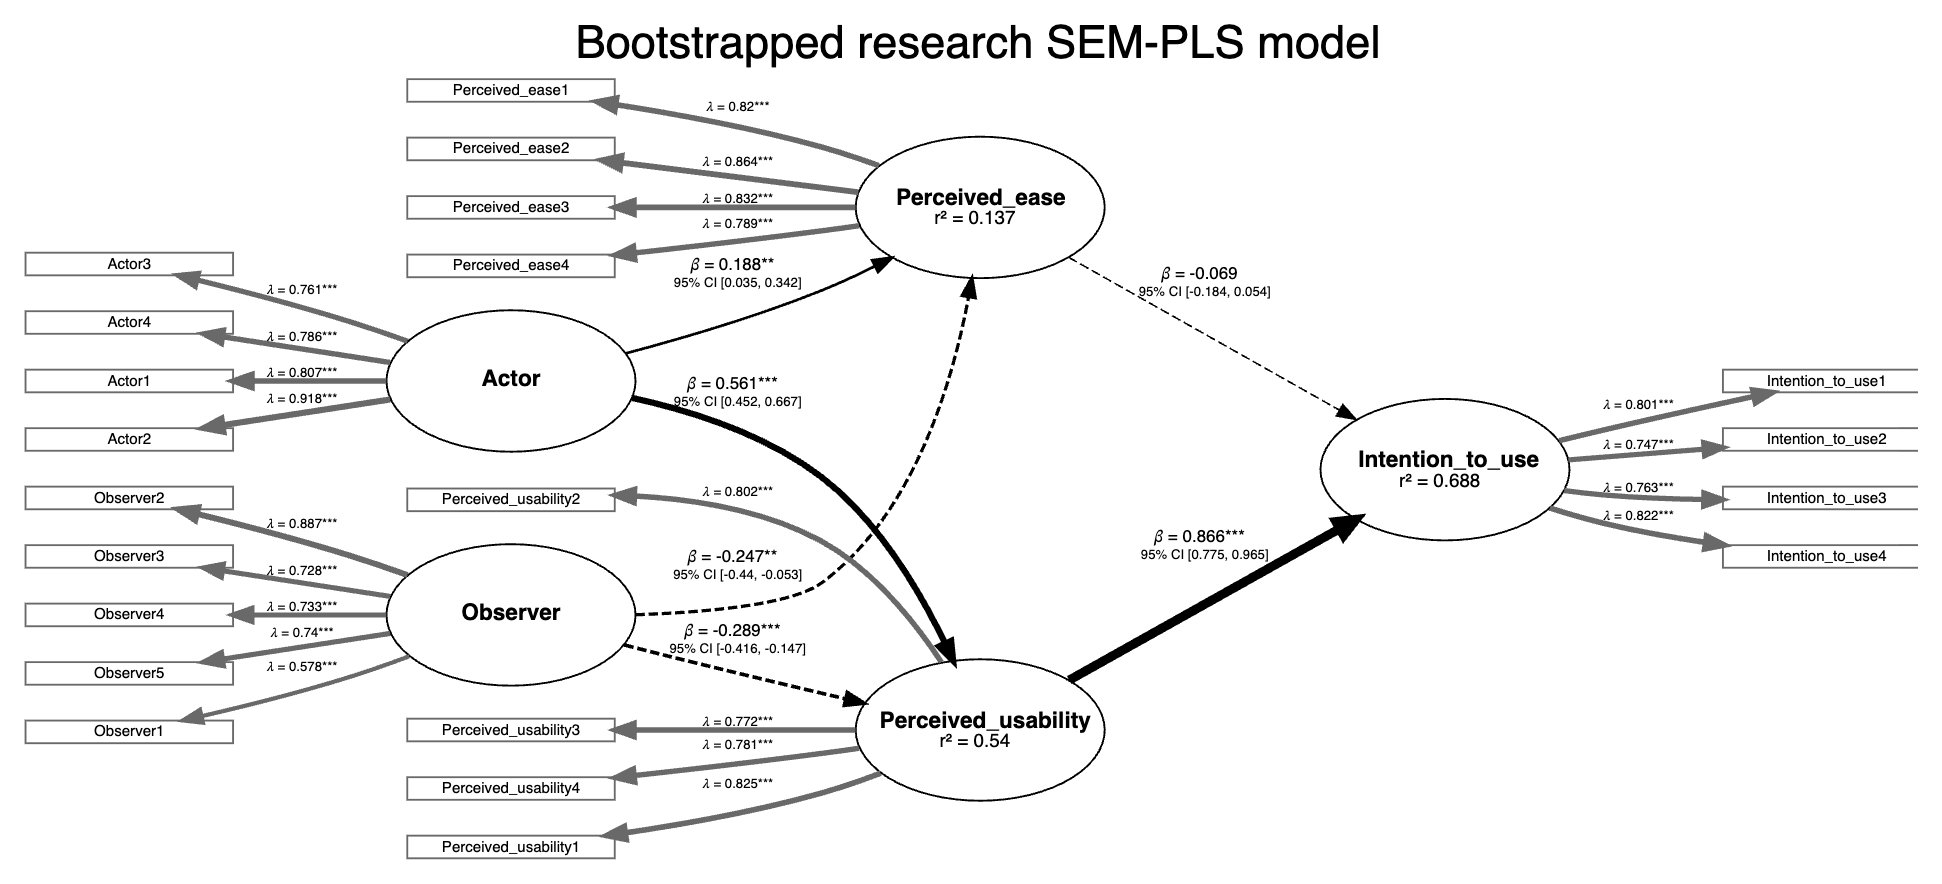
CFI = 0,957 i SRMR = 0,048 spełniają kryteria Hu i Bentlera (1999), ale RMSEA = 0,080; 90% CI [0,065; 0,095] przekracza ich próg 0,06. Dopasowanie jest więc umiarkowane i warto sprawdzić, które pary pytań mają duże reszty. Tę informację daje tylko CB-SEM. W PLS-SEM nie licz wskaźnika GoF – nie odróżnia on modeli dobrych od błędnych (Henseler i Sarstedt, 2013). Model pomiarowy w PLS-SEM oceniasz kryteriami opisanymi we wpisie PLS-SEM – ocena modelu krok po kroku. W naszym przykładzie AVE wynosi 0,71–0,76, ρC 0,91–0,93, a HTMT użyteczności i intencji 0,83 – blisko progu 0,85.
Jak uzasadnić wybór metody w artykule?
Przykładowy opis: Ponieważ celem badania było sprawdzenie, czy model akceptacji technologii pasuje do danych, a wszystkie skale były refleksyjne, model oszacowano metodą CB-SEM (lavaan, estymator ML, N = 303). Dopasowanie było umiarkowane, χ²(51) = 150,05; p < 0,001; CFI = 0,957; RMSEA = 0,080; 90% CI [0,065; 0,095]; SRMR = 0,048. Łatwość korzystania wiązała się z użytecznością, β = 0,54; 95% CI [0,45; 0,64], a użyteczność z intencją kupna, β = 0,85; 95% CI [0,76; 0,94]. Bezpośredni związek łatwości z intencją był nieistotny, β = −0,09; p = 0,124. Jako analizę odporności wyników powtórzono model metodą PLSc; ścieżki różniły się od CB-SEM o nie więcej niż 0,03.
Cała analiza w R
Kod liczy CB-SEM w pakiecie lavaan (Rosseel, 2012), a PLS-SEM i PLSc w pakiecie seminr (Hair i in., 2021). Plik z danymi umieść w folderze roboczym R.
library(readxl); library(lavaan); library(seminr)
d <- read_excel("Dane_CRUIZE_elegant.xlsx")                     # 303 osoby, odpowiedzi 1–5
x <- as.data.frame(d[, c(paste0("Łatwość_korzystania", 1:4), paste0("Użyteczność", 1:4),
                         paste0("Intencja_kupna", 1:4))])
names(x) <- c(paste0("L", 1:4), paste0("U", 1:4), paste0("I", 1:4))  # krótkie nazwy pytań

# 1) CB-SEM (lavaan): konstrukty jako czynniki wspólne, globalne dopasowanie
cb <- sem(' L =~ L1 + L2 + L3 + L4;  U =~ U1 + U2 + U3 + U4;  I =~ I1 + I2 + I3 + I4
            U ~ L;  I ~ U + L ', data = x)
round(fitMeasures(cb, c("chisq", "df", "cfi", "tli", "rmsea", "srmr")), 3)
st <- standardizedSolution(cb)
st[st$op == "~", c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
round(inspect(cb, "r2")[c("U", "I")], 2)

# 2) PLS-SEM (seminr): konstrukty jako ważone sumy pytań (kompozyty)
sm <- relationships(paths(from = "L", to = c("U", "I")), paths(from = "U", to = "I"))
mm <- constructs(composite("L", multi_items("L", 1:4)), composite("U", multi_items("U", 1:4)),
                 composite("I", multi_items("I", 1:4)))
pls <- estimate_pls(x, mm, sm)
s <- summary(pls)
round(unclass(s$reliability), 2)                                # alfa, rho_A, rho_C, AVE
b <- summary(bootstrap_model(pls, nboot = 10000, seed = 2026))  # 10 000 prób bootstrapowych
round(b$bootstrapped_paths[, c("Original Est.", "2.5% CI", "97.5% CI")], 2)
round(s$paths["R^2", ], 2)

# 3) PLSc (spójny PLS): te same skale potraktowane jako refleksyjne
mmc <- constructs(reflective("L", multi_items("L", 1:4)), reflective("U", multi_items("U", 1:4)),
                  reflective("I", multi_items("I", 1:4)))
round(summary(estimate_pls(x, mmc, sm))$paths, 2)
Wynik w konsoli R:
  chisq      df     cfi     tli   rmsea    srmr
150.051  51.000   0.957   0.944   0.080   0.048
   lhs rhs est.std ci.lower ci.upper
13   U   L   0.543    0.450    0.636
14   I   U   0.850    0.763    0.938
15   I   L  -0.089   -0.203    0.024
   U    I
0.29 0.65
Generating the seminr model
All 303 observations are valid.
  alpha rhoA rhoC  AVE
L  0.90 0.90 0.93 0.76
U  0.87 0.88 0.91 0.73
I  0.87 0.87 0.91 0.71
Bootstrapping model using seminr...
SEMinR Model successfully bootstrapped
         Original Est. 2.5% CI 97.5% CI
L  ->  U          0.49    0.38     0.59
L  ->  I          0.00   -0.09     0.09
U  ->  I          0.72    0.65     0.79
   U    I
0.24 0.52
Generating the seminr model
All 303 observations are valid.
           U      I
R^2    0.300  0.690
AdjR^2 0.300  0.690
L      0.550 -0.080
U          .  0.870
Checklista przed wyborem metody
- Zapisz cel: test teorii (CB-SEM) czy predykcja (PLS-SEM).
- Dla każdego konstruktu zdecyduj: refleksyjny czy formatywny.
- Policz minimalną próbę dla najmniejszej ścieżki, którą chcesz wykryć.
- Sprawdź rozkłady pytań i dobierz estymator (ML, MLR, WLSMV).
- Zaplanuj kontrolę wspólnej wariancji metody, jeśli wszystkie skale pochodzą z jednej ankiety.
- Zaplanuj analizę odporności: druga metoda albo PLSc.
Najczęstsze pytania
Czy mała próba uzasadnia wybór PLS-SEM?
Sama w sobie nie. PLS-SEM liczy się przy małej próbie bez błędów zbieżności, ale wyniki są wtedy mniej precyzyjne, a moc niska. Hair i in. (2019) wymieniają małą próbę jako jeden z powodów, ale nigdy jedyny. Minimalną próbę policz zawsze, niezależnie od metody.
Czy lavaan liczy PLS-SEM?
Nie. lavaan szacuje CB-SEM. PLS-SEM w R policzysz w pakietach seminr i cSEM, poza R – w SmartPLS.
Czy mogę najpierw zrobić CFA, a potem PLS-SEM?
Możesz, ale to dwie różne logiki pomiaru. Jeśli CFA (czyli CB-SEM bez ścieżek) dobrze pasuje, a skale są refleksyjne, naturalnym krokiem jest CB-SEM. Szczegóły o czynnikach znajdziesz w przykładzie analizy czynnikowej.
Recenzent pyta, dlaczego nie CB-SEM. Co odpisać?
Podaj cel badania, naturę konstruktów i – najlepiej – wyniki analizy odporności w drugiej metodzie, tak jak w Tabeli 2. Zgodność kierunków i istotności ścieżek w obu metodach jest najmocniejszym argumentem.
Najczęstsze błędy
- Wybór PLS-SEM tylko z powodu małej próby lub braku normalności.
- Raportowanie wskaźnika GoF jako miary dopasowania modelu PLS.
- Ocenianie konstruktów formatywnych alfą Cronbacha i AVE.
- Porównywanie ścieżek z PLS-SEM i CB-SEM bez świadomości, że PLS je zaniża.
- Interpretowanie ścieżek z danych przekrojowych jako dowodu przyczynowości.
Bibliografia
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/EBR-11-2018-0203
- Sarstedt, M., Hair, J. F., Ringle, C. M., Thiele, K. O., & Gudergan, S. P. (2016). Estimation issues with PLS and CBSEM: Where the bias lies! Journal of Business Research, 69(10), 3998–4010. https://doi.org/10.1016/j.jbusres.2016.06.007
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/MISQ/2015/39.2.02
- Henseler, J., & Sarstedt, M. (2013). Goodness-of-fit indices for partial least squares path modeling. Computational Statistics, 28(2), 565–580. https://doi.org/10.1007/s00180-012-0317-1
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. https://doi.org/10.1177/0013164413495237
- Kock, N., & Hadaya, P. (2018). Minimum sample size estimation in PLS-SEM: The inverse square root and gamma-exponential methods. Information Systems Journal, 28(1), 227–261. https://doi.org/10.1111/isj.12131
- Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. https://doi.org/10.2307/249008
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Hair, J. F., Jr., Hult, G. T. M., Ringle, C. M., Sarstedt, M., Danks, N. P., & Ray, S. (2021). Partial least squares structural equation modeling (PLS-SEM) using R: A workbook. Springer. https://doi.org/10.1007/978-3-030-80519-7
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikModelowanie PLS-SEM
- Słownik wzorówWskaźniki dopasowania CFA (CFI, RMSEA, SRMR)
- Słownik wzorówCR i AVE (Fornell-Larcker)
- Słownik wzorówHTMT – trafność różnicowa
- PoradnikAlfa Cronbacha – przykład
- Przykładowy raportPrzykładowy model SZTOS: PLS-SEM
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.