

Common method bias – jak sprawdzić i ograniczyć wspólną wariancję metody
Common method bias (błąd wspólnej metody) to zniekształcenie związków między zmiennymi, które wynika ze sposobu pomiaru, a nie z badanych zjawisk. Typowa sytuacja: wszystkie skale pochodzą z jednej ankiety wypełnionej przez tę samą osobę w jednym momencie, a recenzent pyta, czy korelacje nie są zawyżone.
W skrócieNajlepszą ochroną jest projekt badania: oddzielenie źródeł danych, czasu pomiaru i formatów pytań. Testy po fakcie są słabsze. Test jednego czynnika Harmana wykrywa tylko skrajny problem i niczego nie koryguje. Zmienna znacznikowa pozwala oszacować i odjąć wspólną wariancję, jeśli zaplanujesz ją przed zbieraniem danych. CFA z czynnikiem metody łatwo nadmiernie koryguje wyniki. Raportuj kilka metod naraz i opisz ich ograniczenia.
Skąd się bierze common method bias?
Gdy ta sama osoba ocenia na tej samej skali i predyktor, i wynik, część zgodności odpowiedzi wynika z jej stylu, a nie z treści pytań. Podsakoff i in. (2003) dzielą źródła tego błędu na cztery grupy. Po pierwsze, wspólny respondent: dążenie do spójności, aprobata społeczna, nastrój, skłonność do zgadzania się. Po drugie, cechy pytań: ta sama skala odpowiedzi, ten sam kierunek, niejasne sformułowania. Po trzecie, kontekst: kolejność i sąsiedztwo pytań. Po czwarte, jeden moment i jedno miejsce pomiaru.
Skutek nie zawsze polega na zawyżeniu. Wspólna wariancja zwykle zawyża korelacje dwóch zmiennych, ale w modelach z wieloma predyktorami może też zaniżać efekty, a efektów interakcji sama nie wytworzy – raczej je osłabia (Siemsen i in., 2010). Dlatego problem dotyczy także modeli SEM, w których wszystkie konstrukty pochodzą z jednej ankiety.
Zapobieganie w projekcie badania
| Źródło | Co zrobić w projekcie |
|---|---|
| Ten sam respondent ocenia predyktor i wynik | zmienną zależną weź z innego źródła: ocena przełożonego, dane z systemu, zachowanie |
| Jeden moment pomiaru | rozdziel pomiar w czasie (np. predyktory w tygodniu 1, wynik w tygodniu 3) |
| Ta sama skala odpowiedzi | zróżnicuj format: skala 1–5, 1–7, dyferencjał semantyczny, pytania o fakty |
| Aprobata społeczna, obawa przed oceną | zapewnij anonimowość i napisz, że nie ma dobrych i złych odpowiedzi |
| Niejasne pytania | krótkie, konkretne sformułowania, bez podwójnych pytań; pilotaż |
| Brak możliwości korekty po fakcie | dodaj zmienną znacznikową: pytanie w tym samym formacie, teoretycznie niezwiązane z modelem |
Przykład: dane CRUIZE
Sprawdzimy problem na zbiorze demonstracyjnym CRUIZE: 303 osoby oceniły autonomiczny samochód na trzech skalach po cztery pytania (odpowiedzi 1–5) – łatwość korzystania (L), użyteczność (U) i intencja kupna (I). To klasyczne ryzyko: jedno źródło, jeden moment, ta sama skala odpowiedzi.
Test jednego czynnika Harmana i jego słabości
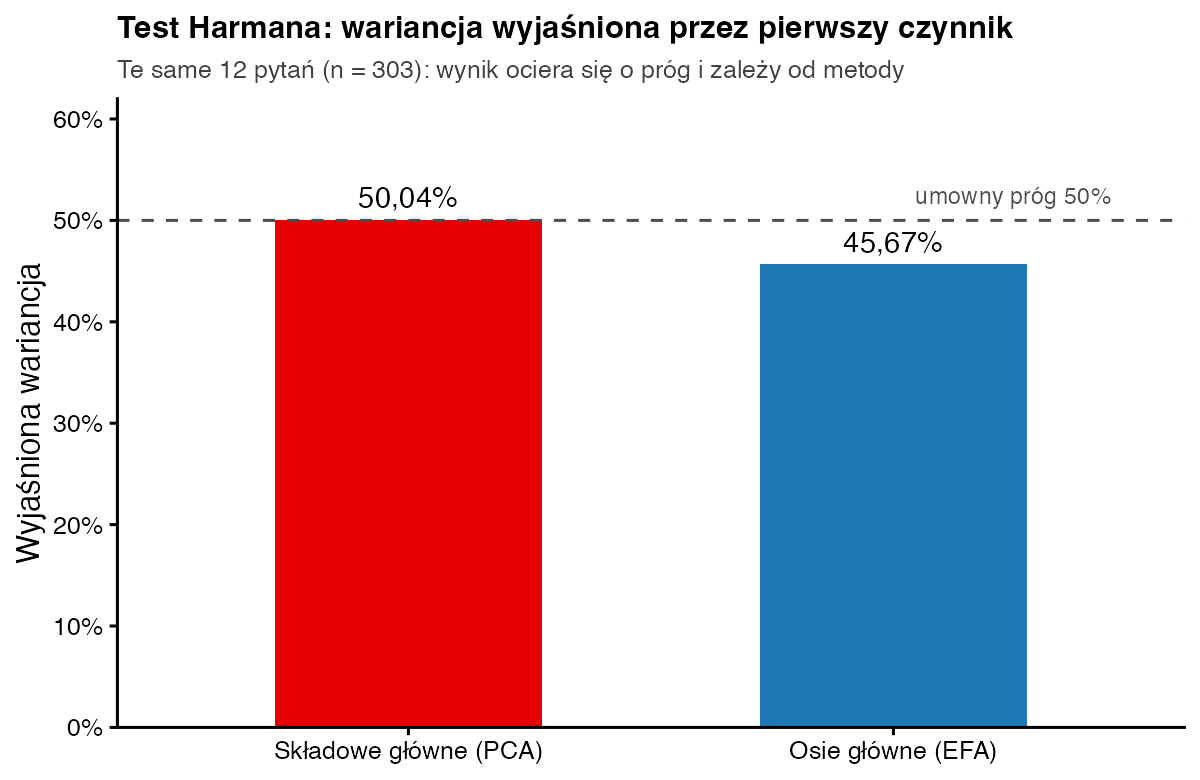
Procedura: wrzucasz wszystkie pytania do jednej analizy czynnikowej bez rotacji i sprawdzasz, ile wariancji wyjaśnia pierwszy czynnik. Jeśli powstaje jeden czynnik albo pierwszy wyjaśnia większość wspólnej zmienności, problem uznaje się za poważny (Podsakoff i Organ, 1986). W praktyce przyjął się umowny próg 50%. W CRUIZE pierwsza składowa główna wyjaśnia 50,04% wariancji, a pierwszy czynnik metodą osi głównych – 45,67%. Ten sam zbiór dostaje więc dwa różne werdykty zależnie od metody.
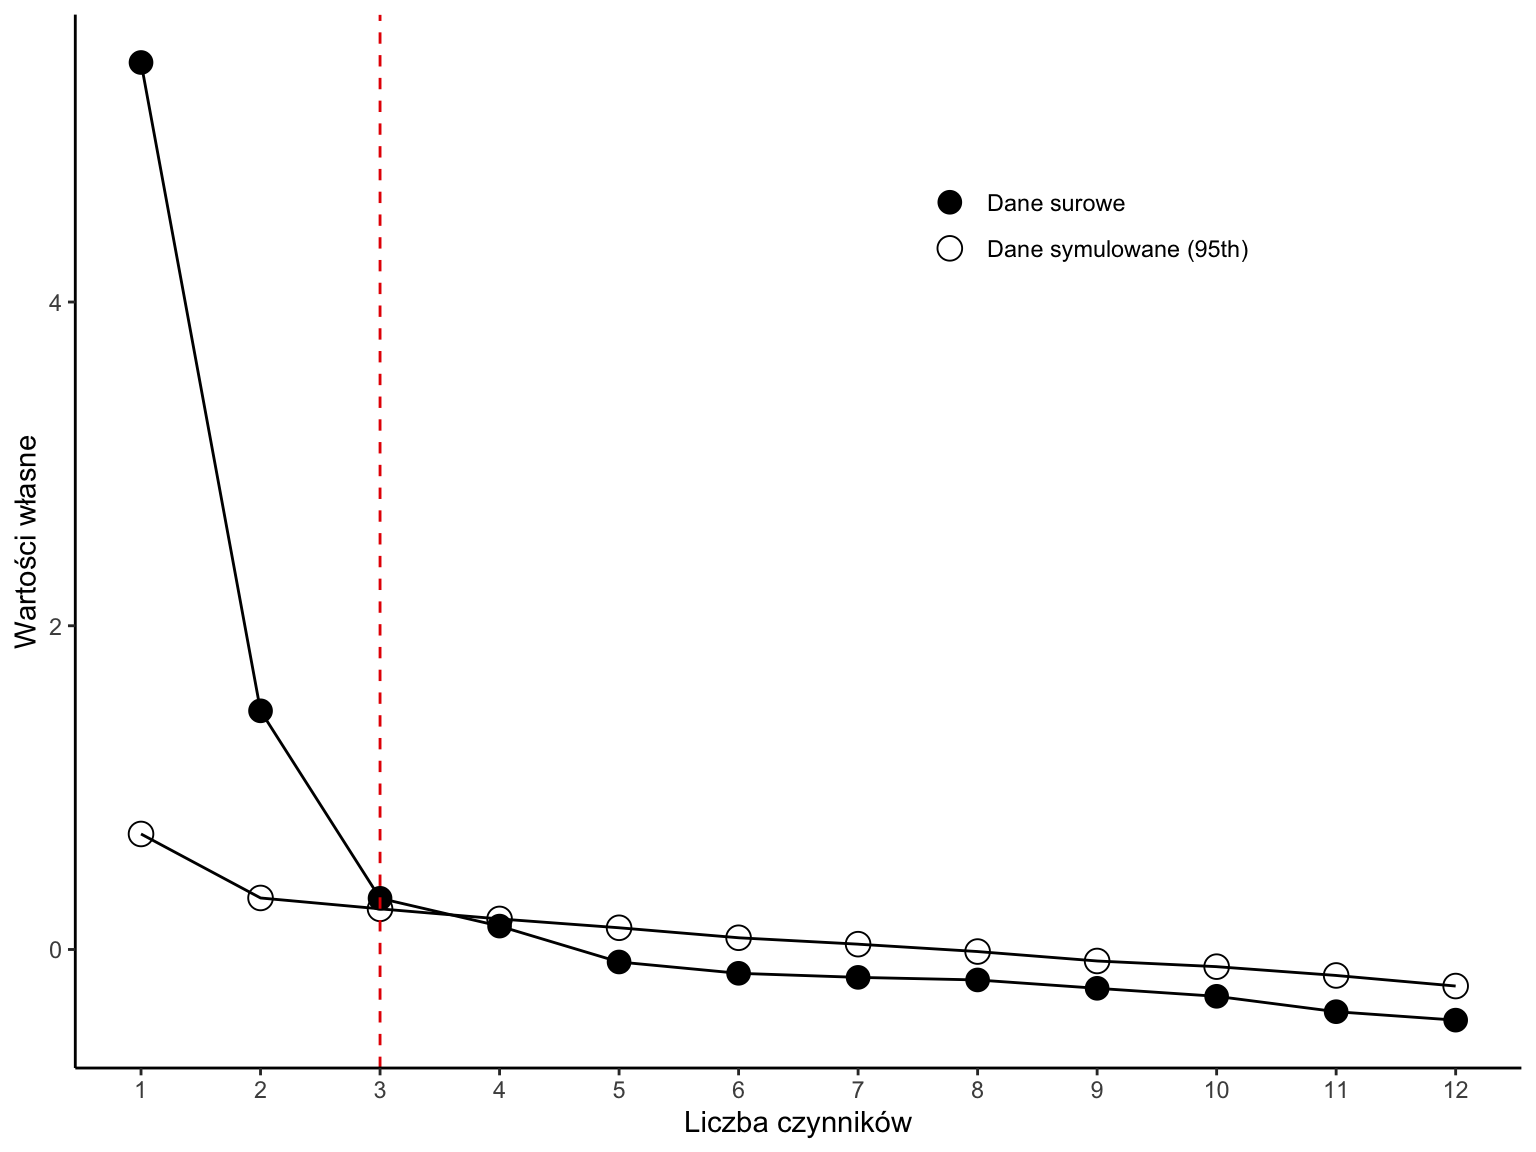
Słabości testu są dobrze opisane (Podsakoff i in., 2003). Wykrywa tylko sytuację, w której metoda dominuje nad treścią. Nie ma uzasadnionego progu. Rośnie razem z prawdziwymi korelacjami między konstruktami – a w modelu akceptacji technologii są one z założenia wysokie. Nie daje żadnej korekty. Na wykresie osypiska z SZTOS widać, że pierwsza wartość własna dominuje, ale analiza równoległa wskazuje trzy czynniki, czyli tyle, ile skal.
Wersja konfirmacyjna testu porównuje model z jednym czynnikiem z modelem trzech skal. Jeden czynnik pasuje źle: χ²(54) = 823,74; CFI = 0,666; RMSEA = 0,217. Model trzech skal: χ²(51) = 150,05; CFI = 0,957; RMSEA = 0,080; różnica Δχ²(3) = 673,69; p < 0,001. Znaczenie wskaźników dopasowania wyjaśniamy w słowniku. Wniosek jest ten sam: wykluczasz tylko skrajny przypadek.
Zmienna znacznikowa (marker variable)
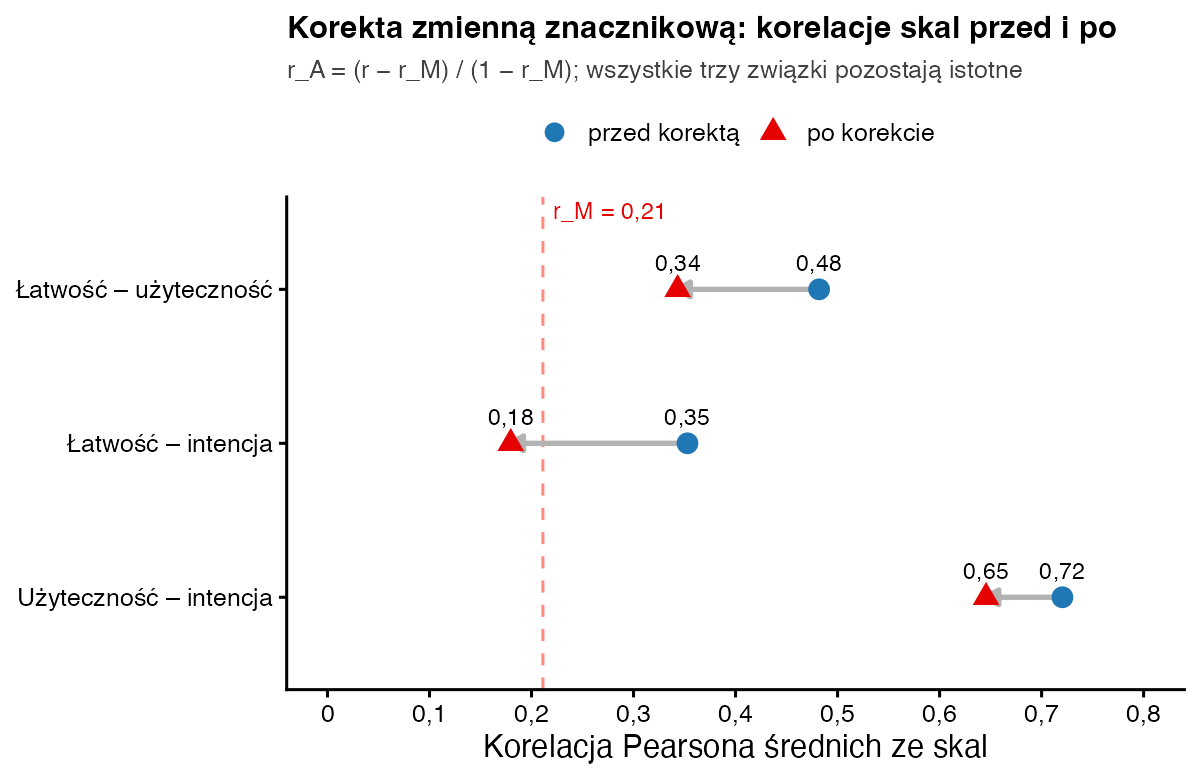
Lindell i Whitney (2001) proponują dodać pytanie, które ma ten sam format, ale teoretycznie nie wiąże się z badanymi konstruktami (np. ocena koloru tapety w ankiecie o pracy). Jego korelacja z pozostałymi zmiennymi, \( r_M \), szacuje wspólną wariancję metody. Skorygowana korelacja to \( r_A = (r - r_M)/(1 - r_M) \).
W CRUIZE nie zaplanowano znacznika, więc użyjemy wariantu awaryjnego tych samych autorów: najmniejszej korelacji między pytaniami, \( r_M \) = 0,21. To podejście ostrożne, bo ta korelacja zawiera też trochę prawdziwego związku. Po korekcie korelacje średnich ze skal spadają z 0,48 do 0,34 (L–U), z 0,35 do 0,18 (L–I) i z 0,72 do 0,65 (U–I). Wszystkie trzy pozostają istotne (p < 0,01). Wzór na istotność korelacji Pearsona stosujesz z n − 3 stopniami swobody.
CFA z czynnikiem metody
Do modelu trzech skal dodajesz czynnik M, który ładuje wszystkie 12 pytań i nie koreluje z konstruktami. Dopasowanie poprawia się: χ²(39) = 58,74; CFI = 0,991; RMSEA = 0,041; Δχ²(12) = 91,31; p < 0,001. Czynnik M wyjaśnia średnio 29% wariancji pytań. Ale korelacja łatwości z użytecznością spada z 0,54 do 0,20 i staje się nieistotna, a ładunek pytania U2 na własnej skali spada do 0,27. Czynnik metody „zjadł” część treści wspólnej dla powiązanych skal. Taki model prawie zawsze lepiej pasuje, więc poprawa dopasowania nie dowodzi błędu metody, a korekta bywa nadmierna (Richardson i in., 2009). Lepsza jest CFA ze zmierzonym znacznikiem (Williams i in., 2010).
Gotowe zdania do artykułu
Przykładowy opis: Ponieważ wszystkie zmienne pochodziły z jednej ankiety, oceniono ryzyko błędu wspólnej metody. Model jednoczynnikowy był wyraźnie gorzej dopasowany niż model trzech skal, Δχ²(3) = 673,69; p < 0,001. Po korekcie metodą zmiennej znacznikowej (Lindell i Whitney, 2001; rM = 0,21) wszystkie korelacje między skalami pozostały istotne (r od 0,18 do 0,65; p < 0,01). Wyniki wskazują, że wspólna metoda nie wyjaśnia obserwowanych związków, choć mogła je częściowo zawyżyć.
Więcej o odpowiadaniu na takie uwagi znajdziesz we wpisie jak odpowiedzieć na recenzję statystyczną.
Cała analiza w R
library(readxl); library(psych); library(lavaan)
d <- read_excel("Dane_CRUIZE_elegant.xlsx")                     # 303 osoby, odpowiedzi 1–5
x <- as.data.frame(d[, c(paste0("Łatwość_korzystania", 1:4), paste0("Użyteczność", 1:4),
                         paste0("Intencja_kupna", 1:4))])
names(x) <- c(paste0("L", 1:4), paste0("U", 1:4), paste0("I", 1:4))

# 1) Test jednego czynnika Harmana: ile wariancji wyjaśnia pierwszy czynnik bez rotacji?
round(eigen(cor(x))$values[1] / 12, 3)                          # składowe główne (PCA)
round(fa(x, nfactors = 1, fm = "pa", rotate = "none")$Vaccounted[2, 1], 3)  # osie główne

# 2) Wersja CFA: jeden wspólny czynnik a trzy konstrukty
trzy <- ' L =~ L1 + L2 + L3 + L4;  U =~ U1 + U2 + U3 + U4;  I =~ I1 + I2 + I3 + I4 '
m3 <- cfa(trzy, data = x)
m1 <- cfa(' G =~ L1 + L2 + L3 + L4 + U1 + U2 + U3 + U4 + I1 + I2 + I3 + I4 ', data = x)
miary <- c("chisq", "df", "cfi", "rmsea")
round(rbind(jeden = fitMeasures(m1, miary), trzy = fitMeasures(m3, miary)), 3)

# 3) Zmienna znacznikowa (Lindell i Whitney): r_M = najmniejsza korelacja między pytaniami
R <- cor(x); rM <- min(R[upper.tri(R)]); round(rM, 2)
sk <- data.frame(L = rowMeans(x[, 1:4]), U = rowMeans(x[, 5:8]), I = rowMeans(x[, 9:12]))
r <- cor(sk)[upper.tri(diag(3))]
rA <- (r - rM) / (1 - rM)                                       # korelacja skorygowana
t <- rA * sqrt((303 - 3) / (1 - rA^2))
data.frame(para = c("L-U", "L-I", "U-I"), r = round(r, 2), r_skor = round(rA, 2),
           p = signif(2 * pt(-abs(t), df = 300), 2))

# 4) CFA z niezmierzonym czynnikiem metody (M ładuje wszystkie pytania)
mM <- cfa(paste(trzy, '\n M =~ L1 + L2 + L3 + L4 + U1 + U2 + U3 + U4 + I1 + I2 + I3 + I4
                       M ~~ 0*L + 0*U + 0*I'), data = x)
round(fitMeasures(mM, miary), 3)
anova(m3, mM)                                                   # czy czynnik metody poprawia dopasowanie?
s <- standardizedSolution(mM)
round(mean(s$est.std[s$op == "=~" & s$lhs == "M"]^2), 2)        # średni udział wariancji metody
k <- c("L", "U", "I")                                           # korelacje konstruktów po dodaniu M
s[s$op == "~~" & s$lhs %in% k & s$rhs %in% k & s$lhs != s$rhs, c("lhs", "rhs", "est.std", "pvalue")]
Wynik w konsoli R:
[1] 0.5
[1] 0.457
        chisq df   cfi rmsea
jeden 823.744 54 0.666 0.217
trzy  150.051 51 0.957 0.080
[1] 0.21
  para    r r_skor       p
1  L-U 0.48   0.34 8.9e-10
2  L-I 0.35   0.18 1.7e-03
3  U-I 0.72   0.65 5.4e-37
 chisq     df    cfi  rmsea
58.745 39.000  0.991  0.041

Chi-Squared Difference Test

   Df    AIC    BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
mM 39 8437.2 8582.1  58.745
m3 51 8504.5 8604.8 150.051     91.307 0.14769      12  2.756e-14 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 0.29
   lhs rhs est.std pvalue
44   L   U   0.203  0.160
45   L   I   0.113  0.379
46   U   I   0.692  0.000
Checklista
- Przed badaniem: inne źródło lub inny termin pomiaru zmiennej zależnej.
- Różne formaty skal i anonimowość.
- Zaplanowana zmienna znacznikowa w tym samym formacie.
- Po badaniu: test Harmana tylko jako pierwszy krok, nie jedyny.
- Korekta znacznikiem lub CFA ze znacznikiem; opis ograniczeń.
Najczęstsze pytania
Czy test Harmana wystarczy recenzentowi?
Coraz rzadziej. Podsakoff i in. (2012) wprost odradzają opieranie się wyłącznie na nim. Pokaż go razem z opisem zabezpieczeń w projekcie i co najmniej jedną metodą z korektą.
Jak sprawdzić common method bias w PLS-SEM?
Popularna jest ocena pełnej współliniowości: dla każdego konstruktu liczysz VIF względem wszystkich pozostałych. Wartości powyżej 3,3 mogą sygnalizować problem (Kock, 2015). To również tylko sygnał ostrzegawczy.
Co, jeśli pierwszy czynnik wyjaśnia ponad 50%?
Nie oznacza to automatycznie błędu metody – przy silnie powiązanych konstruktach to normalne. Sprawdź analizę równoległą, model CFA i korektę znacznikiem.
Najczęstsze błędy
- Traktowanie wyniku testu Harmana poniżej 50% jako dowodu braku problemu.
- Szukanie zmiennej znacznikowej po zebraniu danych.
- Uznanie poprawy dopasowania po dodaniu czynnika metody za dowód błędu.
- Brak opisu zabezpieczeń w projekcie badania.
Bibliografia
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Podsakoff, P. M., MacKenzie, S. B., & Podsakoff, N. P. (2012). Sources of method bias in social science research and recommendations on how to control it. Annual Review of Psychology, 63, 539–569. https://doi.org/10.1146/annurev-psych-120710-100452
- Podsakoff, P. M., & Organ, D. W. (1986). Self-reports in organizational research: Problems and prospects. Journal of Management, 12(4), 531–544. https://doi.org/10.1177/014920638601200408
- Lindell, M. K., & Whitney, D. J. (2001). Accounting for common method variance in cross-sectional research designs. Journal of Applied Psychology, 86(1), 114–121. https://doi.org/10.1037/0021-9010.86.1.114
- Richardson, H. A., Simmering, M. J., & Sturman, M. C. (2009). A tale of three perspectives: Examining post hoc statistical techniques for detection and correction of common method variance. Organizational Research Methods, 12(4), 762–800. https://doi.org/10.1177/1094428109332834
- Williams, L. J., Hartman, N., & Cavazotte, F. (2010). Method variance and marker variables: A review and comprehensive CFA marker technique. Organizational Research Methods, 13(3), 477–514. https://doi.org/10.1177/1094428110366036
- Siemsen, E., Roth, A., & Oliveira, P. (2010). Common method bias in regression models with linear, quadratic, and interaction effects. Organizational Research Methods, 13(3), 456–476. https://doi.org/10.1177/1094428109351241
- Kock, N. (2015). Common method bias in PLS-SEM: A full collinearity assessment approach. International Journal of e-Collaboration, 11(4), 1–10. https://doi.org/10.4018/ijec.2015100101
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówWartość własna i kryterium Kaisera
- Słownik wzorówWskaźniki dopasowania CFA (CFI, RMSEA, SRMR)
- PoradnikJak odpowiedzieć na recenzję statystyczną
- PoradnikPLS-SEM czy CB-SEM – co wybrać?
- PoradnikSekcja „Analiza statystyczna” w artykule – jak napisać
- Przykładowy raportPrzykładowy model SZTOS: PLS-SEM
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.