

Wskaźniki dopasowania CFA: CFI, TLI, RMSEA, SRMR – wzory
Wskaźniki dopasowania mówią, jak dobrze model konfirmacyjnej analizy czynnikowej (CFA) odtwarza korelacje z Twoich danych. Typowe pytanie z pracy dyplomowej: czy kwestionariusz ma strukturę dwuczynnikową, jak zakłada autor, czy wystarczy jeden ogólny czynnik?
W prostych słowachModel CFA to przepis: które pytania należą do którego czynnika. Z tego przepisu da się odtworzyć korelacje między pytaniami. Wskaźniki dopasowania porównują korelacje odtworzone z prawdziwymi. CFI i TLI mówią, o ile Twój model jest lepszy od modelu, w którym nic z niczym nie koreluje. RMSEA mówi, jak duży błąd zostaje na jeden stopień swobody, a SRMR – jak bardzo przeciętnie różnią się korelacje.
Kiedy stosować wskaźniki dopasowania CFA?
- sprawdzasz strukturę gotowego kwestionariusza (np. polskiej adaptacji) metodą CFA;
- porównujesz konkurencyjne modele, np. jeden czynnik ogólny a dwa skorelowane czynniki;
- przed oceną CR i AVE albo trafności różnicowej – najpierw model musi być przyzwoicie dopasowany.
CFA różni się od eksploracyjnej analizy z rotacją czynników tym, że to Ty z góry ustalasz, które pozycje ładują który czynnik. Wszystkie wskaźniki opierają się na statystyce chi-kwadrat, więc przyda się hasło o rozkładzie chi-kwadrat. Gdy wahasz się między CFA a modelowaniem PLS, zajrzyj do wpisu PLS-SEM czy CB-SEM.
Wzory na CFI, TLI, RMSEA i SRMR
Na głos: „CFI to jeden minus nadwyżka chi-kwadratu nad stopniami swobody w naszym modelu, podzielona przez taką samą nadwyżkę w modelu niezależności; RMSEA to pierwiastek z tej nadwyżki podzielonej przez stopnie swobody i liczbę osób minus jeden; SRMR to pierwiastek ze średniego kwadratu różnicy między korelacjami z danych i z modelu”.
- \(\chi^2_M,\ df_M\)
- chi-kwadrat i stopnie swobody Twojego modelu; df to liczba korelacji i wariancji minus liczba szacowanych parametrów
- \(\chi^2_B,\ df_B\)
- to samo dla modelu niezależności (ang. baseline), w którym żadne pozycje nie korelują
- \(\chi^2 - df\)
- nadwyżka niedopasowania: przy idealnym modelu χ² wynosi średnio tyle, ile df, więc liczy się tylko to, co ponad df
- \(\max(\cdot,\ 0)\)
- „weź większą z liczb”: ujemną nadwyżkę zastępujemy zerem
- \(N\)
- liczba osób (lavaan dzieli przez N zamiast N − 1; różnica pojawia się zwykle dopiero w czwartym miejscu po przecinku)
- \(r_{ij},\ \hat{r}_{ij}\)
- korelacja pozycji i oraz j w danych i odtworzona z modelu
- \(p(p+1)/2\)
- liczba niepowtarzających się elementów macierzy korelacji razem z przekątną; dla 6 pozycji 6 · 7 / 2 = 21
Przykład krok po kroku
Dwieście osób wypełniło sześć pozycji: S1–S3 o stresie przed sesją i M1–M3 o motywacji do nauki (ta sama macierz korelacji co w hasłach o ładunkach czynnikowych i rotacji). Sprawdzamy model jednoczynnikowy: jeden ogólny czynnik dla wszystkich pytań. Lavaan podał: χ²(9) = 68,626; dla modelu niezależności χ²(15) = 246,118.
| para | r w danych | r̂ = λᵢ · λⱼ | reszta r − r̂ | reszta² |
|---|---|---|---|---|
| S1–S2 | 0,56 | 0,530 | 0,030 | 0,0009 |
| S1–S3 | 0,48 | 0,456 | 0,024 | 0,0006 |
| S1–M1 | −0,26 | −0,309 | 0,049 | 0,0024 |
| S1–M2 | −0,19 | −0,249 | 0,059 | 0,0035 |
| S1–M3 | −0,16 | −0,214 | 0,054 | 0,0030 |
| S2–S3 | 0,42 | 0,411 | 0,009 | 0,0001 |
| S2–M1 | −0,22 | −0,278 | 0,058 | 0,0034 |
| S2–M2 | −0,17 | −0,225 | 0,055 | 0,0030 |
| S2–M3 | −0,14 | −0,193 | 0,053 | 0,0028 |
| S3–M1 | −0,19 | −0,239 | 0,049 | 0,0024 |
| S3–M2 | −0,14 | −0,193 | 0,053 | 0,0028 |
| S3–M3 | −0,12 | −0,166 | 0,046 | 0,0021 |
| M1–M2 | 0,48 | 0,131 | 0,349 | 0,1219 |
| M1–M3 | 0,40 | 0,113 | 0,287 | 0,0826 |
| M2–M3 | 0,30 | 0,091 | 0,209 | 0,0438 |
| 6 przekątnych | 1 | 1 | 0 | 0 |
| suma (21 elementów) | 0,2753 |
- Korelacje odtworzone. W modelu jednoczynnikowym r̂ to iloczyn ładunków, np. S1–S2: 0,767 · 0,691 = 0,530, a M1–M2: (−0,403) · (−0,325) = 0,131. Reszta to różnica: 0,56 − 0,530 = 0,030 oraz 0,48 − 0,131 = 0,349.
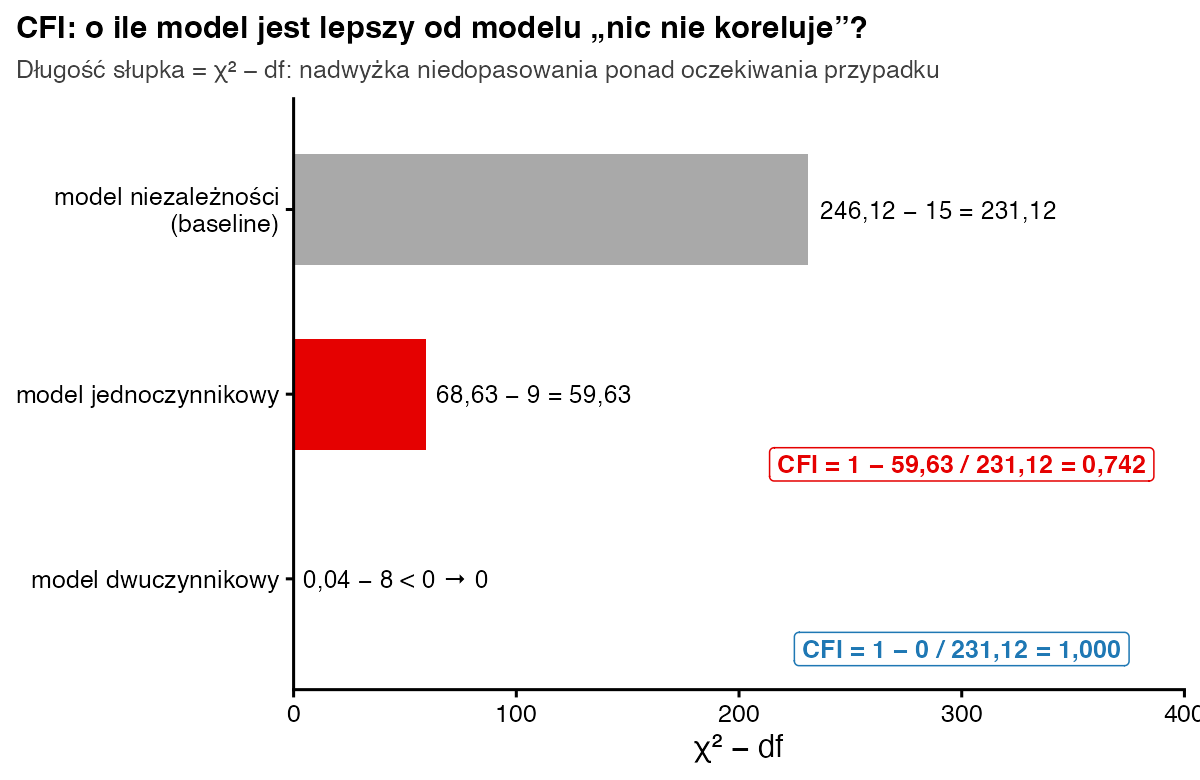
- Nadwyżka modelu. 68,626 − 9 = 59,626.
- Nadwyżka modelu niezależności. 246,118 − 15 = 231,118.
- CFI. 59,626 / 231,118 = 0,258. CFI = 1 − 0,258 = 0,742. Nasz model usuwa tylko 74% niedopasowania modelu „nic nie koreluje”.
- TLI. 246,118 / 15 = 16,408 i 68,626 / 9 = 7,625. Licznik: 16,408 − 7,625 = 8,783. Mianownik: 16,408 − 1 = 15,408. TLI = 8,783 / 15,408 = 0,570.
- RMSEA. Mianownik: 9 · (200 − 1) = 9 · 199 = 1791. Iloraz: 59,626 / 1791 = 0,0333. Pierwiastek: √0,0333 = 0,182.
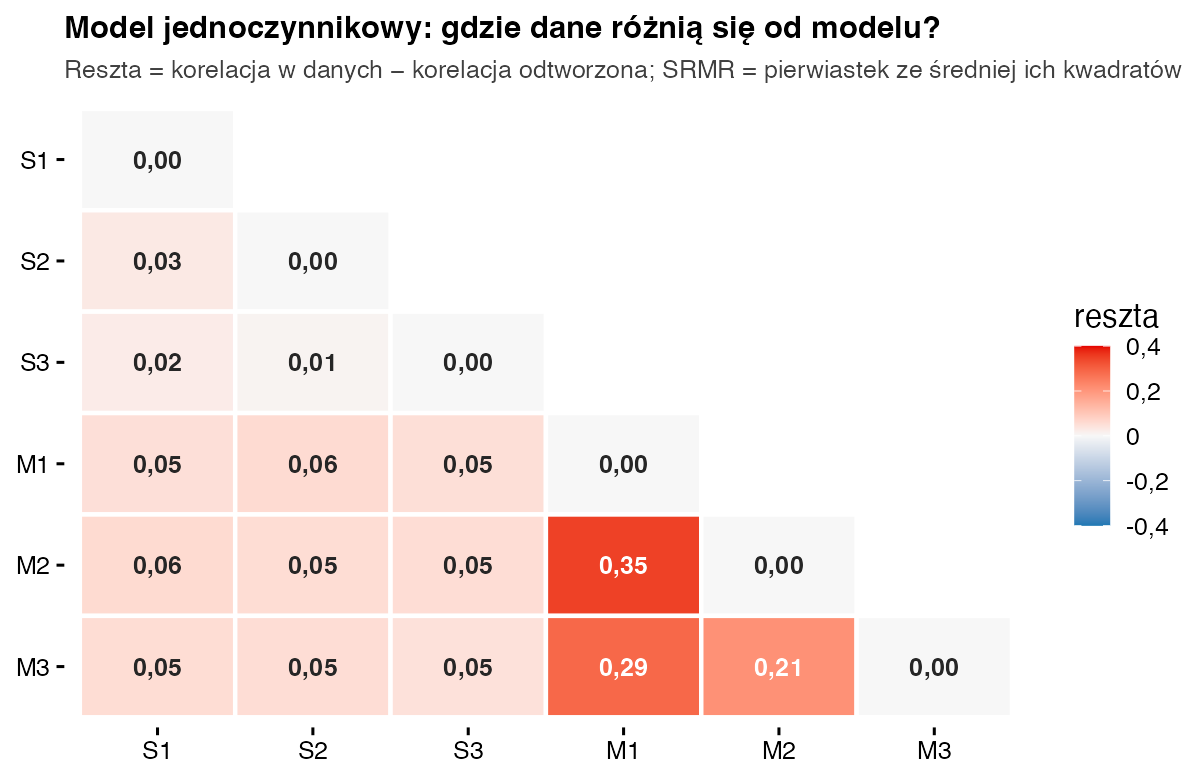
- SRMR. Suma kwadratów reszt z Tabeli 1 to 0,2753. Dzielimy przez 21 elementów: 0,2753 / 21 = 0,0131. Pierwiastek: √0,0131 = 0,114. Prawie cały wynik dają trzy pary M, gdzie model zaniża korelacje o 0,21–0,35.
- Test χ². Wartość krytyczna dla df = 9 i α = 0,05 to 16,92 (tablice albo
qchisq(0.95, 9)). 68,63 > 16,92, więc p < 0,001: model istotnie odbiega od danych. - Model dwuczynnikowy. Lavaan: χ²(8) = 0,038. Nadwyżka 0,038 − 8 jest ujemna, więc zamieniamy ją na 0. CFI = 1 − 0 / 231,118 = 1,000 i RMSEA = √(0 / (8 · 199)) = 0. TLI = (16,408 − 0,038 / 8) / 15,408 = (16,408 − 0,005) / 15,408 = 16,403 / 15,408 = 1,065. TLI może przekroczyć 1, gdy χ² jest mniejsze niż df.
Jak zinterpretować i opisać wynik?
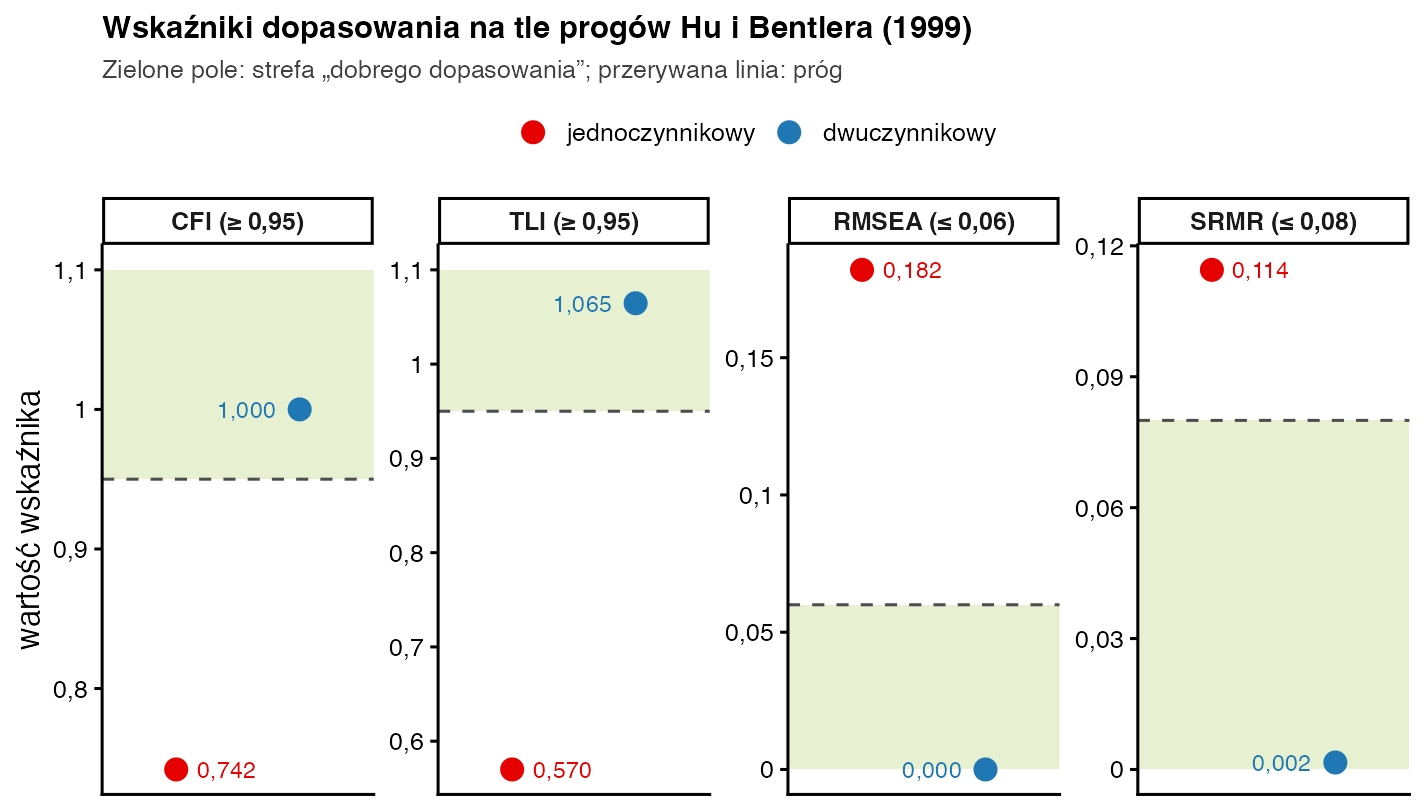
Najczęściej cytowane progi to propozycja Hu i Bentlera (1999): CFI i TLI co najmniej około 0,95, RMSEA najwyżej około 0,06 i SRMR najwyżej około 0,08. Model jednoczynnikowy nie spełnia żadnego z nich, a dwuczynnikowy – wszystkie. Traktuj te liczby jako orientacyjne, a nie „złote reguły” (Marsh i in., 2004). Wyznaczono je w symulacjach dla określonych modeli. Przy małej próbie, niewielu stopniach swobody i bardzo wysokich lub niskich ładunkach mogą wprowadzać w błąd. RMSEA przy małym df bywa zawyżone (Kenny i in., 2015). Istotny test χ² przy dużej próbie pojawia się nawet przy drobnych odchyleniach, dlatego zawsze podawaj go razem z pozostałymi wskaźnikami. W naszym przykładzie idealne dopasowanie modelu dwuczynnikowego wynika z tego, że dane skonstruowano z takiego modelu. W prawdziwych danych χ² prawie nigdy nie wynosi zero.
Zapis w stylu APA: Model jednoczynnikowy był słabo dopasowany do danych, χ²(9) = 68,63; p < 0,001; CFI = 0,74; TLI = 0,57; RMSEA = 0,18, 90% CI [0,14; 0,22]; SRMR = 0,11. Model z dwoma skorelowanymi czynnikami był dopasowany bardzo dobrze, χ²(8) = 0,04; p > 0,99; CFI = 1,00; TLI = 1,06; RMSEA = 0,00; SRMR = 0,00, i istotnie lepszy od jednoczynnikowego, Δχ²(1) = 68,59; p < 0,001.
Jak policzyć CFI, TLI, RMSEA i SRMR w R?
suppressPackageStartupMessages(library(lavaan))
r <- c(.56, .48, -.26, -.19, -.16, .42, -.22, -.17, -.14, -.19, -.14, -.12, .48, .40, .30)
R <- diag(6); R[lower.tri(R)] <- r; R <- R + t(R) - diag(6)    # macierz korelacji, n = 200
dimnames(R) <- list(c("S1", "S2", "S3", "M1", "M2", "M3"), c("S1", "S2", "S3", "M1", "M2", "M3"))
jeden <- cfa("F =~ S1 + S2 + S3 + M1 + M2 + M3", sample.cov = R, sample.nobs = 200, std.lv = TRUE)
dwa   <- cfa("Stres =~ S1 + S2 + S3
              Motyw =~ M1 + M2 + M3", sample.cov = R, sample.nobs = 200, std.lv = TRUE)
fm <- c("chisq", "df", "pvalue", "baseline.chisq", "baseline.df", "cfi", "tli", "rmsea", "srmr")
round(cbind(jeden = fitMeasures(jeden, fm), dwa = fitMeasures(dwa, fm)), 3)

# „ręcznie” dla modelu jednoczynnikowego (wzory z tekstu)
x <- fitMeasures(jeden); N <- 200
CFI <- 1 - (x[["chisq"]] - x[["df"]]) / (x[["baseline.chisq"]] - x[["baseline.df"]])
TLI <- (x[["baseline.chisq"]] / x[["baseline.df"]] - x[["chisq"]] / x[["df"]]) /
       (x[["baseline.chisq"]] / x[["baseline.df"]] - 1)
RMSEA <- sqrt(max(x[["chisq"]] - x[["df"]], 0) / (x[["df"]] * (N - 1)))
e <- residuals(jeden, type = "cor")$cov; e <- e[lower.tri(e, diag = TRUE)]
SRMR <- sqrt(sum(e^2) / length(e))
round(c(CFI = CFI, TLI = TLI, RMSEA = RMSEA, SRMR = SRMR, suma_e2 = sum(e^2)), 4)
Wynik w konsoli R:
                 jeden     dwa
chisq           68.626   0.038
df               9.000   8.000
pvalue           0.000   1.000
baseline.chisq 246.118 246.118
baseline.df     15.000  15.000
cfi              0.742   1.000
tli              0.570   1.065
rmsea            0.182   0.000
srmr             0.114   0.002
    CFI     TLI   RMSEA    SRMR suma_e2
 0.7420  0.5700  0.1825  0.1145  0.2753
Na surowych danych zamiast sample.cov i sample.nobs podajesz data = dane. Pełny wydruk daje summary(dwa, fit.measures = TRUE, standardized = TRUE), a porównanie modeli – anova(dwa, jeden). Ręczne RMSEA (0,1825) różni się od wyniku lavaan (0,182) tylko w czwartym miejscu po przecinku, bo lavaan dzieli przez N, a nie N − 1.
Model źle dopasowany – co robić?
Zacznij od reszt i indeksów modyfikacji (modindices(model)). Pokazują, które korelacje model odtwarza najgorzej. Duże reszty w jednej grupie pozycji, jak tu dla M1–M3, sugerują brakujący czynnik. Pojedyncza duża reszta może oznaczać pytania o bardzo podobnej treści. Każdą zmianę modelu uzasadnij teorią lub treścią pytań. Dodawanie korelacji błędów tylko po to, aby podnieść CFI, to dopasowywanie modelu do przypadku. Taki model trzeba potem sprawdzić na nowej próbie.
Najczęstsze błędy
- Traktowanie progów Hu i Bentlera jako sztywnych granic „zdany – niezdany”.
- Raportowanie tylko wskaźników, które wyszły dobrze, np. CFI bez RMSEA i SRMR.
- Odrzucanie modelu wyłącznie z powodu istotnego χ² przy kilkuset osobach.
- Pomijanie przedziału ufności dla RMSEA i liczby stopni swobody.
- Modyfikowanie modelu według indeksów modyfikacji bez uzasadnienia i bez sprawdzenia na nowej próbie.
Bibliografia
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246.
- Steiger, J. H. (1990). Structural model evaluation and modification: An interval estimation approach. Multivariate Behavioral Research, 25(2), 173–180.
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling, 11(3), 320–341.
- Kenny, D. A., Kaniskan, B., & McCoach, D. B. (2015). The performance of RMSEA in models with small degrees of freedom. Sociological Methods & Research, 44(3), 486–507.
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówCR i AVE (Fornell-Larcker)
- Słownik wzorówŁadunek czynnikowy
- Słownik wzorówRozkład chi-kwadrat
- PoradnikAnaliza czynnikowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza czynnikowa
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.