

AIC i BIC – wzór i przykład krok po kroku
AIC (kryterium informacyjne Akaike) i BIC (bayesowskie kryterium informacyjne) służą do wyboru lepszego z kilku modeli dopasowanych do tych samych danych. Typowe pytanie z pracy dyplomowej: czy dodanie kolejnego predyktora naprawdę poprawia model, czy tylko go komplikuje?
W prostych słowachKażdy model dostaje ocenę złożoną z dwóch części. Pierwsza to „jak źle model pasuje do danych” – im lepsze dopasowanie, tym mniej punktów. Druga to kara za złożoność: każdy dodatkowy parametr dokłada punkty karne. Wygrywa model z najmniejszą sumą. Dzięki temu nowy predyktor „opłaca się” tylko wtedy, gdy poprawia dopasowanie bardziej, niż wynosi kara. BIC karze surowiej niż AIC, więc częściej wybiera prostszy model.
Kiedy stosować AIC i BIC?
- porównujesz dwa lub więcej modeli dla tej samej zmiennej wyjaśnianej i tych samych osób;
- modele różnią się liczbą predyktorów – chcesz wiedzieć, czy dodatkowa zmienna jest warta „kosztu”;
- modele nie są zagnieżdżone (jeden nie jest szczególnym przypadkiem drugiego) – wtedy test F nie zadziała, a AIC tak;
- pracujesz z modelami, dla których nie ma zwykłego R²: regresja logistyczna, modele mieszane, modele strukturalne.
Przy modelach zagnieżdżonych masz też test zmiany R², opisany w haśle o regresji hierarchicznej i ΔR². Podobną ideę kary za liczbę predyktorów ma skorygowane R² z hasła o współczynniku determinacji. W analizie czynnikowej AIC i BIC stoją obok wskaźników dopasowania CFA.
Wzór na AIC i BIC
- \(L\)
- wiarygodność (ang. likelihood): jak prawdopodobne są nasze dane, jeśli model jest prawdziwy; im wyższa, tym lepsze dopasowanie
- \(\ln L\)
- logarytm naturalny wiarygodności; zwykle liczba ujemna
- \(-2\ln L\)
- „część dopasowania”: im mniejsza, tym model lepiej pasuje do danych
- \(k\)
- liczba szacowanych parametrów: wyraz wolny, wszystkie współczynniki b i jeszcze odchylenie standardowe reszt σ
- \(2k\)
- kara za złożoność w AIC: 2 punkty za każdy parametr
- \(k \ln n\)
- kara w BIC: rośnie z liczbą osób; już od n = 8 jest większa niż w AIC
- \(n\)
- liczba osób
- \(SS_{reszt}\)
- suma kwadratów reszt modelu regresji liniowej
Jak przeczytać wzór na głos: „AIC to podwojona liczba parametrów minus podwojony logarytm wiarygodności”. Druga linijka pokazuje, skąd w regresji liniowej wziąć ln L: wystarczy suma kwadratów reszt.
Przykład krok po kroku
Dane z hasła o współczynniku determinacji: pięcioro studentów, godziny nauki, punkty z kolokwium i kubki kawy (2, 1, 1, 1, 0). Model 1 przewiduje punkty z godzin. Model 2 dodaje kawę. Sumy kwadratów reszt to 14,4 i 14,0.
| model | SSreszt | SS / n | ln(SS / n) | ln L | −2 ln L | k | 2k | AIC | k · ln 5 | BIC |
|---|---|---|---|---|---|---|---|---|---|---|
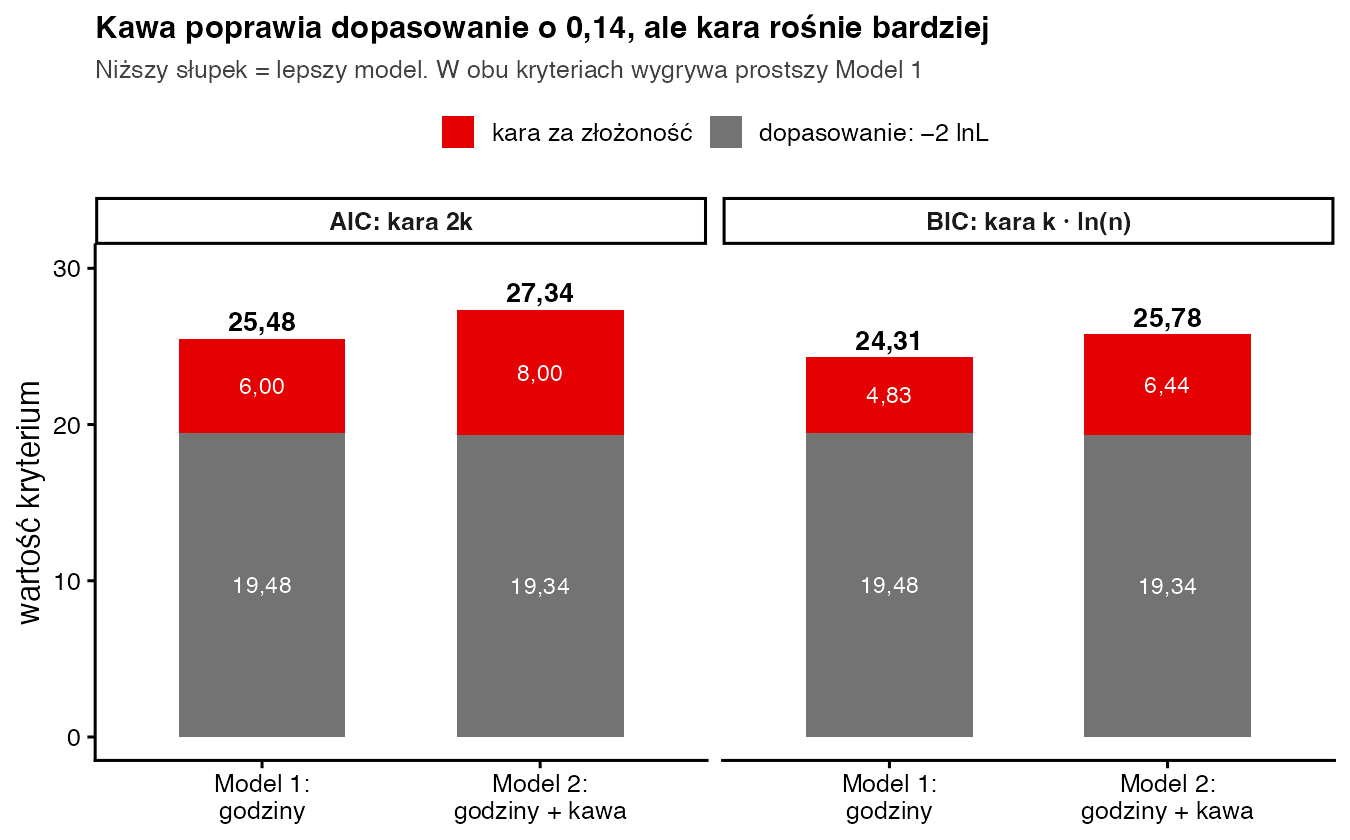
| 1: godziny | 14,4 | 14,4 / 5 = 2,88 | 1,058 | −9,74 | 19,48 | 3 | 6 | 25,48 | 4,83 | 24,31 |
| 2: godziny + kawa | 14,0 | 14,0 / 5 = 2,80 | 1,030 | −9,67 | 19,34 | 4 | 8 | 27,34 | 6,44 | 25,78 |
| różnica 2 − 1 | −0,4 | 0,07 | −0,14 | 1 | 2 | ΔAIC = 1,86 | 1,61 | ΔBIC = 1,47 |
- Średni kwadrat reszty. Podziel sumę kwadratów reszt przez n: 14,4 / 5 = 2,88 i 14,0 / 5 = 2,80.
- Logarytmy. ln(2,88) = 1,058 i ln(2,80) = 1,030. Stała ln(2π) = ln(6,283) = 1,838. Logarytm naturalny liczy każdy kalkulator naukowy (klawisz „ln”), w R:
log(). - ln L dla modelu 1. Dodaj trzy składniki: 1,838 + 1,058 + 1 = 3,896. Pomnóż przez −n/2 = −2,5: ln L = −2,5 · 3,896 = −9,74.
- ln L dla modelu 2. 1,838 + 1,030 + 1 = 3,868, a −2,5 · 3,868 = −9,67. Model 2 pasuje odrobinę lepiej, bo ma mniejsze reszty.
- Liczba parametrów. Model 1 szacuje wyraz wolny, nachylenie i σ: k = 3. Model 2 dodaje współczynnik kawy: k = 4.
- AIC. Model 1: 2 · 3 − 2 · (−9,74) = 6 + 19,48 = 25,48. Model 2: 2 · 4 + 19,34 = 8 + 19,34 = 27,34.
- BIC. ln 5 = 1,609. Model 1: 3 · 1,609 + 19,48 = 4,83 + 19,48 = 24,31. Model 2: 4 · 1,609 + 19,34 = 6,44 + 19,34 = 25,78.
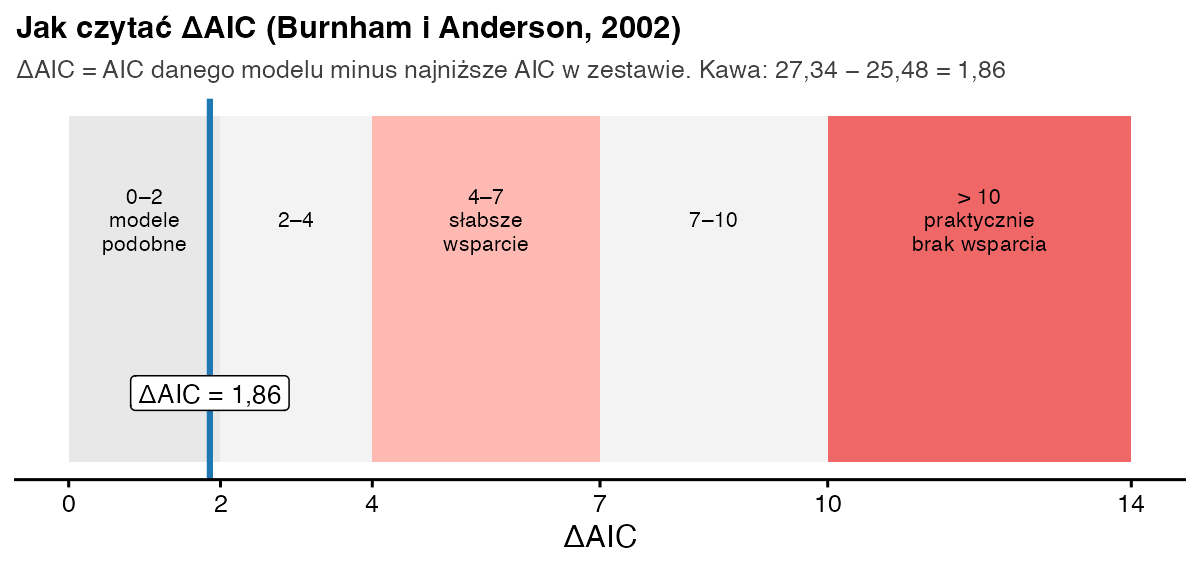
- Porównanie. Kawa poprawiła część dopasowania tylko o 19,48 − 19,34 = 0,14, a kara wzrosła o 2 (AIC) albo o 1,61 (BIC). Model 1 ma niższe AIC i niższe BIC: ΔAIC = 27,34 − 25,48 = 1,86; ΔBIC = 25,78 − 24,31 = 1,47.
- Wagi Akaike. Każdy model dostaje wagę exp(−ΔAIC / 2). Dla modelu 1: exp(0) = 1, dla modelu 2: exp(−0,93) = 0,395. Po podzieleniu przez sumę 1,395 wagi wynoszą 0,72 i 0,28. W tym zestawie model 1 jest „lepszy z prawdopodobieństwem” około 72% (Wagenmakers i Farrell, 2004).
Jak zinterpretować i opisać wynik?
Liczy się tylko różnica między modelami, nigdy sama wartość AIC. AIC = 25,48 samo w sobie nic nie mówi. Różnice poniżej 2 traktuj jako „modele podobnie dobre” – wtedy wybierz prostszy. Dla BIC Raftery (1995) proponuje: 0–2 słabe świadectwo, 2–6 pozytywne, 6–10 silne, powyżej 10 bardzo silne. Tutaj oba kryteria zgadzają się z innymi miarami: skorygowane R² spadło z 0,52 do 0,30, a test F dla kawy dał F(1, 2) = 0,06; p = 0,833.
Zapis w stylu APA: Model z liczbą godzin nauki (AIC = 25,48; BIC = 24,31) był lepiej dopasowany niż model uzupełniony o liczbę kubków kawy (AIC = 27,34; BIC = 25,78), ΔAIC = 1,86; waga Akaike prostszego modelu wynosiła 0,72.
Jak policzyć AIC i BIC w R?
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)
kawa    <- c(2, 1, 1, 1, 0)
m1 <- lm(punkty ~ godziny)
m2 <- lm(punkty ~ godziny + kawa)

# 1) „ręcznie”: lnL z sumy kwadratów reszt, potem AIC i BIC
n <- 5
lnL <- function(m) -n / 2 * (log(2 * pi) + log(sum(resid(m)^2) / n) + 1)
k <- c(3, 4)                       # a, b (i kawa) oraz σ
L <- c(m1 = lnL(m1), m2 = lnL(m2))
round(rbind(lnL = L, AIC = 2 * k - 2 * L, BIC = k * log(n) - 2 * L), 2)

# 2) gotowe funkcje
AIC(m1, m2)
BIC(m1, m2)
Wynik w konsoli R:
       m1    m2
lnL -9.74 -9.67
AIC 25.48 27.34
BIC 24.31 25.78
   df      AIC
m1  3 25.47834
m2  4 27.33748
   df      BIC
m1  3 24.30665
m2  4 25.77523
Kolumna df w wyniku AIC() to nasze k – R także liczy σ jako parametr. Inne programy mogą pomijać stałe we wzorze albo nie liczyć σ. Wtedy same wartości AIC są inne, ale różnice między modelami pozostają takie same.
AIC czy BIC – które wybrać?
AIC szuka modelu, który najlepiej przewidzi nowe dane, więc chętniej zostawia dodatkowe predyktory. BIC szuka modelu „prawdziwego” i przy dużych próbach karze złożoność dużo surowiej (przy n = 100 kara za parametr to ln 100 = 4,61 zamiast 2). Jeśli oba wskazują ten sam model, sprawa jest prosta. Jeśli się różnią, napisz to wprost i uzasadnij wybór celem badania. Przy małych próbach rozważ AICc z poprawką Hurvicha i Tsaia (1989): AIC + 2k(k + 1) / (n − k − 1). W naszym przykładzie dla modelu 2 mianownik wynosi 5 − 4 − 1 = 0, więc AICc nie da się nawet policzyć – to sygnał, że pięć osób to za mało na trzy predyktory.
Najczęstsze błędy
- Porównywanie AIC modeli liczonych na różnej liczbie osób (np. przez braki danych w jednej zmiennej) albo z inną zmienną wyjaśnianą, np. y i log(y).
- Interpretowanie samej wartości AIC jako „dobrej” lub „złej” – liczy się tylko różnica.
- Mieszanie AIC z różnych programów, które liczą stałe inaczej.
- Traktowanie ΔAIC jak testu istotności z wartością p – to kryterium wyboru, nie test.
- Wybór „najlepszego” modelu z dziesiątek kombinacji predyktorów bez teorii – AIC też da się „przetrenować”.
Bibliografia
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723.
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464.
- Burnham, K. P., & Anderson, D. R. (2002). Model selection and multimodel inference: A practical information-theoretic approach (2nd ed.). Springer.
- Raftery, A. E. (1995). Bayesian model selection in social research. Sociological Methodology, 25, 111–163.
- Hurvich, C. M., & Tsai, C.-L. (1989). Regression and time series model selection in small samples. Biometrika, 76(2), 297–307.
- Wagenmakers, E.-J., & Farrell, S. (2004). AIC model selection using Akaike weights. Psychonomic Bulletin & Review, 11(1), 192–196.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówWspółczynnik determinacji R²
- Słownik wzorówRegresja hierarchiczna i ΔR²
- Słownik wzorówRegresja logistyczna
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.