

Regresja hierarchiczna i ΔR² – wzór i przykład krok po kroku
Regresja hierarchiczna to dokładanie predyktorów do modelu blokami, w ustalonej kolejności, i sprawdzanie, o ile każdy blok zwiększa R². Typowe pytanie z pracy dyplomowej: czy godziny nauki przewidują wynik z kolokwium ponad to, co wyjaśnia samo zainteresowanie przedmiotem?
W prostych słowachNajpierw budujesz model ze zmiennymi, które „i tak” wpływają na wynik i chcesz je kontrolować (blok 1). Zapisujesz, ile zmienności wyjaśnia. Potem dokładasz zmienne, które naprawdę Cię interesują (blok 2), i znowu sprawdzasz R². Różnica to ΔR² (czytaj: „delta R kwadrat”): ile nowego wniósł blok 2. Test F zmiany mówi, czy ten przyrost jest większy, niż dałby przypadek.
Kiedy stosować regresję hierarchiczną?
- chcesz pokazać, że Twój predyktor coś dodaje ponad zmienne kontrolne (wiek, płeć, wcześniejsze wyniki, zainteresowanie);
- kolejność wprowadzania zmiennych wynika z teorii albo czasu: najpierw cechy stałe, potem zmienne bieżące;
- testujesz interakcję (moderację): blok 1 to efekty główne, blok 2 to iloczyn predyktorów;
- recenzent pyta o „przyrostową trafność” (ang. incremental validity) nowej skali.
Podstawy R² i skorygowanego R² znajdziesz w haśle o współczynniku determinacji. Test F zmiany korzysta z rozkładu F. Moderację krok po kroku opisujemy w haśle o interakcji w regresji. Jeśli modele nie są zagnieżdżone, porównaj je za pomocą AIC i BIC.
Wzór na ΔR² i F zmiany
- \(R^2_1\)
- R² modelu z blokiem 1 (same zmienne kontrolne)
- \(R^2_2\)
- R² modelu z blokami 1 i 2 razem
- \(\Delta R^2\)
- przyrost R²: część zmienności wyjaśniona dodatkowo przez blok 2
- \(m\)
- liczba predyktorów dodanych w bloku 2 = pierwsze stopnie swobody testu F
- \(k_2\)
- łączna liczba predyktorów w modelu z bloku 2
- \(n\)
- liczba osób; \(n - k_2 - 1\) to drugie stopnie swobody testu F
- \(1 - R^2_2\)
- część zmienności, której nie wyjaśnia nawet pełny model
- \(F_{zm}\)
- statystyka F dla zmiany R²
Jak przeczytać wzór na głos: „F zmiany to przyrost R² na jeden dodany predyktor, podzielony przez niewyjaśnioną część zmienności na jeden stopień swobody reszt”. Licznik mówi, ile zyskałeś. Mianownik mówi, ile szumu zostało.
Przykład krok po kroku
Dziesięcioro studentów oceniło zainteresowanie przedmiotem (1–5), podało liczbę godzin nauki przed kolokwium (0–8) i wynik w punktach (0–20). Blok 1: zainteresowanie. Blok 2: godziny nauki. Równania obu modeli podaje R (sposób liczenia współczynników opisujemy w haśle o regresji liniowej): ŷ₁ = 4 + 2 · zainteresowanie oraz ŷ₂ = 3 + 1 · zainteresowanie + 1 · godziny.
| zaint. | godziny | y | (y − 10)² | ŷ₁ = 4 + 2z | (y − ŷ₁)² | ŷ₂ = 3 + z + g | (y − ŷ₂)² |
|---|---|---|---|---|---|---|---|
| 1 | 4 | 6 | (−4)² = 16 | 4 + 2 = 6 | 0² = 0 | 3 + 1 + 4 = 8 | (−2)² = 4 |
| 1 | 0 | 5 | (−5)² = 25 | 6 | (−1)² = 1 | 3 + 1 + 0 = 4 | 1² = 1 |
| 2 | 5 | 11 | 1² = 1 | 4 + 4 = 8 | 3² = 9 | 3 + 2 + 5 = 10 | 1² = 1 |
| 2 | 1 | 9 | (−1)² = 1 | 8 | 1² = 1 | 3 + 2 + 1 = 6 | 3² = 9 |
| 3 | 6 | 11 | 1² = 1 | 4 + 6 = 10 | 1² = 1 | 3 + 3 + 6 = 12 | (−1)² = 1 |
| 3 | 2 | 5 | (−5)² = 25 | 10 | (−5)² = 25 | 3 + 3 + 2 = 8 | (−3)² = 9 |
| 4 | 7 | 13 | 3² = 9 | 4 + 8 = 12 | 1² = 1 | 3 + 4 + 7 = 14 | (−1)² = 1 |
| 4 | 3 | 11 | 1² = 1 | 12 | (−1)² = 1 | 3 + 4 + 3 = 10 | 1² = 1 |
| 5 | 8 | 19 | 9² = 81 | 4 + 10 = 14 | 5² = 25 | 3 + 5 + 8 = 16 | 3² = 9 |
| 5 | 4 | 10 | 0² = 0 | 14 | (−4)² = 16 | 3 + 5 + 4 = 12 | (−2)² = 4 |
| Σ = 30 | Σ = 40 | Σ = 100 | SScałk = 160 | Σ = 100 | SSreszt1 = 80 | Σ = 100 | SSreszt2 = 40 |
- Błąd bez modelu. Średnia punktów: 100 / 10 = 10. Suma kwadratów odchyleń od średniej: SScałk = 160.
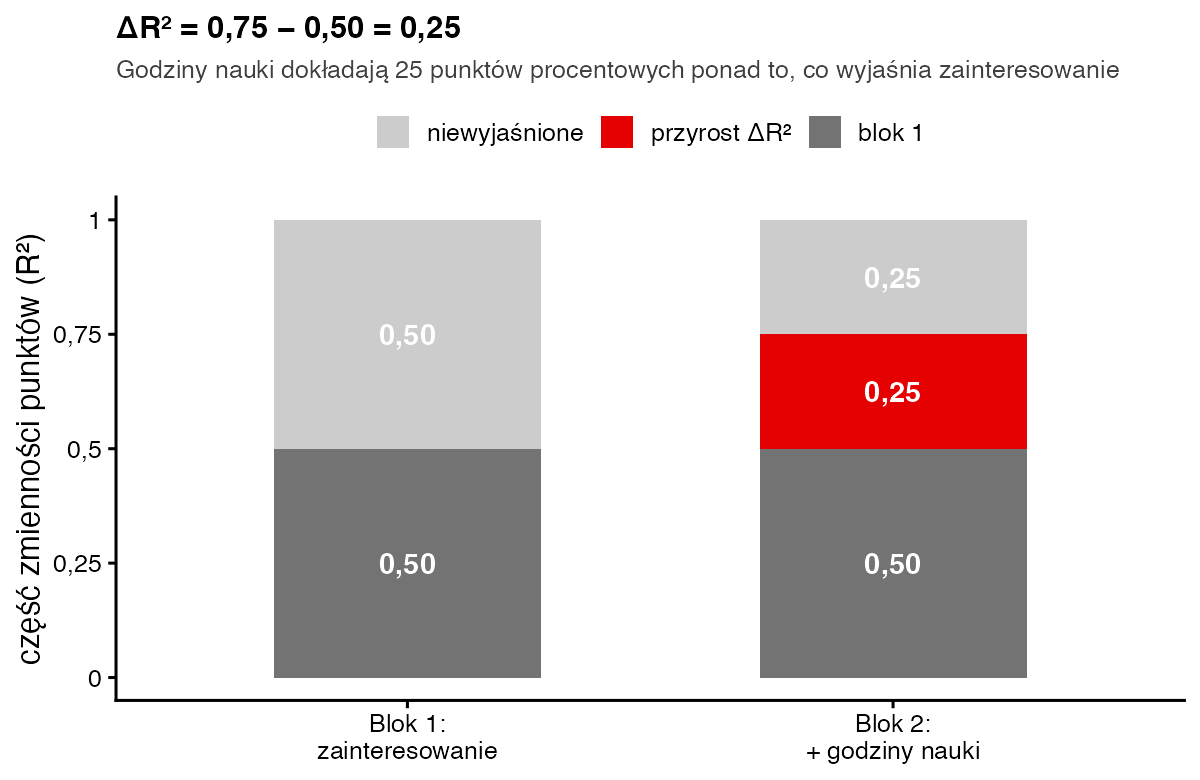
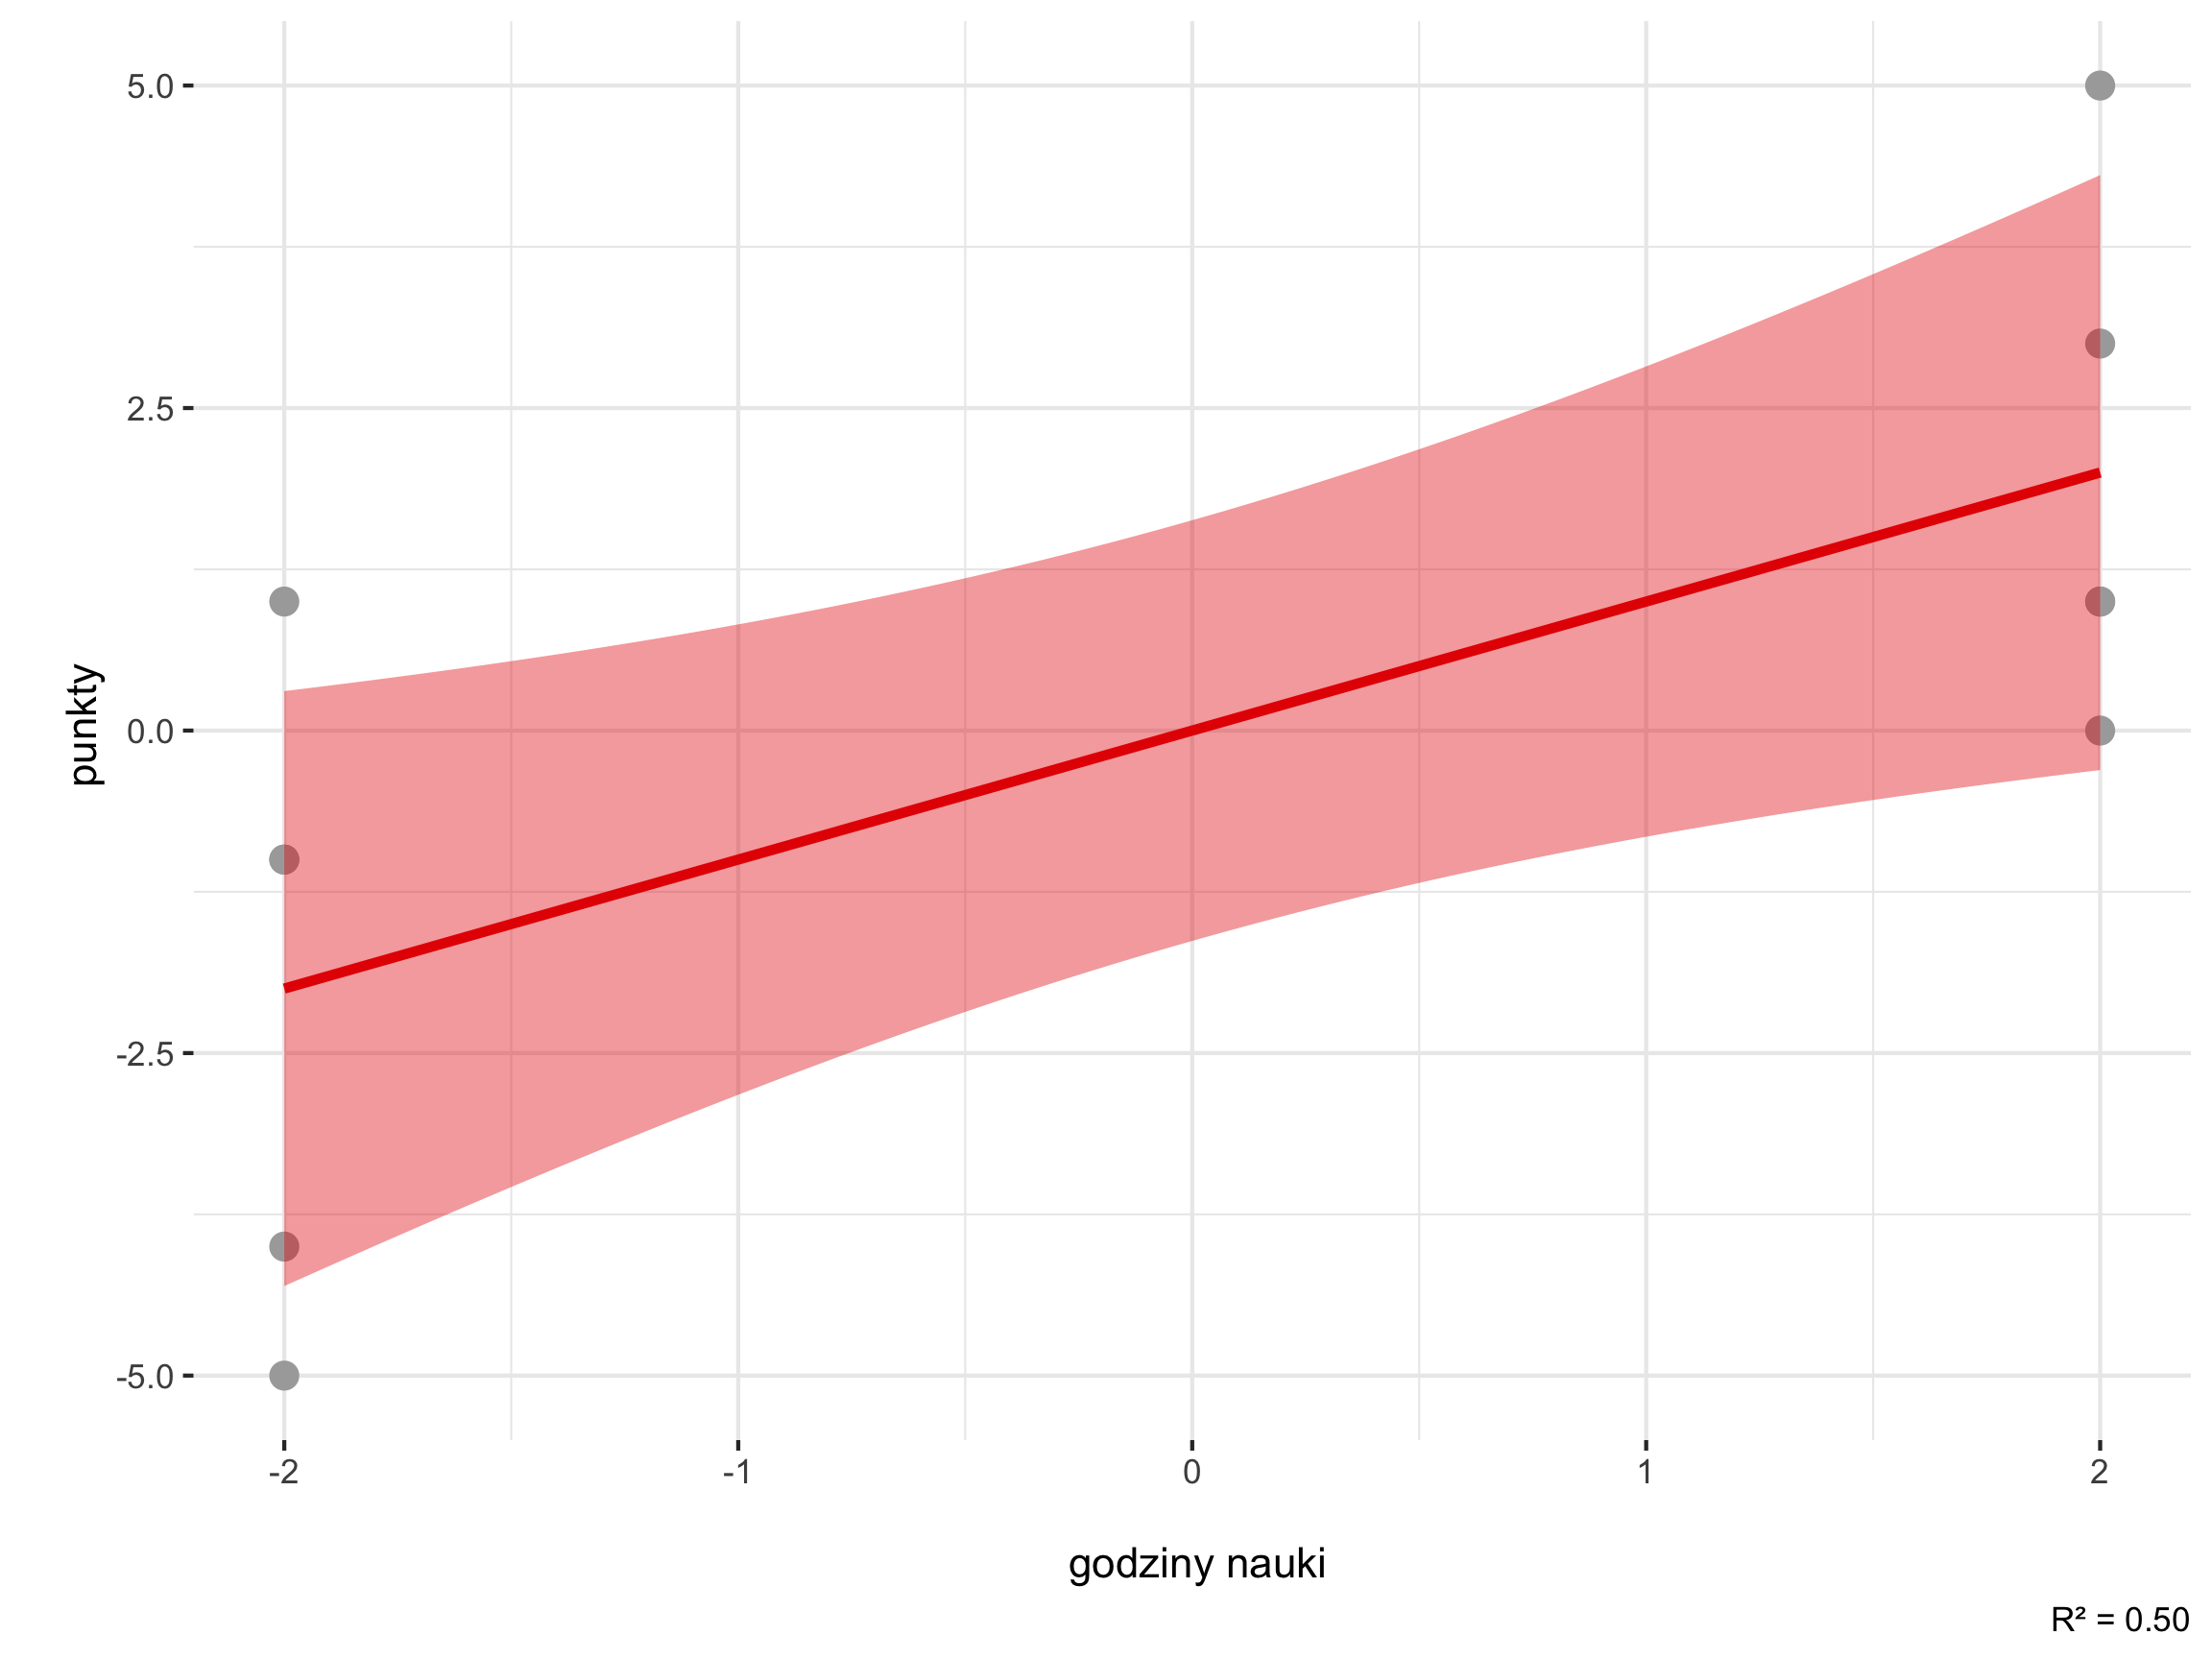
- Blok 1. Reszty modelu z samym zainteresowaniem, np. dla trzeciej osoby: 11 − 8 = 3, a 3² = 9. Suma kwadratów: SSreszt1 = 80. Stąd R²₁ = 1 − 80 / 160 = 1 − 0,50 = 0,50.
- Blok 2. Po dodaniu godzin, np. dla trzeciej osoby: ŷ₂ = 3 + 2 + 5 = 10, reszta 11 − 10 = 1. Suma kwadratów: SSreszt2 = 40, więc R²₂ = 1 − 40 / 160 = 1 − 0,25 = 0,75.
- ΔR². 0,75 − 0,50 = 0,25. To samo w sumach kwadratów: godziny usunęły 80 − 40 = 40 z pierwotnych 160, a 40 / 160 = 0,25.
- Stopnie swobody. Dodaliśmy m = 1 predyktor, a pełny model ma k₂ = 2 predyktory: n − k₂ − 1 = 10 − 2 − 1 = 7.
- F zmiany. Licznik: 0,25 / 1 = 0,25. Mianownik: (1 − 0,75) / 7 = 0,25 / 7 = 0,0357. F = 0,25 / 0,0357 = 7,00.
- Decyzja. Wartość krytyczna F(1, 7) dla α = 0,05 to 5,59 (tablice rozkładu F albo w R:
qf(0.95, 1, 7)). 7,00 > 5,59, więc przyrost jest istotny. Dokładnie: p = 0,033 (pf(7, 1, 7, lower.tail = FALSE)). - Test bloku 1. Dla porządku: F(1, 8) = (0,50 / 1) / (0,50 / 8) = 0,50 / 0,0625 = 8,00; p = 0,022. Model końcowy: F(2, 7) = 10,50; p = 0,008.
Jak zinterpretować i opisać wynik?
ΔR² = 0,25 znaczy, że godziny nauki wyjaśniają dodatkowe 25 punktów procentowych zmienności wyników ponad zainteresowanie. Wielkość przyrostu możesz wyrazić jako f² Cohena: ΔR² / (1 − R²₂) = 0,25 / 0,25 = 1,00. To efekt duży według progów Cohena (1988): 0,02 – mały, 0,15 – średni, 0,35 – duży. Przy tak małej próbie przedział ufności byłby jednak bardzo szeroki. Jak zawsze w regresji, „wyjaśnia” nie znaczy „powoduje”.
Zapis w stylu APA: W kroku 1 zainteresowanie przedmiotem wyjaśniało 50% zmienności wyników, R² = 0,50; F(1, 8) = 8,00; p = 0,022. Dodanie liczby godzin nauki w kroku 2 istotnie zwiększyło dopasowanie, ΔR² = 0,25; F(1, 7) = 7,00; p = 0,033. Model końcowy wyjaśniał 75% zmienności, R² = 0,75; F(2, 7) = 10,50; p = 0,008.
Jak policzyć ΔR² w R?
zainteresowanie <- c(1, 1, 2, 2, 3, 3, 4, 4, 5, 5)
godziny <- c(4, 0, 5, 1, 6, 2, 7, 3, 8, 4)
punkty  <- c(6, 5, 11, 9, 11, 5, 13, 11, 19, 10)
blok1 <- lm(punkty ~ zainteresowanie)
blok2 <- lm(punkty ~ zainteresowanie + godziny)

# 1) „ręcznie”: ΔR² i F zmiany
R2_1 <- summary(blok1)$r.squared             # 0.50
R2_2 <- summary(blok2)$r.squared             # 0.75
dR2  <- R2_2 - R2_1                          # 0.25
F_zm <- (dR2 / 1) / ((1 - R2_2) / (10 - 2 - 1))
c(R2_1 = R2_1, R2_2 = R2_2, dR2 = dR2, F = F_zm,
  p = pf(F_zm, 1, 7, lower.tail = FALSE))

# 2) gotowa funkcja: porównanie modeli zagnieżdżonych
anova(blok1, blok2)
Wynik w konsoli R:
     R2_1      R2_2       dR2         F         p
0.5000000 0.7500000 0.2500000 7.0000000 0.0331455
Analysis of Variance Table

Model 1: punkty ~ zainteresowanie
Model 2: punkty ~ zainteresowanie + godziny
  Res.Df RSS Df Sum of Sq  F  Pr(>F)
1      8  80
2      7  40  1        40  7 0.03315 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Funkcja anova(blok1, blok2) pokazuje to samo w sumach kwadratów: RSS spada z 80 do 40, F = 7 i p = 0,033. Gdy blok 2 ma jeden predyktor, ten test jest równoważny testowi t dla jego współczynnika: t = 2,646, a 2,646² = 7,00.
Regresja hierarchiczna a krokowa – czym się różnią?
W regresji hierarchicznej to Ty decydujesz o kolejności bloków na podstawie teorii, zanim zobaczysz wyniki. W regresji krokowej (stepwise) kolejność wybiera program według istotności. Wyniki krokowe łatwo „dopasowują się” do przypadkowych cech próby i źle się replikują, dlatego metodolodzy odradzają je w pracach dyplomowych. Kolejność bloków zmienia ΔR², ale nie zmienia pełnego modelu: R²₂ = 0,75 niezależnie od tego, co wejdzie pierwsze. Gdy zestawiasz siłę predyktorów w modelu końcowym, sięgnij po standaryzowane współczynniki β.
Najczęstsze błędy
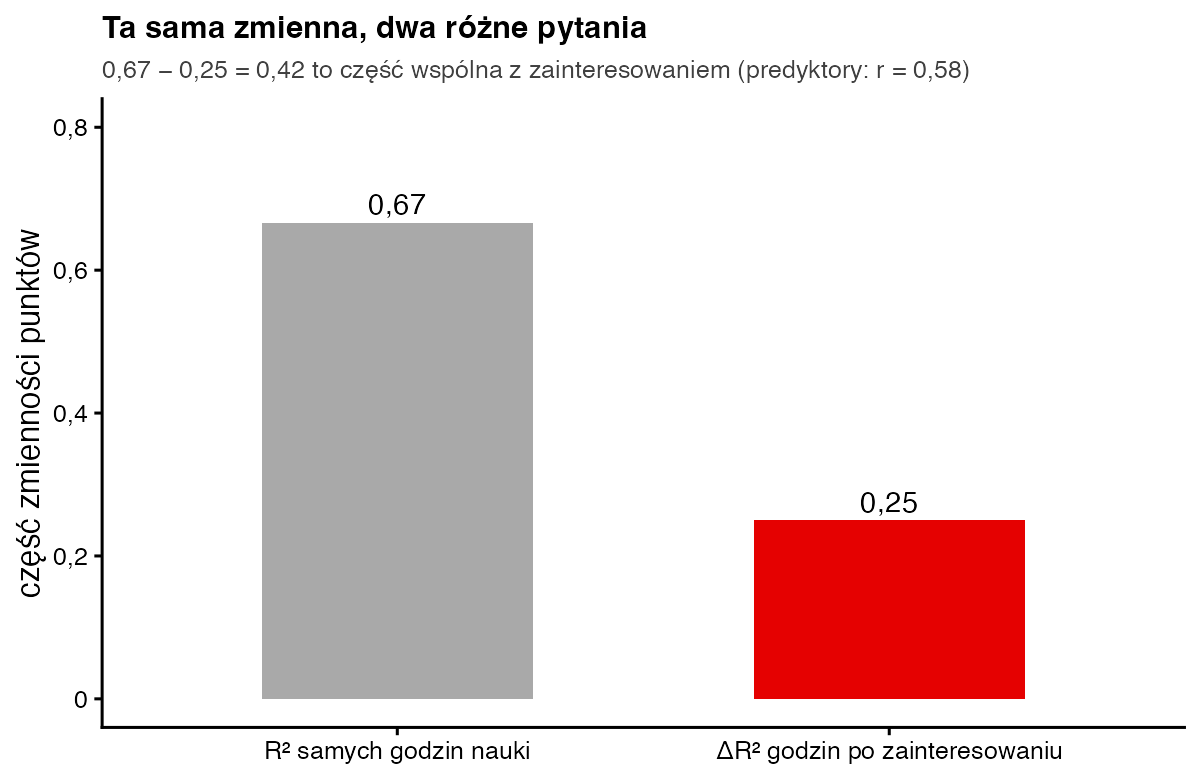
- Porównywanie R² samego predyktora (0,67) z ΔR² (0,25), jakby to była ta sama wielkość – ΔR² zależy od tego, co już jest w modelu.
- Liczenie modeli na różnej liczbie osób przez braki danych w zmiennych z bloku 2 – oba modele muszą mieć te same osoby.
- Ustalanie kolejności bloków po obejrzeniu wyników.
- Podawanie tylko R² modelu końcowego bez ΔR² i F zmiany dla każdego kroku.
- Uznanie nieistotnego ΔR² za dowód, że predyktor „nie ma związku” z wynikiem – może być po prostu nakładający się z blokiem 1 albo próba jest za mała.
Bibliografia
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Petrocelli, J. V. (2003). Hierarchical multiple regression in counseling research: Common problems and possible remedies. Measurement and Evaluation in Counseling and Development, 36(1), 9–22.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówWspółczynnik determinacji R²
- Słownik wzorówRegresja liniowa
- Słownik wzorówRozkład F
- Słownik wzorówInterakcja w regresji (moderacja)
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.