

Współczynnik determinacji R² – wzór i przykład krok po kroku
Współczynnik determinacji R² mówi, jaką część zmienności zmiennej wyjaśnianej odtwarza model regresji. Typowe pytanie z pracy dyplomowej: jaki procent różnic w punktach z kolokwium da się przewidzieć na podstawie liczby godzin nauki?
W prostych słowachWyobraź sobie, że musisz zgadnąć wynik każdego studenta. Bez żadnej wiedzy najlepiej strzelać w średnią i zapisywać, o ile się mylisz. Potem zgadujesz jeszcze raz, tym razem z pomocą modelu. R² mówi, o jaką część zmalały Twoje błędy (liczone jako kwadraty). R² = 0,64 znaczy: model usunął 64% błędu, który popełniałbyś, zgadując samą średnią.
Kiedy stosować współczynnik determinacji?
- opisujesz wynik regresji liniowej – prostej albo z kilkoma predyktorami;
- chcesz powiedzieć, jak dobrze model jako całość pasuje do danych;
- porównujesz modele z różną liczbą predyktorów – wtedy patrz na skorygowane R².
R² nie mówi, czy pojedynczy predyktor jest istotny ani w którą stronę działa – to odczytasz ze współczynników w haśle o regresji liniowej. W regresji z jednym predyktorem R² to po prostu kwadrat korelacji Pearsona. W analizie wariancji tę samą ideę nazywa się eta kwadrat.
Wzór na R² i skorygowane R²
- \(y_i\)
- prawdziwy wynik i-tej osoby (np. jej punkty z kolokwium)
- \(\bar{y}\)
- średnia wszystkich wyników – „zgadywanie bez modelu”
- \(\hat{y}_i\)
- wynik przewidziany przez model dla i-tej osoby (czytaj: „y z daszkiem”)
- \(SS_{całk}\)
- całkowita suma kwadratów: suma kwadratów odległości wyników od średniej
- \(SS_{reszt}\)
- suma kwadratów reszt: suma kwadratów odległości wyników od przewidywań modelu
- \(n\)
- liczba osób
- \(k\)
- liczba predyktorów w modelu (bez wyrazu wolnego)
- \(R^2_{adj}\)
- skorygowane R² (ang. adjusted): R² z karą za liczbę predyktorów
Jak przeczytać wzór na głos: „R kwadrat to jeden minus stosunek błędu, który zostaje przy modelu, do błędu, który popełniamy, zgadując średnią”.
Przykład krok po kroku
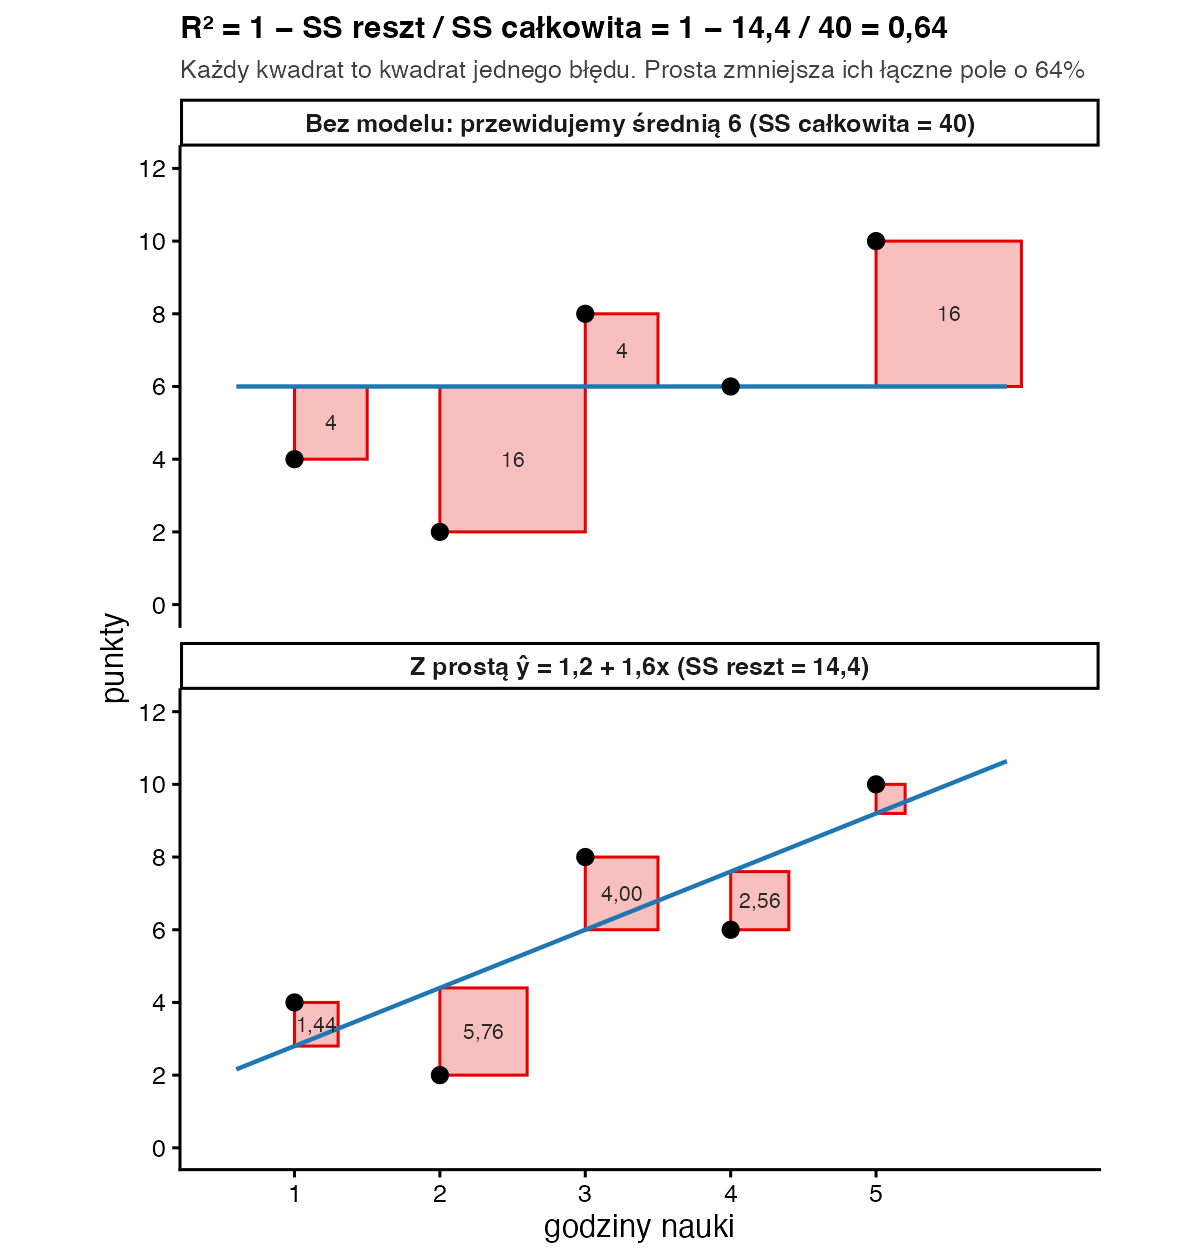
Te same dane co w hasłach o korelacji Pearsona i regresji. Pięcioro studentów zapisało, ile godzin uczyło się do kolokwium (x) i ile punktów zdobyło (y). Prosta regresji ma postać ŷ = 1,2 + 1,6x.
| x | y | y − 6 | (y − 6)² | ŷ = 1,2 + 1,6x | y − ŷ | (y − ŷ)² |
|---|---|---|---|---|---|---|
| 1 | 4 | 4 − 6 = −2 | 4 | 1,2 + 1,6 = 2,8 | 4 − 2,8 = 1,2 | 1,44 |
| 2 | 2 | 2 − 6 = −4 | 16 | 1,2 + 3,2 = 4,4 | 2 − 4,4 = −2,4 | 5,76 |
| 3 | 8 | 8 − 6 = 2 | 4 | 1,2 + 4,8 = 6,0 | 8 − 6,0 = 2,0 | 4,00 |
| 4 | 6 | 6 − 6 = 0 | 0 | 1,2 + 6,4 = 7,6 | 6 − 7,6 = −1,6 | 2,56 |
| 5 | 10 | 10 − 6 = 4 | 16 | 1,2 + 8,0 = 9,2 | 10 − 9,2 = 0,8 | 0,64 |
| Σ = 15 | Σ = 30 | 0 | SScałk = 40 | Σ = 30 | 0 | SSreszt = 14,4 |
- Średnia. \(\bar{y} = 30 / 5 = 6\). To nasze „zgadywanie bez modelu”.
- Błąd bez modelu. Odejmij średnią od każdego wyniku i podnieś różnicę do kwadratu (kwadrat usuwa minusy): 4 + 16 + 4 + 0 + 16 = 40. To SScałk.
- Przewidywania modelu. Podstaw każde x do równania prostej, np. dla x = 2: 1,2 + 1,6 · 2 = 1,2 + 3,2 = 4,4.
- Błąd z modelem. Reszta to y − ŷ, np. 2 − 4,4 = −2,4, a jej kwadrat (−2,4)² = 5,76. Suma kwadratów reszt: 1,44 + 5,76 + 4,00 + 2,56 + 0,64 = 14,4.
- R². Najpierw stosunek błędów: 14,4 / 40 = 0,36. Model zostawił 36% pierwotnego błędu, więc R² = 1 − 0,36 = 0,64. Kontrola: r = 0,80, a 0,80² = 0,64.
- Skorygowane R². Mamy n = 5 osób i k = 1 predyktor: (n − 1)/(n − k − 1) = 4 / 3. Stąd \(R^2_{adj} = 1 - 0{,}36 \cdot 4/3 = 1 - 0{,}48 = 0{,}52\).
- Test modelu. Część wyjaśniona to 40 − 14,4 = 25,6. F = (25,6 / 1) / (14,4 / 3) = 25,6 / 4,8 = 5,33; df = 1 i 3; p = 0,104. Wartość krytyczną F dla α = 0,05 znajdziesz w tablicach lub w R:
qf(0.95, 1, 3)= 10,13. Nasze 5,33 jest mniejsze, więc wynik nie jest istotny.
Dlaczego skorygowane R² rośnie ostrożniej?
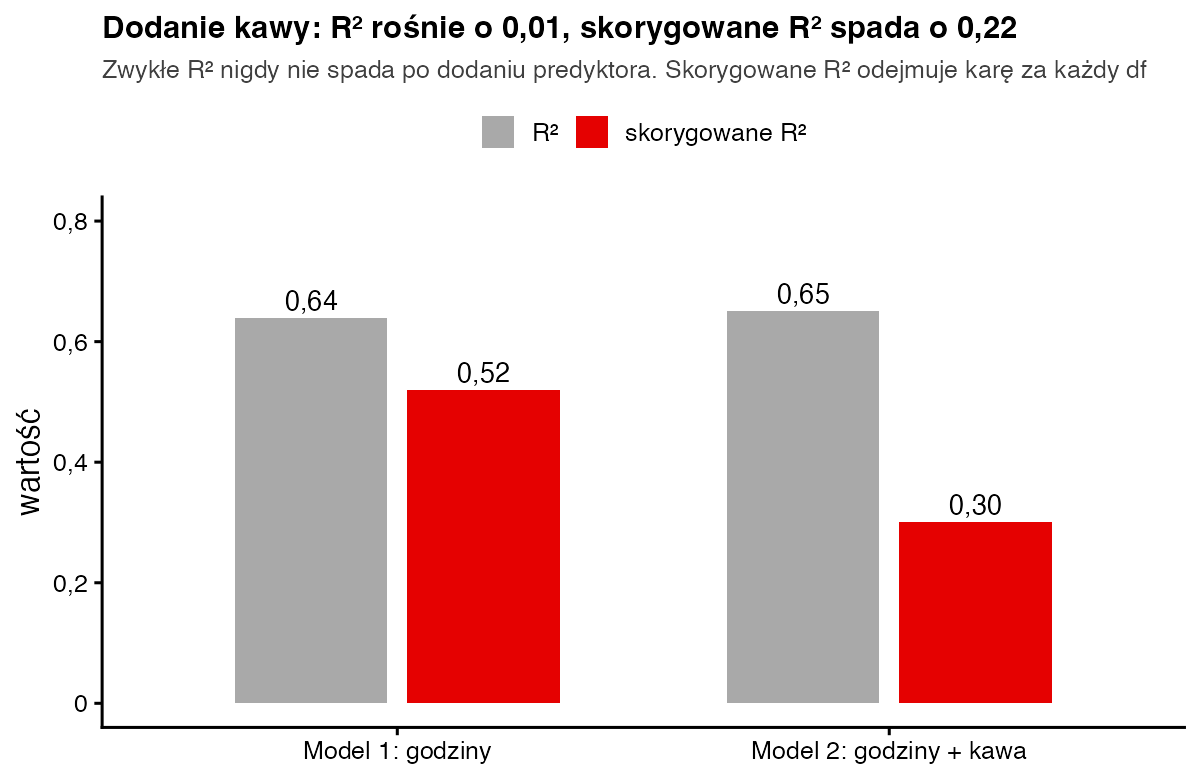
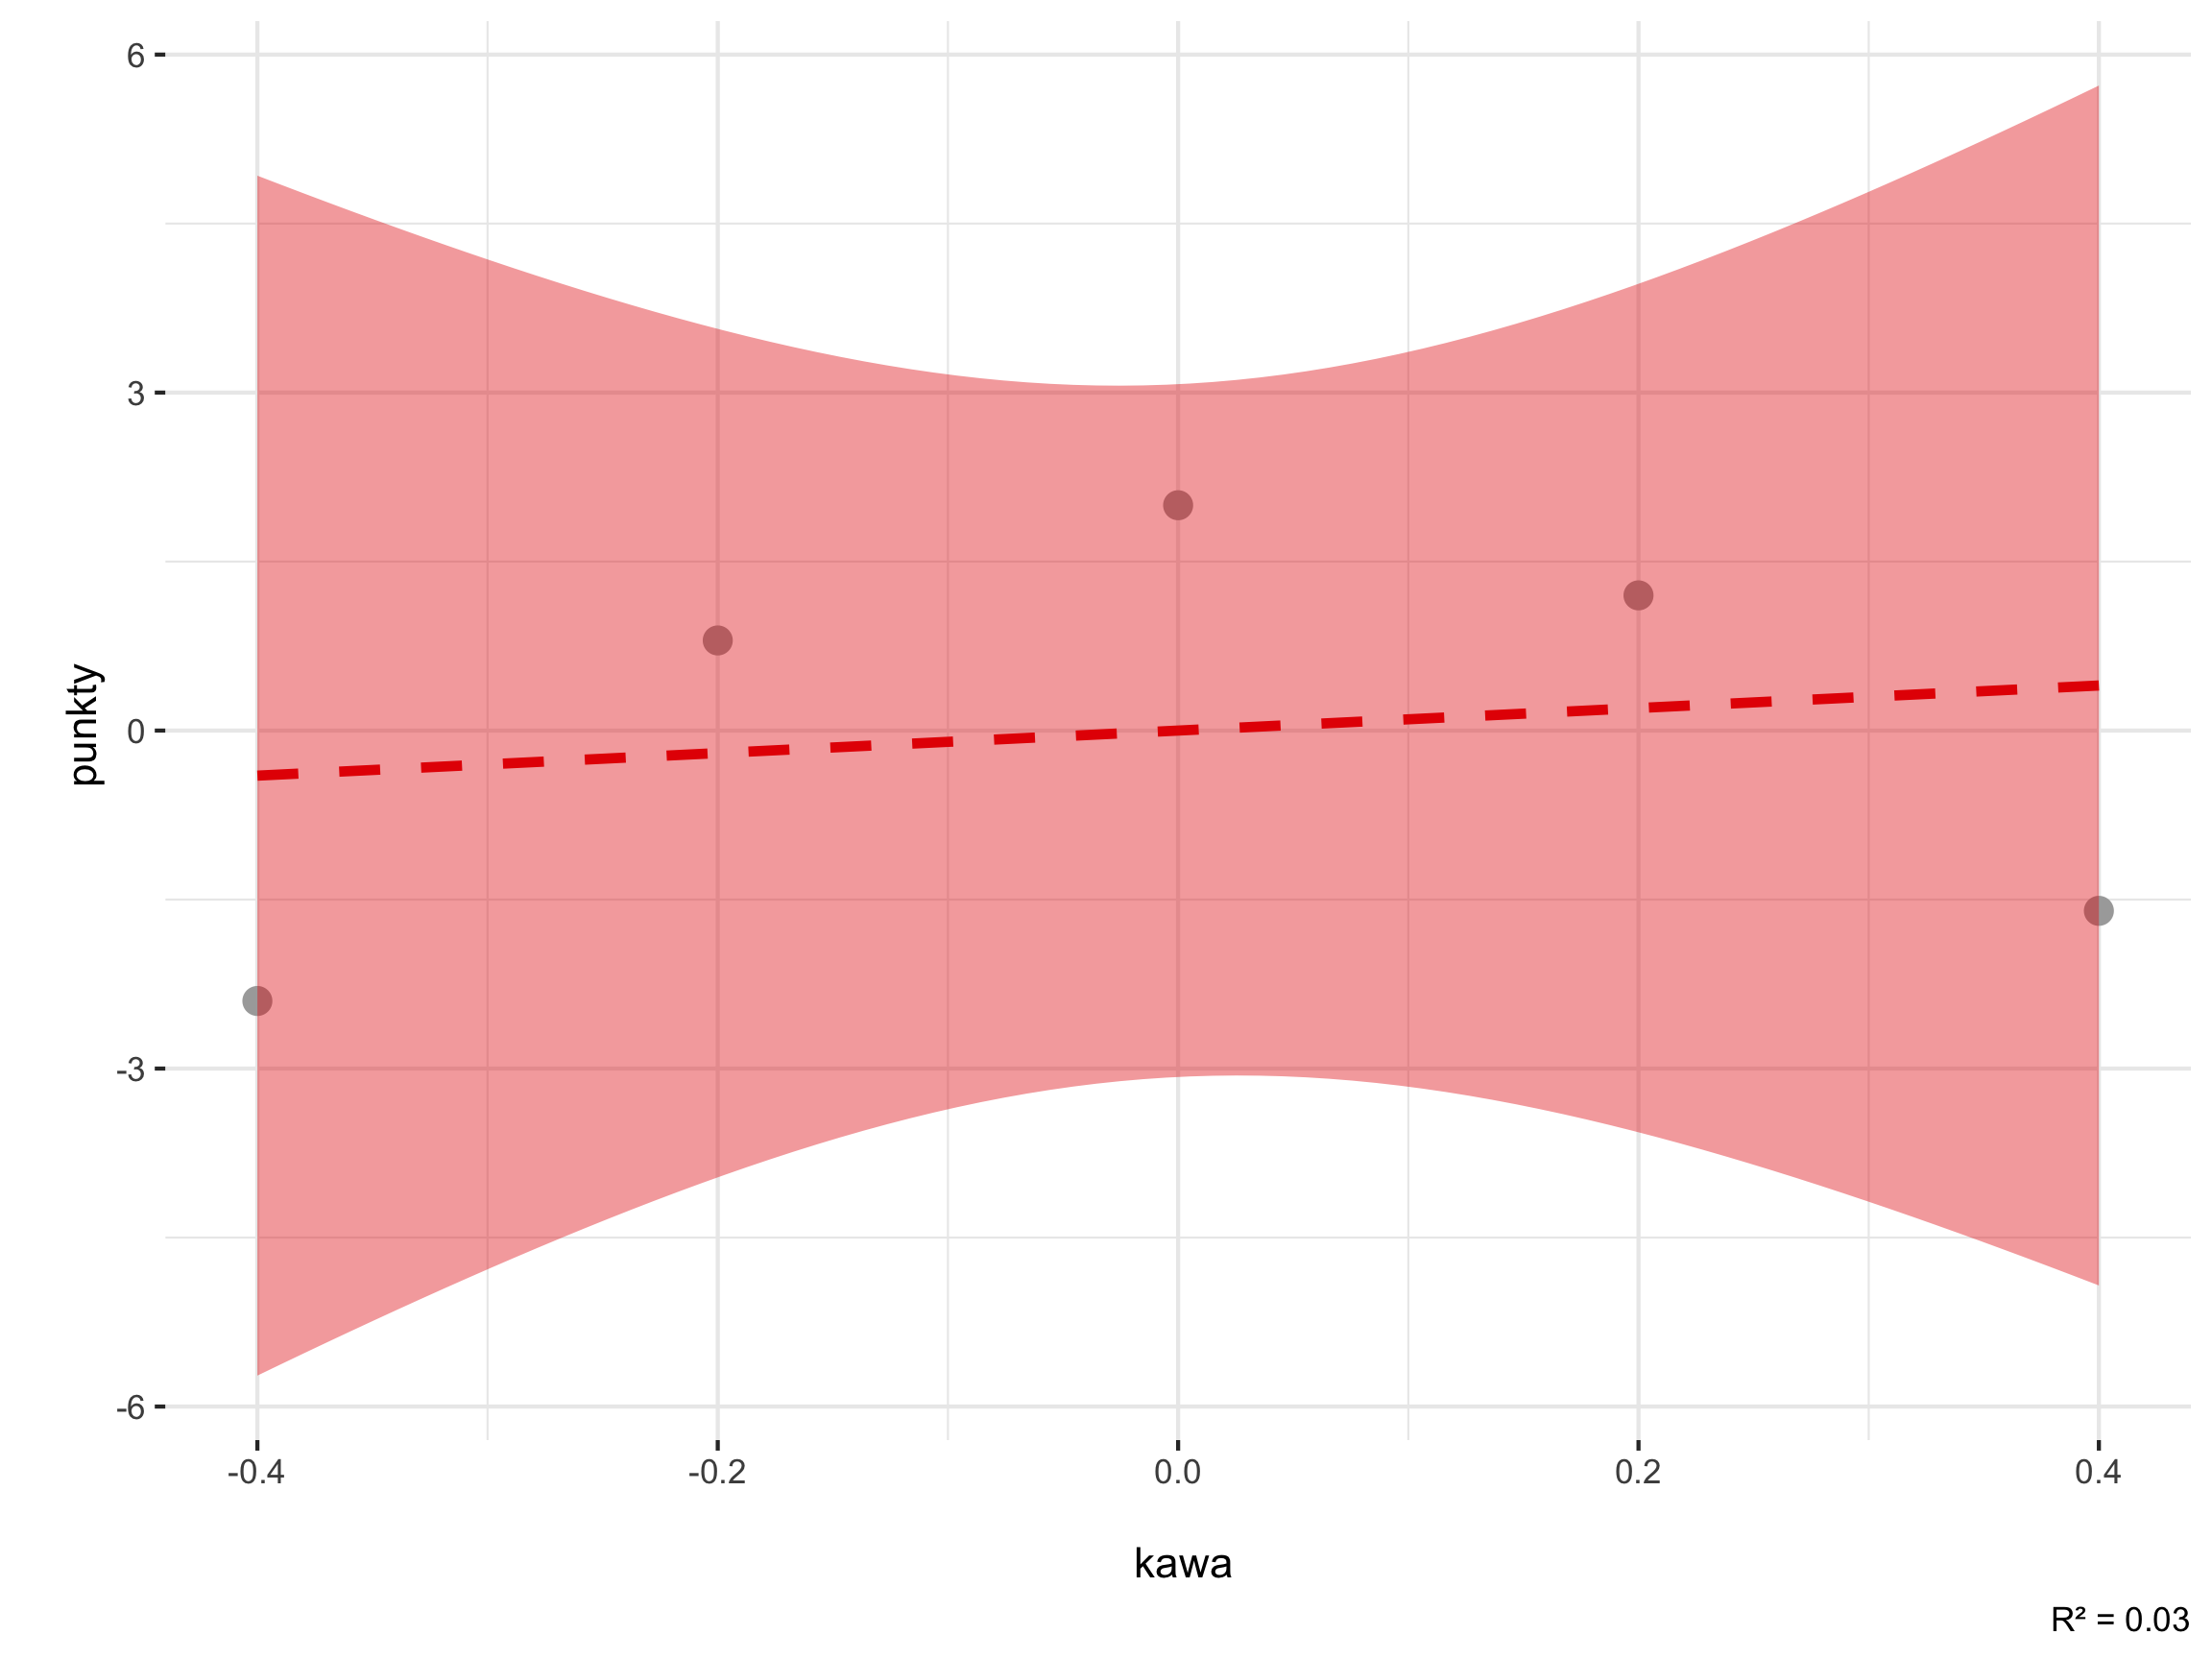
Zwykłe R² ma wadę: po dodaniu dowolnego predyktora nigdy nie spada. Nawet zmienna wylosowana z kapelusza „wyjaśni” odrobinę przypadkowego szumu. Dodajmy do naszych danych liczbę kubków kawy wypitych przed kolokwium: 2, 1, 1, 1, 0. Suma kwadratów reszt spada z 14,4 do 14,0, więc R² rośnie z 0,64 do 1 − 14 / 40 = 0,65. Skorygowane R² mnoży jednak niewyjaśnioną część przez (n − 1)/(n − k − 1). Przy k = 2 to 4 / 2 = 2, więc \(R^2_{adj} = 1 - 0{,}35 \cdot 2 = 0{,}30\). Kawa „kosztowała” jeden stopień swobody, a prawie nic nie dała, więc skorygowane R² spadło z 0,52 do 0,30. Ten sam przyrost R² (ΔR²) przy dokładaniu kolejnych predyktorów służy do oceny interakcji w regresji.
Jak zinterpretować i opisać wynik?
R² = 0,64 oznacza, że model z godzinami nauki odtwarza 64% zmienności punktów. Pozostałe 36% to różnice, których model nie tłumaczy. „Wyjaśnia” jest tu słowem technicznym: R² nie dowodzi, że nauka powoduje wyższe wyniki. Przy pięciu osobach nawet wysokie R² może być przypadkiem – dlatego zawsze podawaj test F i wartość p. Do opisu siły dopasowania możesz użyć progów f² Cohena (1988), przeliczonych na R²: około 0,02 to efekt mały, 0,13 – średni, a 0,26 – duży.
Zapis w stylu APA: Model z liczbą godzin nauki jako predyktorem wyjaśniał 64% zmienności punktów z kolokwium, R² = 0,64; skorygowane R² = 0,52; F(1, 3) = 5,33; p = 0,104. Przy tak małej próbie model nie okazał się istotny statystycznie.
Jak policzyć R² w R?
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)
kawa    <- c(2, 1, 1, 1, 0)

# 1) „ręcznie”, dokładnie według wzoru
model1 <- lm(punkty ~ godziny)
SS_res <- sum(resid(model1)^2)                 # 14.4
SS_cal <- sum((punkty - mean(punkty))^2)       # 40
R2     <- 1 - SS_res / SS_cal                  # 0.64
R2_adj <- 1 - (1 - R2) * (5 - 1) / (5 - 1 - 1) # 0.52
c(SS_res = SS_res, SS_cal = SS_cal, R2 = R2, R2_adj = R2_adj)

# 2) gotowa funkcja: te same liczby w summary()
s1 <- summary(model1)
c(R2 = s1$r.squared, R2_adj = s1$adj.r.squared)

# 3) dokładamy kawę: R² rośnie, skorygowane R² spada
s2 <- summary(lm(punkty ~ godziny + kawa))
c(R2 = s2$r.squared, R2_adj = s2$adj.r.squared)
Wynik w konsoli R:
SS_res SS_cal     R2 R2_adj
 14.40  40.00   0.64   0.52
    R2 R2_adj
  0.64   0.52
    R2 R2_adj
  0.65   0.30
W pełnym wyniku summary(model1) znajdziesz te liczby w wierszu „Multiple R-squared: 0.64, Adjusted R-squared: 0.52”.
Jakie R² jest dobre?
Nie ma jednej granicy. W fizyce model z R² = 0,60 bywa słaby, a w psychologii czy pedagogice R² = 0,20 to często przyzwoity wynik, bo ludzkie zachowanie zależy od wielu czynników. Zamiast pytać „czy to dużo?”, porównaj R² z podobnymi badaniami w literaturze. Pamiętaj też, że bardzo wysokie R² przy małej próbie i wielu predyktorach to raczej sygnał ostrzegawczy niż sukces. Model mógł dopasować się do przypadkowego szumu.
Najczęstsze błędy
- Wybieranie modelu z najwyższym zwykłym R² – ono zawsze rośnie po dodaniu predyktora. Porównuj skorygowane R².
- Pisanie „godziny nauki powodują 64% wyniku” – R² opisuje dopasowanie, a nie przyczynę.
- Mylenie R² z istotnością: wysokie R² może być nieistotne (mała próba), a niskie – istotne (duża próba).
- Podawanie R² bez F, stopni swobody i p.
- Traktowanie niskiego R² jako dowodu, że predyktor „nie działa” – istotny współczynnik może wyjaśniać niewielką, ale ważną część zmienności.
Bibliografia
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówEta kwadrat (η²)
- Słownik wzorówVIF – współliniowość predyktorów
- Słownik wzorówAIC i BIC
- PoradnikRegresja liniowa – przykład
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.