

Analiza równoległa Horna – zasada, przykład i R
Analiza równoległa Horna porównuje wartości własne z Twoich danych z wartościami własnymi, jakie dałby czysty przypadek przy tej samej liczbie osób i pozycji. Typowe pytanie z pracy dyplomowej: ile czynników naprawdę kryje się w kwestionariuszu, a ile to tylko szum?
W prostych słowachNawet zupełnie przypadkowe odpowiedzi dają jakieś korelacje, a więc i wartości własne większe od 1. Analiza równoległa sprawdza, jak duże wartości własne daje sam przypadek. Komputer tworzy setki zbiorów losowych danych tej samej wielkości co Twój i liczy dla nich wartości własne. Zostawiasz tylko te czynniki, które wyraźnie przebijają wynik losowy.
Kiedy stosować analizę równoległą?
- przed eksploracyjną analizą czynnikową (EFA) lub analizą głównych składowych (PCA), aby ustalić liczbę czynników;
- gdy kryterium Kaisera i wykres osypiska dają różne odpowiedzi;
- gdy masz małą próbę albo dużo pozycji – wtedy reguła „λ > 1” myli się najczęściej.
Zanim zaczniesz, sprawdź, czy dane w ogóle nadają się do analizy czynnikowej (KMO i test Bartletta). Po ustaleniu liczby czynników oceniasz ładunki czynnikowe. Wykres osypiska i analizę równoległą krok po kroku omawia też wpis Ile czynników? Wykres osypiska i analiza równoległa.
Wzór (reguła decyzji) analizy równoległej
Na głos: „dla każdego numeru k uśredniamy k-tą wartość własną z B losowych zbiorów danych; czynnik zostaje, dopóki wartość własna z naszych danych jest większa od losowej”.
- \(\lambda_k^{\,obs}\)
- k-ta wartość własna macierzy korelacji Twoich danych (od największej)
- \(\lambda_k^{(b)}\)
- k-ta wartość własna w b-tym zbiorze losowym: n osób, p pozycji, bez żadnych prawdziwych związków
- \(B\)
- liczba zbiorów losowych, zwykle od 100 do 1000; im więcej, tym stabilniejszy wynik
- \(\bar{\lambda}_k^{\,los}\)
- średnia k-tej wartości własnej z szumu – tak liczył Horn (1965)
- \(\lambda_k^{\,los}\)
- próg dla czynnika k: średnia albo ostrożniejszy 95. percentyl wartości losowych (Glorfeld, 1995)
- „dopóki”
- porównujesz po kolei: 1., 2., 3. wartość własną; pierwsza, która przegra z szumem, kończy liczenie
Przykład krok po kroku
Bierzemy te same cztery pozycje skali „stres przed sesją” co w haśle o KMO: każda para koreluje na poziomie r = 0,50, ankietę wypełniło 30 studentów.
| k | λ z danych | średnia z szumu | 95. percentyl szumu | różnica (dane − 95. percentyl) | decyzja |
|---|---|---|---|---|---|
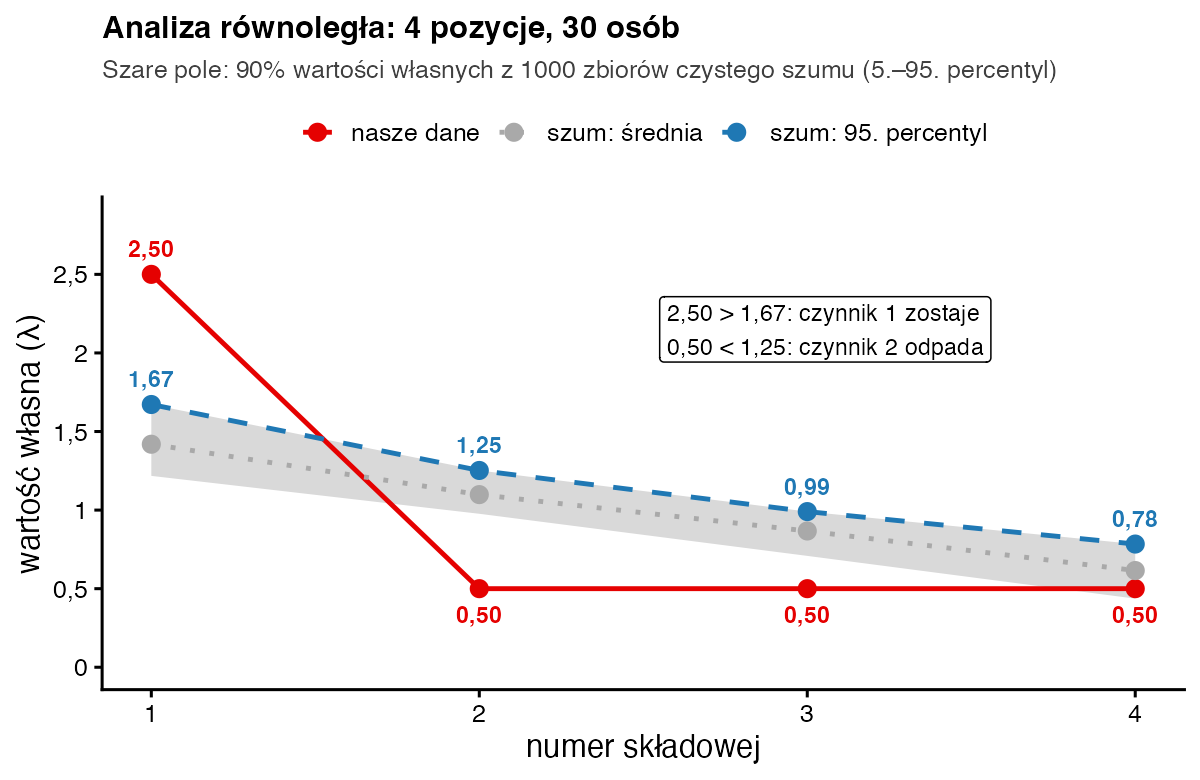
| 1 | 2,500 | 1,419 | 1,672 | 2,500 − 1,672 = 0,828 | zostaje |
| 2 | 0,500 | 1,099 | 1,252 | 0,500 − 1,252 = −0,752 | odpada (koniec) |
| 3 | 0,500 | 0,867 | 0,990 | 0,500 − 0,990 = −0,490 | – |
| 4 | 0,500 | 0,615 | 0,784 | 0,500 − 0,784 = −0,284 | – |
| suma | 4,000 | 4,000 | 1 czynnik |
- Wartości własne z danych. Przy jednakowych korelacjach: λ₁ = 1 + (4 − 1) · 0,5 = 2,5, a pozostałe 1 − 0,5 = 0,5. Suma 2,5 + 3 · 0,5 = 4.
- Jeden zbiór szumu. Losujemy 30 · 4 = 120 liczb z rozkładu normalnego i układamy je w tabelę 30 osób na 4 pozycje. Liczymy korelacje i wartości własne. Pozycje niczego wspólnego nie mierzą, a mimo to pierwsza wartość własna wychodzi zwykle powyżej 1, bo przypadkowe korelacje nie są równe zeru.
- Powtórka 1000 razy. Dla każdego numeru k zapisujemy 1000 wartości własnych. Średnia pierwszej to 1,419, drugiej 1,099. Suma średnich znów wynosi 4, bo w każdym zbiorze wartości własne sumują się do liczby pozycji.
- Próg. Bierzemy 95. percentyl: wartość, której przypadek nie przekracza w 95% zbiorów. Dla k = 1 to 1,672, dla k = 2 to 1,252.
- Porównanie pierwszej wartości. 2,500 − 1,672 = 0,828 > 0. Pierwszy czynnik jest wyraźnie silniejszy niż szum, więc zostaje.
- Porównanie drugiej wartości. 0,500 − 1,252 = −0,752 < 0. Drugi czynnik przegrywa z szumem. Tu kończymy: dalszych wartości już nie sprawdzamy.
- Wynik. Jeden czynnik. Ze średnią zamiast percentyla wynik jest ten sam: 2,500 > 1,419, ale 0,500 < 1,099.
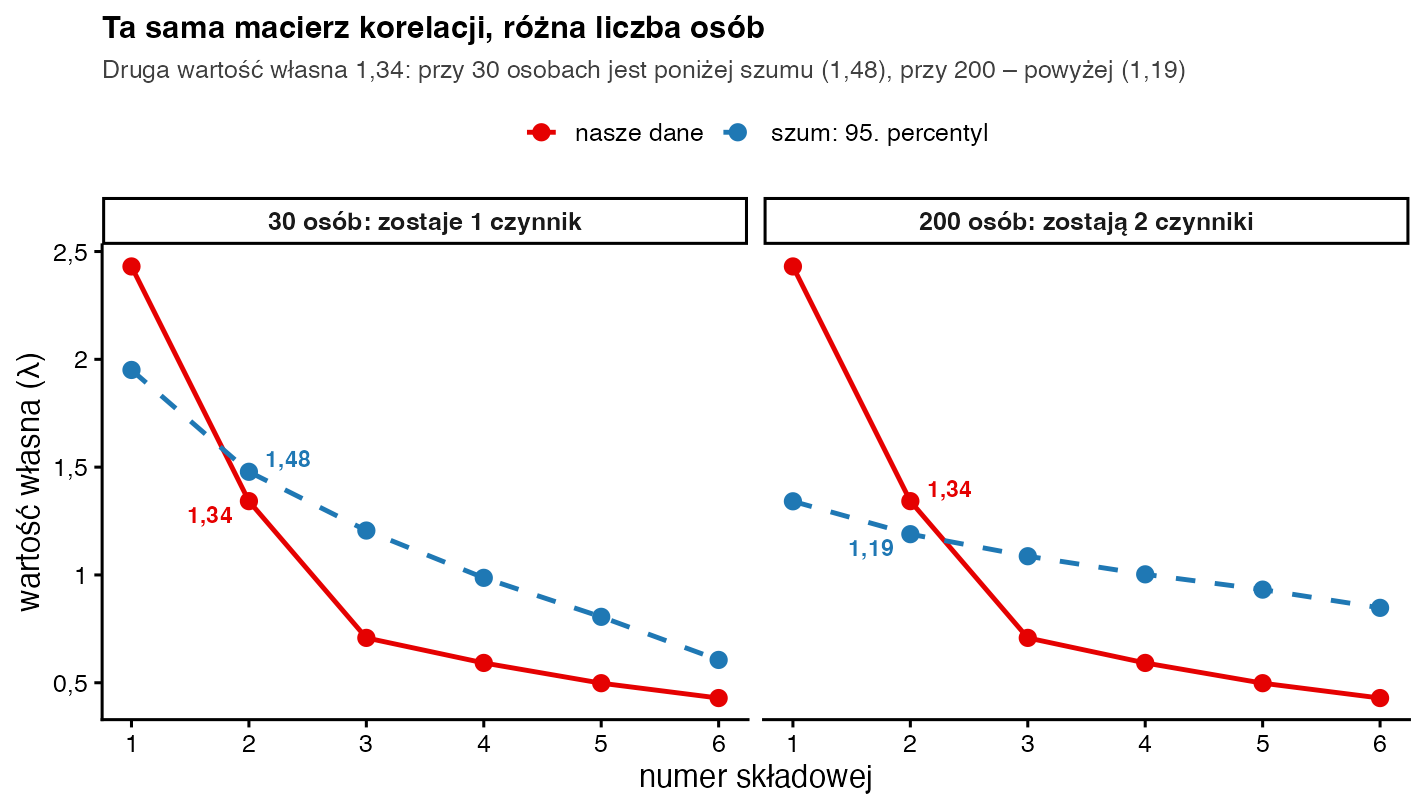
Drugi przykład pokazuje, że próg zależy od liczby osób. Sześć pozycji z wpisu Analiza czynnikowa – przykład ma wartości własne 2,43 i 1,34. Przy 200 osobach 95. percentyl szumu to 1,34 i 1,19. Druga wartość przebija szum (1,34 > 1,19), więc zostają dwa czynniki. Gdyby tę samą macierz korelacji uzyskać od 30 osób, progi rosną do 1,95 i 1,48. Wtedy 1,34 < 1,48 i zostaje jeden czynnik. Mała próba daje dużo przypadkowych korelacji, więc poprzeczka idzie w górę.
Jak zinterpretować i opisać wynik?
Wynik analizy równoległej to liczba czynników, których siła wyraźnie przekracza to, co daje przypadek przy Twojej liczbie osób i pozycji. W przeglądach metod (Zwick i Velicer, 1986; Hayton i in., 2004) należy ona do najtrafniejszych reguł. Wersja z 95. percentylem jest nieco ostrożniejsza niż ze średnią. Podaj w pracy, której wersji użyłeś, ile było zbiorów losowych i czy liczyłeś wartości własne składowych (PCA), czy czynników. Pamiętaj, że to wskazówka, a nie wyrok. Czynnik, którego pozycji nie umiesz sensownie nazwać, nie stanie się dobry tylko dlatego, że przebił szum.
Zapis w stylu APA: Liczbę czynników ustalono analizą równoległą Horna (1000 zbiorów losowych, 95. percentyl). Tylko pierwsza wartość własna (λ = 2,50) przekraczała odpowiadającą jej wartość z danych losowych (1,67), dlatego wyodrębniono jeden czynnik.
Jak zrobić analizę równoległą w R?
R <- matrix(0.5, 4, 4); diag(R) <- 1      # 4 pozycje skali stresu, r = 0.5
n <- 30; p <- 4                            # 30 studentów
obs <- eigen(R)$values                     # 2.5 0.5 0.5 0.5

# 1) „ręcznie”: 1000 zbiorów czystego szumu o tym samym n i p
set.seed(2026)
los <- replicate(1000, eigen(cor(matrix(rnorm(n * p), n)), only.values = TRUE)$values)
tab <- rbind(obs = obs, srednia = rowMeans(los), p95 = apply(los, 1, quantile, 0.95))
round(tab, 3)
sum(cumprod(obs > tab["p95", ]))           # ile pierwszych przebija szum: 1

# 2) gotowa funkcja z pakietu psych
set.seed(2026)
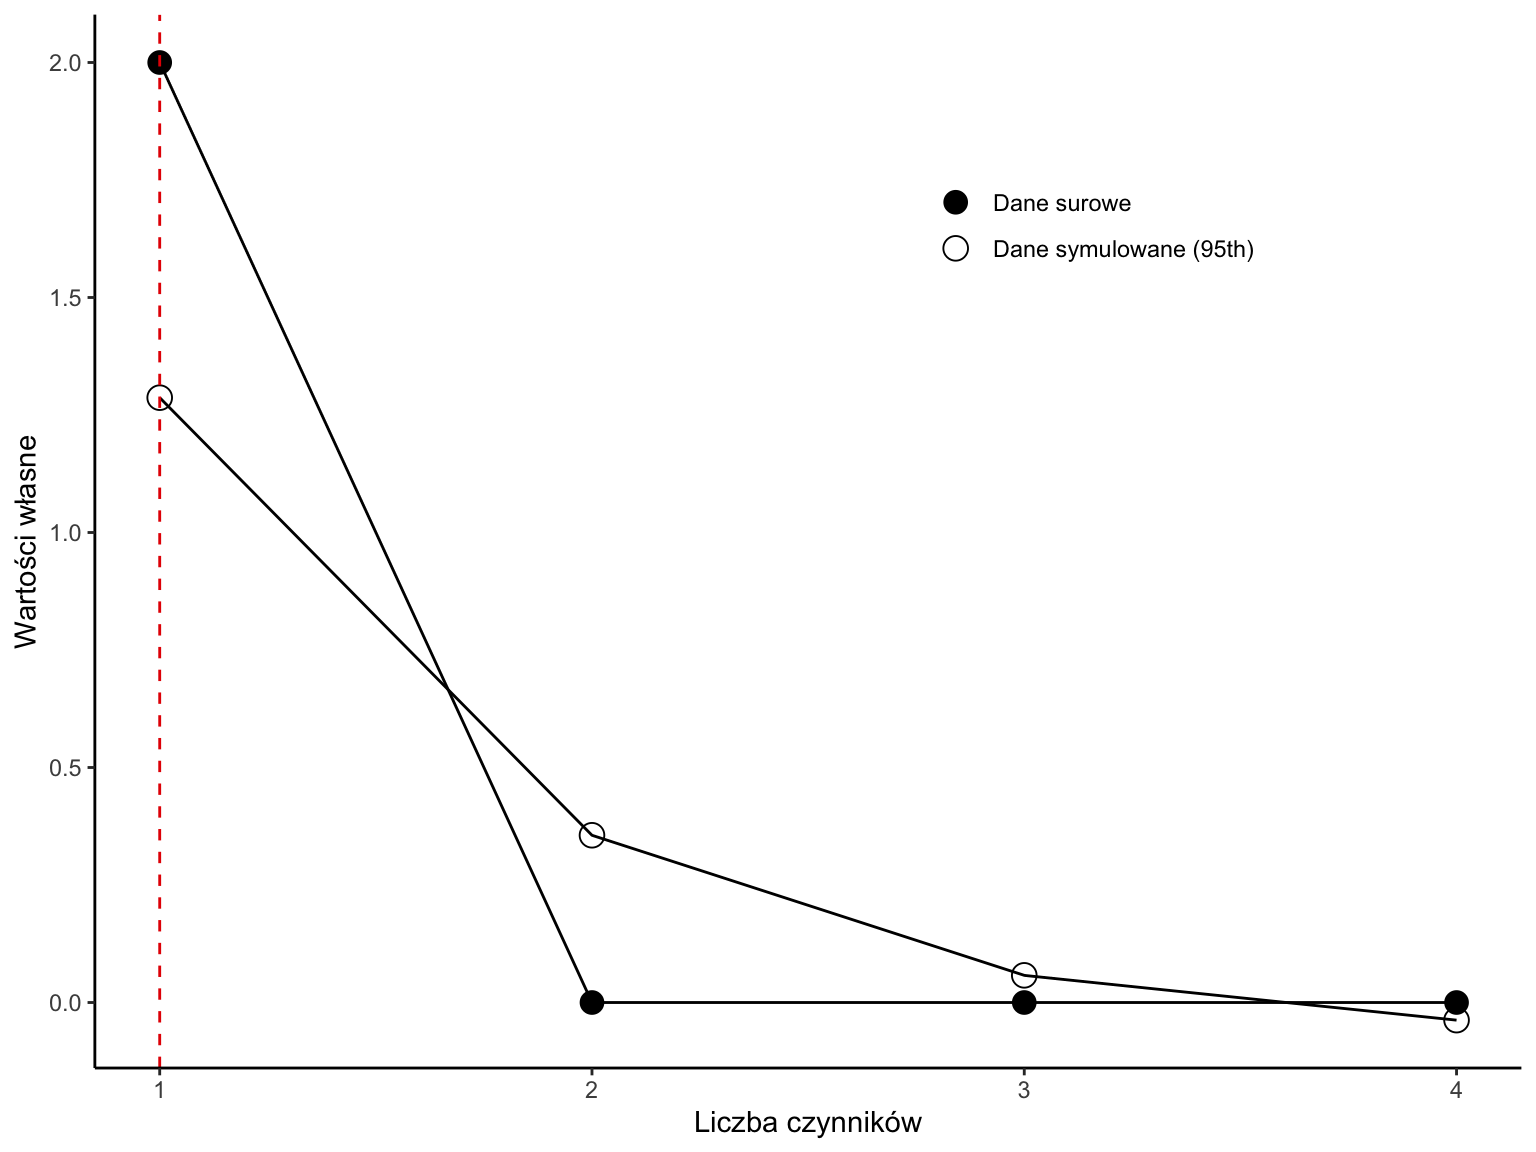
psych::fa.parallel(R, n.obs = n, fa = "pc", n.iter = 1000, plot = FALSE)$ncomp

# 3) 6 pozycji (stres S1–S3, motywacja M1–M3): wynik zależy od n
r <- c(.56, .48, -.26, -.19, -.16, .42, -.22, -.17, -.14, -.19, -.14, -.12, .48, .40, .30)
R6 <- diag(6); R6[lower.tri(R6)] <- r; R6 <- R6 + t(R6) - diag(6)
p95 <- function(n) { set.seed(2026)
  apply(replicate(1000, eigen(cor(matrix(rnorm(n * 6), n)))$values), 1, quantile, 0.95) }
round(rbind(obs = eigen(R6)$values, n30 = p95(30), n200 = p95(200))[, 1:3], 2)
Wynik w konsoli R:
         [,1]  [,2]  [,3]  [,4]
obs     2.500 0.500 0.500 0.500
srednia 1.419 1.099 0.867 0.615
p95     1.672 1.252 0.990 0.784
[1] 1
Parallel analysis suggests that the number of factors =  NA  and the number of components =  1
[1] 1
     [,1] [,2] [,3]
obs  2.43 1.34 0.71
n30  1.95 1.48 1.21
n200 1.34 1.19 1.09
Na surowych danych wystarczy psych::fa.parallel(dane, fa = "pc") dla składowych albo fa = "fa", fm = "ml" dla czynników. W naszym przykładzie funkcja porównała dane ze średnią szumu (pole $pc.sim: około 1,4 i 1,1) i bez plot = FALSE od razu rysuje wykres. W ręcznej części kodu set.seed() sprawia, że tabela wychodzi zawsze taka sama. Wyniki fa.parallel() mogą się jednak nieznacznie różnić między uruchomieniami nawet po ustawieniu ziarna. Wskazana liczba czynników zwykle się nie zmienia.
Ile zbiorów losowych i czy średnia, czy 95. percentyl?
Horn (1965) używał średniej. Glorfeld (1995) zauważył, że średnia czasem przepuszcza o jeden czynnik za dużo, i zaproponował 95. percentyl. Dziś oba warianty są w użyciu. Gdy dają różne wyniki, czynnik jest „na granicy” i warto sprawdzić oba rozwiązania pod kątem treści pozycji. Liczba zbiorów losowych powinna wynosić co najmniej kilkaset, żeby percentyl nie skakał przy każdym uruchomieniu. Przy 20 zbiorach (domyślnie w fa.parallel) średnia jest zwykle stabilna, ale percentyl już mniej.
Najczęstsze błędy
- Porównywanie wartości własnych PCA z progiem wyliczonym dla wersji czynnikowej (albo odwrotnie) – obie strony muszą być liczone tak samo.
- Kontynuowanie liczenia po pierwszej przegranej z szumem, np. zostawienie czynnika 1 i 3 przy przegranym 2.
- Brak informacji w pracy, ile było zbiorów losowych i czy próg to średnia, czy 95. percentyl.
- Uznanie analizy równoległej za dowód, że czynniki „istnieją” – to tylko reguła liczbowa; nazwy i sens czynników uzasadniasz treścią pytań.
- Liczenie analizy na macierzy korelacji bez podania prawdziwej liczby osób – wynik bardzo zależy od n.
Bibliografia
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Glorfeld, L. W. (1995). An improvement on Horn's parallel analysis methodology for selecting the correct number of factors to retain. Educational and Psychological Measurement, 55(3), 377–393.
- Zwick, W. R., & Velicer, W. F. (1986). Comparison of five rules for determining the number of components to retain. Psychological Bulletin, 99(3), 432–442.
- Hayton, J. C., Allen, D. G., & Scarpello, V. (2004). Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis. Organizational Research Methods, 7(2), 191–205.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówWartość własna i kryterium Kaisera
- Słownik wzorówŁadunek czynnikowy
- Słownik wzorówKMO i test Bartletta
- PoradnikAnaliza czynnikowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza czynnikowa
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.