

Ładunek czynnikowy – wzór, interpretacja i przykład
Ładunek czynnikowy mówi, jak silnie dana pozycja kwestionariusza jest związana z czynnikiem, czyli z ukrytą cechą, którą mierzy skala. Typowe pytanie z pracy dyplomowej: czy wszystkie trzy pytania o stres przed sesją rzeczywiście mierzą stres i które z nich robi to najlepiej?
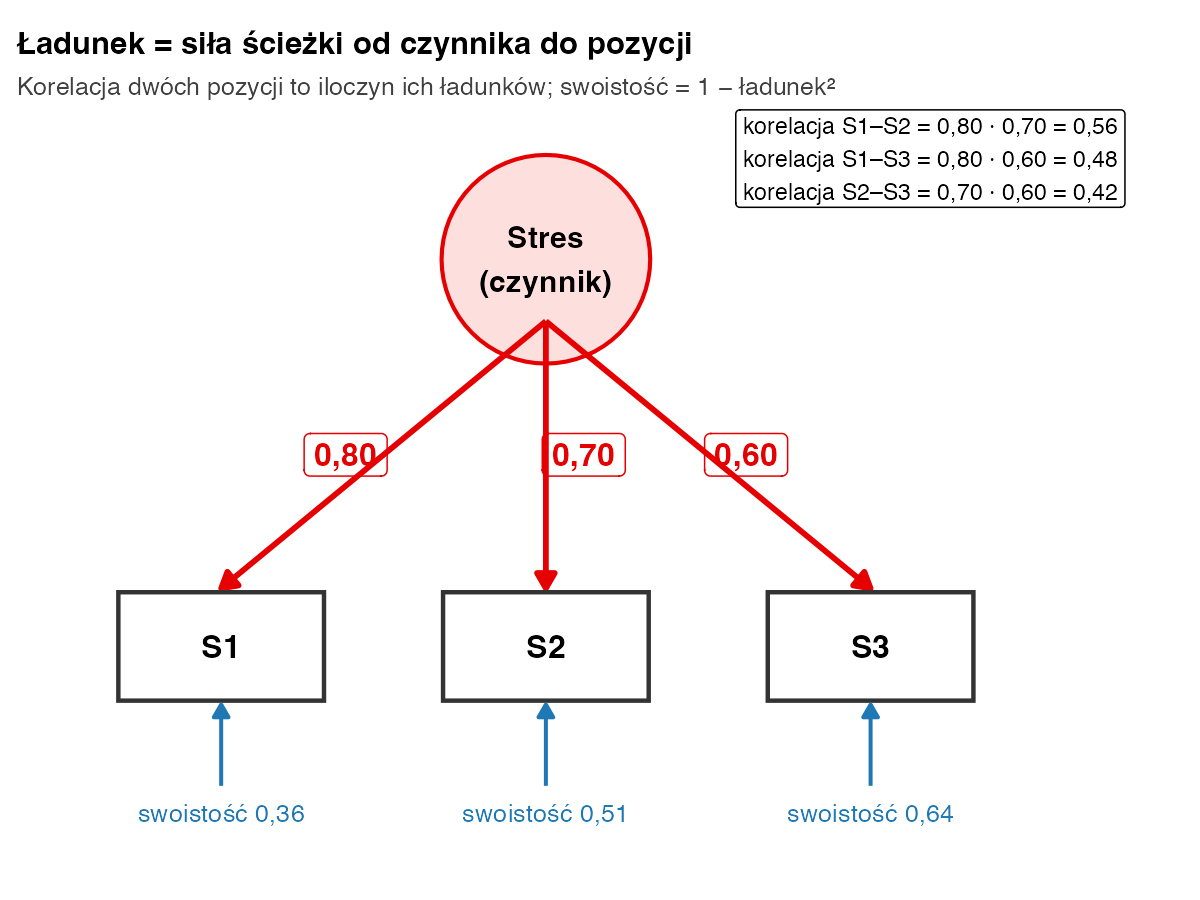
W prostych słowachWyobraź sobie, że stres przed sesją to niewidoczna przyczyna, która podnosi odpowiedzi na kilka pytań naraz. Ładunek pokazuje, jak mocno ta przyczyna „ciągnie” odpowiedzi na konkretne pytanie. W najprostszym modelu ładunek to po prostu korelacja pytania z czynnikiem. Podniesiony do kwadratu mówi, jaka część zróżnicowania odpowiedzi pochodzi od czynnika.
Kiedy patrzeć na ładunki czynnikowe?
- w eksploracyjnej analizie czynnikowej (EFA), żeby przypisać pozycje do czynników i nazwać czynniki;
- w konfirmacyjnej analizie czynnikowej (CFA), żeby ocenić, czy każda pozycja dobrze mierzy swój czynnik;
- przy ocenie skali: na ładunkach opierają się m.in. CR i AVE oraz omega McDonalda.
Zanim zinterpretujesz ładunki, ustal liczbę czynników (wartości własne i analiza równoległa). Przy kilku czynnikach ładunki czyta się dopiero po rotacji. Prostszym, „surowym” odpowiednikiem ładunku jest korelacja pozycja–całość.
Wzór na ładunek czynnikowy
Na głos: „wynik standaryzowany pozycji to ładunek razy czynnik plus część własna pozycji; korelacja dwóch pozycji to iloczyn ich ładunków, a ładunek do kwadratu to wspólność”.
- \(z_i\)
- standaryzowana odpowiedź na pozycję i (średnia 0, wariancja 1)
- \(F\)
- czynnik – ukryta cecha, np. stres przed sesją, też ze średnią 0 i wariancją 1
- \(\lambda_i\)
- ładunek pozycji i (lambda): przy jednym czynniku lub czynnikach nieskorelowanych to korelacja pozycji z czynnikiem, od −1 do 1
- \(e_i\)
- część swoista: to, co w odpowiedzi nie pochodzi od czynnika (specyfika pytania i błąd pomiaru)
- \(r_{ij}\)
- korelacja pozycji i oraz j; w modelu jednoczynnikowym cała wynika ze wspólnego czynnika
- \(h_i^2\)
- wspólność: część wariancji pozycji wyjaśniona przez czynnik (lub czynniki – wtedy suma kwadratów ładunków)
- \(u_i^2\)
- swoistość (unikalność): pozostała część wariancji, 1 − h²
Przykład krok po kroku
Dwieście osób odpowiedziało na trzy pytania o stres przed sesją (S1–S3). Korelacje: S1–S2 = 0,56; S1–S3 = 0,48; S2–S3 = 0,42. Przy jednym czynniku i trzech pozycjach ładunki da się policzyć na kartce.
| pozycja | licznik (iloczyn jej dwóch korelacji) | mianownik (trzecia korelacja) | λ² | λ = √λ² | h² = λ² | u² = 1 − h² |
|---|---|---|---|---|---|---|
| S1 | 0,56 · 0,48 = 0,2688 | 0,42 | 0,2688 / 0,42 = 0,64 | 0,80 | 0,64 | 0,36 |
| S2 | 0,56 · 0,42 = 0,2352 | 0,48 | 0,2352 / 0,48 = 0,49 | 0,70 | 0,49 | 0,51 |
| S3 | 0,48 · 0,42 = 0,2016 | 0,56 | 0,2016 / 0,56 = 0,36 | 0,60 | 0,36 | 0,64 |
| suma | 1,49 | 1,49 | 1,51 |
- Skąd wzór triady. W modelu jednoczynnikowym r₁₂ = λ₁λ₂, r₁₃ = λ₁λ₃ i r₂₃ = λ₂λ₃. Mnożymy dwie pierwsze: r₁₂ · r₁₃ = λ₁² · λ₂λ₃. Dzielimy przez r₂₃ = λ₂λ₃ i zostaje λ₁².
- Ładunek S1. 0,56 · 0,48 = 0,2688. Dzielimy przez 0,42: 0,2688 / 0,42 = 0,64. Pierwiastek: √0,64 = 0,80.
- Ładunek S2. 0,56 · 0,42 = 0,2352; 0,2352 / 0,48 = 0,49; √0,49 = 0,70.
- Ładunek S3. 0,48 · 0,42 = 0,2016; 0,2016 / 0,56 = 0,36; √0,36 = 0,60.
- Sprawdzenie. Odtwarzamy korelacje z ładunków: 0,80 · 0,70 = 0,56; 0,80 · 0,60 = 0,48; 0,70 · 0,60 = 0,42. Zgadza się co do setnej części.
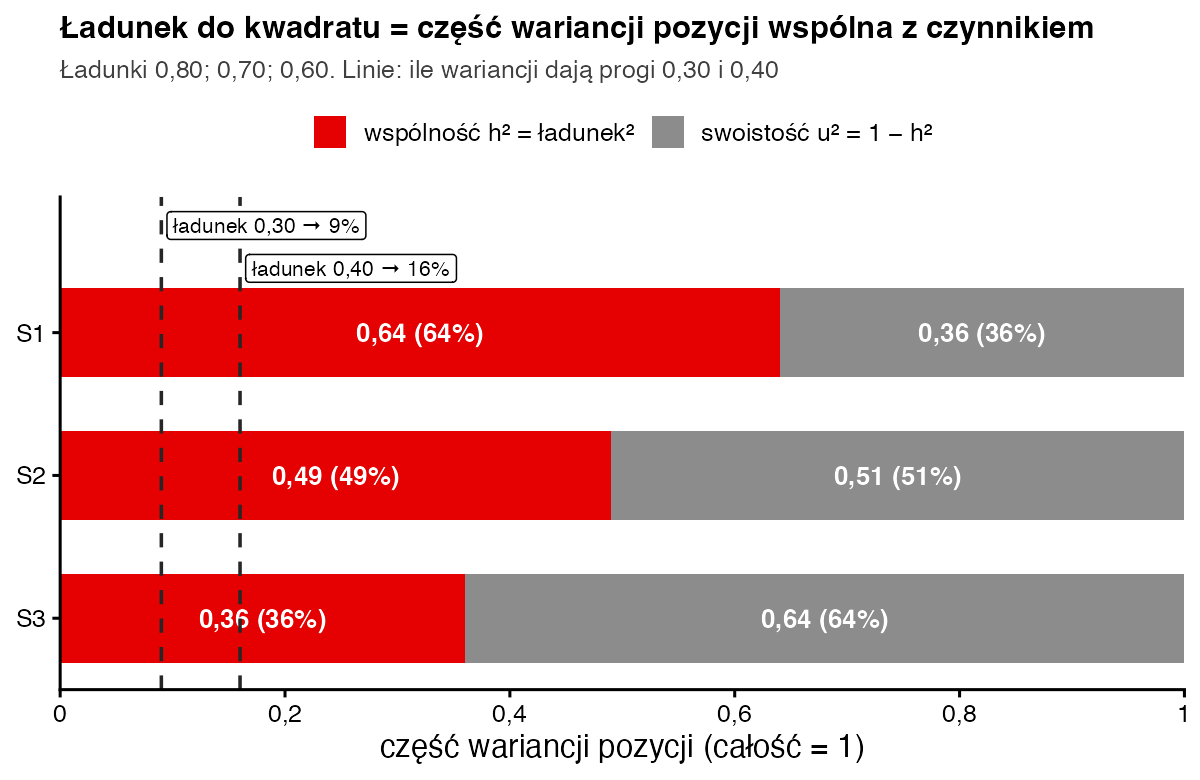
- Wspólność i swoistość. S1: 0,80² = 0,64, czyli 64% wariancji odpowiedzi pochodzi od stresu, a 1 − 0,64 = 0,36 to część swoista. S2: 0,49 i 0,51. S3: 0,36 i 0,64.
- Ile wyjaśnia czynnik. Suma kwadratów ładunków: 0,64 + 0,49 + 0,36 = 1,49. Dzielimy przez 3 pozycje: 1,49 / 3 = 0,497. Czynnik wyjaśnia prawie 50% wariancji trzech pytań. To ta sama liczba co AVE w haśle o CR i AVE.
Jak zinterpretować i opisać wynik?
Im wyższy ładunek, tym lepiej pozycja mierzy czynnik. Popularne progi to 0,30 lub 0,40: pozycję z niższym ładunkiem uznaje się za słabo związaną z czynnikiem. Tabachnick i Fidell (2013) przyjmują minimum 0,32, czyli około 10% wspólnej wariancji. Pamiętaj, że to umowne reguły kciuka. Stevens (2002) wiązał próg z liczebnością próby: przy małej próbie ładunek 0,40 może być przypadkowy. Przy kilku skorelowanych czynnikach program podaje dwie tabele. Macierz wzoru (ang. pattern) zawiera wagi regresji i to ją zwykle się raportuje. Macierz struktury (ang. structure) to korelacje pozycji z czynnikami. W przykładzie sześciu pozycji ze stresem i motywacją (wynik w R niżej) S1 ma ładunek wzoru 0,00 na motywacji, ale korelację −0,32. Wynika ona tylko z korelacji czynników: 0,80 · (−0,40) = −0,32.
Zapis w stylu APA: W jednoczynnikowej analizie czynnikowej metodą największej wiarygodności wszystkie trzy pozycje miały wysokie ładunki na czynniku stresu przed sesją (0,80; 0,70 i 0,60), a ich wspólności wynosiły od 0,36 do 0,64. Czynnik wyjaśniał 49,7% wariancji pozycji.
Jak policzyć ładunki czynnikowe w R?
library(psych); library(GPArotation, warn.conflicts = FALSE)
r12 <- 0.56; r13 <- 0.48; r23 <- 0.42        # korelacje 3 pozycji stresu (n = 200)

# 1) „ręcznie”: model jednoczynnikowy, r_ij = λ_i · λ_j (wzór triady)
lam <- c(S1 = sqrt(r12 * r13 / r23), S2 = sqrt(r12 * r23 / r13), S3 = sqrt(r13 * r23 / r12))
round(rbind(ladunek = lam, wspolnosc = lam^2, swoistosc = 1 - lam^2), 2)
unname(c(lam[1] * lam[2], lam[1] * lam[3], lam[2] * lam[3]))  # odtworzone r
sum(lam^2) / 3                                         # wariancja wyjaśniona przez czynnik

# 2) gotowa funkcja: EFA metodą największej wiarygodności
R3 <- matrix(c(1, r12, r13, r12, 1, r23, r13, r23, 1), 3)
f1 <- fa(R3, nfactors = 1, n.obs = 200, fm = "ml")
round(cbind(ladunek = f1$loadings[, 1], h2 = f1$communality, u2 = f1$uniquenesses), 2)

# 3) 6 pozycji, 2 skorelowane czynniki: wzór (pattern) a struktura
r <- c(.56, .48, -.26, -.19, -.16, .42, -.22, -.17, -.14, -.19, -.14, -.12, .48, .40, .30)
R6 <- diag(6); R6[lower.tri(R6)] <- r; R6 <- R6 + t(R6) - diag(6)
f2 <- fa(R6, nfactors = 2, n.obs = 200, fm = "ml", rotate = "oblimin")
tab <- cbind(f2$loadings[, 1:2], f2$Structure[, 1:2])
dimnames(tab) <- list(c("S1", "S2", "S3", "M1", "M2", "M3"), c("wzor_S", "wzor_M", "strukt_S", "strukt_M"))
round(tab, 2)
Wynik w konsoli R:
            S1   S2   S3
ladunek   0.80 0.70 0.60
wspolnosc 0.64 0.49 0.36
swoistosc 0.36 0.51 0.64
[1] 0.56 0.48 0.42
[1] 0.4966667
     ladunek   h2   u2
[1,]     0.8 0.64 0.36
[2,]     0.7 0.49 0.51
[3,]     0.6 0.36 0.64
   wzor_S wzor_M strukt_S strukt_M
S1    0.8    0.0     0.80    -0.32
S2    0.7    0.0     0.70    -0.28
S3    0.6    0.0     0.60    -0.24
M1    0.0    0.8    -0.32     0.80
M2    0.0    0.6    -0.24     0.60
M3    0.0    0.5    -0.20     0.50
Na surowych danych wpisujesz fa(dane, nfactors = 1, fm = "ml"). Kolumna h2 to wspólność, u2 to swoistość. Przy trzech pozycjach i jednym czynniku model ma zero stopni swobody, więc R nie oceni jego dopasowania – ładunki są jednak poprawne.
Ładunek czynnikowy a korelacja pozycja–całość – czym się różnią?
Korelacja pozycja–całość to korelacja pytania z sumą pozostałych pytań skali. Liczysz ją bez żadnego modelu. Ładunek to korelacja pytania z ukrytym czynnikiem, oczyszczonym z części swoistych wszystkich pozycji. Dlatego ładunki są zwykle nieco wyższe niż skorygowane korelacje pozycja–całość. Oba wskaźniki zwykle wskazują te same słabe pytania. W pracy z analizą czynnikową podawaj ładunki, a przy samej alfie Cronbacha wystarczą korelacje pozycja–całość.
Najczęstsze błędy
- Traktowanie progu 0,30 lub 0,40 jak sztywnej granicy i usuwanie pozycji z ładunkiem 0,39 bez zajrzenia do treści pytania.
- Interpretowanie ładunków przed rotacją, gdy czynników jest więcej niż jeden.
- Mylenie macierzy wzoru z macierzą struktury przy rotacji skośnej i raportowanie raz jednej, raz drugiej.
- Ignorowanie znaku: ujemny ładunek często oznacza nieprzekodowane pytanie odwrócone.
- Podawanie ładunków z analizy głównych składowych jako „czynnikowych” – PCA daje zwykle ładunki wyższe niż EFA.
Bibliografia
- Comrey, A. L., & Lee, H. B. (1992). A first course in factor analysis (2nd ed.). Lawrence Erlbaum Associates.
- Stevens, J. P. (2002). Applied multivariate statistics for the social sciences (4th ed.). Lawrence Erlbaum Associates.
- Tabachnick, B. G., & Fidell, L. S. (2013). Using multivariate statistics (6th ed.). Pearson.
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRotacja czynników (varimax, oblimin)
- Słownik wzorówWartość własna i kryterium Kaisera
- Słownik wzorówCR i AVE (Fornell-Larcker)
- Słownik wzorówKorelacja pozycja–całość
- PoradnikAnaliza czynnikowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza czynnikowa
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.