

KMO i test sferyczności Bartletta – wzory i przykład
Miara KMO (Kaisera-Meyera-Olkina) i test sferyczności Bartletta sprawdzają, czy dane w ogóle nadają się do analizy czynnikowej. Przykładowe pytanie z pracy dyplomowej: czy cztery pozycje kwestionariusza stresu przed sesją mają ze sobą na tyle dużo wspólnego, że warto szukać w nich wspólnego czynnika?
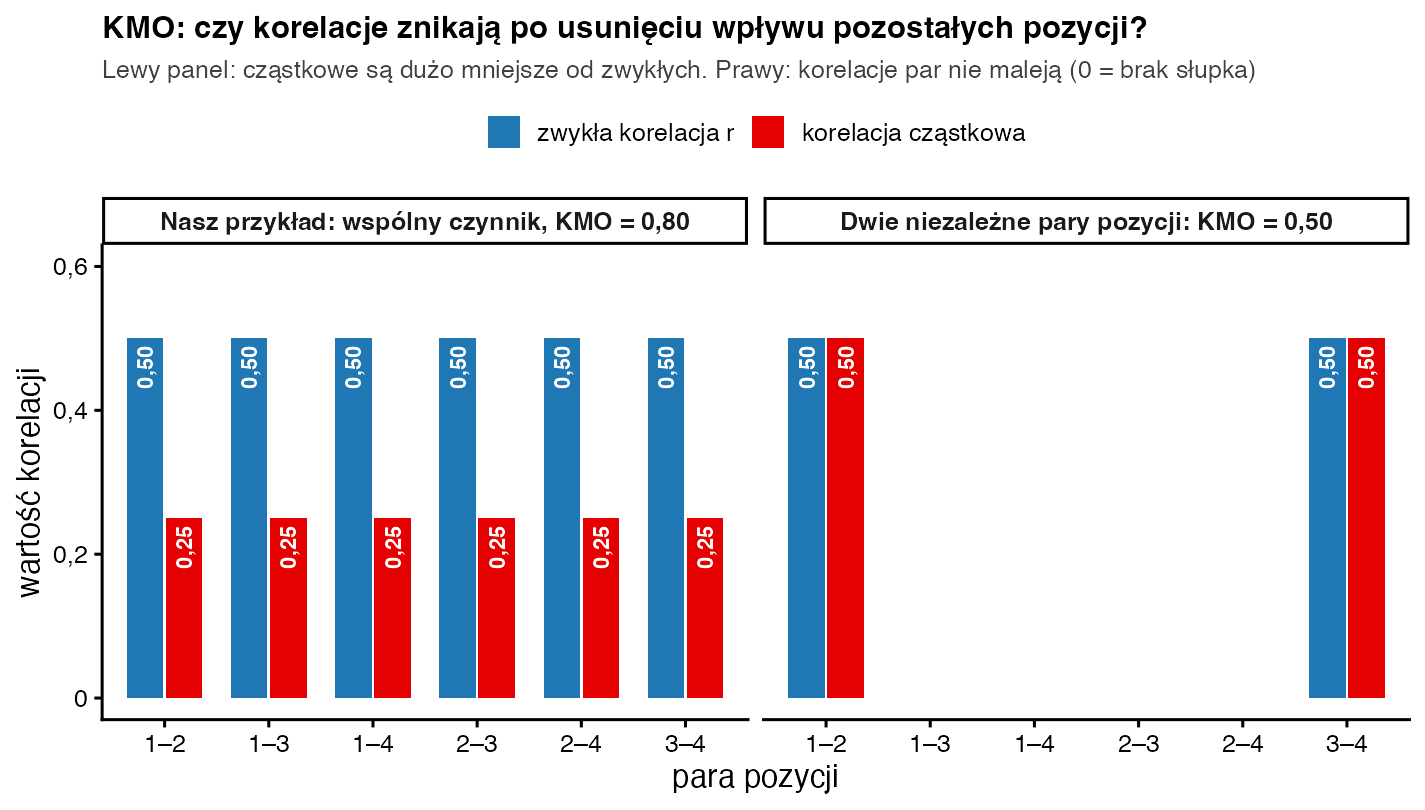
W prostych słowachAnaliza czynnikowa szuka ukrytej cechy, która „spina” kilka pytań. Test Bartletta sprawdza najprostszą rzecz: czy pytania są w ogóle ze sobą skorelowane. KMO sprawdza coś subtelniejszego: czy korelacje wynikają z czegoś wspólnego dla wszystkich pytań, a nie tylko z powiązań pojedynczych par. Gdy po usunięciu wpływu pozostałych pytań korelacje pary prawie znikają, KMO jest wysokie.
Kiedy stosować KMO i test Bartletta?
- przed eksploracyjną analizą czynnikową (EFA) lub analizą głównych składowych (PCA), jako sprawdzenie warunków wstępnych;
- masz kilka pozycji ilościowych lub porządkowych (np. skala 1–5) z tej samej ankiety;
- masz macierz korelacji tych pozycji i liczbę osób (do testu Bartletta).
Oba wskaźniki dotyczą całej macierzy korelacji Pearsona między pozycjami. KMO opiera się na korelacjach cząstkowych. Po analizie czynnikowej rzetelność skali opiszesz alfą Cronbacha, a w modelu konfirmacyjnym – wskaźnikami CR i AVE. Gotowy raport z całą procedurą zobaczysz w przykładowym raporcie z analizy czynnikowej.
Wzory na KMO i test Bartletta
Na głos: „KMO to suma kwadratów zwykłych korelacji podzielona przez tę samą sumę plus sumę kwadratów korelacji cząstkowych; chi-kwadrat Bartletta to minus logarytm wyznacznika macierzy korelacji, pomnożony przez poprawkę zależną od n i p”.
- \(r_{ij}\)
- zwykła korelacja pozycji i z pozycją j
- \(a_{ij}\)
- korelacja cząstkowa pozycji i oraz j po usunięciu wpływu wszystkich pozostałych pozycji
- \(\sum\sum_{i \ne j}\)
- suma po wszystkich parach różnych pozycji (liczenie każdej pary raz lub dwa razy nie zmienia wyniku, byle tak samo w liczniku i mianowniku)
- \(\lvert R\rvert\)
- wyznacznik macierzy korelacji: 1, gdy pozycje są zupełnie nieskorelowane, i coraz bliżej 0, gdy są silnie skorelowane
- \(\ln\)
- logarytm naturalny (w R:
log()) - \(n,\ p\)
- liczba osób i liczba pozycji
- \(df\)
- stopnie swobody: liczba par pozycji
Przykład krok po kroku
Trzydzieścioro studentów wypełniło cztery pozycje skali „stres przed sesją”. Dla prostoty przyjmijmy, że każda para pozycji koreluje dokładnie na poziomie r = 0,50.
| para | r | r² | cząstkowa a | a² |
|---|---|---|---|---|
| 1–2 | 0,50 | 0,25 | 0,25 | 0,0625 |
| 1–3 | 0,50 | 0,25 | 0,25 | 0,0625 |
| 1–4 | 0,50 | 0,25 | 0,25 | 0,0625 |
| 2–3 | 0,50 | 0,25 | 0,25 | 0,0625 |
| 2–4 | 0,50 | 0,25 | 0,25 | 0,0625 |
| 3–4 | 0,50 | 0,25 | 0,25 | 0,0625 |
| suma | 1,50 | 0,375 |
- Kwadraty zwykłych korelacji. Każda para: 0,50 · 0,50 = 0,25. Par jest 6, więc suma to 6 · 0,25 = 1,50.
- Korelacja cząstkowa – krok pierwszy (wzór dla 3 zmiennych). Usuwamy wpływ pozycji 3 z korelacji pozycji 1 i 2: \(r_{12 \cdot 3} = (0{,}5 - 0{,}5 \cdot 0{,}5) / \sqrt{(1 - 0{,}25)(1 - 0{,}25)} = 0{,}25 / 0{,}75 = 0{,}333\).
- Krok drugi. Ten sam wzór, ale na korelacjach już oczyszczonych z pozycji 3 – teraz usuwamy pozycję 4. Wszystkie one wynoszą 0,333, a 0,333 · 0,333 = 0,111. \(a_{12} = (0{,}333 - 0{,}111) / (1 - 0{,}111) = 0{,}222 / 0{,}889 = 0{,}25\). Przez symetrię każda para ma tę samą wartość.
- Kwadraty cząstkowych. 0,25 · 0,25 = 0,0625; sześć par: 6 · 0,0625 = 0,375.
- KMO. 1,50 / (1,50 + 0,375) = 1,50 / 1,875 = 0,80.
- Wyznacznik. Dla macierzy, w której wszystkie korelacje są równe r, wyznacznik to \((1 - r)^{p-1}(1 + (p-1)r) = 0{,}5^3 \cdot 2{,}5 = 0{,}125 \cdot 2{,}5 = 0{,}3125\). Logarytm: ln 0,3125 = −1,163.
- Poprawka. (2 · 4 + 5) / 6 = 13 / 6 = 2,167. Mnożnik: 30 − 1 − 2,167 = 26,833.
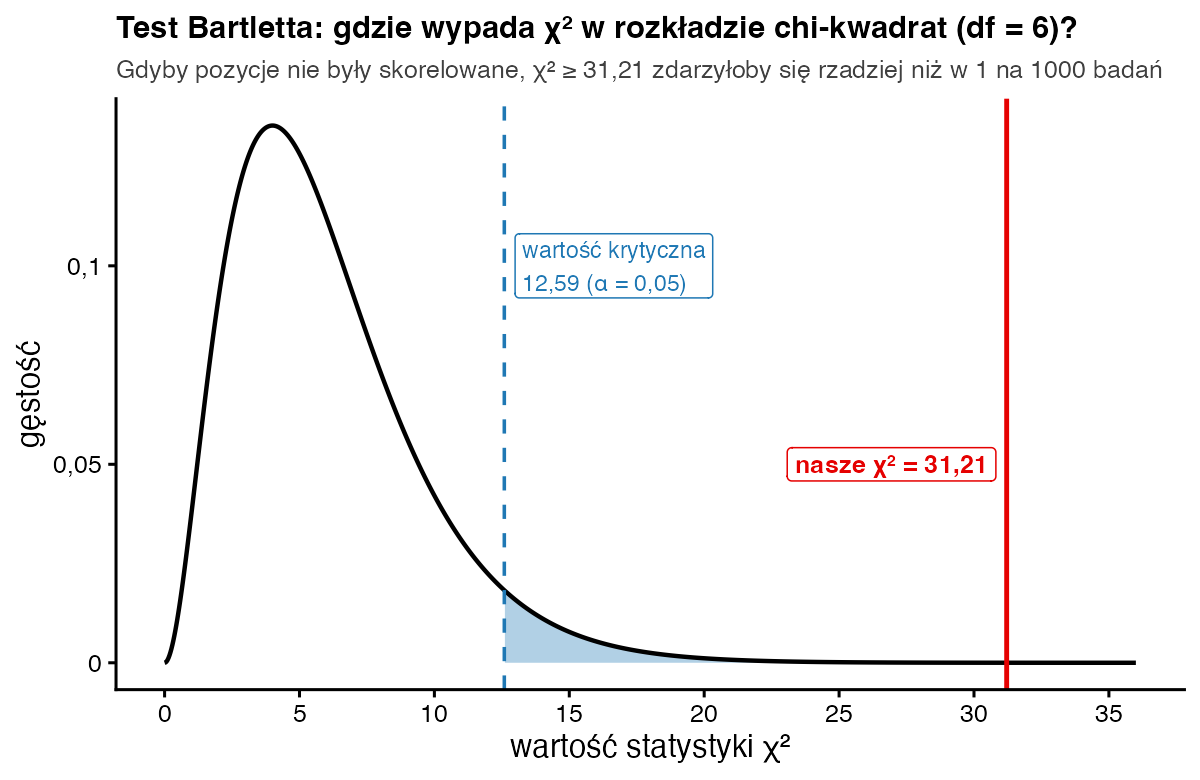
- Chi-kwadrat Bartletta. \(\chi^2 = -26{,}833 \cdot (-1{,}163) = 31{,}21\), df = 4 · 3 / 2 = 6.
- Decyzja. Wartość krytyczna chi-kwadrat dla df = 6 i α = 0,05 to 12,59 (tablice albo w R:
qchisq(0.95, 6)). 31,21 jest dużo większe, p < 0,001.
Gdyby skala miała tylko trzy pozycje, wystarczyłby pierwszy krok. Suma r² wyniosłaby 3 · 0,25 = 0,75, a suma a² = 3 · 0,111 = 0,333. KMO = 0,75 / (0,75 + 0,333) = 0,69. Te same korelacje, a niższe KMO – ta miara rośnie z liczbą pozycji.
Jak zinterpretować i opisać wynik?
Kaiser (1974) zaproponował słowną skalę: KMO ≥ 0,90 – znakomite, 0,80–0,89 – bardzo dobre, 0,70–0,79 – średnie, 0,60–0,69 – mierne, 0,50–0,59 – słabe, poniżej 0,50 – nie do przyjęcia. Nasze 0,80 to wynik bardzo dobry. Warto też spojrzeć na KMO każdej pozycji osobno (MSA). Pozycja z MSA poniżej 0,50 to kandydatka do usunięcia. Test Bartletta mówi tylko, że korelacje nie są wszystkie równe zero. Przy dużych próbach wychodzi istotny prawie zawsze, więc sam w sobie niewiele dowodzi. To raczej minimalny warunek niż mocny argument.
Zapis w stylu APA: Dane spełniały warunki analizy czynnikowej. Miara adekwatności doboru próby Kaisera-Meyera-Olkina wyniosła KMO = 0,80, a test sferyczności Bartletta był istotny statystycznie, χ²(6) = 31,21; p < 0,001.
Jak policzyć KMO i test Bartletta w R?
R <- matrix(0.5, 4, 4); diag(R) <- 1          # 4 pozycje skali stresu, każda para r = 0.5
n <- 30; p <- ncol(R)                          # 30 studentów, 4 pozycje

# 1) „ręcznie”: korelacja cząstkowa w dwóch krokach (wzór dla 3 zmiennych)
cz <- function(rxy, rxz, ryz) (rxy - rxz * ryz) / sqrt((1 - rxz^2) * (1 - ryz^2))
r12_3  <- cz(0.5, 0.5, 0.5)                    # bez wpływu pozycji 3: 0.333
r12_34 <- cz(r12_3, r12_3, r12_3)              # bez wpływu 3 i 4:    0.25
KMO <- 6 * 0.5^2 / (6 * 0.5^2 + 6 * r12_34^2) # 1.5 / (1.5 + 0.375)
chi2 <- -(n - 1 - (2 * p + 5) / 6) * log(det(R))
round(c(r12_3 = r12_3, r12_34 = r12_34, KMO = KMO, wyznacznik = det(R), chi2 = chi2), 4)
pchisq(chi2, df = p * (p - 1) / 2, lower.tail = FALSE)   # wartość p

# 2) gotowe funkcje z pakietu psych
psych::KMO(R)$MSA
psych::cortest.bartlett(R, n = 30)
Wynik w konsoli R:
     r12_3     r12_34        KMO wyznacznik       chi2
    0.3333     0.2500     0.8000     0.3125    31.2112
[1] 2.310057e-05
[1] 0.8
$chisq
[1] 31.21121

$p.value
[1] 2.310057e-05

$df
[1] 6
Na surowych danych wpisujesz po prostu psych::KMO(dane) i psych::cortest.bartlett(dane) – funkcje same policzą macierz korelacji i liczbę osób. psych::KMO() zwraca też MSA dla każdej pozycji.
Co zrobić, gdy KMO jest za niskie?
Najpierw sprawdź MSA poszczególnych pozycji i treść pytań o najniższych wartościach. Często to pozycja, która mierzy coś innego niż reszta skali, albo pytanie odwrócone, którego nie przekodowano. Usuń ją i policz KMO jeszcze raz. Pomaga też większa próba i dodanie pozycji, które dobrze pasują do skali. Nie usuwaj jednak pozycji „na ślepo”, tylko po to, by podbić wynik. Każdą decyzję uzasadnij treścią pytania.
Najczęstsze błędy
- Traktowanie istotnego testu Bartletta jako dowodu, że analiza czynnikowa „wyjdzie” – to tylko warunek minimalny.
- Podawanie samego ogólnego KMO bez sprawdzenia MSA pojedynczych pozycji.
- Liczenie KMO na pozycjach z różnych, niezwiązanych skal naraz.
- Pomijanie liczby osób przy liczeniu testu Bartletta z macierzy korelacji – wynik zależy od n.
- Zapominanie o przekodowaniu pozycji odwróconych przed policzeniem korelacji.
Bibliografia
- Bartlett, M. S. (1950). Tests of significance in factor analysis. British Journal of Statistical Psychology, 3(2), 77–85.
- Kaiser, H. F. (1974). An index of factorial simplicity. Psychometrika, 39(1), 31–36. https://doi.org/10.1007/BF02291575
- Dziuban, C. D., & Shirkey, E. C. (1974). When is a correlation matrix appropriate for factor analysis? Some decision rules. Psychological Bulletin, 81(6), 358–361.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówCR i AVE (Fornell-Larcker)
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówAnaliza równoległa Horna
- Słownik wzorówWartość własna i kryterium Kaisera
- PoradnikAnaliza czynnikowa – przykład
- Przykładowy raportAnaliza czynnikowa
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.