

d Somersa – wzór i przykład krok po kroku
d Somersa to asymetryczna miara związku dwóch zmiennych porządkowych: jedną traktujesz jako niezależną, drugą jako zależną. Typowe pytanie z pracy dyplomowej: na ile rok studiów pozwala przewidzieć, jak student oceni zajęcia?
W prostych słowachBierzesz pary osób, które różnią się zmienną niezależną – np. rokiem studiów. Sprawdzasz, ile razy osoba z wyższego roku dała wyższą ocenę, a ile razy niższą. d Somersa to różnica tych dwóch udziałów. Pary, w których obie osoby dały tę samą ocenę, zostają w rachunku i „rozcieńczają” wynik – inaczej niż w gammie.
Kiedy stosować d Somersa?
- obie zmienne są porządkowe i mają niewiele poziomów (rok studiów, ocena zajęć niska–średnia–wysoka, poziom wykształcenia, odpowiedzi na skali Likerta);
- masz uzasadnienie, która zmienna jest niezależna, a która zależna (np. rok studiów występuje przed oceną zajęć);
- dane są w tabeli krzyżowej z wieloma wiązaniami;
- chcesz miarę ostrożniejszą niż gamma, która nie pomija remisów w zmiennej zależnej.
Gdy związek traktujesz symetrycznie, podaj gammę Goodmana-Kruskala albo tau-b Kendalla. Gdy zmienne są ilościowe lub mają wiele poziomów – korelację Spearmana. Dla zmiennych nominalnych zostaje test chi-kwadrat z V Cramera.
Wzór na d Somersa
- \(d_{YX}\)
- d Somersa, gdy \(Y\) (tu: ocena) jest zmienną zależną, a \(X\) (tu: rok) – niezależną
- \(C\)
- liczba par zgodnych: osoba z wyższego roku ma też wyższą ocenę
- \(D\)
- liczba par niezgodnych: osoba z wyższego roku ma niższą ocenę
- \(T_Y\)
- pary z różnym rokiem, ale z tą samą oceną (remis tylko w zmiennej zależnej)
- \(T_X\)
- wszystkie pary z tym samym rokiem – te odrzucamy, bo nic nie mówią o wpływie roku
- \(P\)
- liczba wszystkich par, jakie da się utworzyć z \(n\) osób
- \(d_{XY}\)
- wersja odwrotna: zależny jest rok; w mianowniku odejmujesz pary z tą samą oceną (\(P - T_Y\))
Jak przeczytać ten wzór na głos: „d Somersa to przewaga par zgodnych nad niezgodnymi wśród wszystkich par, które różnią się zmienną niezależną”. Licznik jest taki sam jak w gammie – zmienia się tylko mianownik.
Przykład krok po kroku
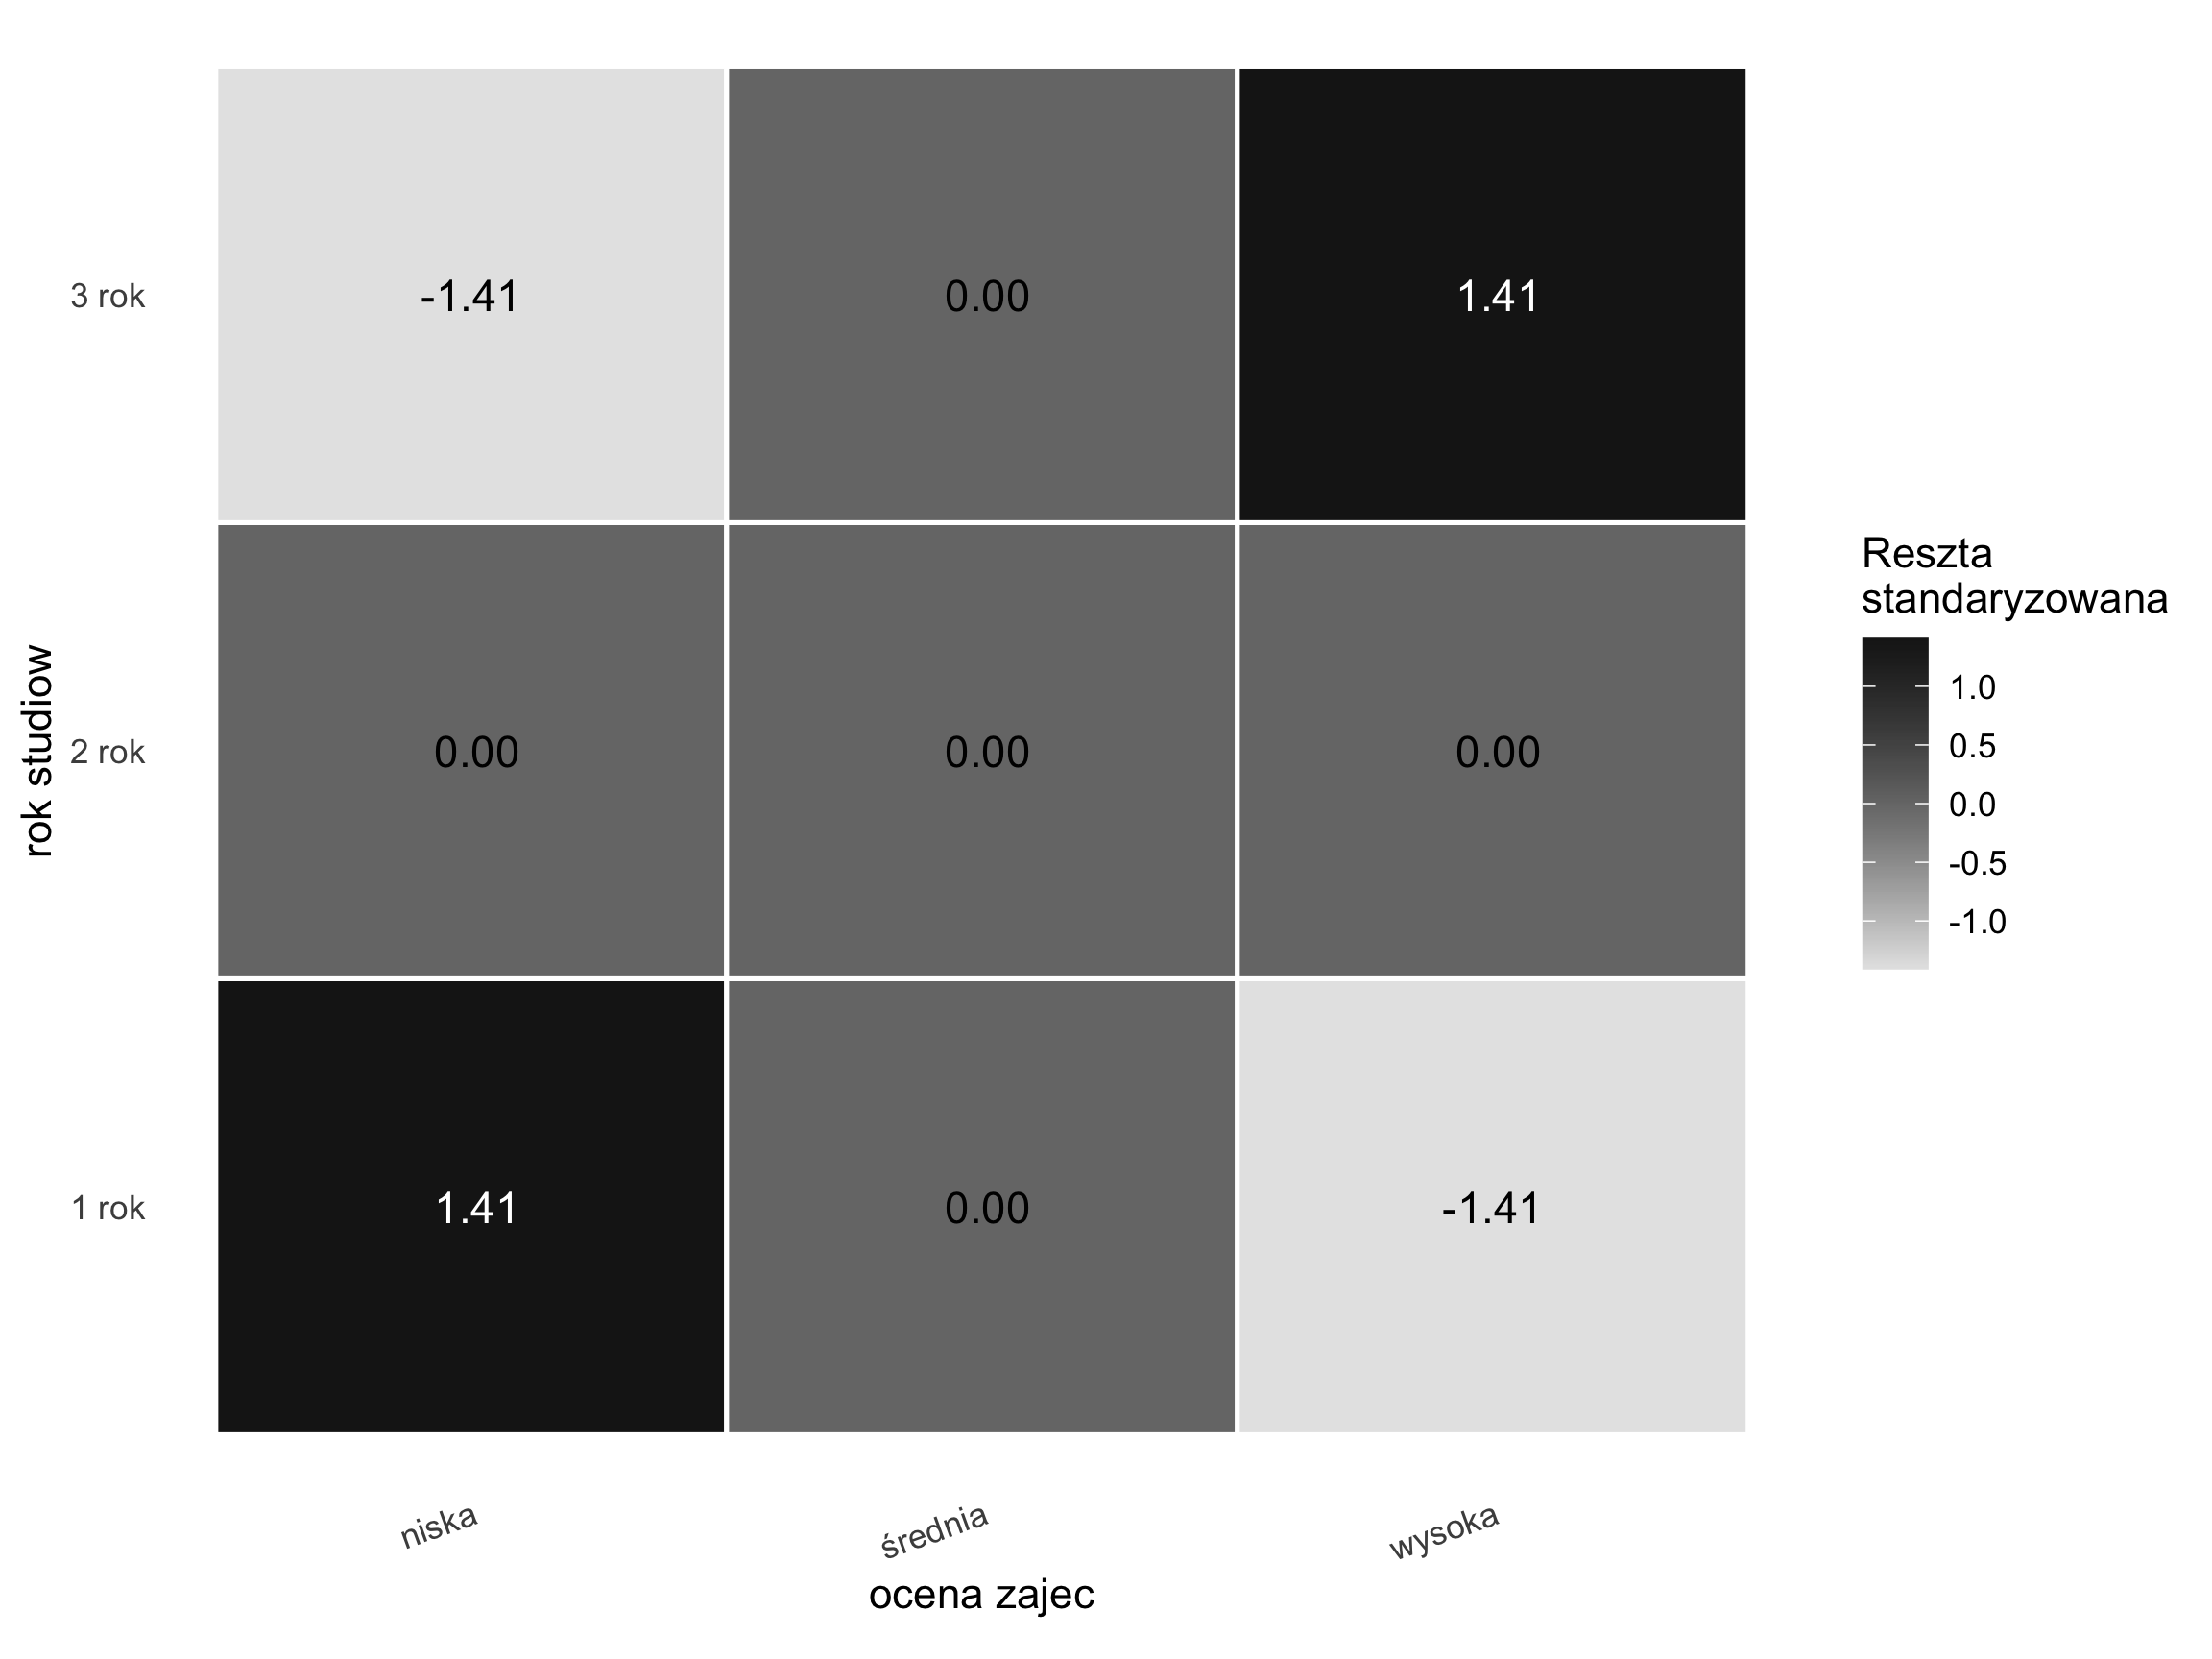
Używamy tej samej tabeli co w haśle o gammie: 12 studentów, po 4 z każdego roku, oceniło zajęcia ze statystyki. Liczby par zgodnych C = 28 i niezgodnych D = 4 policzyliśmy tam komórka po komórce.
| Rok | niska | średnia | wysoka | Razem | Pary z tym samym rokiem |
|---|---|---|---|---|---|
| 1 rok | 2 | 2 | 0 | 4 | 4 · 3 / 2 = 6 |
| 2 rok | 1 | 2 | 1 | 4 | 4 · 3 / 2 = 6 |
| 3 rok | 0 | 2 | 2 | 4 | 4 · 3 / 2 = 6 |
| Razem | 3 | 6 | 3 | 12 | TX = 18 |
| Pary z tą samą oceną | 3 · 2 / 2 = 3 | 6 · 5 / 2 = 15 | 3 · 2 / 2 = 3 | TY(wszystkie) = 21 |
- Wszystkie pary. P = 12 · 11 / 2 = 132 / 2 = 66.
- Pary z tym samym rokiem. W każdym roku są 4 osoby, czyli 4 · 3 / 2 = 6 par. Razem 3 · 6 = 18.
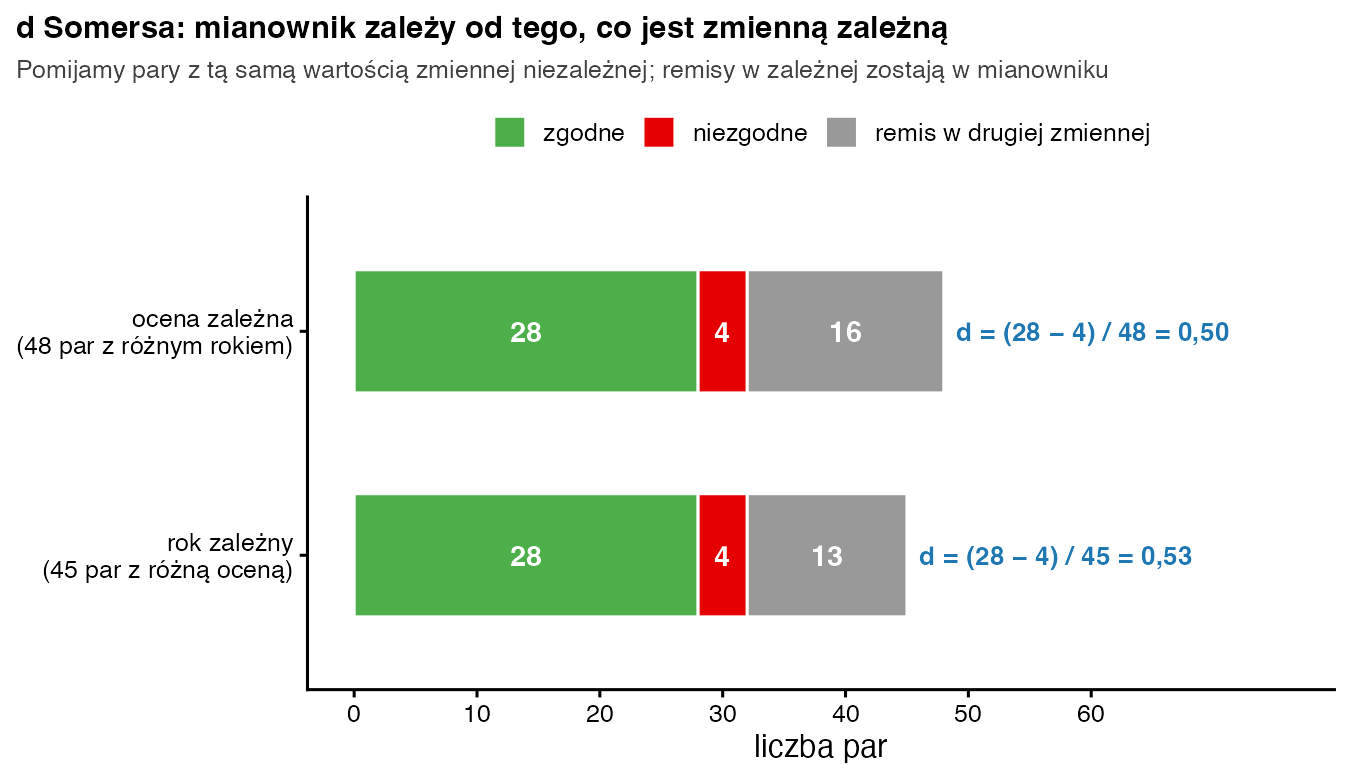
- Pary z różnym rokiem. 66 − 18 = 48. Tylko te pary mówią coś o tym, czy rok wiąże się z oceną.
- Rozkład tych 48 par. 28 zgodnych, 4 niezgodne, a pozostałe 48 − 28 − 4 = 16 to pary z tą samą oceną (np. student 1 i 3 roku, obaj „średnia”).
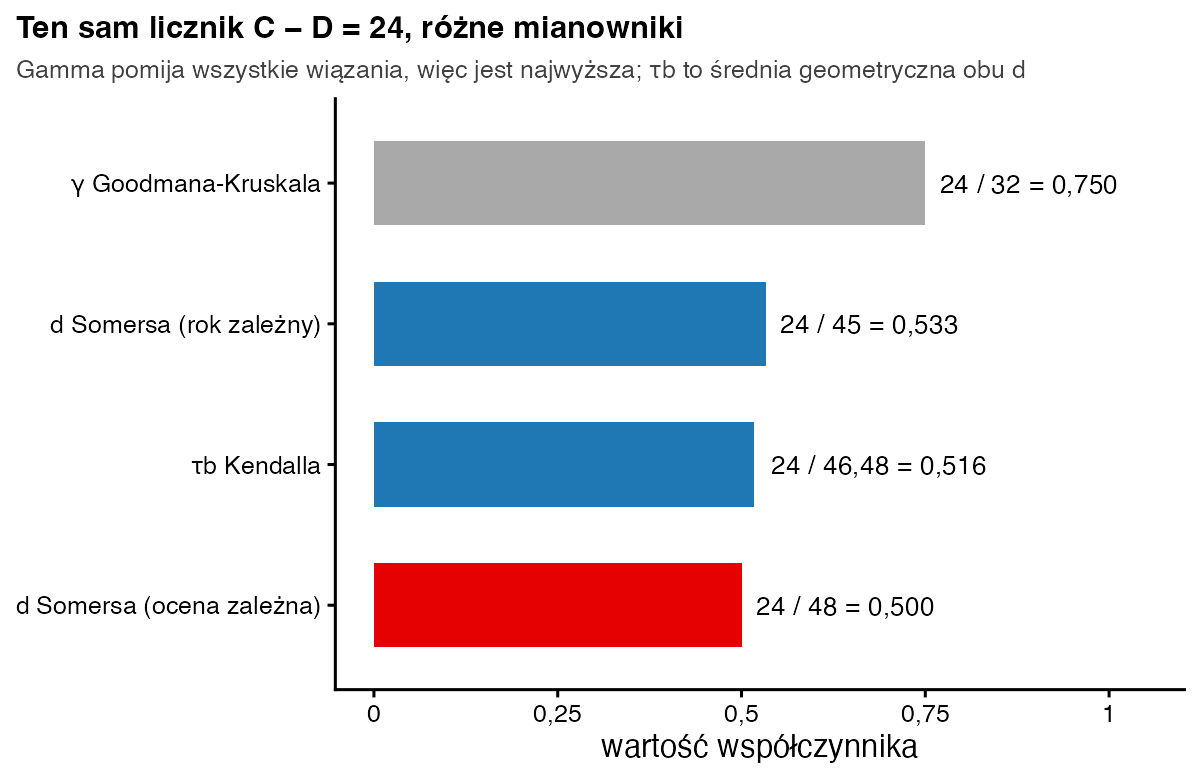
- d Somersa (ocena zależna). dYX = (28 − 4) / 48 = 24 / 48 = 0,50. Inaczej: 28 / 48 = 0,583 par zgodnych minus 4 / 48 = 0,083 niezgodnych = 0,50.
- Wersja odwrotna (rok zależny). Par z tą samą oceną jest 3 + 15 + 3 = 21, więc par z różną oceną: 66 − 21 = 45. dXY = 24 / 45 = 0,533.
- Porównanie. Gamma: 24 / 32 = 0,75. Tau-b Kendalla to średnia geometryczna obu d: √(0,50 · 0,533) = √0,2667 = 0,516.
- Istotność. Licznik C − D jest wspólny dla d, gammy i tau-b, więc związek testujesz jednym testem:
cor.test(..., method = "kendall")daje z = 1,91; p = 0,056. Wartość krytyczna z tablic rozkładu normalnego dla α = 0,05 to 1,96 (w R:qnorm(0.975)).
Jak zinterpretować i opisać wynik?
dYX = 0,50 znaczy: jeśli weźmiesz dwóch studentów z różnych lat, to starszy częściej da wyższą ocenę niż niższą, a przewaga wynosi 50 punktów procentowych (58,3% wobec 8,3%; w 33,3% par oceny są takie same). Kierunek jest dodatni. To nadal opis związku, a nie dowód, że rok studiów zmienia opinię o zajęciach. Przy 12 osobach wynik nie jest istotny (p = 0,056) – to tylko ilustracja rachunku.
Zapis w stylu APA: Rok studiów był dodatnio związany z oceną zajęć (ocena jako zmienna zależna), d Somersa = 0,50; związek nie był jednak istotny statystycznie, z = 1,91; p = 0,056 (test Kendalla, n = 12).
Jak policzyć d Somersa w R?
# Rok studiów (wiersze, X) × ocena zajęć (kolumny, Y), n = 12
tab <- matrix(c(2, 2, 0,
                1, 2, 1,
                0, 2, 2), nrow = 3, byrow = TRUE,
              dimnames = list(rok = c("1", "2", "3"),
                              ocena = c("niska", "średnia", "wysoka")))

# 1) „ręcznie”: pary zgodne, niezgodne i wiązania
pary <- DescTools::ConDisPairs(tab)
C <- pary$C; D <- pary$D                       # 28 i 4
n <- sum(tab); P <- n * (n - 1) / 2            # 66 par
TX <- sum(choose(rowSums(tab), 2))             # ten sam rok: 18
TY <- sum(choose(colSums(tab), 2))             # ta sama ocena: 21
round(c(d_ocena_zalezna = (C - D) / (P - TX),
        d_rok_zalezny   = (C - D) / (P - TY),
        tau_b = (C - D) / sqrt((P - TX) * (P - TY))), 3)

# 2) gotowa funkcja (direction = "column": zależna jest zmienna w kolumnach)
DescTools::SomersDelta(tab, direction = "column")
DescTools::SomersDelta(tab, direction = "row")
Wynik w konsoli R:
d_ocena_zalezna   d_rok_zalezny           tau_b
          0.500           0.533           0.516
[1] 0.5
[1] 0.5333333
Rachunek ręczny i DescTools::SomersDelta() dają te same liczby: 0,50 dla oceny zależnej i 0,533 dla roku zależnego. Uwaga na argument direction: na tych danych "column" zwraca wariant, w którym zależna jest zmienna w kolumnach (ocena). Oznaczenia kierunku różnią się między programami, więc zawsze sprawdź na prostym przykładzie, która wersja to która.
Która zmienna jest zależna w d Somersa?
To decyzja merytoryczna, nie statystyczna. Zależna jest ta zmienna, którą chcesz przewidywać albo wyjaśniać – zwykle ta, która pojawia się później w czasie lub jest „skutkiem” w Twoim modelu teoretycznym. Rok studiów wyprzedza ocenę zajęć, więc ocena jest zależna. Jeśli nie umiesz uzasadnić kierunku, nie wybieraj wersji, która „ładniej wychodzi”. Podaj wtedy tau-b albo gammę (Somers, 1962; Agresti, 2010). SPSS pokazuje w tabeli obie wersje i wersję symetryczną. Wybierz tę, która odpowiada Twojej hipotezie.
Najczęstsze błędy
- Podawanie d Somersa bez informacji, która zmienna była zależna.
- Wybieranie kierunku po obejrzeniu wyników – tylko dlatego, że daje wyższą wartość.
- Mylenie d Somersa z d Cohena – to zupełnie inne miary o tej samej literze.
- Liczenie d Somersa dla zmiennych nominalnych albo dla kategorii w złej kolejności.
- Uznawanie asymetrii miary za dowód kierunku przyczynowego.
Bibliografia
- Somers, R. H. (1962). A new asymmetric measure of association for ordinal variables. American Sociological Review, 27(6), 799–811. https://doi.org/10.2307/2090408
- Goodman, L. A., & Kruskal, W. H. (1954). Measures of association for cross classifications. Journal of the American Statistical Association, 49(268), 732–764. https://doi.org/10.1080/01621459.1954.10501231
- Agresti, A. (2010). Analysis of ordinal categorical data (2nd ed.). Wiley.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówGamma Goodmana-Kruskala
- Słownik wzorówTau Kendalla
- Słownik wzorówKorelacja Spearmana
- PoradnikTesty parametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.