

Gamma Goodmana-Kruskala – wzór i przykład krok po kroku
Gamma Goodmana-Kruskala (γ) to miara siły i kierunku związku dwóch zmiennych porządkowych zapisanych w tabeli krzyżowej. Typowe pytanie z pracy dyplomowej: czy studenci starszych roczników wyżej oceniają zajęcia niż studenci pierwszego roku?
W prostych słowachBierzesz każdą możliwą parę osób i patrzysz, czy osoba z wyższego roku dała też wyższą ocenę. Jeśli tak – para jest „zgodna”. Jeśli dała niższą – para jest „niezgodna”. Gamma to przewaga par zgodnych nad niezgodnymi. Pary, w których ktoś ma ten sam rok albo tę samą ocenę, gamma po prostu pomija.
Kiedy stosować gammę Goodmana-Kruskala?
- obie zmienne są porządkowe i mają niewiele poziomów (np. rok studiów 1–3, ocena zajęć niska–średnia–wysoka, wykształcenie, odpowiedzi na skali Likerta);
- dane masz w postaci tabeli krzyżowej, więc wiele osób ma takie same wartości (dużo wiązań);
- chcesz wiedzieć nie tylko, czy zmienne są związane, ale też w którą stronę idzie związek (od −1 do +1);
- żadna zmienna nie jest wyraźnie „zależna” – związek traktujesz symetrycznie.
Gdy jedną zmienną traktujesz jako zależną, wybierz d Somersa. Gdy poziomów jest dużo i wiązań mało, sięgnij po tau Kendalla albo korelację Spearmana. Test chi-kwadrat i V Cramera nie widzą kolejności kategorii, więc nie powiedzą, w którą stronę idzie związek. O analizie odpowiedzi porządkowych przeczytasz też we wpisie skala Likerta – jak analizować.
Wzór na gammę Goodmana-Kruskala
- \(C\)
- liczba par zgodnych: osoba „niżej” w tabeli (wyższy rok) ma też wyższą ocenę
- \(D\)
- liczba par niezgodnych: osoba z wyższego roku ma niższą ocenę
- \(n_{ij}\)
- liczba osób w komórce: wiersz \(i\) (rok), kolumna \(j\) (ocena)
- \(\sum_{k>i,\ l>j}\)
- suma osób we wszystkich komórkach niżej i na prawo od danej komórki
- \(\sum_{k>i,\ l<j}\)
- suma osób we wszystkich komórkach niżej i na lewo
- \(\gamma\)
- wynik od −1 do +1: +1 – same pary zgodne, −1 – same niezgodne, 0 – po równo
Jak przeczytać ten wzór na głos: „gamma to różnica między liczbą par zgodnych i niezgodnych, podzielona przez ich sumę”. Kolejność wierszy i kolumn musi iść od „najmniej” do „najwięcej” – inaczej zgodne i niezgodne zamienią się miejscami.
Przykład krok po kroku
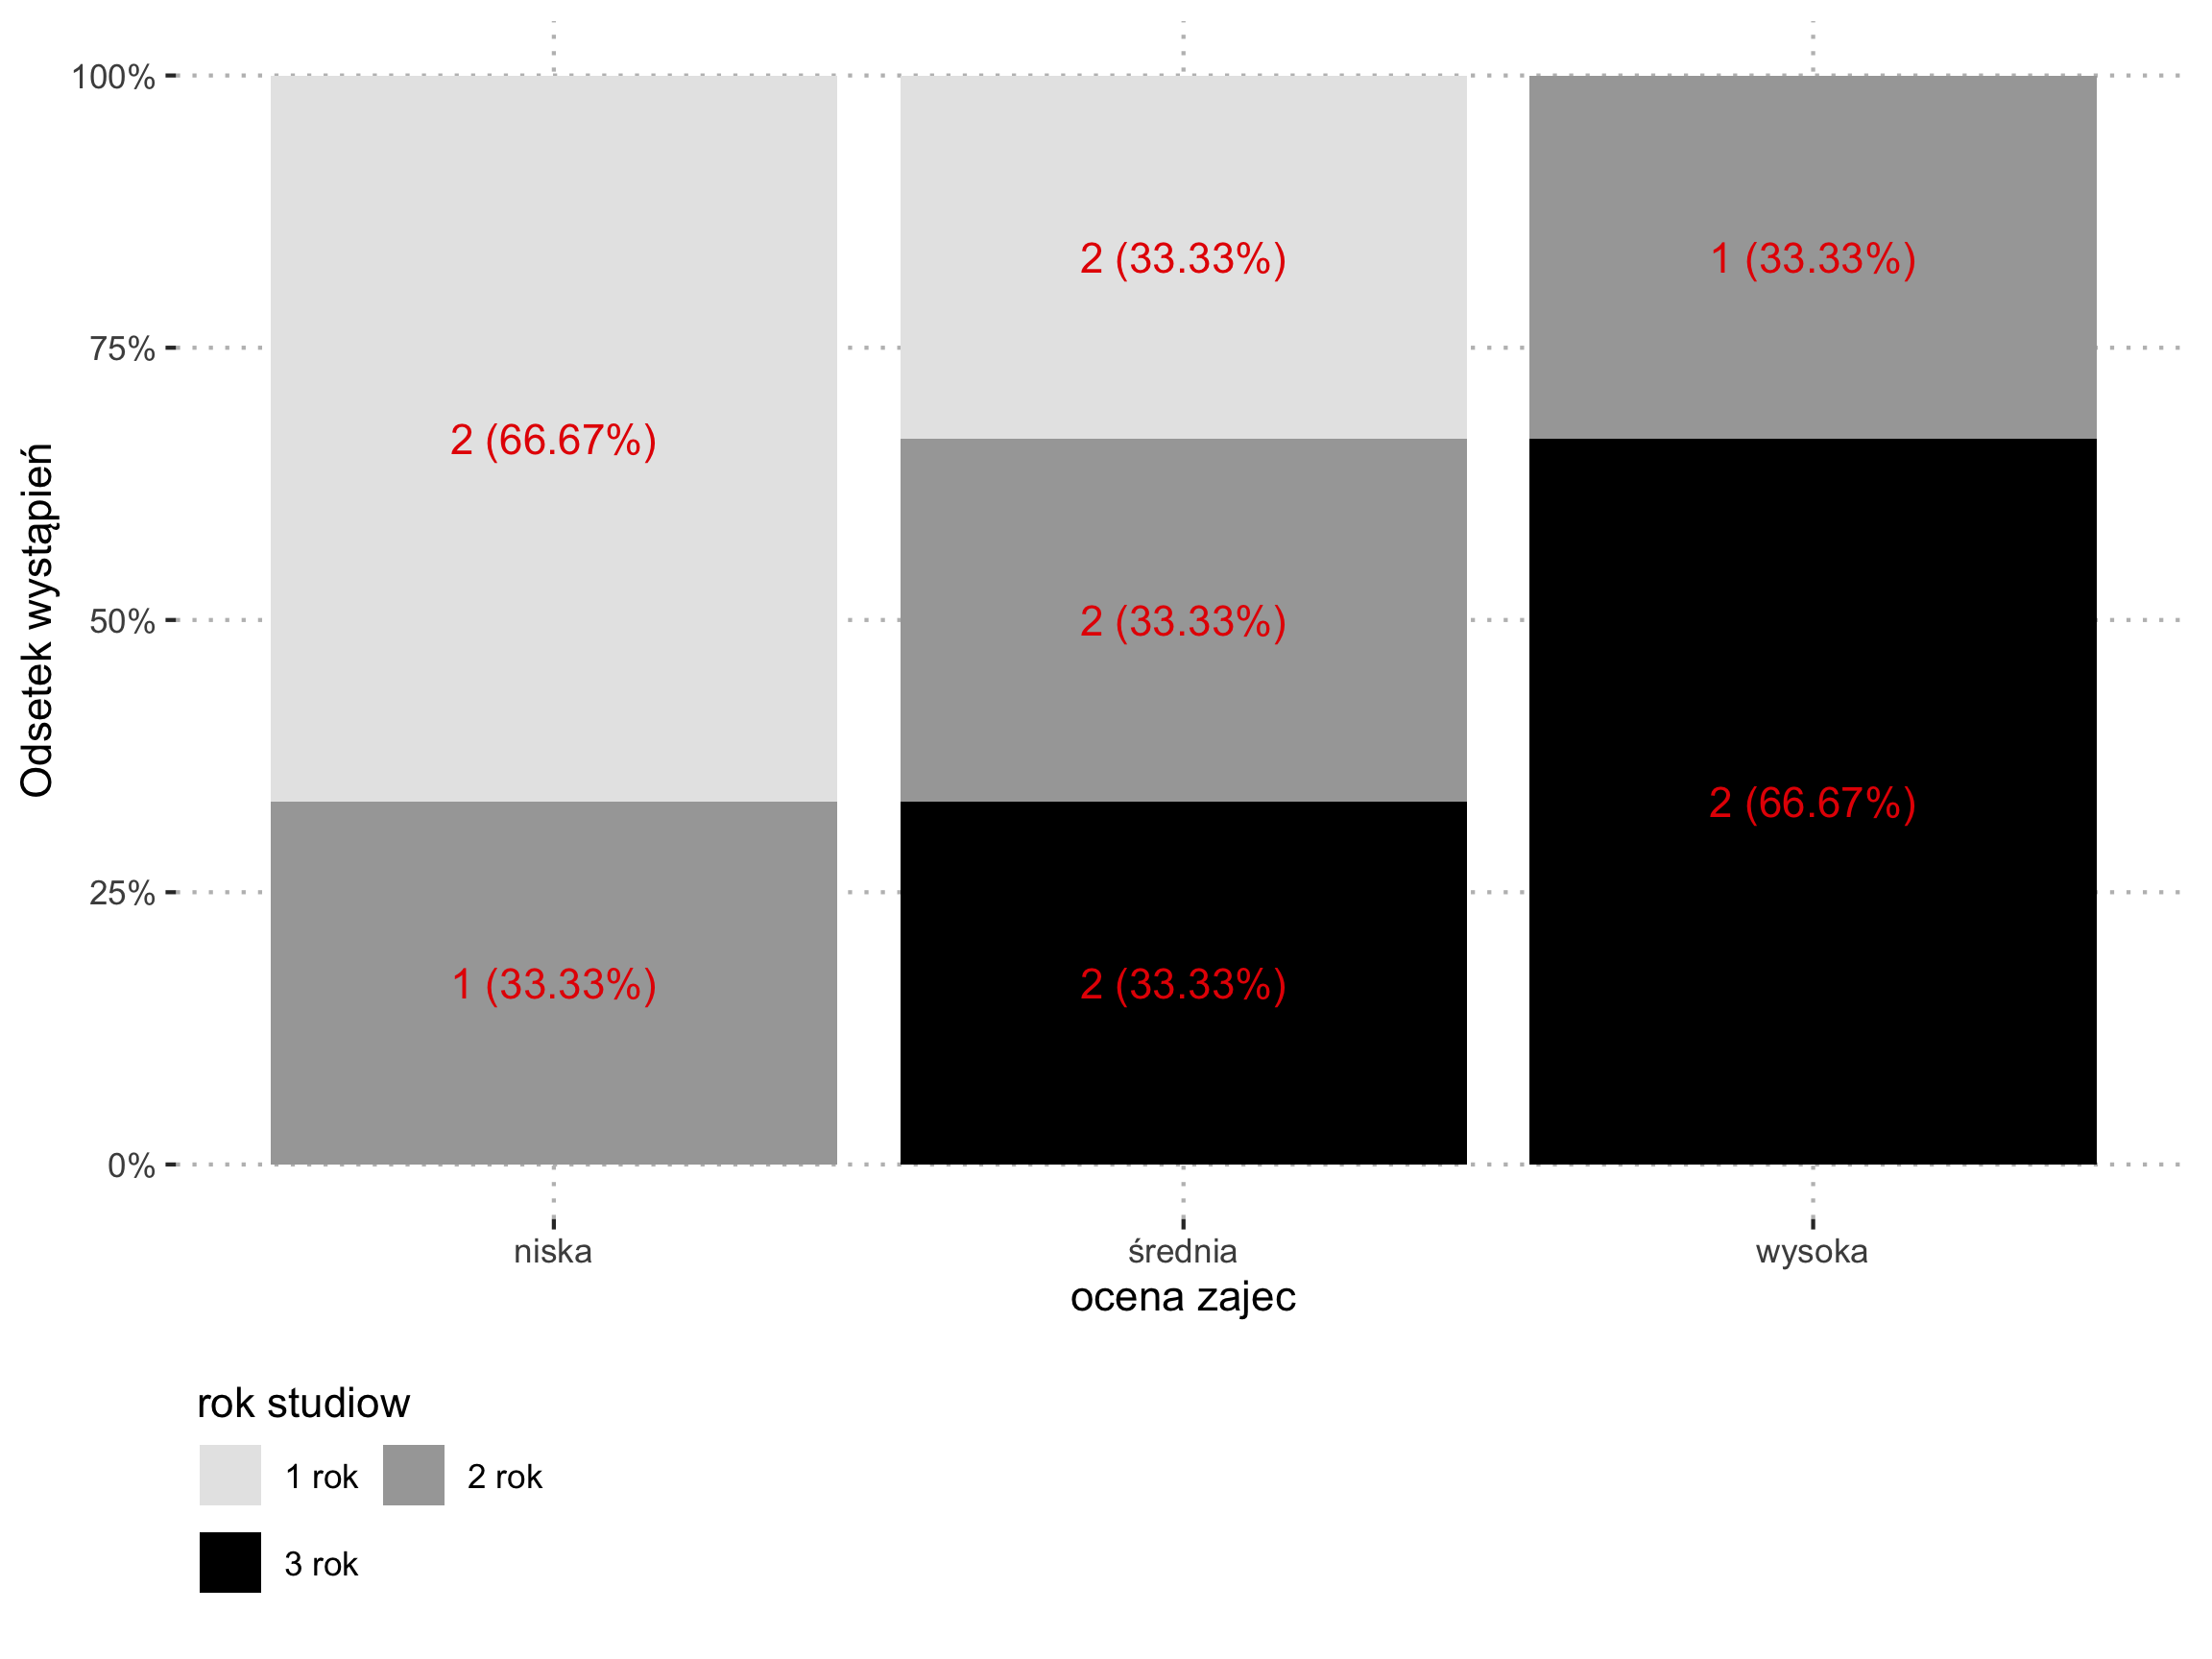
Zapytaliśmy 12 studentów (po 4 z każdego roku), jak oceniają zajęcia ze statystyki. Tabela krzyżowa:
| Rok | niska | średnia | wysoka | Razem |
|---|---|---|---|---|
| 1 rok | 2 | 2 | 0 | 4 |
| 2 rok | 1 | 2 | 1 | 4 |
| 3 rok | 0 | 2 | 2 | 4 |
| Razem | 3 | 6 | 3 | 12 |
| Komórka | n | Niżej i w prawo | Pary zgodne | Niżej i w lewo | Pary niezgodne |
|---|---|---|---|---|---|
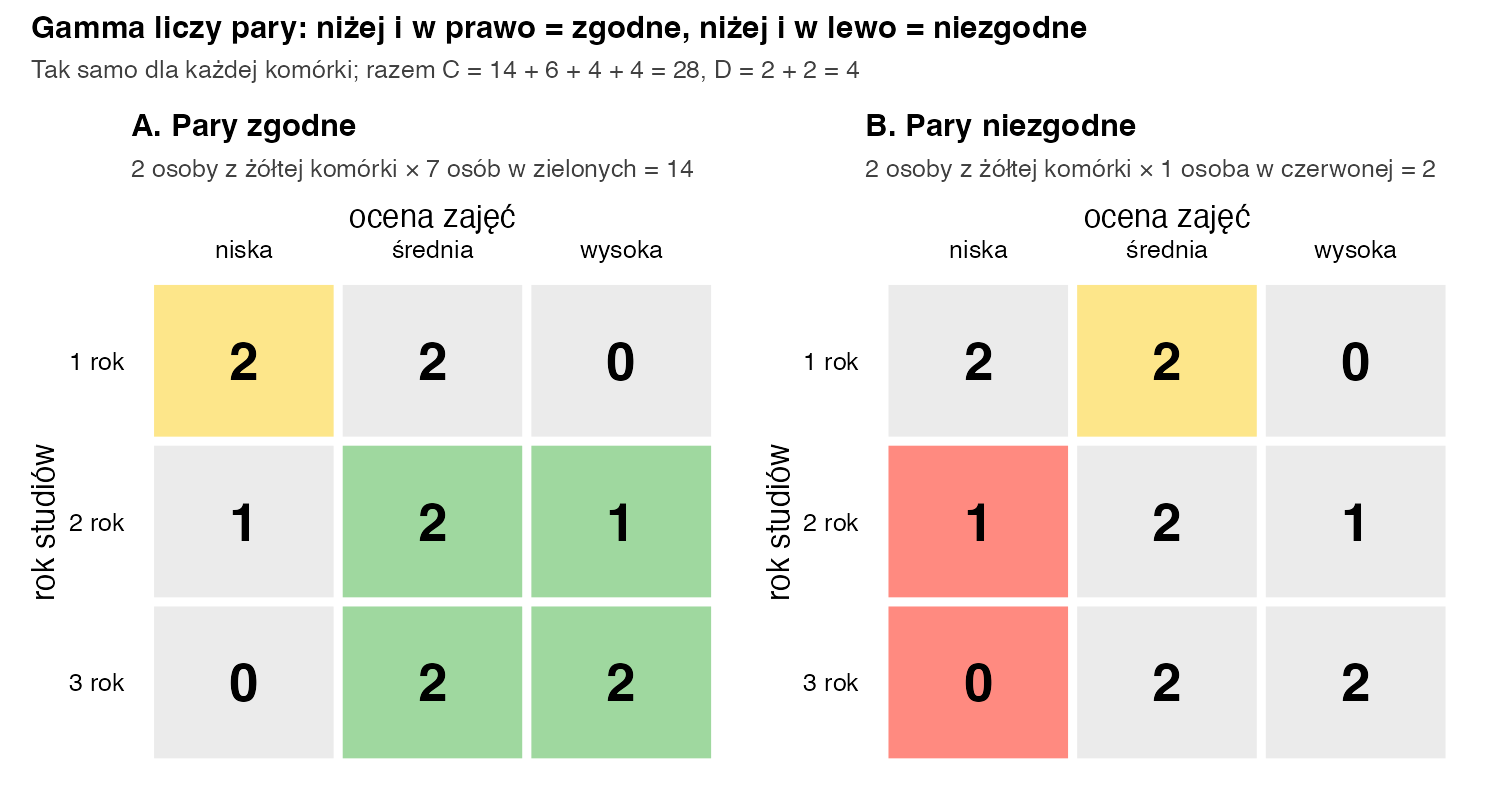
| 1 rok, niska | 2 | 2 + 1 + 2 + 2 = 7 | 2 · 7 = 14 | brak | 0 |
| 1 rok, średnia | 2 | 1 + 2 = 3 | 2 · 3 = 6 | 1 + 0 = 1 | 2 · 1 = 2 |
| 1 rok, wysoka | 0 | brak | 0 | 1 + 2 + 0 + 2 = 5 | 0 · 5 = 0 |
| 2 rok, niska | 1 | 2 + 2 = 4 | 1 · 4 = 4 | brak | 0 |
| 2 rok, średnia | 2 | 2 | 2 · 2 = 4 | 0 | 2 · 0 = 0 |
| 2 rok, wysoka | 1 | brak | 0 | 0 + 2 = 2 | 1 · 2 = 2 |
| Suma (3 rok nie ma nikogo „niżej”) | C = 28 | D = 4 | |||
- Uporządkuj tabelę. Wiersze od 1 do 3 roku, kolumny od oceny niskiej do wysokiej. To warunek konieczny – gamma korzysta z kolejności.
- Pary zgodne. Dla każdej komórki mnożysz liczbę osób przez sumę osób „niżej i w prawo” (wyższy rok i wyższa ocena). Suma: C = 14 + 6 + 4 + 4 = 28.
- Pary niezgodne. To samo z komórkami „niżej i w lewo” (wyższy rok, niższa ocena): D = 2 + 2 = 4.
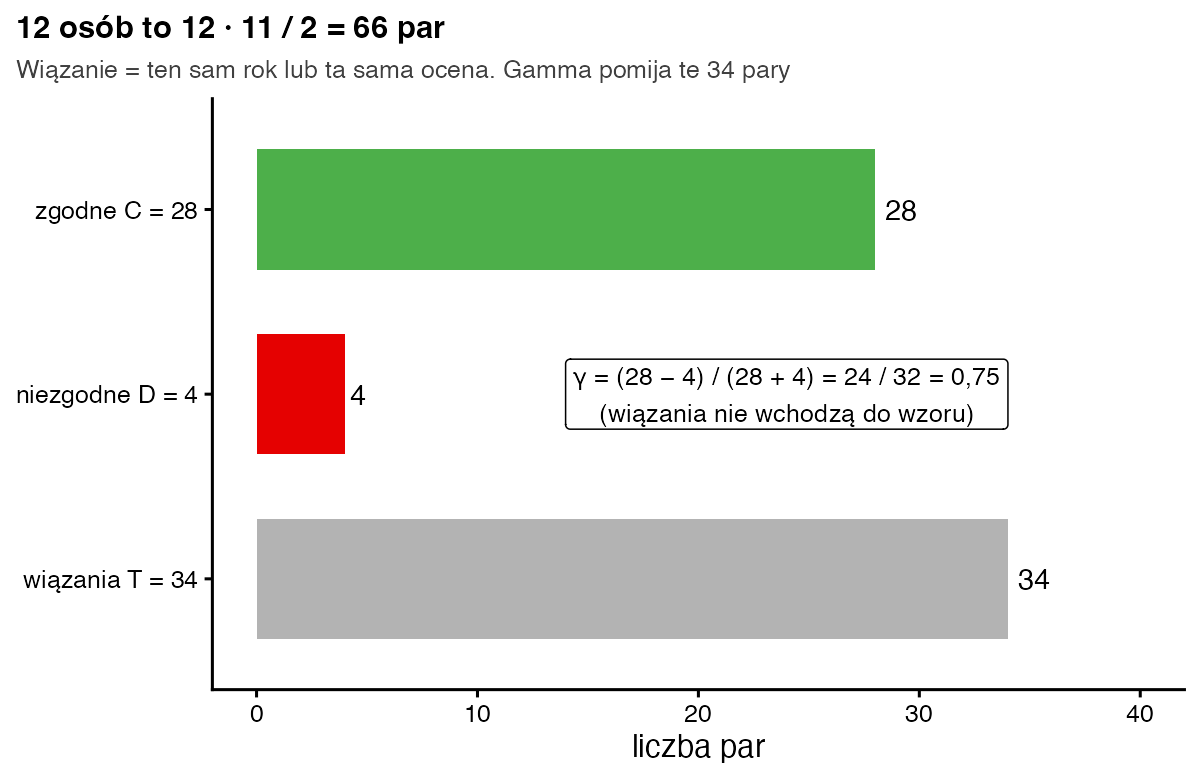
- Licznik. C − D = 28 − 4 = 24. Par zgodnych jest wyraźnie więcej.
- Mianownik. C + D = 28 + 4 = 32 pary bez wiązań.
- Gamma. γ = 24 / 32 = 0,75.
- Co z resztą par? Wszystkich par jest 12 · 11 / 2 = 66. Pozostałe 66 − 32 = 34 pary to wiązania: te same lata albo te same oceny. Gamma ich nie liczy.
- Istotność. Test niezależności dla dwóch zmiennych porządkowych w R wykonasz funkcją
cor.test(..., method = "kendall"). Sprawdza, czy C − D różni się od zera bardziej, niż wynikałoby z przypadku: z = 1,91; p = 0,056. Wartość krytyczna dla α = 0,05 to 1,96 (w R:qnorm(0.975)).
Jak zinterpretować i opisać wynik?
γ = 0,75 oznacza, że wśród par bez wiązań par zgodnych jest o 75 punktów procentowych więcej niż niezgodnych (87,5% wobec 12,5%). Kierunek jest dodatni: wyższy rok idzie w parze z wyższą oceną zajęć. Nie oznacza to, że rok studiów „powoduje” lepsze oceny. Gamma bywa wysoka nawet przy dość słabym związku, bo pomija wiązania. Dlatego warto podać obok d Somersa lub tau-b. Przy 12 osobach wynik nie jest istotny (p = 0,056). To ilustracja – w prawdziwym badaniu potrzebujesz większej próby.
Zapis w stylu APA: Między rokiem studiów a oceną zajęć wystąpił dodatni związek – studenci starszych lat częściej wybierali wyższe oceny, γ = 0,75 (C = 28, D = 4). Związek nie był jednak istotny statystycznie, z = 1,91; p = 0,056 (test Kendalla, n = 12).
Jak policzyć gammę Goodmana-Kruskala w R?
# Rok studiów (wiersze) × ocena zajęć (kolumny), n = 12
tab <- matrix(c(2, 2, 0,
                1, 2, 1,
                0, 2, 2), nrow = 3, byrow = TRUE,
              dimnames = list(rok = c("1", "2", "3"),
                              ocena = c("niska", "średnia", "wysoka")))

# 1) „ręcznie”: pary zgodne (niżej i w prawo) i niezgodne (niżej i w lewo)
C <- 0; D <- 0
for (i in 1:2) for (j in 1:3) {
  if (j < 3) C <- C + tab[i, j] * sum(tab[(i + 1):3, (j + 1):3])
  if (j > 1) D <- D + tab[i, j] * sum(tab[(i + 1):3, 1:(j - 1)])
}
c(C = C, D = D, gamma = (C - D) / (C + D))

# 2) gotowa funkcja i test istotności związku porządkowego
DescTools::GoodmanKruskalGamma(tab)
rok   <- rep(rep(1:3, each = 3), t(tab))
ocena <- rep(rep(1:3, times = 3), t(tab))
cor.test(rok, ocena, method = "kendall", exact = FALSE)
Wynik w konsoli R:
    C     D gamma
28.00  4.00  0.75
[1] 0.75

	Kendall's rank correlation tau

data:  rok and ocena
z = 1.9122, p-value = 0.05585
alternative hypothesis: true tau is not equal to 0
sample estimates:
      tau
0.5163978
Pętla „ręczna” i DescTools::GoodmanKruskalGamma() dają tę samą gammę: 0,75. cor.test() wymaga danych w postaci jednej osoby w wierszu, dlatego tabelę „rozwijamy” funkcją rep(). W wydruku testu widać też tau-b = 0,516 – niższe od gammy, bo uwzględnia wiązania.
Gamma czy korelacja Spearmana – co wybrać?
Gdy skala ma tylko 3–5 kategorii, a dane są w tabeli krzyżowej, wiązań jest bardzo dużo. Spearman i tau-b radzą sobie z nimi poprawkami, a gamma po prostu je pomija. Dzięki temu gamma jest prosta w interpretacji („przewaga par zgodnych”), ale daje wartości wyższe niż inne miary. Nie porównuj więc gammy z jednego badania z korelacją Spearmana z innego. Goodman i Kruskal (1954) zaproponowali gammę właśnie dla tabel z uporządkowanymi kategoriami. Agresti (2010) opisuje ją razem z d Somersa i tau-b jako rodzinę miar opartych na parach.
Najczęstsze błędy
- Nieuporządkowane kategorie (np. „średnia, niska, wysoka” w kolejności alfabetycznej) – gamma wychodzi wtedy bez sensu.
- Liczenie gammy dla zmiennych nominalnych, np. kierunku studiów – tam nie ma „wyżej” i „niżej”.
- Traktowanie gammy jak korelacji Pearsona i porównywanie jej z progami dla r.
- Pomijanie liczby par i liczebności: gamma = 1 może wyjść nawet przy kilku osobach.
- Wnioskowanie o przyczynie z samego związku dwóch zmiennych.
Bibliografia
- Goodman, L. A., & Kruskal, W. H. (1954). Measures of association for cross classifications. Journal of the American Statistical Association, 49(268), 732–764. https://doi.org/10.1080/01621459.1954.10501231
- Agresti, A. (2010). Analysis of ordinal categorical data (2nd ed.). Wiley.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTau Kendalla
- Słownik wzorówd Somersa
- Słownik wzorówV Cramera
- PoradnikTesty parametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.