

Iloraz szans i ryzyko względne – wzór i przykład krok po kroku
Iloraz szans (OR) i ryzyko względne (RR) mówią, ile razy częściej coś zdarza się w jednej grupie niż w drugiej, gdy wynik ma dwie wartości. Typowe pytanie z pracy dyplomowej: o ile bardziej prawdopodobne jest zaliczenie przedmiotu u studentów, którzy regularnie chodzili na ćwiczenia?
W prostych słowachRyzyko to zwykły odsetek: ilu na stu studentów zaliczyło. Szansa to stosunek: ilu zaliczyło na jednego, który nie zaliczył – jak w zakładach bukmacherskich. Ryzyko względne dzieli dwa odsetki, a iloraz szans dzieli dwie szanse. Gdy zdarzenie jest rzadkie, oba wyniki są prawie takie same. Gdy jest częste, iloraz szans wychodzi dużo większy.
Kiedy stosować iloraz szans i ryzyko względne?
- masz tabelę 2 × 2: dwie grupy i wynik tak/nie (zaliczył/nie zaliczył, rzucił palenie/nie rzucił);
- chcesz opisać siłę i kierunek związku, a nie tylko podać, czy jest istotny;
- RR wybierasz w eksperymencie lub badaniu, w którym obserwujesz grupy w czasie; OR – zawsze, gdy liczysz regresję logistyczną albo gdy osoby dobierano według wyniku (badanie kliniczno-kontrolne).
Istotność związku sprawdzisz testem chi-kwadrat, przy małych liczebnościach dokładnym testem Fishera. Różnicę odsetków (zamiast ich ilorazu) opisuje test z dla dwóch proporcji.
Wzór na iloraz szans i ryzyko względne
- \(a,\ b\)
- w grupie osób chodzących na ćwiczenia: \(a\) – liczba osób, które zaliczyły, \(b\) – liczba osób, które nie zaliczyły
- \(c,\ d\)
- to samo w grupie niechodzących: \(c\) zaliczyło, \(d\) nie zaliczyło
- \(a/b,\ c/d\)
- szanse zaliczenia w każdej grupie: ilu zaliczyło na jednego, który nie zaliczył
- \(a/(a+b)\)
- ryzyko, czyli prawdopodobieństwo zaliczenia: odsetek zaliczających w grupie
- \(\ln,\ \exp\)
- logarytm naturalny i jego odwrotność (\(e\) do potęgi); przedział liczysz na logarytmach, a potem wracasz do zwykłej skali
- \(1{,}96\)
- wartość z rozkładu normalnego dla 95% ufności (w R:
qnorm(0.975)) - \(OR = 1,\ RR = 1\)
- brak związku: w obu grupach wynik zdarza się tak samo często
Jak przeczytać ten wzór na głos: „iloraz szans to szansa zaliczenia w pierwszej grupie podzielona przez szansę zaliczenia w drugiej; ryzyko względne to odsetek zaliczających w pierwszej grupie podzielony przez odsetek w drugiej”. Dla ryzyka względnego błąd standardowy logarytmu to \( \sqrt{1/a - 1/(a+b) + 1/c - 1/(c+d)} \).
Przykład krok po kroku
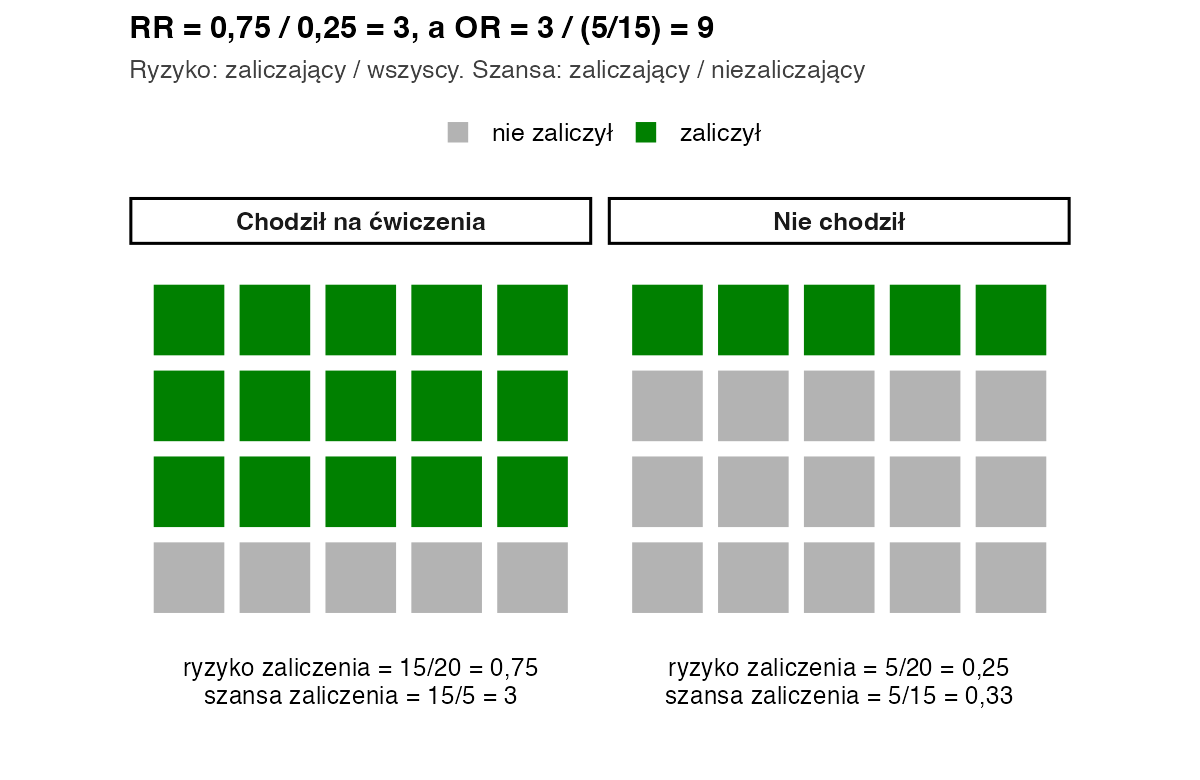
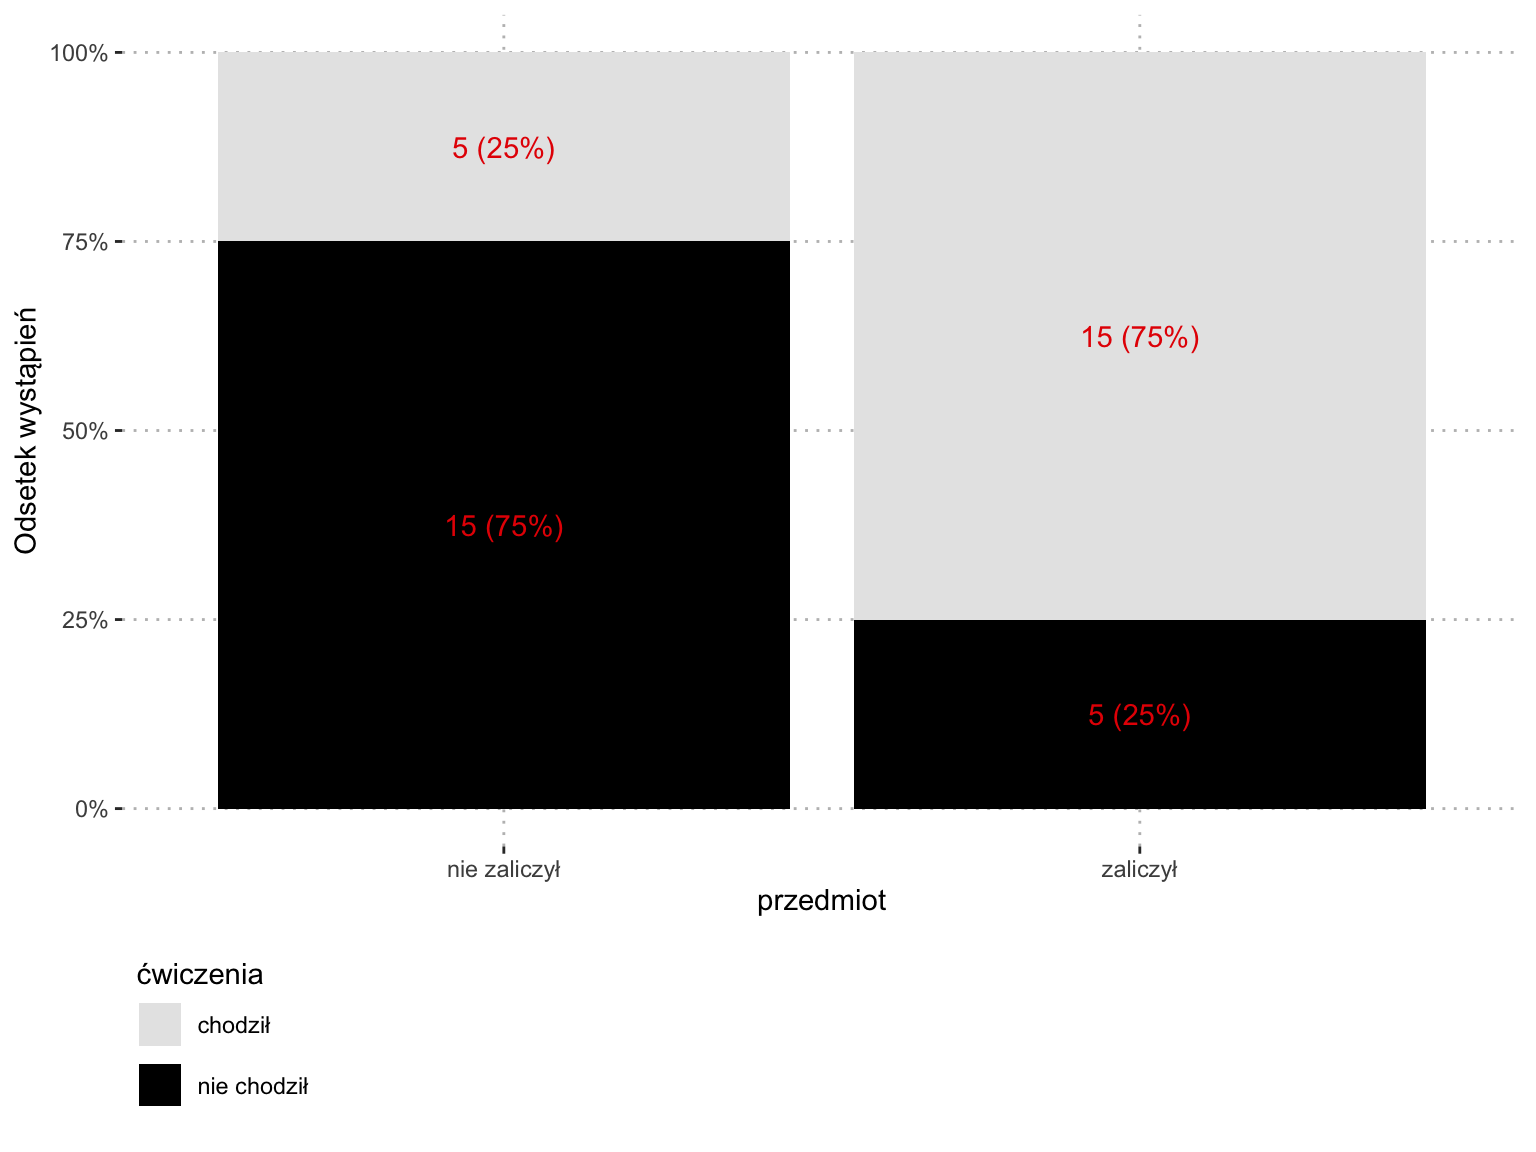
Zapytałeś 40 studentów, czy regularnie chodzili na ćwiczenia i czy zaliczyli przedmiot. Wśród 20 chodzących zaliczyło 15 osób, a 5 nie. Wśród 20 niechodzących zaliczyło 5 osób, a 15 nie. To ten sam zbiór, co w przykładzie z testem chi-kwadrat (χ² = 10,00) – tam sprawdzaliśmy, czy związek jest istotny, tu mierzymy, jak jest silny.
| Grupa | Zaliczył | Nie zaliczył | Razem | Ryzyko zaliczenia | Szansa zaliczenia |
|---|---|---|---|---|---|
| Chodził na ćwiczenia | a = 15 | b = 5 | 20 | 15 / 20 = 0,75 | 15 / 5 = 3 |
| Nie chodził | c = 5 | d = 15 | 20 | 5 / 20 = 0,25 | 5 / 15 = 0,33 |
| Razem / iloraz | 20 | 20 | 40 | RR = 0,75 / 0,25 = 3 | OR = 3 / (5/15) = 9 |
- Ryzyko w każdej grupie. Chodzący: 15 / 20 = 0,75 (75%). Niechodzący: 5 / 20 = 0,25 (25%).
- Ryzyko względne. RR = 0,75 / 0,25 = 3. Prawdopodobieństwo zaliczenia jest 3 razy większe u osób chodzących na ćwiczenia.
- Szanse w każdej grupie. Chodzący: 15 / 5 = 3 (trzech zaliczających na jednego niezaliczającego). Niechodzący: 5 / 15 = 0,33 (jeden zaliczający na trzech niezaliczających).
- Iloraz szans. OR = (15 · 15) / (5 · 5) = 225 / 25 = 9. Szansa zaliczenia jest 9 razy większa.
- Błąd standardowy ln OR. Dodajesz odwrotności czterech liczebności: 1/15 + 1/5 + 1/5 + 1/15 = 8/15 = 0,5333. Pierwiastek: √0,5333 = 0,7303.
- Granice na skali logarytmu. ln 9 = 2,1972 (w R:
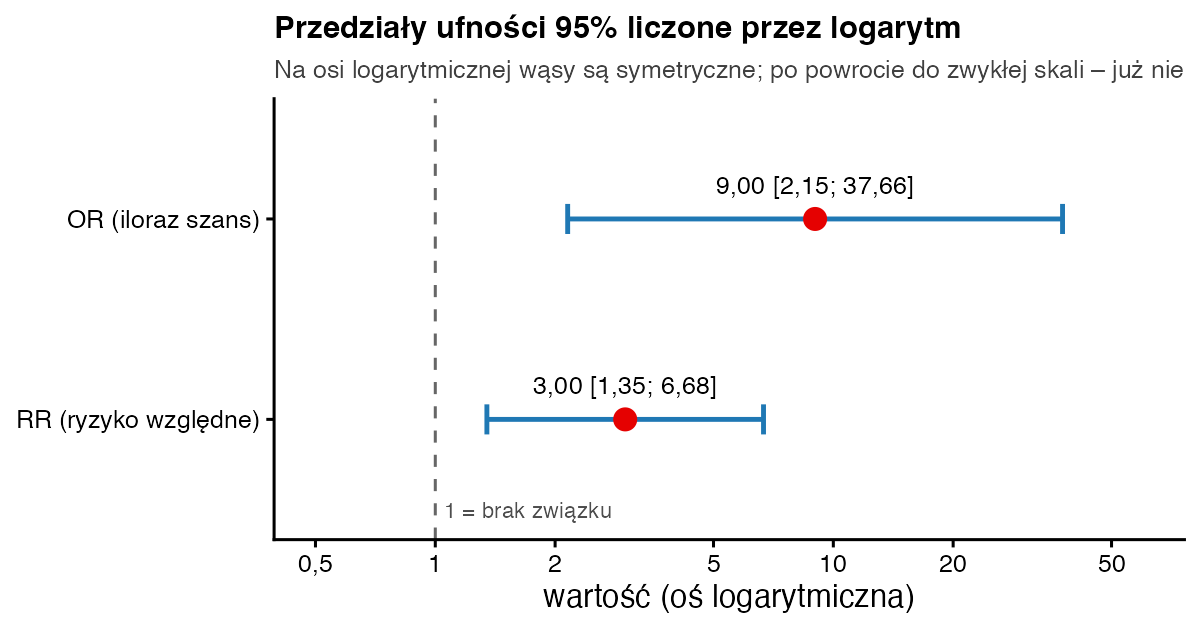
log(9)). 1,96 · 0,7303 = 1,4314. Dolna: 2,1972 − 1,4314 = 0,7658. Górna: 2,1972 + 1,4314 = 3,6286. - Powrót do zwykłej skali. e0,7658 = 2,15 i e3,6286 = 37,66 (w R:
exp()). 95% CI dla OR: [2,15; 37,66]. Przedział nie obejmuje 1, więc związek jest istotny na poziomie 0,05. - Przedział dla RR. 1/15 − 1/20 + 1/5 − 1/20 = 0,0667 − 0,05 + 0,2 − 0,05 = 0,1667; √0,1667 = 0,4082; 1,96 · 0,4082 = 0,8001. ln 3 = 1,0986, więc granice to 1,0986 − 0,8001 = 0,2985 i 1,0986 + 0,8001 = 1,8987, a po
exp(): [1,35; 6,68].
Jak zinterpretować i opisać wynik?
Poprawne zdania brzmią: „prawdopodobieństwo zaliczenia było 3 razy większe” (RR) albo „szansa zaliczenia była 9 razy większa” (OR). Nie pisz, że osoby chodzące na ćwiczenia zaliczały „9 razy częściej” – to opis ryzyka, a nie szansy. Pamiętaj też, że to badanie obserwacyjne. Na ćwiczenia mogli chodzić bardziej zmotywowani studenci, więc OR nie dowodzi, że to ćwiczenia pomogły.
Zapis w stylu APA: Przedmiot zaliczyło 75% osób regularnie chodzących na ćwiczenia i 25% osób, które na nie nie chodziły, χ²(1) = 10,00; p = 0,002. Szansa zaliczenia była 9 razy większa w grupie chodzących, OR = 9,00; 95% CI [2,15; 37,66], a prawdopodobieństwo zaliczenia – 3 razy większe, RR = 3,00; 95% CI [1,35; 6,68].
Jak policzyć iloraz szans i ryzyko względne w R?
# Chodzenie na ćwiczenia a zaliczenie przedmiotu (40 studentów)
a <- 15; b <- 5     # chodził na ćwiczenia: zaliczył / nie zaliczył
c_ <- 5; d <- 15    # nie chodził: zaliczył / nie zaliczył

# 1) „ręcznie”: iloraz szans i ryzyko względne z 95% CI (przez logarytm)
OR <- (a * d) / (b * c_)                          # 225 / 25 = 9
se_lnOR <- sqrt(1/a + 1/b + 1/c_ + 1/d)
RR <- (a / (a + b)) / (c_ / (c_ + d))             # 0,75 / 0,25 = 3
se_lnRR <- sqrt(1/a - 1/(a + b) + 1/c_ - 1/(c_ + d))
wynik <- rbind(OR = c(OR, exp(log(OR) + c(-1, 1) * 1.96 * se_lnOR)),
               RR = c(RR, exp(log(RR) + c(-1, 1) * 1.96 * se_lnRR)))
colnames(wynik) <- c("wartosc", "CI_dolna", "CI_gorna"); round(wynik, 2)

# 2) gotowa funkcja dla OR
tab <- matrix(c(a, b, c_, d), nrow = 2, byrow = TRUE)
DescTools::OddsRatio(tab, conf.level = 0.95)

# 3) to samo z regresji logistycznej: exp(b) = OR
dane <- data.frame(cwiczenia = rep(c(1, 1, 0, 0), c(a, b, c_, d)),
                   zaliczyl  = rep(c(1, 0, 1, 0), c(a, b, c_, d)))
model <- glm(zaliczyl ~ cwiczenia, family = binomial, data = dane)
round(exp(cbind(OR = coef(model), confint.default(model)))[2, ], 2)
Wynik w konsoli R:
   wartosc CI_dolna CI_gorna
OR       9     2.15    37.66
RR       3     1.35     6.68
odds ratio     lwr.ci     upr.ci
  9.000000   2.150863  37.659298
    OR  2.5 % 97.5 %
  9.00   2.15  37.66
Rachunek ręczny, DescTools::OddsRatio i regresja logistyczna dają ten sam iloraz szans i ten sam przedział. W regresji logistycznej współczynnik przy zmiennej ćwiczenia wynosi 2,197, czyli ln 9. Dlatego exp(b) z regresji logistycznej to właśnie iloraz szans. Wyraz wolny (−1,099 = ln 0,33) to logarytm szansy zaliczenia w grupie niechodzących.
Iloraz szans czy ryzyko względne – czym się różnią?
Gdy zdarzenie jest rzadkie, OR i RR są prawie równe. Przykład: jeśli zachoruje 2 na 100 osób w jednej grupie i 1 na 100 w drugiej, to RR = 2, a OR = 2,02. Gdy zdarzenie jest częste, jak zaliczenie przedmiotu w naszym przykładzie (połowa wszystkich osób), OR „przesadza” w porównaniu z RR: 9 zamiast 3 (Davies i in., 1998). RR łatwiej zrozumieć, dlatego warto go podać, gdy plan badania na to pozwala. OR ma za to wygodne własności matematyczne: wychodzi z regresji logistycznej i nie zależy od tego, czy liczysz szansę zaliczenia, czy szansę niezaliczenia (wtedy OR = 1/9).
Najczęstsze błędy
- Opisywanie ilorazu szans słowami „9 razy częściej” albo „9 razy bardziej prawdopodobne”.
- Liczenie RR w badaniu, w którym osoby dobierano według wyniku (kliniczno-kontrolnym) – tam sensowny jest tylko OR.
- Podawanie OR bez przedziału ufności – przy małych grupach przedział bywa bardzo szeroki.
- Liczenie przedziału jako OR ± 1,96 · SE na zwykłej skali zamiast na logarytmach.
- Odwrócenie tabeli (inna grupa w pierwszym wierszu) i podanie OR = 0,11 bez wyjaśnienia, że to 1/9.
Bibliografia
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01348.x
- Katz, D., Baptista, J., Azen, S. P., & Pike, M. C. (1978). Obtaining confidence intervals for the risk ratio in cohort studies. Biometrics, 34(3), 469–474.
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989
- Szumilas, M. (2010). Explaining odds ratios. Journal of the Canadian Academy of Child and Adolescent Psychiatry, 19(3), 227–229.
- Agresti, A. (2007). An introduction to categorical data analysis (2nd ed.). Wiley.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja logistyczna
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówDokładny test Fishera
- Słownik wzorówTest z dla dwóch proporcji
- PoradnikTest chi-kwadrat – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.