

Dokładny test Fishera – wzór i przykład krok po kroku
Dokładny test Fishera sprawdza, czy dwie zmienne dwuwartościowe są ze sobą powiązane, gdy próba jest za mała na test chi-kwadrat. Typowe pytanie z pracy dyplomowej: czy studenci chodzący na korepetycje częściej zaliczają kolokwium, jeśli w badaniu wzięło udział tylko kilka osób?
W prostych słowachWyobraź sobie, że sumy w wierszach i kolumnach tabeli są ustalone, a osoby rozdajesz do komórek zupełnie losowo. Test Fishera wypisuje wszystkie tabele, które mogłyby wtedy powstać, i liczy, jak często każda z nich by wyszła. Wartość p to łączna szansa na tabele tak samo albo jeszcze mniej prawdopodobne niż Twoja. Nic tu nie jest przybliżone – dlatego test nazywa się „dokładny”.
Kiedy stosować dokładny test Fishera?
- masz tabelę 2 × 2: dwie grupy różnych osób i wynik typu tak/nie (zaliczył/nie zaliczył, pije kawę/nie pije);
- w co najmniej jednej komórce liczebność oczekiwana jest mniejsza niż 5 – wtedy przybliżenie chi-kwadrat bywa zawodne;
- próba jest bardzo mała (kilka–kilkanaście osób), np. badanie pilotażowe albo rzadka grupa.
Przy większych liczebnościach zwykle wystarczy test chi-kwadrat. Gdy te same osoby badasz dwa razy (przed i po), potrzebny jest test McNemara. Siłę związku opisz ilorazem szans albo współczynnikiem phi.
Wzór na prawdopodobieństwo tabeli
- \(a,\ b,\ c,\ d\)
- liczebności w czterech komórkach tabeli: \(a\) i \(b\) w pierwszym wierszu, \(c\) i \(d\) w drugim
- \(a+b,\ c+d\)
- sumy wierszy, czyli liczba osób w każdej grupie
- \(a+c,\ b+d\)
- sumy kolumn, czyli ile osób w ogóle miało wynik „tak”, a ile „nie”
- \(n\)
- liczba wszystkich osób w tabeli
- \(\binom{k}{m}\)
- symbol Newtona: na ile sposobów można wybrać \(m\) osób spośród \(k\)
- \(k!\)
- silnia: iloczyn liczb od 1 do \(k\), np. \(4! = 1 \cdot 2 \cdot 3 \cdot 4 = 24\)
- \(P\)
- prawdopodobieństwo otrzymania dokładnie tej tabeli, gdy zmienne nie są powiązane, a sumy brzegowe są stałe (rozkład hipergeometryczny)
Jak przeczytać ten wzór na głos: „na ile sposobów można rozdać wyniki »tak« w obu grupach tak, jak w tabeli, podzielone przez liczbę wszystkich możliwych rozdań”. Wartość p to suma \(P\) wszystkich tabel, które są tak samo albo mniej prawdopodobne niż tabela z badania.
Przykład krok po kroku
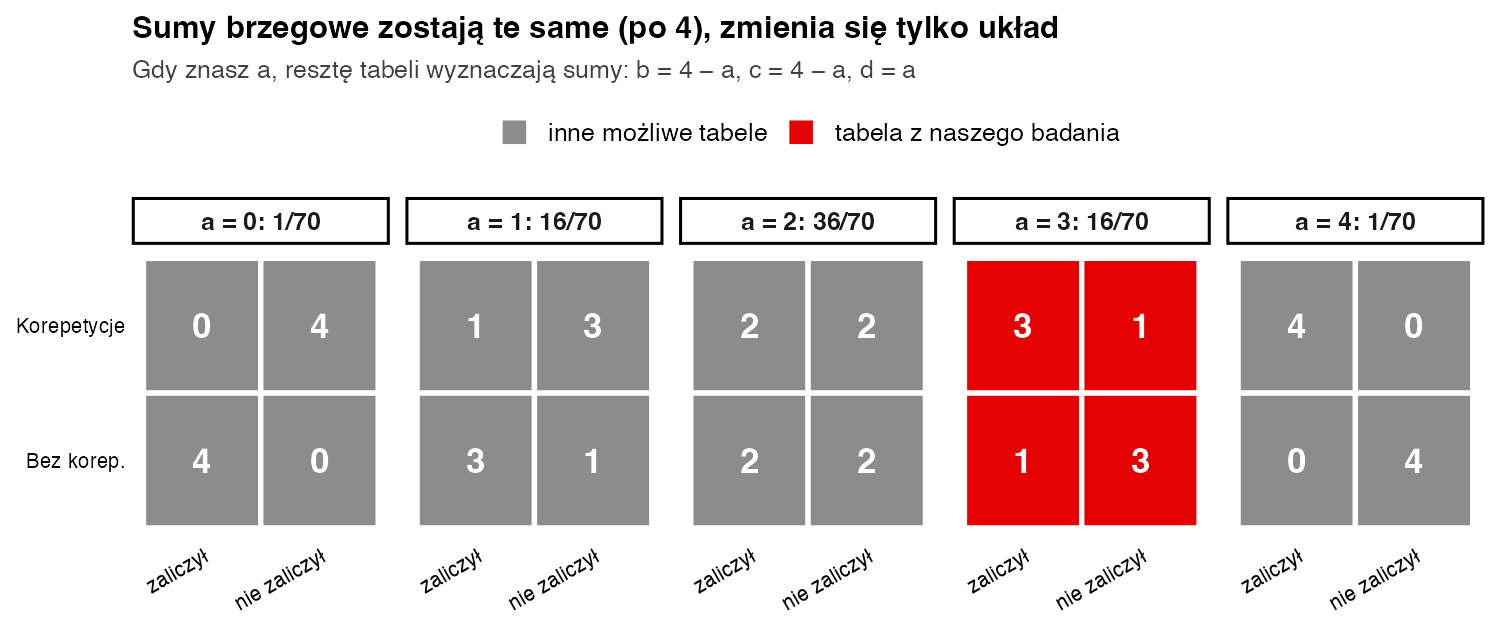
Zbadałeś 8 studentów. Czworo chodziło na korepetycje – 3 z nich zaliczyło kolokwium, 1 nie. Czworo nie chodziło – zaliczył tylko 1, a 3 nie. Tabela to [3, 1; 1, 3]: \(a = 3,\ b = 1,\ c = 1,\ d = 3\), a wszystkie sumy wierszy i kolumn wynoszą 4.
| a | b = 4 − a | c = 4 − a | d = a | \(\binom{4}{a}\) | \(\binom{4}{c}\) | Liczba układów | P = układy / 70 | Czy ≤ P naszej tabeli? |
|---|---|---|---|---|---|---|---|---|
| 0 | 4 | 4 | 0 | 1 | 1 | 1 · 1 = 1 | 0,014 | tak |
| 1 | 3 | 3 | 1 | 4 | 4 | 4 · 4 = 16 | 0,229 | tak |
| 2 | 2 | 2 | 2 | 6 | 6 | 6 · 6 = 36 | 0,514 | nie |
| 3 | 1 | 1 | 3 | 4 | 4 | 4 · 4 = 16 | 0,229 | tak (nasza) |
| 4 | 0 | 0 | 4 | 1 | 1 | 1 · 1 = 1 | 0,014 | tak |
| Suma | 70 | 1,000 | p = 34/70 = 0,486 | |||||
- Liczebności oczekiwane. Dla każdej komórki: suma wiersza · suma kolumny / n = 4 · 4 / 8 = 16 / 8 = 2. Wszystkie cztery komórki mają 2, czyli mniej niż 5. Dlatego zamiast chi-kwadrat wybierasz test Fishera.
- Mianownik. Ile jest sposobów wybrania 4 osób z wynikiem „zaliczył” spośród 8? \(\binom{8}{4} = \frac{8 \cdot 7 \cdot 6 \cdot 5}{4 \cdot 3 \cdot 2 \cdot 1} = \frac{1680}{24} = 70\).
- Prawdopodobieństwo naszej tabeli. Trzy osoby z 4 w grupie z korepetycjami: \(\binom{4}{3} = 4\) sposoby. Jedna osoba z 4 w drugiej grupie: \(\binom{4}{1} = 4\) sposoby. Razem 4 · 4 = 16 układów, więc P = 16 / 70 = 0,229.
- Wszystkie inne tabele. Przy stałych sumach \(a\) może wynosić tylko 0, 1, 2, 3 albo 4. Dla każdej wartości liczysz układy tak samo (Tabela 1). Kontrola: 1 + 16 + 36 + 16 + 1 = 70.
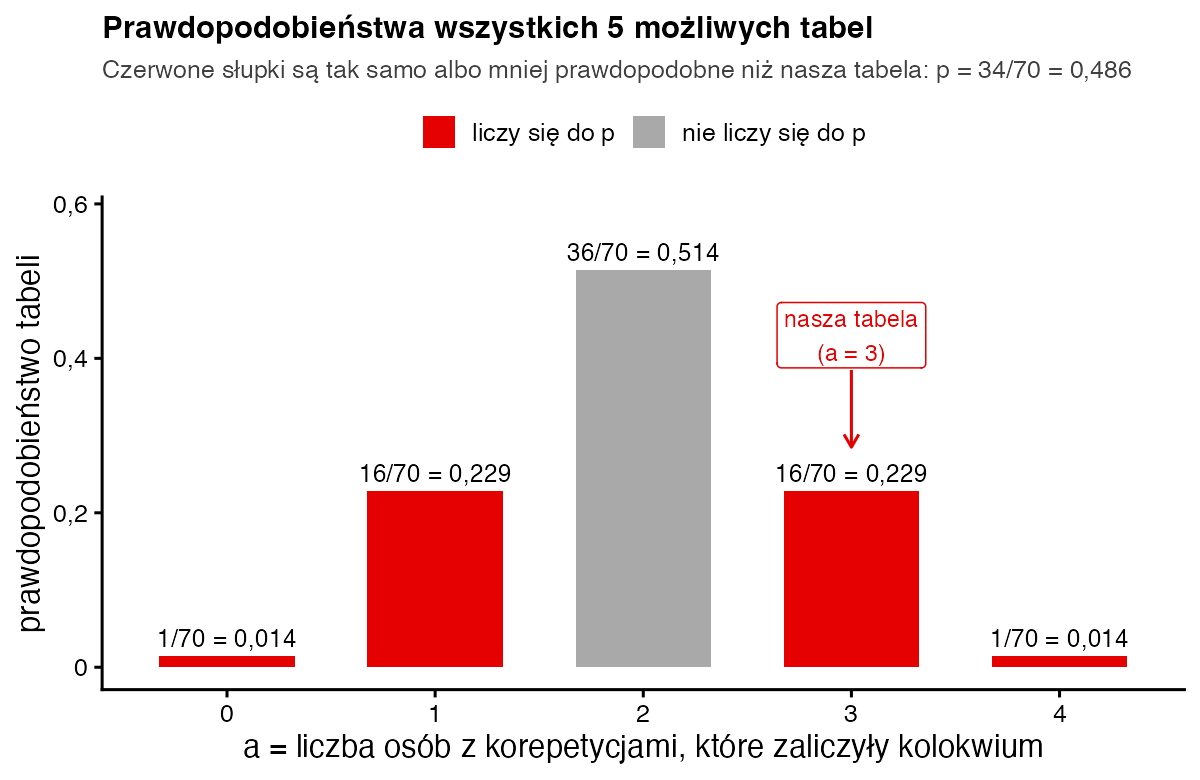
- Wartość p. Sumujesz tabele o P nie większym niż 0,229: (1 + 16 + 16 + 1) / 70 = 34 / 70 = 0,486. Tylko tabela [2, 2; 2, 2] jest bardziej prawdopodobna i nie wchodzi do sumy.
- Decyzja. 0,486 > 0,05, więc brak podstaw do odrzucenia hipotezy zerowej. Iloraz szans z tabeli wynosi (3 · 3) / (1 · 1) = 9, ale przy 8 osobach to oszacowanie jest skrajnie nieprecyzyjne.
Jak zinterpretować i opisać wynik?
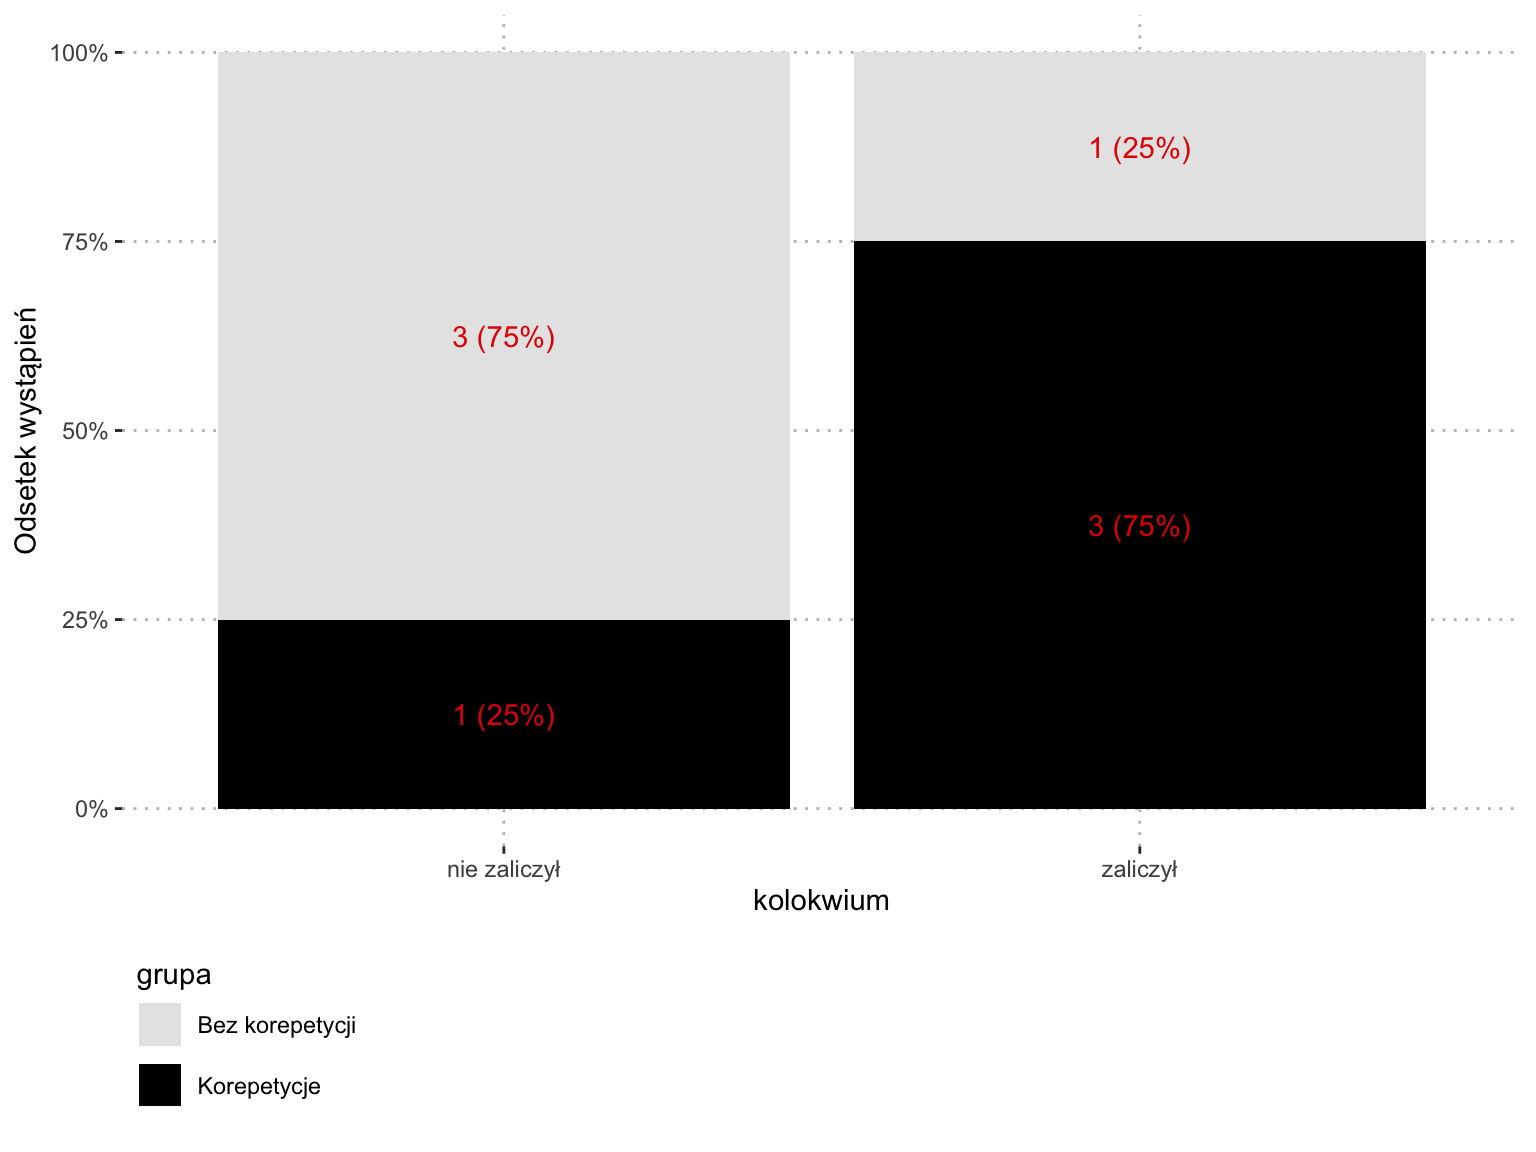
Wśród osób z korepetycjami zaliczyło 75% (3 z 4), a bez korepetycji 25% (1 z 4). Różnica wygląda duża, ale przy 8 osobach taki układ mógł łatwo powstać przypadkiem. Wynik nieistotny nie oznacza, że korepetycje nie pomagają. Oznacza, że ta próba jest za mała, żeby to stwierdzić. W opisie podaj procenty, nazwę testu, p i iloraz szans z przedziałem ufności.
Zapis w stylu APA: Kolokwium zaliczyło 75% osób chodzących na korepetycje i 25% osób bez korepetycji. Dokładny test Fishera nie wykazał istotnego związku, p = 0,486 (dwustronnie); OR = 9,00; 95% CI [0,21; 621,93].
Przedział ufności dla ilorazu szans pochodzi z funkcji fisher.test i obejmuje 1, co zgadza się z nieistotnym wynikiem testu.
Jak policzyć dokładny test Fishera w R?
# Korepetycje a zaliczenie kolokwium (8 studentów)
tab <- matrix(c(3, 1,
                1, 3), nrow = 2, byrow = TRUE,
              dimnames = list(grupa = c("Korepetycje", "Bez korepetycji"),
                              kolokwium = c("zaliczył", "nie zaliczył")))

# 1) „ręcznie”: wszystkie możliwe tabele przy tych samych sumach brzegowych
a <- 0:4                                     # liczba w lewej górnej komórce
P <- choose(4, a) * choose(4, 4 - a) / choose(8, 4)
data.frame(a, liczba_ukladow = P * 70, P = round(P, 3))
sum(P[P <= P[a == 3] + 1e-9])                # p dwustronne = 34/70

# 2) gotowa funkcja
fisher.test(tab)

# 3) liczebności oczekiwane – dlaczego nie chi-kwadrat
outer(rowSums(tab), colSums(tab)) / sum(tab)
Wynik w konsoli R:
  a liczba_ukladow     P
1 0              1 0.014
2 1             16 0.229
3 2             36 0.514
4 3             16 0.229
5 4              1 0.014
[1] 0.4857143

	Fisher's Exact Test for Count Data

data:  tab
p-value = 0.4857
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
   0.2117329 621.9337505
sample estimates:
odds ratio
  6.408309

                zaliczył nie zaliczył
Korepetycje            2            2
Bez korepetycji        2            2
Rachunek ręczny i fisher.test dają to samo p = 0,486. Uwaga: R podaje iloraz szans 6,41, a nie 9. To tzw. warunkowy estymator największej wiarygodności. Przy dużych próbach jest bliski zwykłemu ilorazowi (a · d) / (b · c), a przy bardzo małych – wyraźnie się od niego różni.
Test Fishera czy chi-kwadrat – kiedy który?
Najczęściej stosowana reguła (Cochran) mówi, że chi-kwadrat jest bezpieczny, gdy żadna liczebność oczekiwana nie jest mniejsza niż 1 i najwyżej 20% komórek ma mniej niż 5. W tabeli 2 × 2 oznacza to w praktyce: każda komórka oczekiwana co najmniej 5. W naszym przykładzie chi-kwadrat dałby χ²(1) = 2,00 i p = 0,157 – wynik dużo bardziej „optymistyczny” niż dokładne 0,486. Campbell (2007) pokazał jednak, że klasyczny test Fishera bywa zbyt ostrożny. Dla dużych prób oba testy dają bardzo podobne p, więc przy kilkuset osobach wybór nie ma znaczenia.
Najczęstsze błędy
- Sprawdzanie reguły „5” na liczebnościach obserwowanych zamiast oczekiwanych.
- Używanie testu Fishera dla tych samych osób zbadanych dwa razy – tu potrzebny jest test McNemara.
- Pisanie „przyjęto hipotezę zerową” przy p > 0,05 – poprawnie: brak podstaw do jej odrzucenia.
- Podawanie samego p bez procentów w grupach i bez wielkości efektu.
- Zdziwienie, że iloraz szans z
fisher.testróżni się od policzonego ręcznie – to dwa różne estymatory.
Bibliografia
- Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Agresti, A. (1992). A survey of exact inference for contingency tables. Statistical Science, 7(1), 131–153. https://doi.org/10.1214/ss/1177011454
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówTest McNemara
- Słownik wzorówIloraz szans i ryzyko względne
- Słownik wzorówWspółczynnik phi (φ)
- PoradnikTest chi-kwadrat – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.