

Test z dla dwóch proporcji – wzór i przykład
Test z dla dwóch proporcji sprawdza, czy odsetek odpowiedzi „tak” w dwóch różnych grupach różni się bardziej, niż mogłoby się zdarzyć przez przypadek. Typowe pytanie z pracy dyplomowej: czy wśród studentów uczących się z quizów kolokwium zalicza większy odsetek osób niż wśród uczących się z notatek?
W prostych słowachLiczysz odsetek w każdej grupie i ich różnicę. Potem sprawdzasz, jak duża różnica mogłaby wyjść „sama z siebie”, gdyby w obu grupach odsetek był taki sam. Iloraz tych dwóch liczb to z. Im dalej z od zera, tym trudniej uznać różnicę za przypadek.
Kiedy stosować test z dla dwóch proporcji?
- masz dwie niezależne grupy różnych osób (np. dwie metody nauki, kobiety i mężczyzn);
- wynik jest dwuwartościowy: zdał/nie zdał, tak/nie, korzysta/nie korzysta;
- w każdej grupie jest co najmniej kilka odpowiedzi każdego rodzaju – w praktyce oczekiwane liczebności we wszystkich czterech komórkach tabeli powinny wynosić co najmniej 5;
- chcesz znać kierunek różnicy i przedział ufności dla różnicy odsetków, a nie tylko „czy jest związek”.
Ten test daje ten sam wynik co test chi-kwadrat dla tabeli 2 × 2. Przy małych liczebnościach wybierz dokładny test Fishera. Gdy te same osoby odpowiadają dwa razy (przed i po), potrzebujesz testu McNemara. Dla jednego odsetka wystarczy przedział ufności dla proporcji.
Wzór na test z dla dwóch proporcji
- \(x_1,\ x_2\)
- liczba odpowiedzi „tak” (np. osób, które zdały) w grupie 1 i 2
- \(n_1,\ n_2\)
- liczba osób w grupie 1 i 2
- \(\hat{p}_1,\ \hat{p}_2\)
- odsetki w grupach jako ułamki: \(x_1/n_1\) i \(x_2/n_2\)
- \(\bar{p}\)
- odsetek wspólny – wszystkie „tak” podzielone przez wszystkie osoby; tak wyglądałby odsetek, gdyby grupy się nie różniły (hipoteza zerowa)
- \(\sqrt{\dots}\)
- błąd standardowy różnicy przy prawdziwej H0 – typowa wielkość różnicy „przez przypadek”
- \(z\)
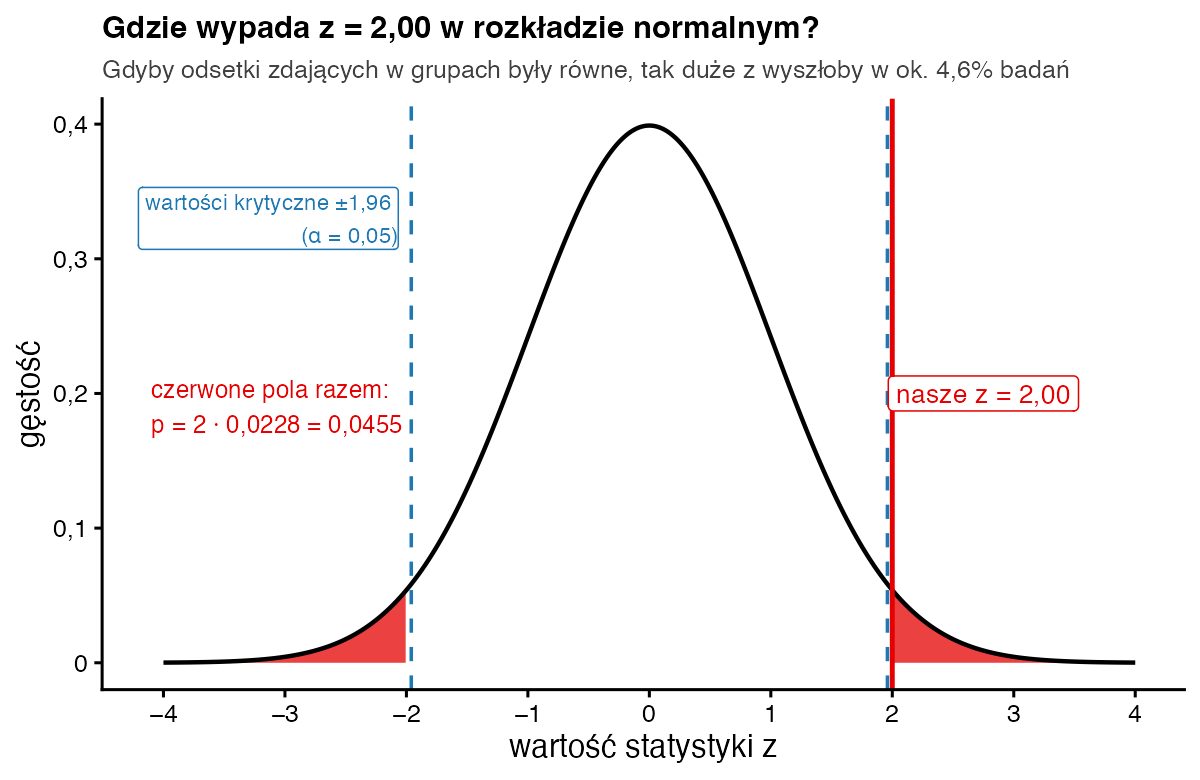
- statystyka testu; porównujesz ją z rozkładem normalnym (dla α = 0,05 wartości krytyczne to ±1,96)
Wzór przeczytasz na głos tak: „różnica odsetków podzielona przez pierwiastek z iloczynu: odsetek wspólny razy jeden minus odsetek wspólny razy suma odwrotności liczebności grup”.
Przykład krok po kroku
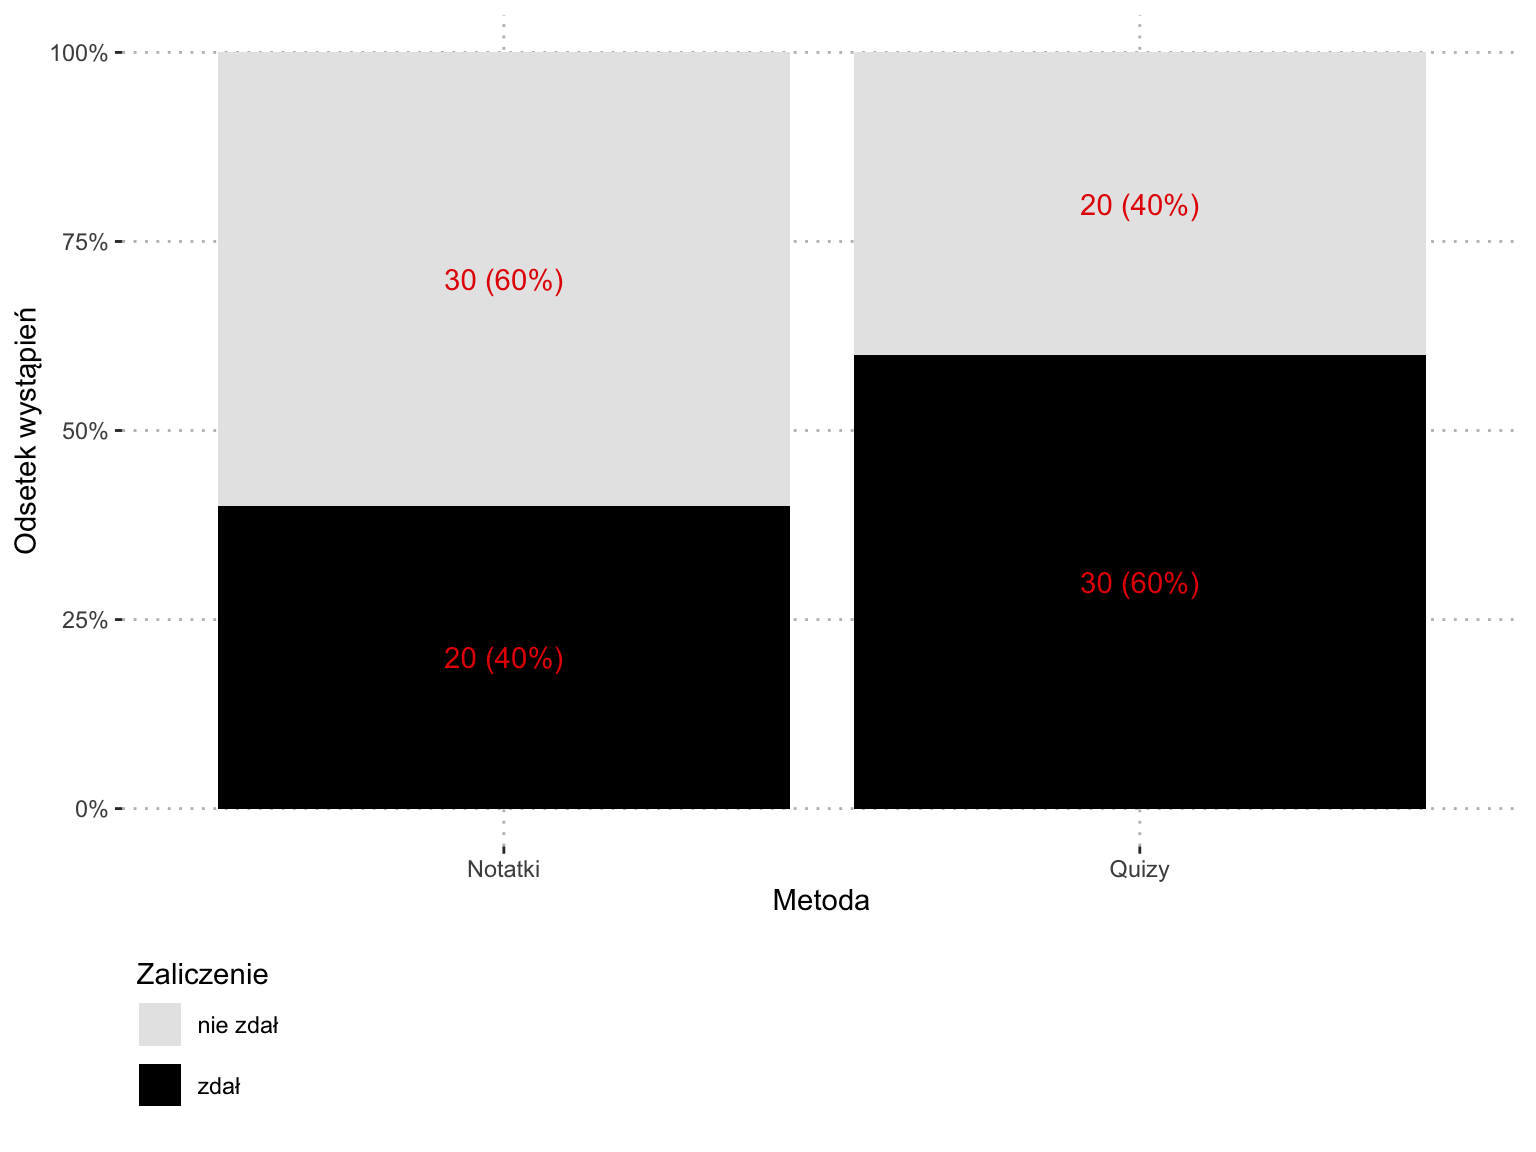
Pięćdziesięciu studentów uczyło się z quizów, a pięćdziesięciu z notatek. Kolokwium zaliczyło odpowiednio 30 i 20 osób:
| Grupa | Zdało (x) | Nie zdało | Razem (n) | Odsetek zdających x / n |
|---|---|---|---|---|
| Quizy | 30 | 50 − 30 = 20 | 50 | 30 / 50 = 0,6 |
| Notatki | 20 | 50 − 20 = 30 | 50 | 20 / 50 = 0,4 |
| Razem | 50 | 50 | 100 | 50 / 100 = 0,5 |
- Odsetki i różnica. Quizy: 30 / 50 = 0,6 (60%). Notatki: 20 / 50 = 0,4 (40%). Różnica: 0,6 − 0,4 = 0,2, czyli 20 punktów procentowych.
- Odsetek wspólny. (30 + 20) / (50 + 50) = 50 / 100 = 0,5. Zakładamy na chwilę, że grupy się nie różnią i obie mają po 50% zdających.
- Błąd standardowy. 0,5 · (1 − 0,5) = 0,5 · 0,5 = 0,25. Dalej 1/50 + 1/50 = 0,02 + 0,02 = 0,04. Iloczyn: 0,25 · 0,04 = 0,01. Pierwiastek: √0,01 = 0,1.
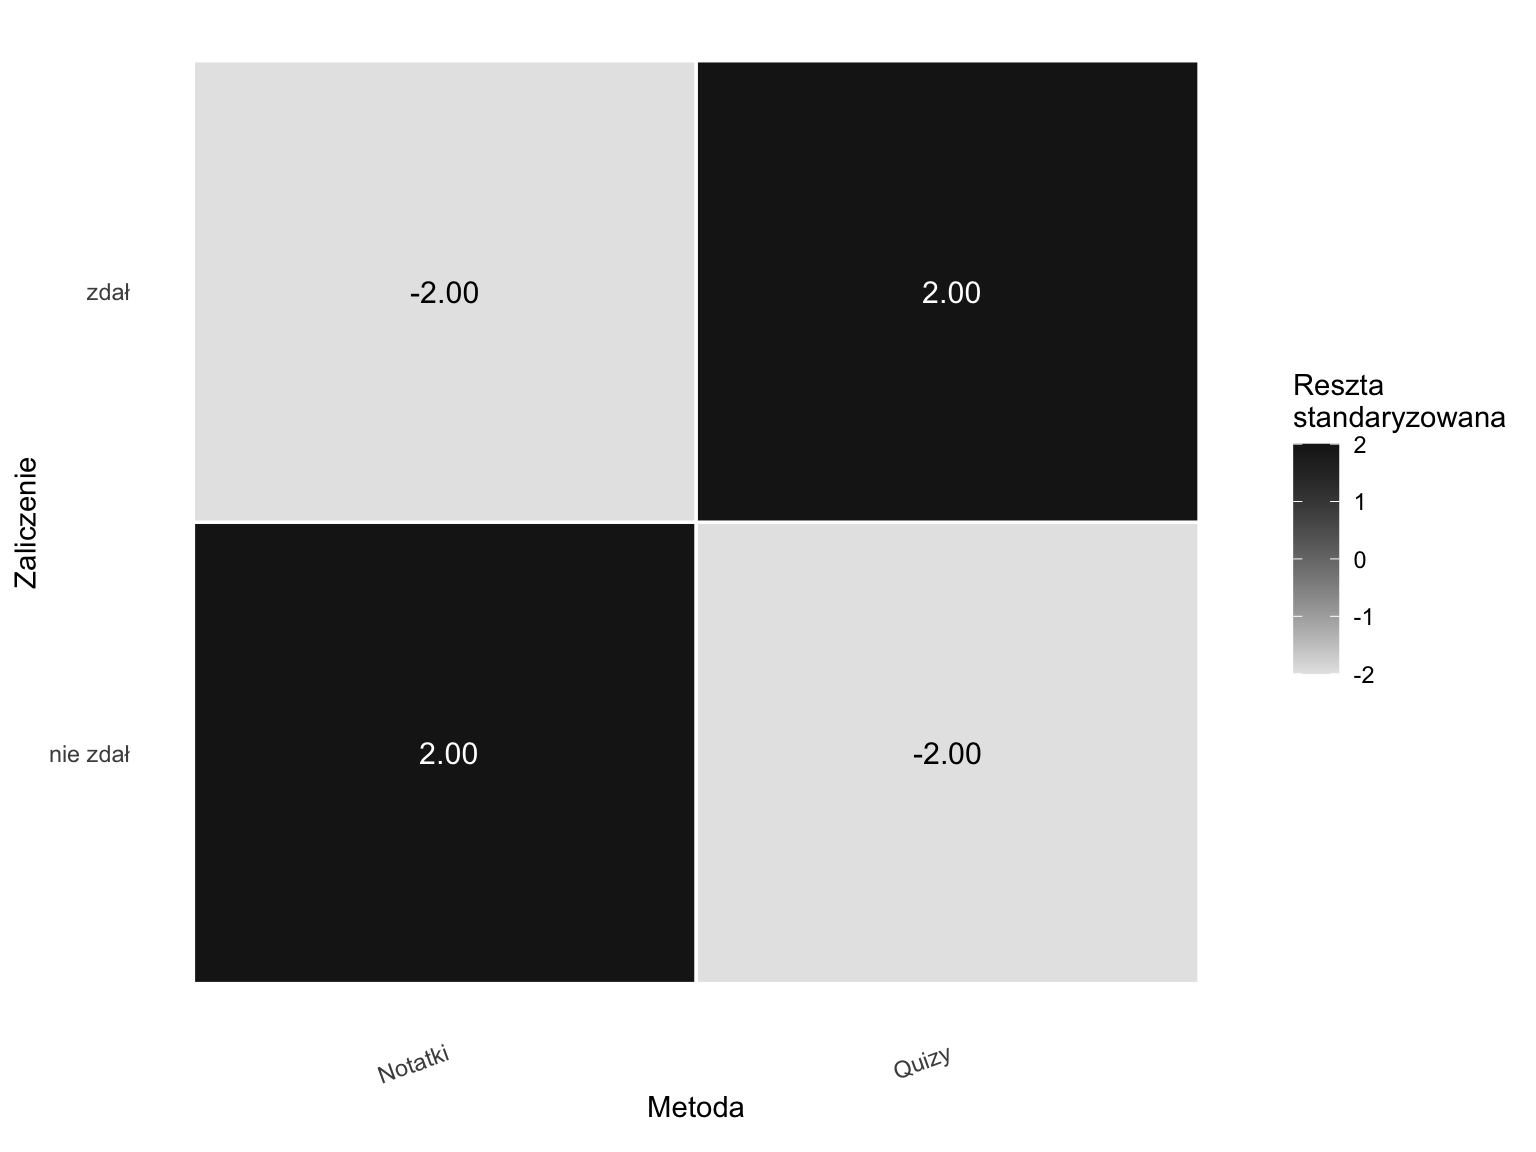
- Statystyka z. z = 0,2 / 0,1 = 2,00. Różnica jest dwa razy większa niż jej typowe „przypadkowe” wahanie.
- Wartość p. W tablicy rozkładu normalnego dla z = 2,00 odczytasz 0,97725 – tyle pola leży na lewo od 2. W prawym ogonie zostaje 1 − 0,97725 = 0,02275. Test jest dwustronny, więc mnożymy przez 2: p = 0,0455 ≈ 0,046. W R:
2 * pnorm(-2). Ponieważ p < 0,05 (i |z| = 2,00 > 1,96), różnicę uznajemy za istotną statystycznie. - Związek z chi-kwadrat. z² = 2 · 2 = 4. Test chi-kwadrat (bez poprawki Yatesa) dla tej samej tabeli daje dokładnie χ²(1) = 4,00 i to samo p = 0,046.
- Przedział ufności dla różnicy. Tu nie zakładamy równości grup, więc każdy odsetek ma własną wariancję: 0,6 · 0,4 / 50 = 0,24 / 50 = 0,0048 oraz 0,4 · 0,6 / 50 = 0,0048. Suma 0,0096; √0,0096 ≈ 0,098. Margines: 1,96 · 0,098 ≈ 0,192. Granice: 0,2 − 0,192 = 0,008 i 0,2 + 0,192 = 0,392, czyli 95% CI od 0,8 do 39,2 punktu procentowego.
- Wielkość efektu. Współczynnik phi = √(χ² / n) = √(4 / 100) = √0,04 = 0,20 – związek słaby, między umownymi progami 0,1 (mały) i 0,3 (średni) według Cohena (1988).
Jak zinterpretować i opisać wynik?
Kolokwium zaliczyło 60% osób uczących się z quizów i 40% uczących się z notatek. Gdyby metoda nauki nie miała znaczenia, różnica co najmniej tak duża wyszłaby w około 4,6% podobnych badań – to mówi wartość p. Przedział ufności [0,8; 39,2] punktu procentowego nie obejmuje zera, co jest zgodne z wynikiem testu. Pokazuje on jednak, że prawdziwa przewaga quizów może być zarówno ledwie zauważalna, jak i bardzo duża. Wynik jest „na granicy” – przy jednej osobie mniej w grupie Quizy, które zdały, różnica nie byłaby już istotna. Pamiętaj, że bez losowego przydziału do grup nie wiesz, czy to metoda nauki podnosi zdawalność.
Zapis w stylu APA: Odsetek osób, które zaliczyły kolokwium, był istotnie wyższy w grupie uczącej się z quizów (60%) niż w grupie uczącej się z notatek (40%), z = 2,00; p = 0,046; różnica = 20 punktów procentowych, 95% CI [0,8; 39,2]; φ = 0,20.
Jak policzyć test z dla dwóch proporcji w R?
x <- c(quizy = 30, notatki = 20)    # liczba osób, które zdały
n <- c(quizy = 50, notatki = 50)    # liczba osób w grupie

# 1) test z „ręcznie”
p1 <- x[1] / n[1]; p2 <- x[2] / n[2]                 # 0,6 i 0,4
p_wsp <- sum(x) / sum(n)                             # 0,5
se0 <- sqrt(p_wsp * (1 - p_wsp) * (1/n[1] + 1/n[2])) # 0,1
z <- (p1 - p2) / se0
p_val <- 2 * pnorm(-abs(z))
round(c(z = unname(z), z_kwadrat = unname(z^2), p = unname(p_val)), 4)

# 2) przedział ufności dla różnicy (SE bez łączenia odsetków)
se1 <- sqrt(p1 * (1 - p1) / n[1] + p2 * (1 - p2) / n[2])
round(unname((p1 - p2) + c(-1, 1) * qnorm(0.975) * se1), 3)

# 3) gotowa funkcja: prop.test() bez poprawki Yatesa (podaje chi2 = z^2)
prop.test(x, n, correct = FALSE)
Wynik w konsoli R:
        z z_kwadrat         p
   2.0000    4.0000    0.0455
[1] 0.008 0.392

	2-sample test for equality of proportions without continuity
	correction

data:  x out of n
X-squared = 4, df = 1, p-value = 0.0455
alternative hypothesis: two.sided
95 percent confidence interval:
 0.007963533 0.392036467
sample estimates:
prop 1 prop 2
   0.6    0.4
R nie ma osobnej funkcji „test z dla proporcji” – robi to prop.test(), która podaje statystykę chi-kwadrat równą z². Ważne: bez correct = FALSE funkcja dodaje poprawkę Yatesa i dla tych danych wyjdzie χ² = 3,24 oraz p = 0,072. Przedział ufności w wyniku liczony jest z osobnych wariancji grup, dokładnie jak w kroku 7.
Test z dla dwóch proporcji czy test chi-kwadrat?
Dla tabeli 2 × 2 to ten sam test: z² = χ², a wartości p są identyczne (dwustronnie). Test z ma dwie zalety. Ma znak, więc widzisz, która grupa ma wyższy odsetek. Do tego łatwo z niego przejść do przedziału ufności dla różnicy odsetków, który czytelnik rozumie od razu („od 1 do 39 punktów procentowych”). Chi-kwadrat jest wygodniejszy, gdy tabela ma więcej wierszy lub kolumn. Uwaga techniczna: test używa wspólnego odsetka w błędzie standardowym, a przedział – osobnych odsetków. W wynikach bardzo bliskich granicy (p ≈ 0,05) test i przedział mogą więc wyjątkowo dać odmienne wnioski. Lepiej działający przedział dla różnicy proporcji opisał Newcombe (1998). Jeśli chcesz opisać różnicę jako „ile razy większa szansa”, użyj ilorazu szans lub ryzyka względnego.
Najczęstsze błędy
- Stosowanie testu przy bardzo małych grupach (oczekiwane liczebności poniżej 5) – wtedy lepszy jest dokładny test Fishera.
- Porównywanie odsetków tych samych osób w dwóch pomiarach tym testem zamiast testem McNemara.
- Podawanie wyniku z
prop.test()z poprawką Yatesa i opisywanie go jako „test z” – liczby się wtedy nie zgadzają. - Raportowanie samego p bez odsetków, liczebności grup i przedziału dla różnicy.
- Mylenie różnicy w punktach procentowych (60% − 40% = 20 pp) z różnicą względną (60% to o 50% więcej niż 40%).
Bibliografia
- Fleiss, J. L., Levin, B., & Paik, M. C. (2003). Statistical methods for rates and proportions (3rd ed.). John Wiley & Sons.
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890.
- Agresti, A. (2007). An introduction to categorical data analysis (2nd ed.). John Wiley & Sons.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówPrzedział ufności dla proporcji
- Słownik wzorówWspółczynnik phi (φ)
- Słownik wzorówIloraz szans i ryzyko względne
- PoradnikTest chi-kwadrat – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.