

Interakcja w regresji (moderacja) – wzór i przykład krok po kroku
Interakcja w regresji sprawdza, czy siła związku między dwiema zmiennymi zależy od trzeciej zmiennej, zwanej moderatorem. Typowe pytanie z pracy dyplomowej: czy dodatkowa godzina nauki daje tyle samo punktów studentom mało i bardzo zmotywowanym?
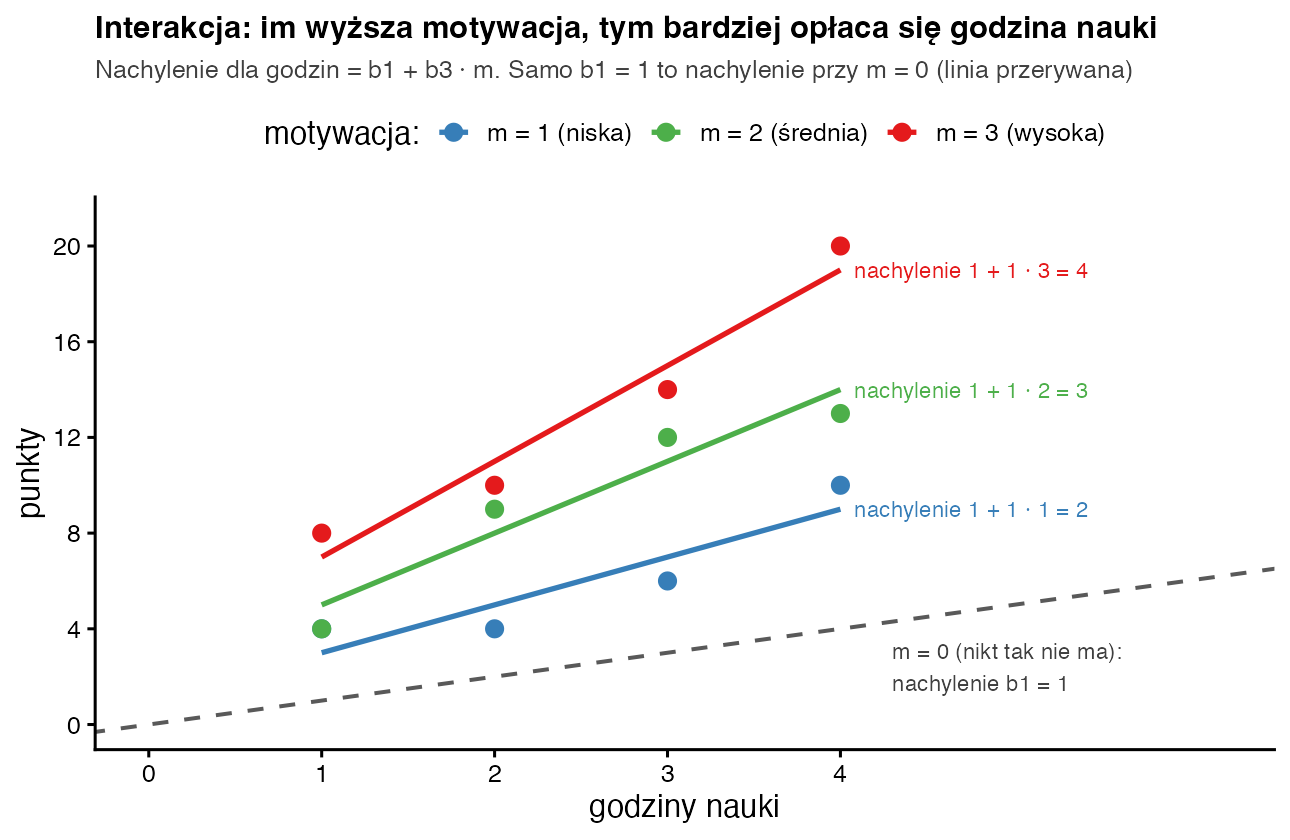
W prostych słowachBez interakcji zakładasz, że każda godzina nauki daje wszystkim tyle samo punktów – linie na wykresie są równoległe. Z interakcją pozwalasz, żeby nachylenie linii zmieniało się razem z moderatorem. Jeśli u osób z wysoką motywacją linia jest bardziej stroma, motywacja „wzmacnia” efekt nauki. Uwaga na pułapkę: w modelu z interakcją współczynnik „godzin” nie jest już ogólnym efektem godzin, tylko efektem przy motywacji równej zero.
Kiedy stosować interakcję w regresji?
- masz hipotezę typu „związek X z Y jest silniejszy (słabszy) u osób z wysokim M”;
- predyktor X i moderator M są ilościowe albo jeden z nich jest dwuwartościowy (np. płeć zakodowana 0/1);
- zmienna wyjaśniana Y jest ilościowa i spełnia założenia regresji liniowej.
Gdy oba czynniki są grupami (np. metoda nauki i długość snu), ten sam pomysł nazywa się interakcją w dwuczynnikowej ANOVA. Jeśli pytasz nie „kiedy?”, ale „przez co?” X wpływa na Y, potrzebujesz mediacji – zobacz efekt pośredni i test Sobela.
Wzór modelu z interakcją
- \(x\)
- predyktor, np. liczba godzin nauki
- \(m\)
- moderator, np. motywacja na skali 1–3
- \(x m\)
- iloczyn predyktora i moderatora – nowa kolumna danych, która „przechowuje” interakcję
- \(b_0\)
- przewidywany wynik, gdy x = 0 i m = 0
- \(b_1\)
- nachylenie dla x, gdy m = 0 (efekt warunkowy, nie „główny”)
- \(b_2\)
- nachylenie dla m, gdy x = 0
- \(b_3\)
- o ile zmienia się nachylenie dla x, gdy m rośnie o 1 – to jest właściwa miara interakcji
- \(b_1 + b_3 m\)
- proste nachylenie (ang. simple slope): efekt godzin przy wybranym poziomie motywacji
- \(s^2,\ \mathrm{cov}\)
- wariancje i kowariancja oszacowań współczynników (z macierzy
vcov()w R)
Jak przeczytać wzór na głos: „każda godzina nauki daje b1 punktów plus b3 punktów za każdy stopień motywacji”.
Przykład krok po kroku
Dwanaścioro studentów podało liczbę godzin nauki (1–4) i motywację (1 – niska, 2 – średnia, 3 – wysoka). R dopasował model: ŷ = 0 + 1 · godziny + 1 · motywacja + 1 · godziny · motywacja. Tabela pokazuje, że te współczynniki rzeczywiście dobrze odtwarzają dane.
| x (godziny) | m (motywacja) | x · m | y (punkty) | ŷ = x + m + x · m | reszta y − ŷ |
|---|---|---|---|---|---|
| 1 | 1 | 1 · 1 = 1 | 4 | 1 + 1 + 1 = 3 | 1 |
| 2 | 1 | 2 · 1 = 2 | 4 | 2 + 1 + 2 = 5 | −1 |
| 3 | 1 | 3 · 1 = 3 | 6 | 3 + 1 + 3 = 7 | −1 |
| 4 | 1 | 4 · 1 = 4 | 10 | 4 + 1 + 4 = 9 | 1 |
| 1 | 2 | 1 · 2 = 2 | 4 | 1 + 2 + 2 = 5 | −1 |
| 2 | 2 | 2 · 2 = 4 | 9 | 2 + 2 + 4 = 8 | 1 |
| 3 | 2 | 3 · 2 = 6 | 12 | 3 + 2 + 6 = 11 | 1 |
| 4 | 2 | 4 · 2 = 8 | 13 | 4 + 2 + 8 = 14 | −1 |
| 1 | 3 | 1 · 3 = 3 | 8 | 1 + 3 + 3 = 7 | 1 |
| 2 | 3 | 2 · 3 = 6 | 10 | 2 + 3 + 6 = 11 | −1 |
| 3 | 3 | 3 · 3 = 9 | 14 | 3 + 3 + 9 = 15 | −1 |
| 4 | 3 | 4 · 3 = 12 | 20 | 4 + 3 + 12 = 19 | 1 |
| Σ = 30 | Σ = 24 | Σ = 60 | Σ = 114 | Σ = 114 | Σ = 0; Σ reszt² = 12 |
- Kolumna iloczynu. Dla każdej osoby mnożysz godziny przez motywację, np. 3 · 2 = 6. Model traktuje ją jak trzeci predyktor.
- Współczynniki. R podaje b0 = 0, b1 = 1, b2 = 1 i b3 = 1. Interakcja: b3 = 1, SE = 0,387, t = 1 / 0,387 = 2,58, df = 12 − 4 = 8, p = 0,033. Wartość krytyczna t dla α = 0,05 i df = 8 to 2,306 (w R:
qt(0.975, 8)). - Proste nachylenia. Wstaw motywację do b1 + b3m: przy m = 1: 1 + 1 · 1 = 2 punkty za godzinę; przy m = 2: 1 + 1 · 2 = 3; przy m = 3: 1 + 1 · 3 = 4.
- Błąd standardowy nachylenia. Z macierzy
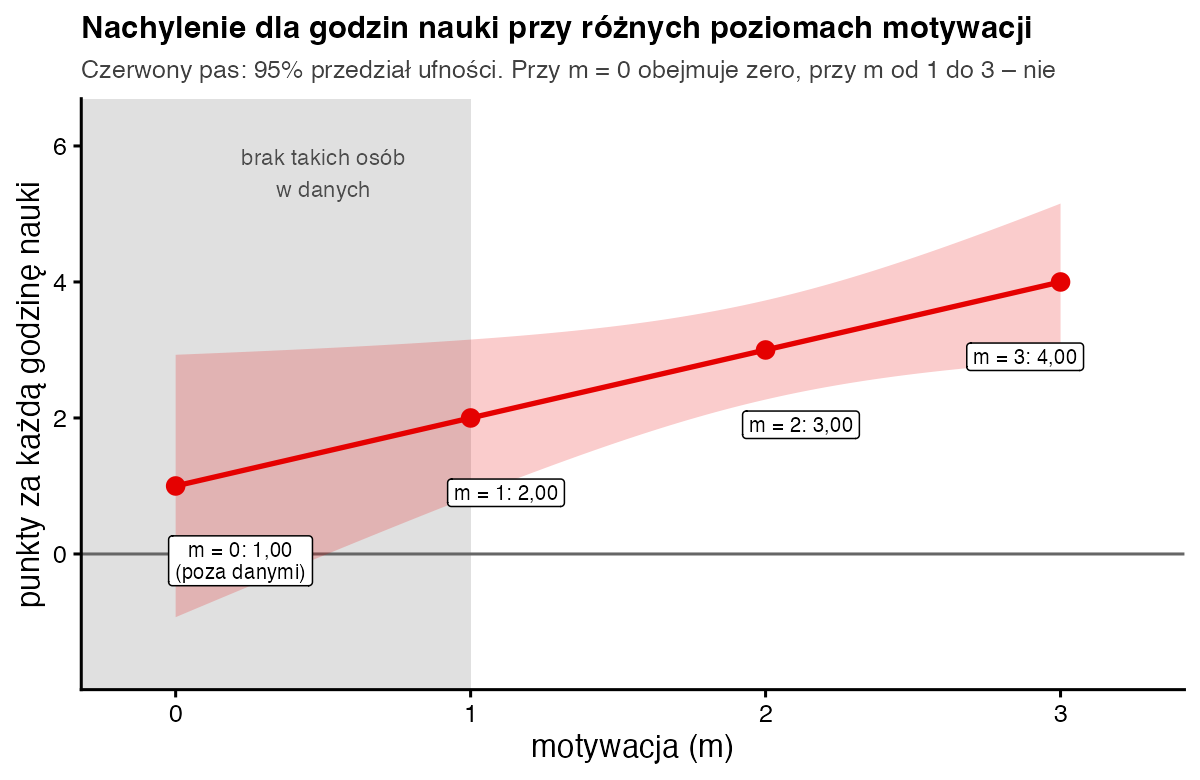
vcov(): \(s^2_{b_1} = 0{,}70\), \(s^2_{b_3} = 0{,}15\), cov = −0,30. Przy m = 1: 0,70 + 1 · 0,15 + 2 · 1 · (−0,30) = 0,25; √0,25 = 0,5; t = 2 / 0,5 = 4,00; p = 0,004. Przy m = 3: 0,70 + 9 · 0,15 − 6 · 0,30 = 0,25; t = 4 / 0,5 = 8,00; p < 0,001. - Centrowanie. Odejmij średnie: x − 2,5 i m − 2. Nowe b1 = 1 + 1 · 2 = 3 (efekt godzin przy przeciętnej motywacji), nowe b2 = 1 + 1 · 2,5 = 3,5, nowe b0 = 0 + 2,5 + 2 + 1 · 2,5 · 2 = 9,5 (średnia punktów). b3 = 1 się nie zmienia.
- Ile dodaje interakcja? R² modelu bez iloczynu to 0,914, a z iloczynem 0,953. Przyrost ΔR² = 10 / 255 = 0,039 – iloczyn zmniejszył sumę kwadratów reszt z 22 do 12.
Nieskorygowany wydruk mówi: godziny b1 = 1, p = 0,266. Kusi, by napisać „godziny nauki nie mają istotnego efektu”. To błąd. b1 to efekt godzin przy motywacji 0, a takiej osoby w danych nie ma. Przy każdej istniejącej motywacji efekt godzin jest wyraźny i istotny.
Jak zinterpretować i opisać wynik?
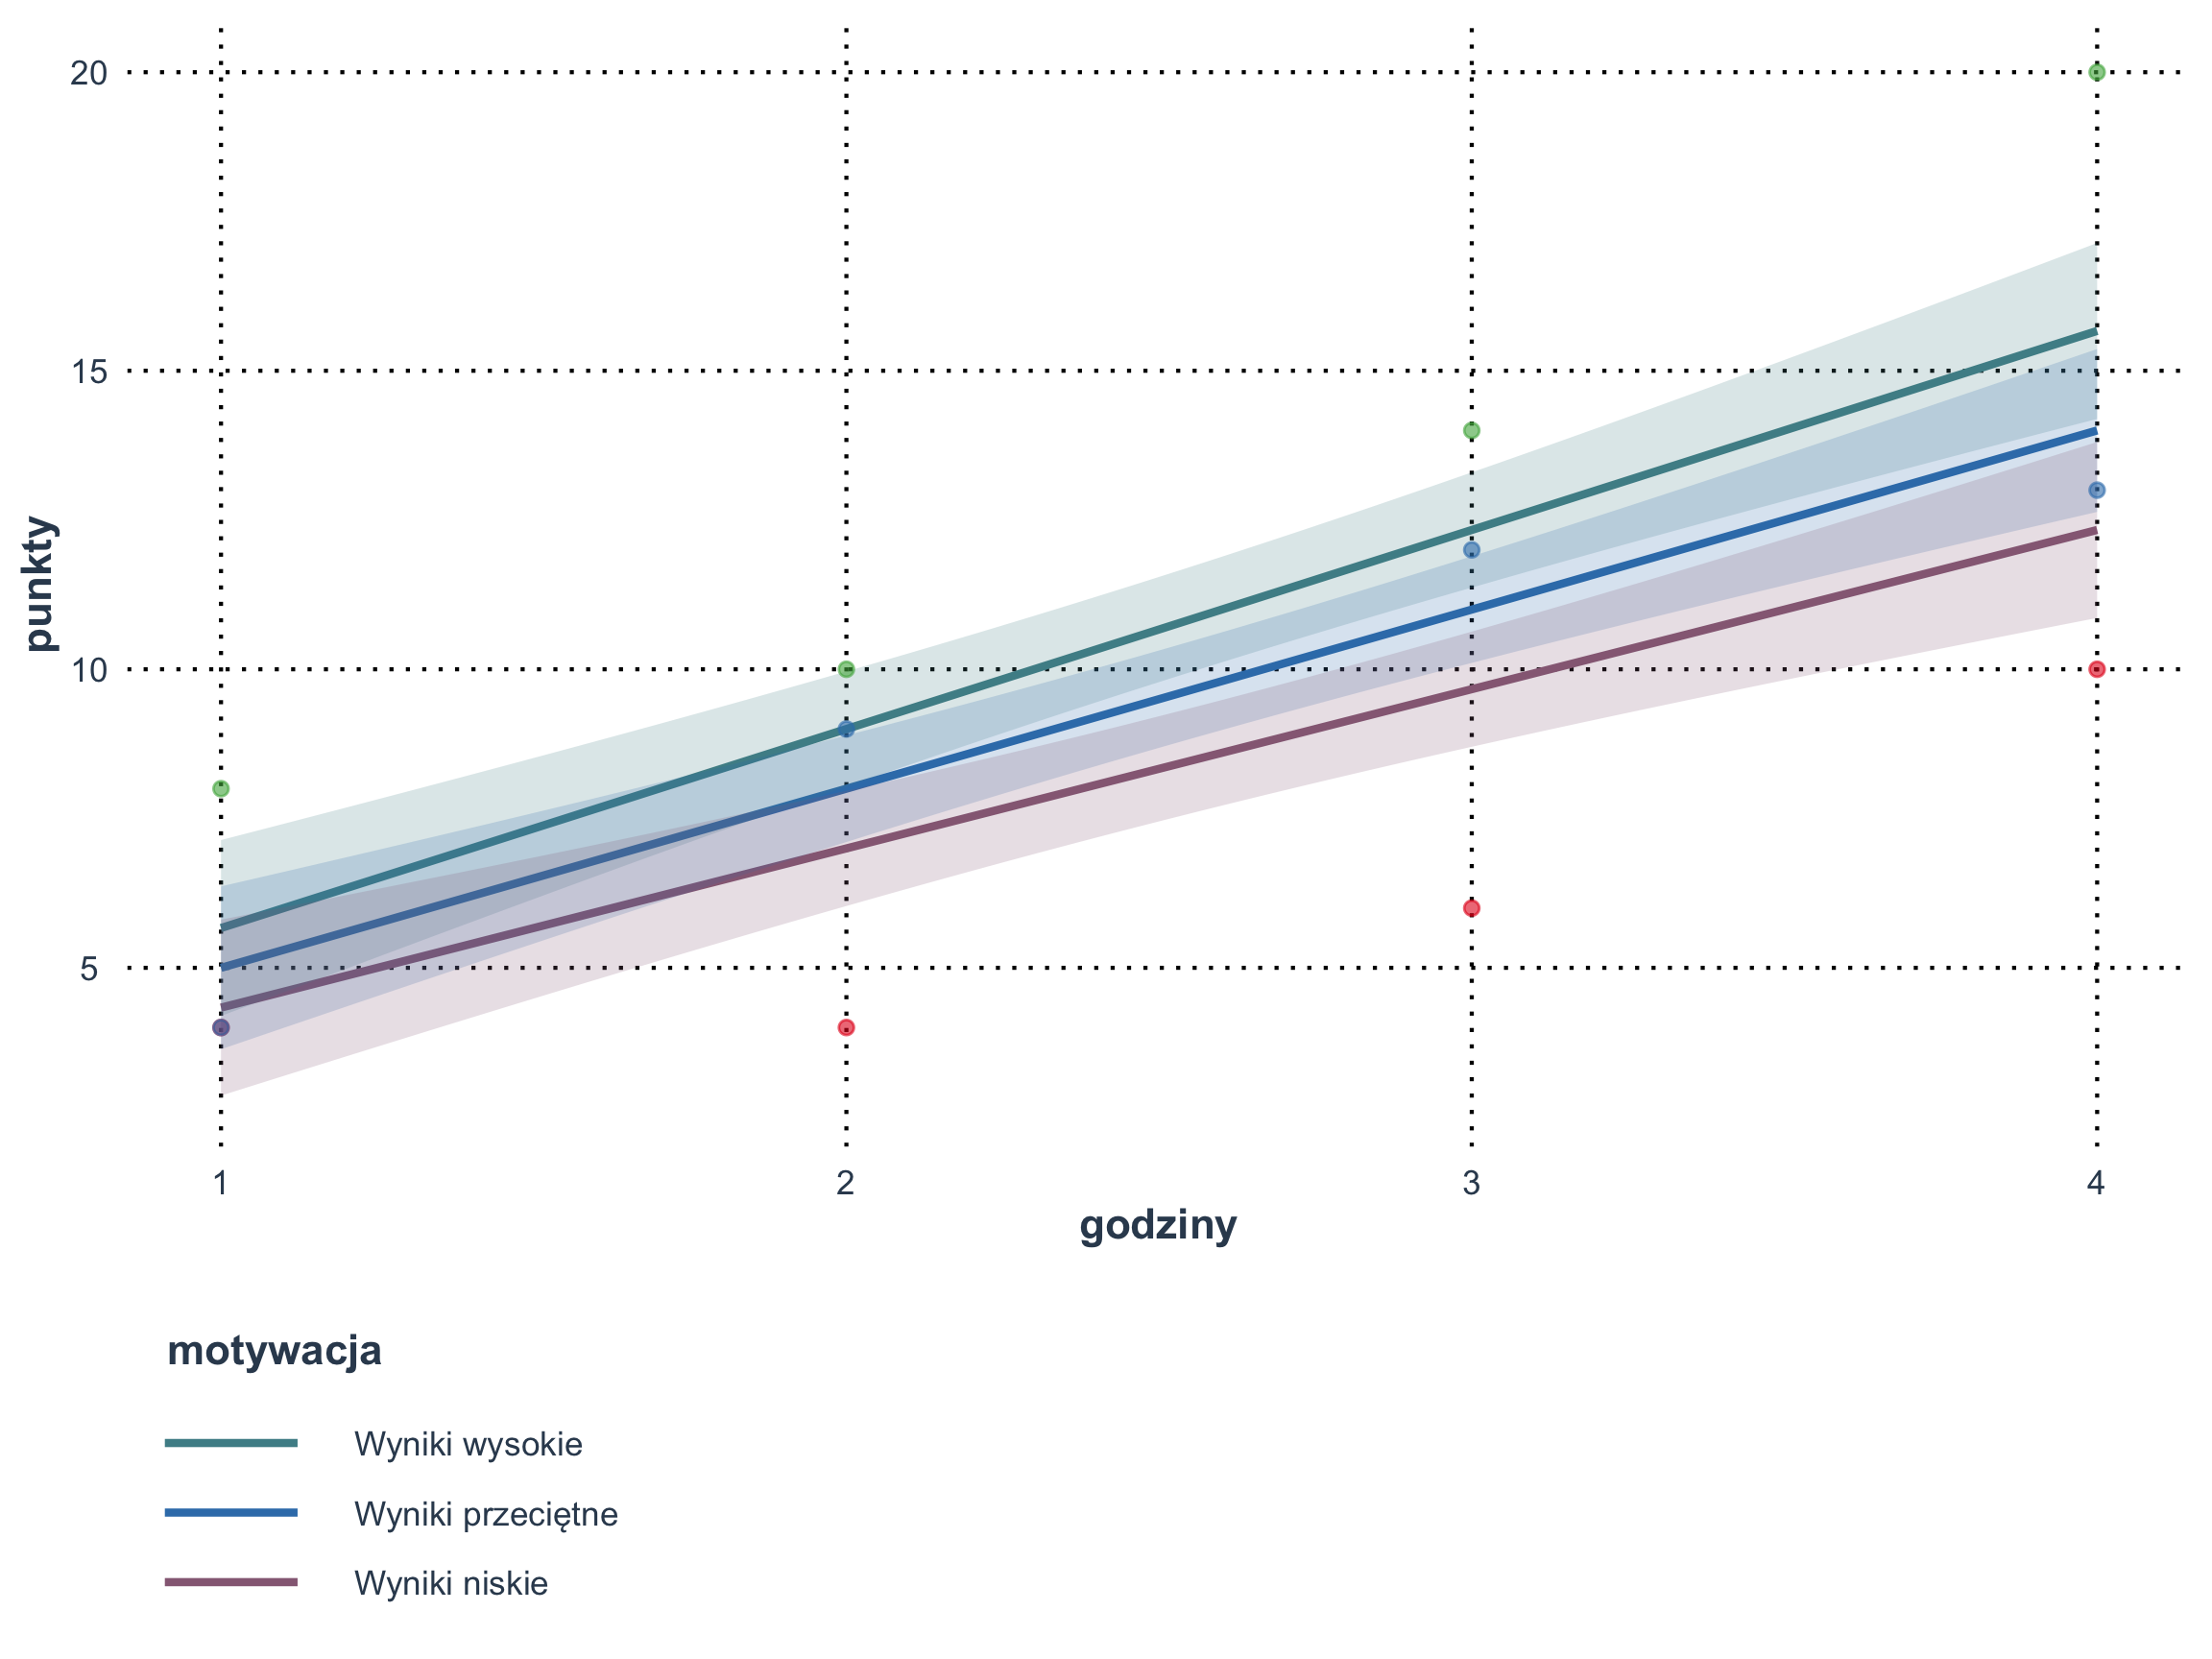
Najpierw opisz interakcję (b3 i jej p), potem proste nachylenia przy kilku poziomach moderatora. Najczęściej wybiera się niski i wysoki poziom jako średnią ± 1 odchylenie standardowe (Aiken i West, 1991). Tutaj SD motywacji wynosi 0,85, więc to m = 1,15 i m = 2,85, a nachylenia 2,15 i 3,85. Przy skali tylko z trzema wartościami prościej podać nachylenia dla 1, 2 i 3. Współczynników b1 i b2 nie nazywaj „efektami głównymi”. W modelu z interakcją są to efekty warunkowe: b1 przy m = 0, b2 przy x = 0. Jeśli chcesz, by miały sens, wycentruj zmienne – wtedy oznaczają efekt przy średniej drugiej zmiennej.
Zapis w stylu APA: Motywacja moderowała związek między liczbą godzin nauki a liczbą punktów, b = 1,00; SE = 0,39; t(8) = 2,58; p = 0,033; ΔR² = 0,04. Każda godzina nauki dawała 2,00 punktu przy niskiej motywacji (p = 0,004) i 4,00 punktu przy wysokiej (p < 0,001).
Jak policzyć interakcję w R?
godziny   <- rep(1:4, times = 3)
motywacja <- rep(1:3, each = 4)
punkty    <- c(4, 4, 6, 10,  4, 9, 12, 13,  8, 10, 14, 20)

# model z interakcją: punkty = b0 + b1*godziny + b2*motywacja + b3*godziny*motywacja
model <- lm(punkty ~ godziny * motywacja)
round(coef(summary(model)), 3)

# 1) „ręcznie”: proste nachylenia b1 + b3*m i ich błędy standardowe
b <- coef(model); V <- vcov(model)
m <- c(1, 2, 3)
nachylenie <- b[2] + b[4] * m
SE <- sqrt(V[2, 2] + m^2 * V[4, 4] + 2 * m * V[2, 4])
t  <- nachylenie / SE
round(cbind(m, nachylenie, SE, t, p = 2 * pt(-abs(t), df = 8)), 3)

# 2) centrowanie: te same dane, „efekty główne” przy średnich
gc <- godziny - mean(godziny); mc <- motywacja - mean(motywacja)
round(coef(lm(punkty ~ gc * mc)), 2)

# 3) gotowa funkcja: proste nachylenia z pakietu emmeans
suppressPackageStartupMessages(library(emmeans))
emtrends(model, ~ motywacja, var = "godziny", at = list(motywacja = 1:3))
Wynik w konsoli R:
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)              0      2.291   0.000    1.000
godziny                  1      0.837   1.195    0.266
motywacja                1      1.061   0.943    0.373
godziny:motywacja        1      0.387   2.582    0.033
     m nachylenie    SE     t     p
[1,] 1          2 0.500 4.000 0.004
[2,] 2          3 0.316 9.487 0.000
[3,] 3          4 0.500 8.000 0.000
(Intercept)          gc          mc       gc:mc
        9.5         3.0         3.5         1.0
 motywacja godziny.trend    SE df lower.CL upper.CL
         1             2 0.500  8    0.847     3.15
         2             3 0.316  8    2.271     3.73
         3             4 0.500  8    2.847     5.15

Confidence level used: 0.95
Zapis godziny * motywacja w lm() dodaje oba predyktory i ich iloczyn. Funkcja emtrends() z pakietu emmeans liczy proste nachylenia razem z przedziałami ufności.
Czy trzeba centrować zmienne przed interakcją?
Centrowanie nie zmienia b3, jego p ani R² modelu – zmienia tylko znaczenie b0, b1 i b2. Po centrowaniu b1 = 3 to efekt godzin przy średniej motywacji, a przed centrowaniem b1 = 1 to efekt przy motywacji 0. Centrowanie zmniejsza też korelację iloczynu z predyktorami, przez co VIF spada, ale nie „naprawia” żadnego problemu z danymi. Centruj więc wtedy, gdy zero na skali nie ma sensu – a przy skalach 1–5 czy 1–3 prawie nigdy go nie ma.
Najczęstsze błędy
- Nazywanie b1 i b2 „efektami głównymi” w modelu z interakcją i pisanie „godziny nie mają wpływu”, bo b1 jest nieistotne.
- Opisanie samej istotności b3 bez prostych nachyleń – nie wiadomo wtedy, w którą stronę działa moderacja.
- Testowanie interakcji przez podział moderatora medianą na dwie grupy – tracisz informację i moc.
- Liczenie nachyleń dla wartości moderatora spoza danych (np. m = 0 przy skali 1–3).
- Mylenie moderacji (kiedy działa X?) z mediacją (przez co działa X?).
Bibliografia
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). Guilford Press.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówEfekt pośredni i test Sobela
- Słownik wzorówDwuczynnikowa ANOVA
- Słownik wzorówWspółczynnik determinacji R²
- Słownik wzorówRegresja hierarchiczna i ΔR²
- PoradnikRegresja liniowa – przykład
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.