

Test Kołmogorowa-Smirnowa z poprawką Lillieforsa – wzór i przykład
Test Kołmogorowa-Smirnowa (K-S) z poprawką Lillieforsa sprawdza, czy wyniki odbiegają od rozkładu normalnego. Typowe pytanie z pracy dyplomowej: czy mogę użyć testu t, skoro program wypisał „Kołmogorow-Smirnow, p = 0,175”?
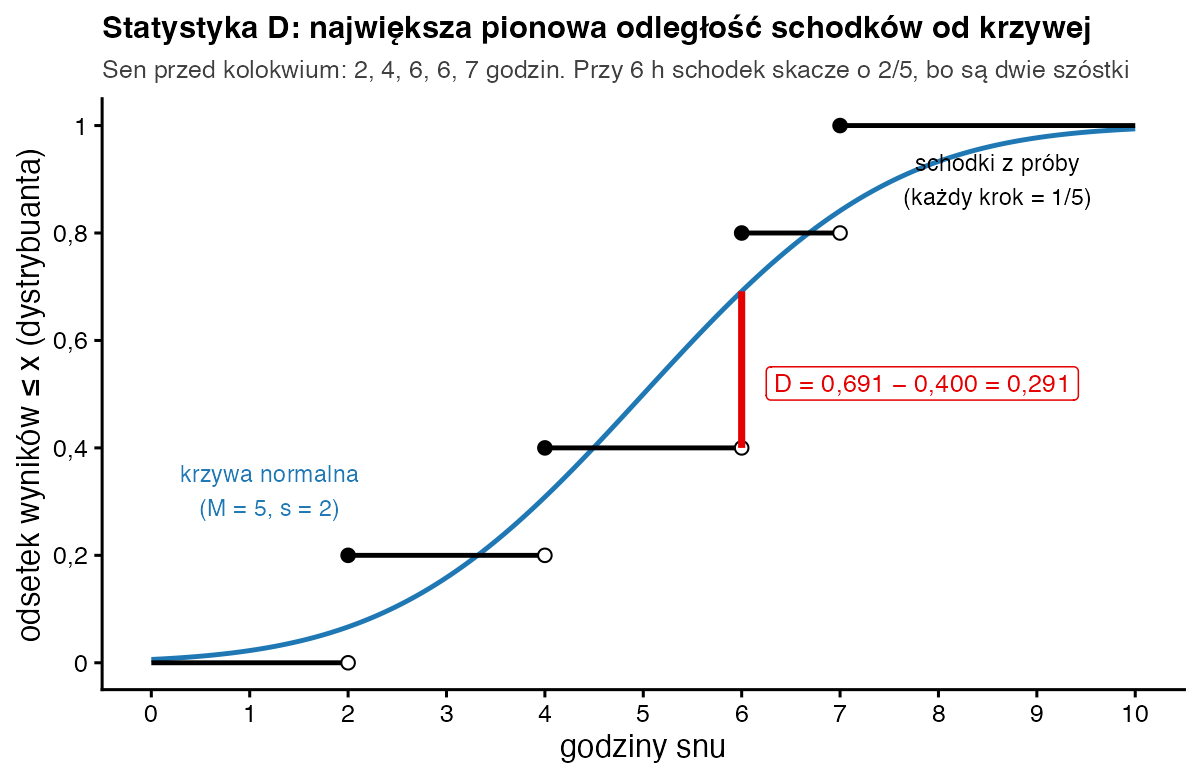
W prostych słowachUstawiasz wyniki od najmniejszego do największego i rysujesz „schodki”: przy każdym wyniku linia podskakuje o jedną część próby. Obok rysujesz gładką krzywą, jaką dałby idealny rozkład normalny o tej samej średniej i odchyleniu. Test mierzy, gdzie schodki najbardziej odstają od krzywej. Im większa ta największa odległość, tym mniej wyniki przypominają rozkład normalny.
Kiedy stosować test Kołmogorowa-Smirnowa (Lilliefors)?
- chcesz sprawdzić założenie normalności przed testem parametrycznym, np. testem t albo ANOVA;
- średnią i odchylenie standardowe liczysz z tych samych danych – wtedy potrzebna jest poprawka Lillieforsa;
- Twój program (np. SPSS w opcji „Eksploracja”) wypisuje K-S z poprawką Lillieforsa obok testu Shapiro-Wilka i musisz zrozumieć, co oznaczają oba wyniki.
Przy małych i średnich próbach lepszy jest zwykle test Shapiro-Wilka, bo ma większą moc. Zawsze patrz też na wykres i na skośność oraz kurtozę. Czym jest sama krzywa, której używamy jako wzorca, wyjaśnia hasło o rozkładzie normalnym.
Wzór na statystykę D
- \(F_n(x)\)
- dystrybuanta z próby („schodki”): jaka część wyników jest mniejsza lub równa \(x\); przy każdym wyniku rośnie o \(1/n\)
- \(\Phi(\cdot)\)
- dystrybuanta standardowego rozkładu normalnego: gładka krzywa w kształcie litery S, odczytywana z tablic albo w R funkcją
pnorm() - \(\bar{x},\ s\)
- średnia i odchylenie standardowe policzone z próby
- \(\tfrac{x - \bar{x}}{s}\)
- wynik standaryzowany z: o ile odchyleń standardowych wynik leży od średniej
- \(\max_x\)
- największa wartość spośród wszystkich sprawdzanych miejsc; sprawdzasz odległość tuż przed i tuż po każdym schodku
- \(D\)
- statystyka testu: od 0 (idealna zgodność) do 1
Jak przeczytać ten wzór na głos: „D to największa pionowa odległość między schodkami dystrybuanty z próby a krzywą dystrybuanty normalnej o tej samej średniej i odchyleniu”. Wzór jest ten sam w klasycznym teście K-S i w wersji Lillieforsa. Różni się tylko tablica wartości krytycznych.
Przykład krok po kroku
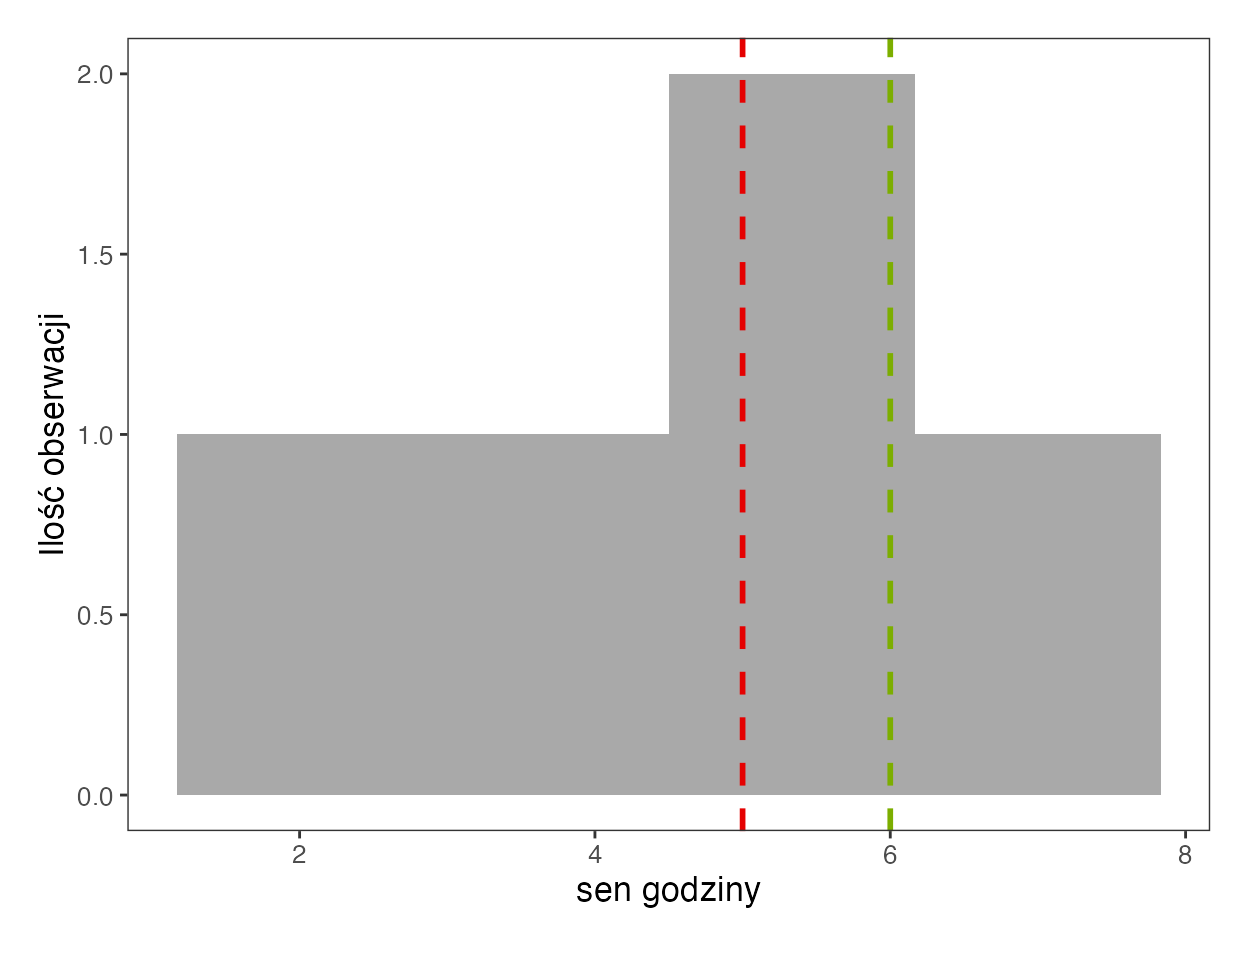
Pięciu studentów podało, ile godzin spali przed kolokwium: 6, 2, 7, 4, 6. Średnia to 5 godzin, a odchylenie standardowe 2 godziny (te same dane, co w hasłach o odchyleniu standardowym i o teście Shapiro-Wilka). Po uporządkowaniu: 2, 4, 6, 6, 7. Dwie osoby spały po 6 godzin, więc w tym miejscu schodek jest podwójny.
| x | z = (x − 5) / 2 | Φ(z) | Fn tuż przed x | Fn w x | Fn w x − Φ(z) | Φ(z) − Fn przed x |
|---|---|---|---|---|---|---|
| 2 | (2 − 5) / 2 = −1,5 | 0,067 | 0 / 5 = 0,0 | 1 / 5 = 0,2 | 0,2 − 0,067 = 0,133 | 0,067 − 0 = 0,067 |
| 4 | (4 − 5) / 2 = −0,5 | 0,309 | 0,2 | 2 / 5 = 0,4 | 0,4 − 0,309 = 0,091 | 0,309 − 0,2 = 0,109 |
| 6 (×2) | (6 − 5) / 2 = 0,5 | 0,691 | 0,4 | 4 / 5 = 0,8 | 0,8 − 0,691 = 0,109 | 0,691 − 0,4 = 0,291 |
| 7 | (7 − 5) / 2 = 1,0 | 0,841 | 0,8 | 5 / 5 = 1,0 | 1,0 − 0,841 = 0,159 | 0,841 − 0,8 = 0,041 |
| Największa odległość (D) | 0,159 | 0,291 | ||||
- Standaryzacja. Od każdej wartości odejmujesz średnią i dzielisz przez odchylenie, np. (2 − 5) / 2 = −3 / 2 = −1,5.
- Krzywa normalna. Z tablic rozkładu normalnego odczytujesz Φ(−1,5) = 0,067, Φ(−0,5) = 0,309, Φ(0,5) = 0,691, Φ(1) = 0,841 (w R:
pnorm(-1.5)itd.). Tyle wyników leżałoby poniżej x w idealnym rozkładzie normalnym. - Schodki z próby. Każdy wynik to 1/5 = 0,2. Przy x = 2 schodek idzie z 0 do 0,2, przy x = 4 – z 0,2 do 0,4, przy x = 6 – od razu z 0,4 do 0,8 (dwie osoby), przy x = 7 – z 0,8 do 1,0.
- Odległości. W każdym wierszu liczysz dwie różnice: schodek „po” minus krzywa i krzywa minus schodek „przed”. Musisz sprawdzić obie, bo największa odległość może wypaść tuż przed skokiem.
- Statystyka D. Największa z ośmiu różnic to 0,691 − 0,4 = 0,291, tuż przed wartością 6. Zatem D = 0,291.
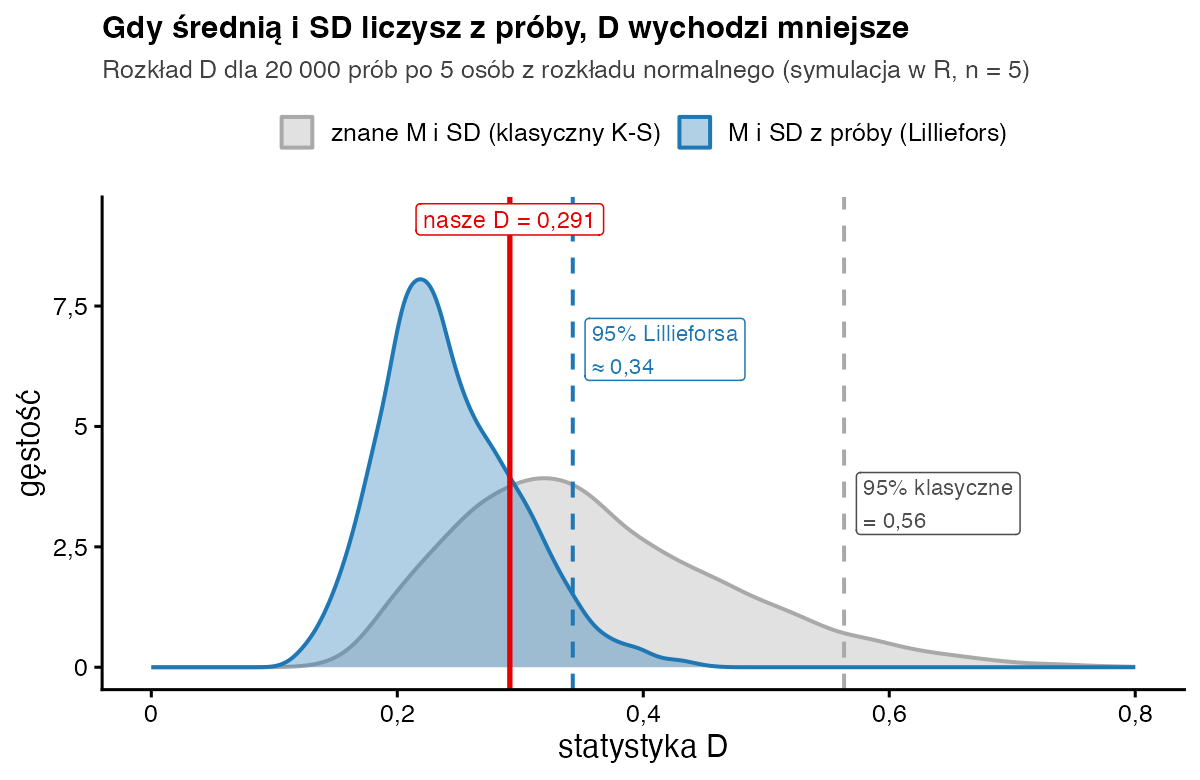
- Wartość krytyczna. W tablicach Lillieforsa dla n = 5 i α = 0,05 wartość krytyczna wynosi około 0,34. 0,291 < 0,34, więc brak podstaw do odrzucenia hipotezy o normalności. R podaje p = 0,175.
Jak zinterpretować i opisać wynik?
Wynik nieistotny oznacza, że nie wykryto odstępstwa od rozkładu normalnego. Nie dowodzi, że rozkład jest normalny. Przy pięciu osobach test wykryłby tylko bardzo duże odstępstwa. Przy kilkuset osobach jest odwrotnie: nawet drobne, nieważne w praktyce odchylenie da p < 0,05. Dlatego wynik testu zawsze zestaw z wykresem. W metodach t i ANOVA normalność dotyczy rozkładu w każdej grupie albo reszt modelu, a nie całej zmiennej naraz.
Zapis w stylu APA: Rozkład czasu snu przed kolokwium nie odbiegał istotnie od rozkładu normalnego, D(5) = 0,29; p = 0,175 (test Kołmogorowa-Smirnowa z poprawką Lillieforsa).
Jak policzyć test Kołmogorowa-Smirnowa (Lilliefors) w R?
# Sen przed kolokwium (godziny), 5 studentów
x <- c(6, 2, 7, 4, 6)

# 1) „ręcznie”: dystrybuanta z próby vs dystrybuanta normalna
wart  <- sort(unique(x))                       # 2, 4, 6, 7
z     <- (wart - mean(x)) / sd(x)              # średnia 5, odchylenie 2
F_norm <- pnorm(z)                             # gładka krzywa
Fn_po  <- ecdf(x)(wart)                        # schodek po danej wartości
Fn_przed <- c(0, head(Fn_po, -1))              # schodek tuż przed nią
round(data.frame(wart, z, F_norm, Fn_przed, Fn_po,
                 D_plus = Fn_po - F_norm, D_minus = F_norm - Fn_przed), 3)
max(Fn_po - F_norm, F_norm - Fn_przed)         # D = 0,291

# 2) gotowa funkcja: test Lillieforsa
nortest::lillie.test(x)

# 3) dla porównania: klasyczny K-S (zły p, bo średnią i sd wzięliśmy z próby)
suppressWarnings(ks.test(x, "pnorm", mean(x), sd(x)))$p.value
shapiro.test(x)$p.value
Wynik w konsoli R:
  wart    z F_norm Fn_przed Fn_po D_plus D_minus
1    2 -1.5  0.067      0.0   0.2  0.133   0.067
2    4 -0.5  0.309      0.2   0.4  0.091   0.109
3    6  0.5  0.691      0.4   0.8  0.109   0.291
4    7  1.0  0.841      0.8   1.0  0.159   0.041
[1] 0.2914625

	Lilliefors (Kolmogorov-Smirnov) normality test

data:  x
D = 0.29146, p-value = 0.1749

[1] 0.7893289
[1] 0.4399399
Ręcznie i funkcją nortest::lillie.test dostajesz to samo D = 0,291. Zwykła funkcja ks.test z parametrami wziętymi z próby podaje p = 0,789. To przykład błędu, przed którym chroni poprawka Lillieforsa: p jest wtedy zawyżone. Test Shapiro-Wilka daje p = 0,440.
Kołmogorow-Smirnow czy Shapiro-Wilk?
W badaniach symulacyjnych test Shapiro-Wilka częściej wykrywa prawdziwe odstępstwa od normalności niż K-S z poprawką Lillieforsa, zwłaszcza w małych próbach (Razali i Wah, 2011). Jeśli program podaje oba wyniki i się różnią, opieraj się raczej na Shapiro-Wilku i na wykresie. Klasyczny test K-S bez poprawki ma sens tylko wtedy, gdy średnią i odchylenie znasz z zewnątrz, np. z norm testu psychologicznego. Pamiętaj też, że przy dużych próbach testy parametryczne są odporne na umiarkowane odstępstwa od normalności.
Najczęstsze błędy
- Użycie klasycznego
ks.testze średnią i odchyleniem z próby – p wychodzi za duże. - Pisanie „rozkład jest normalny”, gdy p > 0,05 – poprawnie: nie wykryto istotnego odstępstwa od normalności.
- Sprawdzanie normalności całej zmiennej zamiast rozkładów w grupach albo reszt modelu.
- Odrzucanie testu t tylko dlatego, że przy bardzo dużej próbie test normalności dał p < 0,05.
- Liczenie odległości tylko w punktach „po” schodku i przeoczenie największej różnicy tuż przed skokiem.
Bibliografia
- Kolmogorov, A. N. (1933). Sulla determinazione empirica di una legge di distribuzione. Giornale dell’Istituto Italiano degli Attuari, 4, 83–91.
- Smirnov, N. (1948). Table for estimating the goodness of fit of empirical distributions. The Annals of Mathematical Statistics, 19(2), 279–281.
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Shapiro-Wilka
- Słownik wzorówRozkład normalny
- Słownik wzorówSkośność
- Słownik wzorówKurtoza
- Słownik wzorówWykres Q-Q
- PoradnikTesty parametryczne
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.