

Wykres Q-Q – jak powstaje i jak go czytać
Wykres Q-Q (kwantyl-kwantyl) porównuje Twoje wyniki, ułożone od najmniejszego do największego, z wynikami, jakich należałoby się spodziewać, gdyby rozkład był idealnie normalny. Typowe pytanie z pracy dyplomowej: czy rozkład punktów z kolokwium jest na tyle zbliżony do normalnego, że mogę użyć testu t albo ANOVA?
W prostych słowachUstawiasz wyniki w kolejce od najmniejszego do największego. Dla każdego miejsca w kolejce sprawdzasz, jaki wynik „powinien” tam stać, gdyby dane pochodziły z rozkładu normalnego. Potem rysujesz pary: wynik prawdziwy i wynik oczekiwany. Jeśli kropki układają się wzdłuż prostej, rozkład jest zbliżony do normalnego. Jeśli tworzą łuk albo „uciekają” na końcach – coś jest nie tak, a kształt podpowiada co.
Kiedy używać wykresu Q-Q?
- chcesz ocenić normalność rozkładu przed testem t, ANOVA albo korelacją Pearsona – osobno w każdej grupie;
- sprawdzasz reszty modelu regresji: to reszty, a nie same zmienne, mają mieć rozkład zbliżony do normalnego;
- masz dużą próbę, w której test Shapiro-Wilka „wyłapuje” nawet drobne odchylenia, i chcesz zobaczyć, czy są one naprawdę duże;
- chcesz wiedzieć, jaki jest problem: skośność, grube ogony, pojedyncze wartości odstające.
Wykres to ocena wzrokowa, nie test. Najlepiej łączyć go z liczbami: testem Shapiro-Wilka albo testem Kołmogorowa-Smirnowa z poprawką Lillieforsa, skośnością i kurtozą. Cały proces opisujemy we wpisie jak sprawdzić normalność rozkładu.
Wzór na punkty wykresu Q-Q
- \(x_{(i)}\)
- i-ty wynik po ułożeniu od najmniejszego do największego (nawias przy i oznacza „po sortowaniu”)
- \(i\)
- numer miejsca w tej kolejce: 1 dla najmniejszego, n dla największego
- \(n\)
- liczba obserwacji
- \(p_i\)
- jaka część rozkładu „leży poniżej” i-tego wyniku; odejmujemy 0,5, żeby nie dostać 0 ani 1
- \(\Phi^{-1}\)
- odwrotność dystrybuanty rozkładu normalnego: zamienia ułamek p na wynik z (w R:
qnorm(p)) - \(z_i\)
- kwantyl teoretyczny – wynik standaryzowany z, który zajmowałby i-te miejsce w idealnym rozkładzie normalnym
- \(\bar{x},\ s\)
- średnia i odchylenie standardowe z próby; zamieniają z na jednostki Twoich danych
Na głos: „i-ty najmniejszy wynik zestawiamy z kwantylem rozkładu normalnego dla ułamka i minus pół, podzielone przez n”.
Przykład krok po kroku
Pięcioro studentów podało, ile godzin spało przed kolokwium: 6, 2, 7, 4, 6. Średnia wynosi 5 godzin, a odchylenie standardowe 2 godziny.
| i | Wynik x(i) | p = (i − 0,5) / 5 | z = qnorm(p) | Oczekiwany 5 + 2 · z | Różnica x − oczekiwany |
|---|---|---|---|---|---|
| 1 | 2 | 0,5 / 5 = 0,1 | −1,282 | 5 − 2,564 = 2,44 | 2 − 2,44 = −0,44 |
| 2 | 4 | 1,5 / 5 = 0,3 | −0,524 | 5 − 1,049 = 3,95 | 4 − 3,95 = 0,05 |
| 3 | 6 | 2,5 / 5 = 0,5 | 0,000 | 5 + 0 = 5,00 | 6 − 5,00 = 1,00 |
| 4 | 6 | 3,5 / 5 = 0,7 | 0,524 | 5 + 1,049 = 6,05 | 6 − 6,05 = −0,05 |
| 5 | 7 | 4,5 / 5 = 0,9 | 1,282 | 5 + 2,564 = 7,56 | 7 − 7,56 = −0,56 |
| Σ | 25 | 2,5 | 0 | 25,00 | 0,00 |
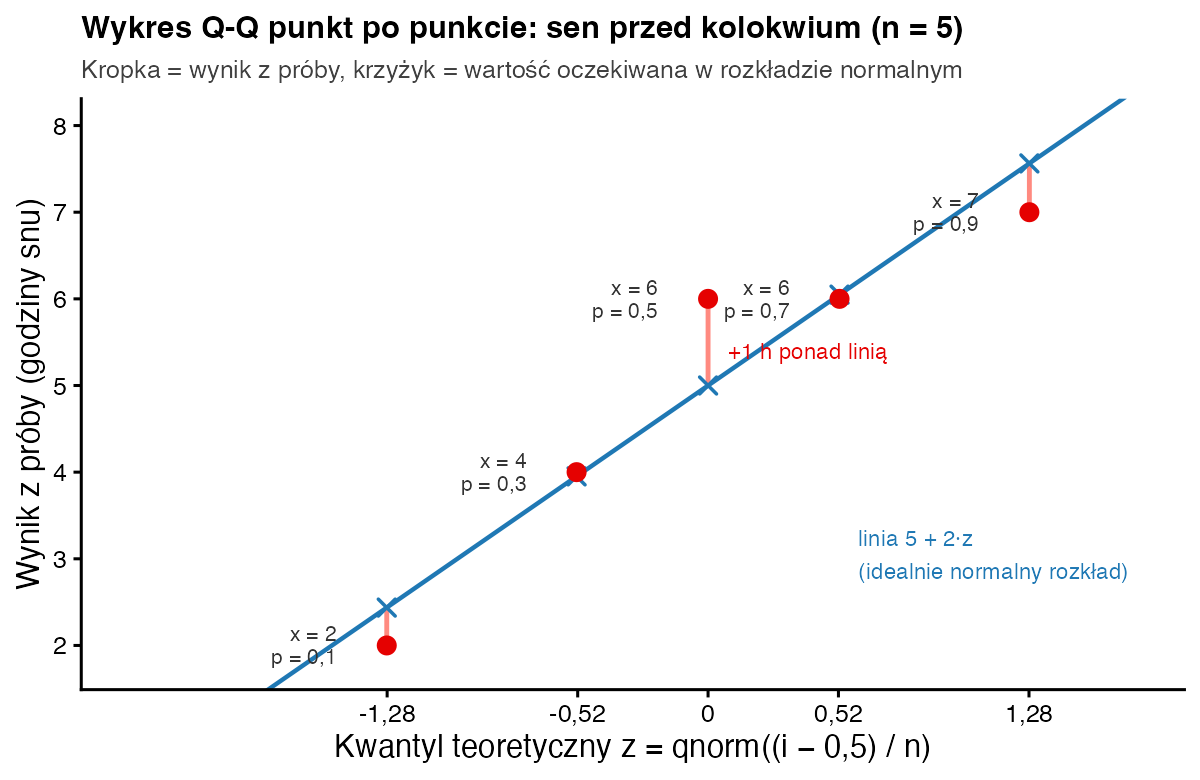
- Sortujesz wyniki. 6, 2, 7, 4, 6 → 2, 4, 6, 6, 7. To są kwantyle z próby – oś pionowa wykresu.
- Liczysz ułamki p. Dla i = 1: (1 − 0,5) / 5 = 0,1. Dla i = 2: 1,5 / 5 = 0,3. Dalej 0,5; 0,7 i 0,9. Najmniejszy wynik „odcina” więc dolne 10% rozkładu, a największy – górne 10%.
- Zamieniasz p na z. Szukasz w tablicy rozkładu normalnego takiego z, dla którego pole na lewo wynosi 0,1. W tablicy dla z = 1,28 pole wynosi 0,8997, czyli prawie 0,9 – z symetrii dla 0,1 dostajesz z ≈ −1,28 (dokładnie −1,282; w R:
qnorm(0.1)). Dla 0,3: z = −0,524 (qnorm(0.3)). Dla 0,5: z = 0. Wartości dla 0,7 i 0,9 to te same liczby ze znakiem plus. To oś pozioma. - Liczysz wyniki oczekiwane. Mnożysz z przez odchylenie i dodajesz średnią. Dla i = 1: 2 · (−1,282) = −2,564; 5 − 2,564 = 2,44 godziny. Dla i = 3: 5 + 2 · 0 = 5 godzin. Tyle godzin spałby student na danym miejscu w kolejce, gdyby rozkład był idealnie normalny.
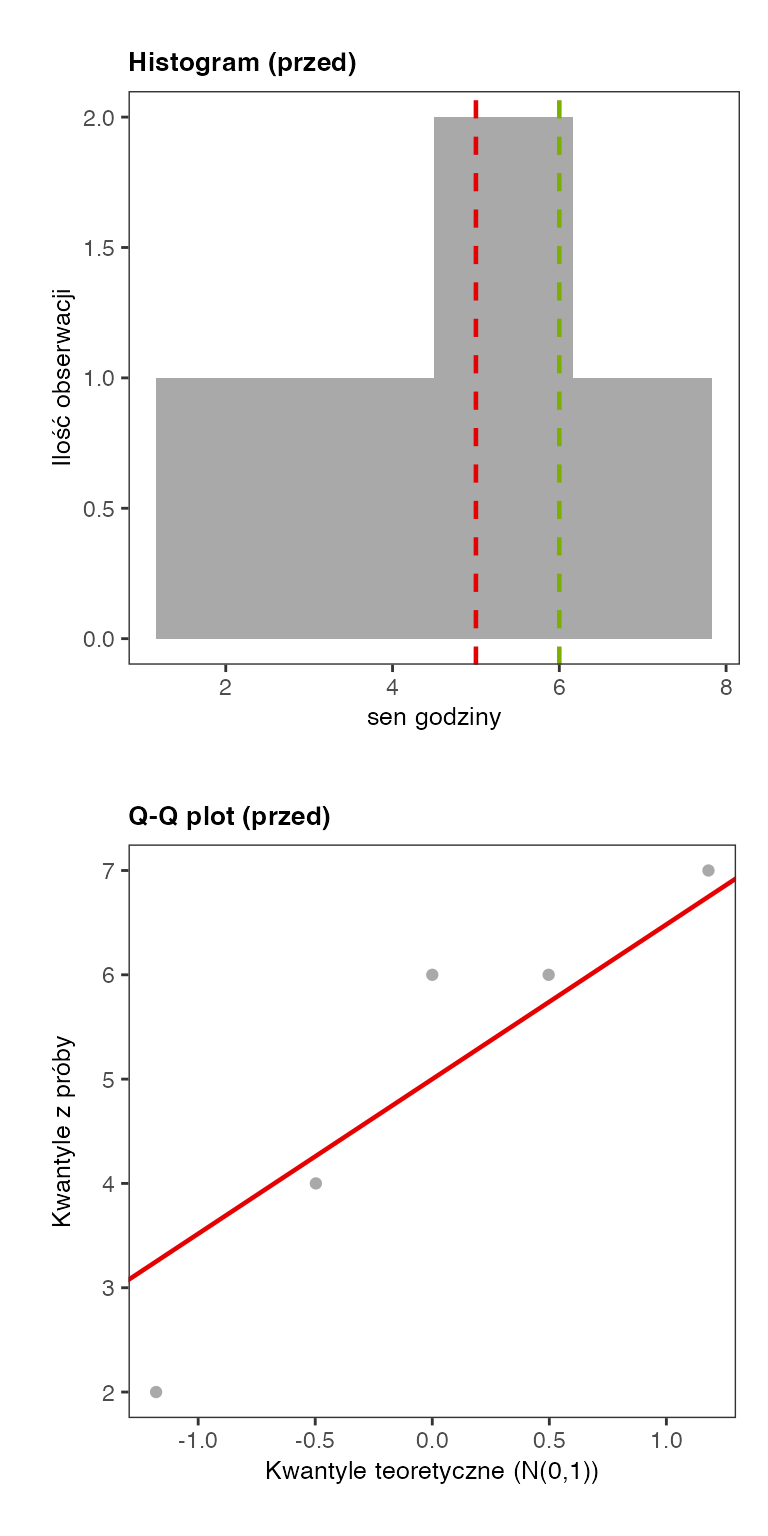
- Porównujesz. Różnice to −0,44; 0,05; 1,00; −0,05 i −0,56. Środkowy student spał o godzinę dłużej, niż „przewiduje” rozkład normalny, a skrajni – nieco krócej. Kropki układają się w łagodny łuk wygięty do góry, czyli lekka skośność lewostronna: mediana (6) jest większa od średniej (5).
- Oceniasz całość. Korelacja między kolumną x a kolumną z wynosi 0,952 – im bliżej 1, tym ciaśniej kropki leżą przy prostej. Przy pięciu osobach takie odchylenia są zupełnie typowe; test Shapiro-Wilka daje tu W = 0,905; p = 0,440.
Jak zinterpretować i opisać wynik?
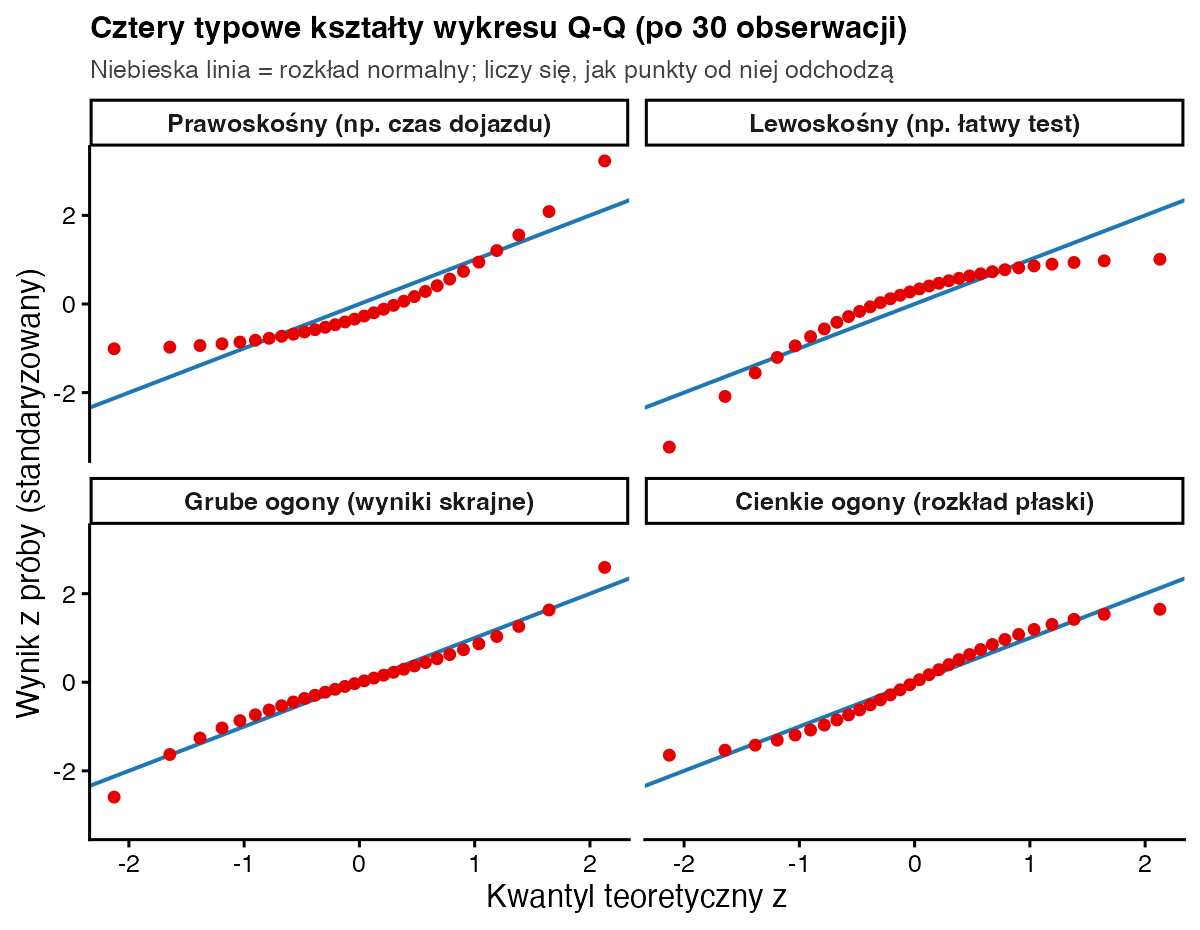
Patrz najpierw na środek, potem na końce. Kilka kropek lekko „falujących” wokół linii to normalna losowość, szczególnie przy małej próbie. Niepokoi systematyczny łuk (skośność) albo końce uciekające od linii (grube ogony, wartości odstające). Pojedynczy punkt daleko od reszty to kandydat na obserwację odstającą. W pracy opisz krótko, co widać, i dołącz wynik testu normalności.
Zapis w stylu APA: Ocena wzrokowa wykresu kwantyl-kwantyl wskazała na lekką skośność lewostronną czasu snu (punkty środkowe powyżej linii odniesienia, skrajne – poniżej), jednak odchylenia były niewielkie, a test Shapiro-Wilka nie wykazał istotnego odstępstwa od rozkładu normalnego, W = 0,905; p = 0,440.
Jak narysować wykres Q-Q w R?
sen <- c(6, 2, 7, 4, 6)                  # godziny snu przed kolokwium

# 1) „ręcznie”: punkty wykresu Q-Q według wzoru
n <- length(sen); i <- 1:n
x <- sort(sen)                           # kwantyle z próby (wyniki od najmniejszego)
p <- (i - 0.5) / n                       # ułamek wyników poniżej punktu
z <- qnorm(p)                            # kwantyle teoretyczne N(0, 1)
oczek <- mean(sen) + sd(sen) * z         # wynik oczekiwany przy normalności
data.frame(i, x, p, z = round(z, 3), oczek = round(oczek, 2), roznica = round(x - oczek, 2))

# 2) gotowe funkcje: te same wyniki z próby, nieco inne z (dla n <= 10 R używa (i - 3/8) / (n + 1/4))
q <- qqnorm(sen, plot.it = FALSE)
all.equal(sort(q$y), x)
round(sort(q$x), 3)
qqnorm(sen); qqline(sen, col = "red")    # wykres z linią przez 1. i 3. kwartyl
round(cor(x, z), 3)                      # im bliżej 1, tym bliżej linii
Wynik w konsoli R:
  i x   p      z oczek roznica
1 1 2 0.1 -1.282  2.44   -0.44
2 2 4 0.3 -0.524  3.95    0.05
3 3 6 0.5  0.000  5.00    1.00
4 4 6 0.7  0.524  6.05   -0.05
5 5 7 0.9  1.282  7.56   -0.56
[1] TRUE
[1] -1.180 -0.497  0.000  0.497  1.180
[1] 0.952
Wyniki z próby z funkcji qqnorm() są identyczne z naszymi. Kwantyle teoretyczne różnią się nieznacznie, bo dla n ≤ 10 R używa wzoru (i − 3/8) / (n + 1/4). Kształt wykresu i wnioski są te same. Linia z qqline() przechodzi przez pierwszy i trzeci kwartyl, a nie przez średnią i odchylenie – dlatego jest mniej stroma niż nasza linia 5 + 2 · z.
Wykres Q-Q czy test normalności – czemu ufać?
Przy małej próbie (kilkanaście osób) test normalności ma małą moc i często „nie widzi” wyraźnej skośności, a wykres Q-Q przy tak małej liczbie punktów trudno czytać. Przy dużej próbie (kilkaset osób) jest odwrotnie: test odrzuca normalność z powodu drobnych odchyleń, które nie szkodzą testowi t ani ANOVA, a wykres pokazuje, że kropki leżą prawie idealnie na linii. Dlatego przy dużych próbach rozstrzygający jest zwykle wykres, a przy małych – oba źródła razem. Gdy normalność naprawdę nie jest spełniona, zajrzyj do wpisu brak normalności – co robić.
Najczęstsze błędy
- Rysowanie jednego wykresu Q-Q dla wszystkich osób razem, gdy porównujesz grupy. Normalność ocenia się w każdej grupie osobno albo na resztach modelu.
- Mylenie wykresu Q-Q z wykresem rozrzutu dwóch zmiennych. Na osi poziomej są tu kwantyle teoretyczne, nie druga zmienna.
- Panika z powodu jednej kropki przy pięciu obserwacjach. Przy małych próbach losowe „falowanie” jest duże.
- Ignorowanie końców wykresu. To właśnie ogony najczęściej zdradzają wartości odstające i grube ogony.
- Pisanie „rozkład jest normalny”. Poprawnie: „brak wyraźnych odstępstw od rozkładu normalnego”.
Bibliografia
- Wilk, M. B., & Gnanadesikan, R. (1968). Probability plotting methods for the analysis of data. Biometrika, 55(1), 1–17. https://doi.org/10.1093/biomet/55.1.1
- Blom, G. (1958). Statistical estimates and transformed beta-variables. Wiley.
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Shapiro-Wilka
- Słownik wzorówTest Kołmogorowa-Smirnowa (Lilliefors)
- Słownik wzorówRozkład normalny
- Słownik wzorówPercentyle i centyle
- PoradnikTesty parametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.