

W Kendalla (współczynnik zgodności) – wzór i przykład krok po kroku
W Kendalla to współczynnik zgodności od 0 do 1, który mówi, na ile kilka osób ustawia te same rzeczy w tej samej kolejności. Podaje się go jako wielkość efektu po teście Friedmana albo jako miarę zgodności sędziów. Typowe pytanie z pracy dyplomowej: czy u wszystkich badanych samoocena rosła w tym samym porządku – przed, po i miesiąc po warsztatach?
W prostych słowachKażda osoba ustawia pomiary (albo oceniane obiekty) od najniższego do najwyższego. Jeśli wszyscy mają ten sam porządek, sumy rang w kolumnach są maksymalnie „rozjechane” – jedna kolumna zbiera same jedynki, inna same trójki – i W = 1. Jeśli porządki są przypadkowe, sumy rang się wyrównują i W jest bliskie 0. W mówi więc, jak bardzo sumy rang różnią się od siebie w porównaniu z największą możliwą różnicą.
Kiedy stosować W Kendalla?
- jako wielkość efektu po teście Friedmana – te same osoby zbadano trzy lub więcej razy;
- jako miarę zgodności kilku oceniających, którzy układają te same obiekty w ranking (np. trzech promotorów porządkuje pięć prac);
- gdy dane są co najmniej porządkowe, a rozkład nie musi być normalny.
Sam test istotności opisuje hasło o teście Friedmana. Zgodność tylko dwóch rankingów mierzy tau Kendalla albo rho Spearmana. Przy dwóch pomiarach wielkość efektu opisuje r w testach nieparametrycznych. Gdy oceny są liczbami na skali ilościowej, a nie rankingiem, lepszy bywa współczynnik ICC.
Wzór na W Kendalla
- \(n\)
- liczba osób (wierszy) – badanych albo oceniających
- \(k\)
- liczba pomiarów albo ocenianych obiektów (kolumn)
- \(R_j\)
- suma rang w j-tej kolumnie; rangi od 1 do k nadajesz osobno w wierszu każdej osoby
- \(\bar{R}\)
- średnia suma rang, zawsze równa \(n(k+1)/2\)
- \(S\)
- suma kwadratów odchyleń sum rang od średniej – im większa, tym bardziej kolumny się różnią
- \(n^2(k^3 - k)/12\)
- największa możliwa wartość S, gdy wszyscy mają identyczny porządek
- \(\chi^2_F\)
- statystyka testu Friedmana dla tych samych danych
Jak przeczytać wzór na głos: „W to rozrzut sum rang podzielony przez największy rozrzut, jaki w ogóle mógłby się zdarzyć”.
Przykład krok po kroku
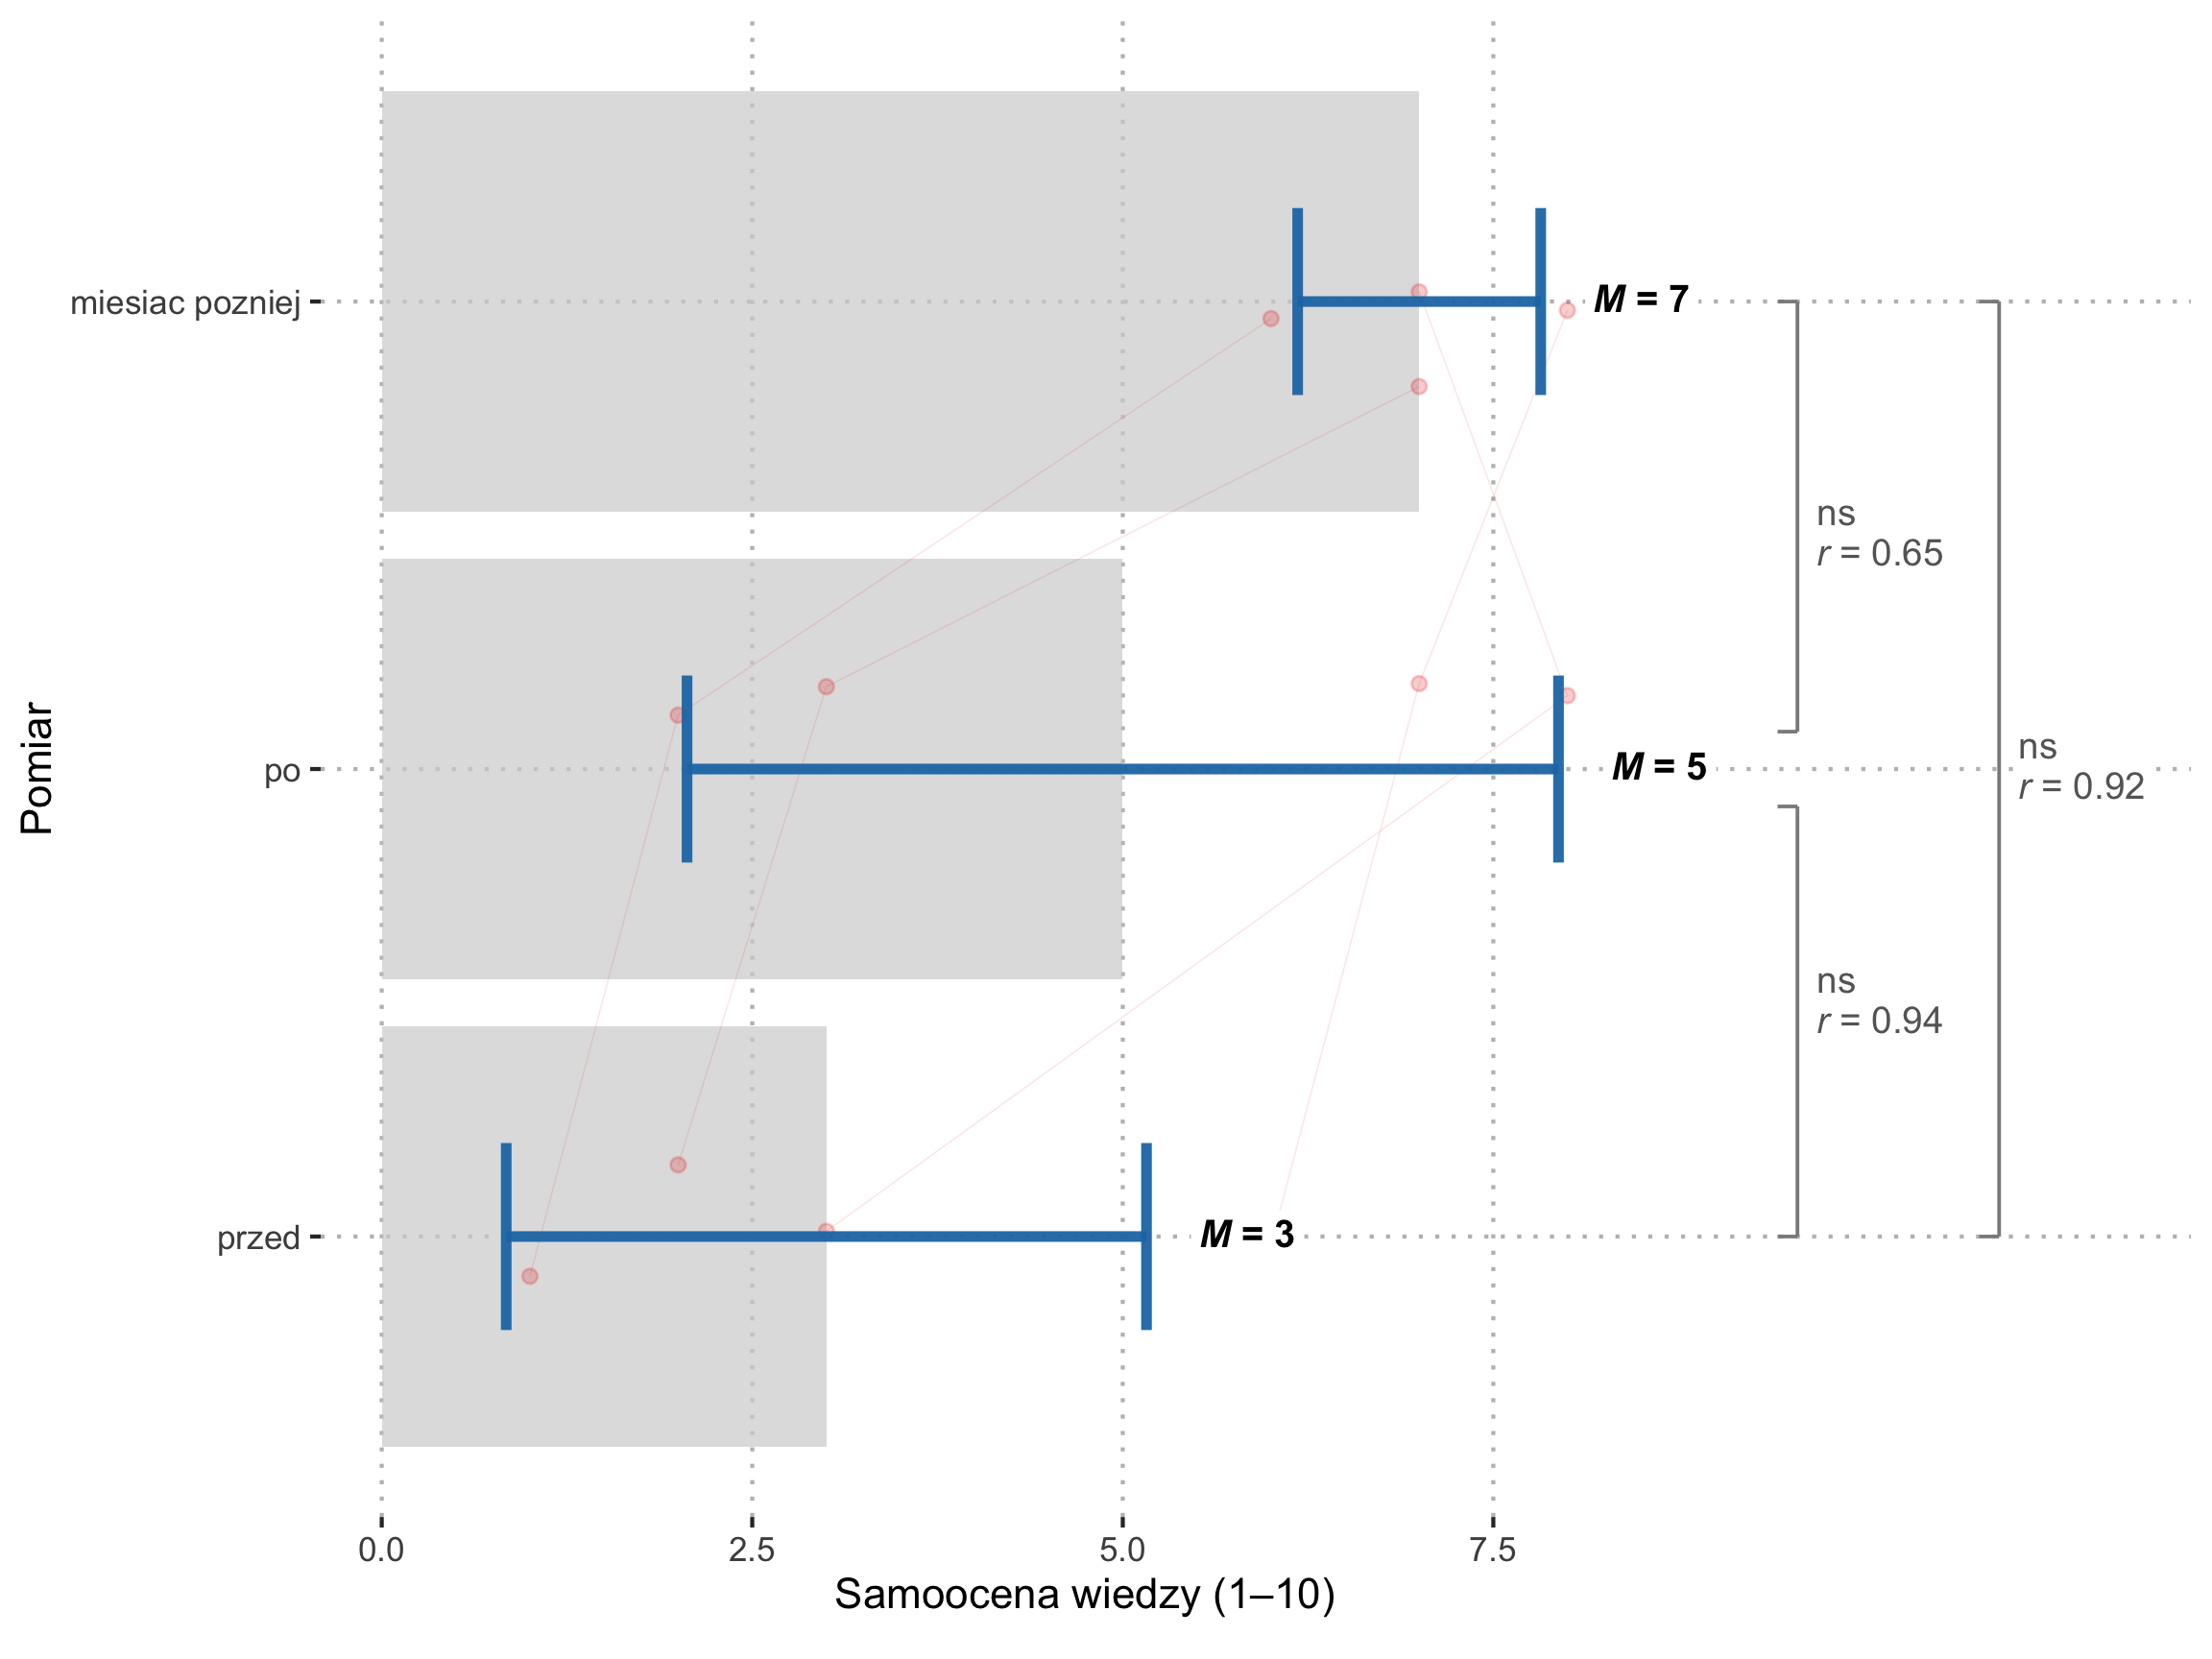
Te same dane co w haśle o teście Friedmana: czworo studentów oceniło swoją wiedzę ze statystyki (1–10) przed warsztatami, zaraz po nich i miesiąc później. Mamy n = 4 osoby i k = 3 pomiary.
| Osoba | Wyniki (przed, po, miesiąc) | Ranga „przed” | Ranga „po” | Ranga „miesiąc” |
|---|---|---|---|---|
| 1 | 1, 2, 6 | 1 | 2 | 3 |
| 2 | 2, 3, 7 | 1 | 2 | 3 |
| 3 | 3, 8, 7 | 1 | 3 | 2 |
| 4 | 6, 7, 8 | 1 | 2 | 3 |
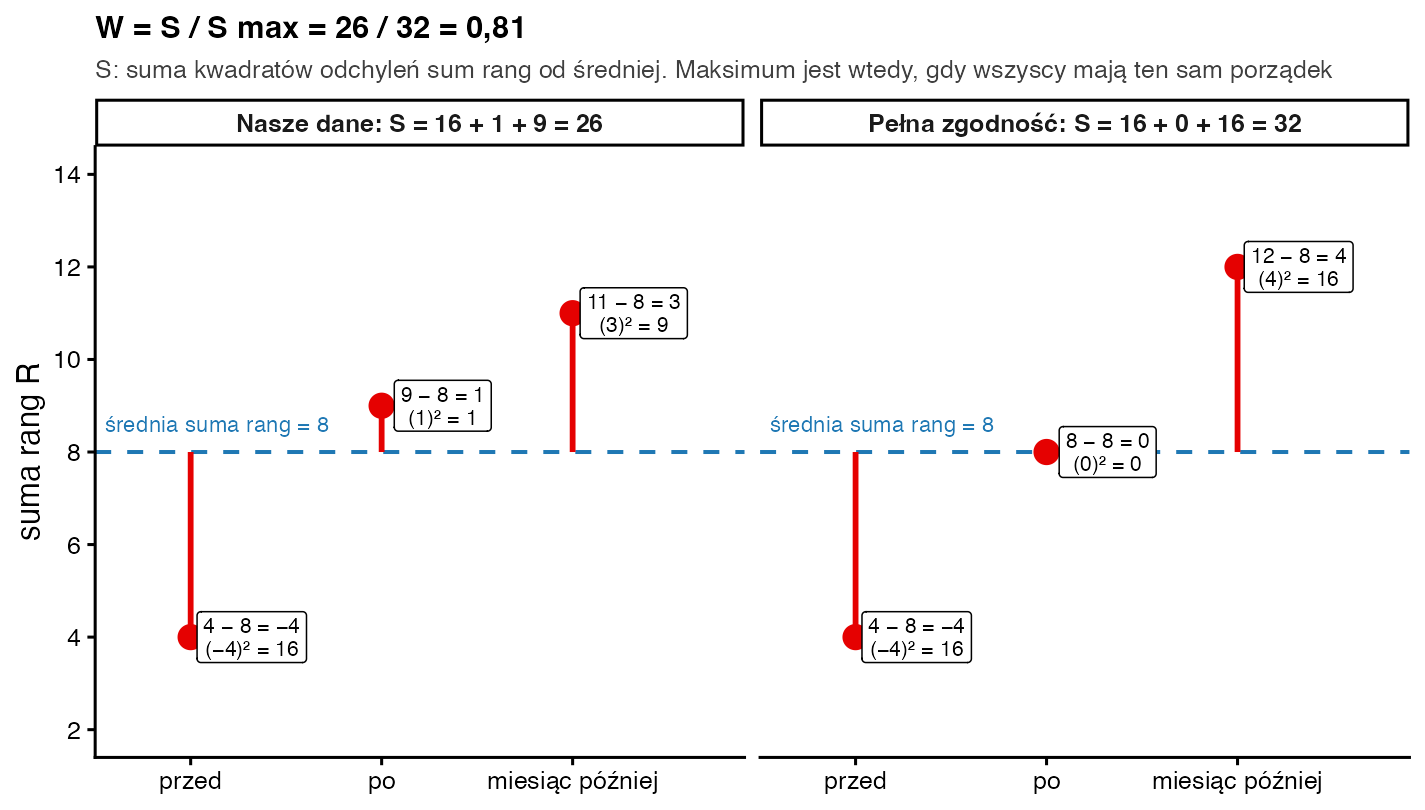
| suma rang Rj | średnia 24 / 3 = 8 | 4 | 9 | 11 |
| Rj − 8 | – | 4 − 8 = −4 | 9 − 8 = 1 | 11 − 8 = 3 |
| (Rj − 8)² | S = 16 + 1 + 9 = 26 | 16 | 1 | 9 |
- Rangi w wierszach. U każdej osoby najniższy wynik dostaje 1, a najwyższy 3. Tylko osoba 3 miała najwyższy wynik tuż po warsztatach (8), a nie miesiąc później (7).
- Sumy rang. Dodaj rangi w kolumnach: 1 + 1 + 1 + 1 = 4, 2 + 2 + 3 + 2 = 9, 3 + 3 + 2 + 3 = 11. Kontrola: 4 + 9 + 11 = 24.
- Średnia suma rang. \(\bar{R} = n(k+1)/2 = 4 \cdot 4 / 2 = 8\). Tyle dostałaby każda kolumna, gdyby porządki były zupełnie przypadkowe.
- S. Odchylenia: −4, 1 i 3. Kwadraty: 16, 1 i 9. S = 26.
- Maksymalne S. \(n^2(k^3 - k)/12 = 16 \cdot (27 - 3) / 12 = 16 \cdot 24 / 12 = 32\). Tyle wyszłoby przy sumach rang 4, 8 i 12.
- W. \(W = 12 \cdot 26 / (16 \cdot 24) = 312 / 384 = 0{,}8125 \approx 0{,}81\). To samo co 26 / 32.
- Kontrola przez test Friedmana. Z hasła o teście Friedmana χ²F = 6,50, więc W = 6,5 / (4 · 2) = 6,5 / 8 = 0,81.
- Istotność. χ² = n(k − 1)W = 4 · 2 · 0,8125 = 6,50 przy df = k − 1 = 2. Wartość krytyczna z tablic χ² dla α = 0,05 to 5,99 (w R:
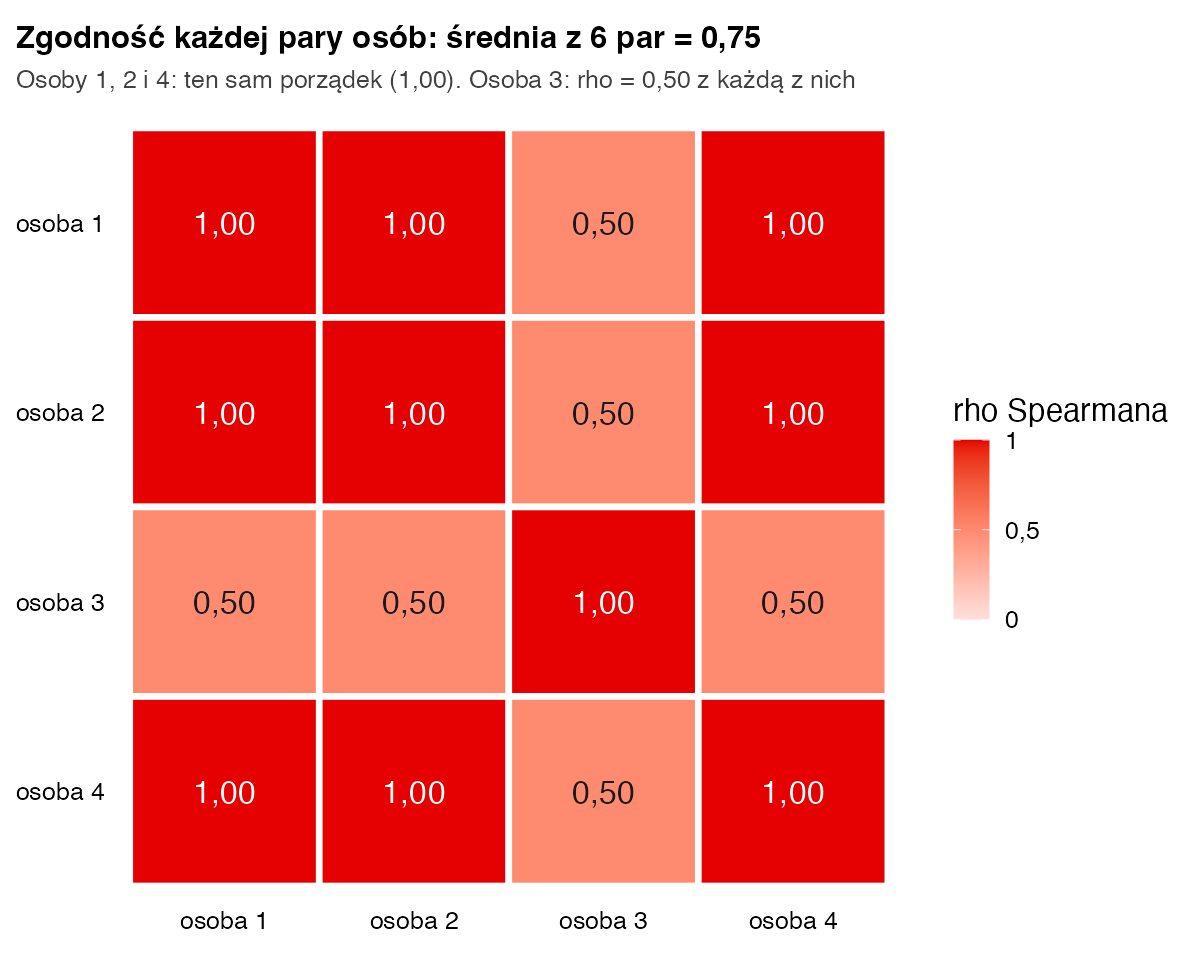
qchisq(0.95, 2)). 6,50 > 5,99, więc p < 0,05: przybliżone p = 0,039, a dokładne p = 0,042. - Średnia korelacja osób. \(\bar{r}_s = (nW - 1)/(n - 1) = (4 \cdot 0{,}8125 - 1) / 3 = 2{,}25 / 3 = 0{,}75\). Przeciętna para osób zgadza się co do porządku pomiarów w stopniu rho = 0,75.
Jak zinterpretować i opisać wynik?
W = 0,81 oznacza wysoką zgodność: prawie wszyscy badani mieli ten sam porządek pomiarów. Dla W często stosuje się progi przejęte od r: 0,10 – efekt mały, 0,30 – średni, 0,50 – duży (Cohen, 1988; tak robi m.in. pakiet rstatix). W nie jest jednak procentem wyjaśnionej zmienności – nie pisz, że „pomiar wyjaśnia 81% zmienności”. Przy zgodności sędziów nie ma jednej granicy „dobrej” zgodności. Opisz W słowami i porównaj z podobnymi badaniami.
Zapis w stylu APA: Samoocena wiedzy różniła się istotnie między pomiarami, χ²F(2) = 6,50; p = 0,042 (dokładne); W = 0,81, co wskazuje na wysoką zgodność badanych co do kolejności pomiarów.
Jak policzyć W Kendalla w R?
# wiersze = osoby (m = 4), kolumny = pomiary (k = 3)
wyniki <- matrix(c(1, 2, 6,
                   2, 3, 7,
                   3, 8, 7,
                   6, 7, 8), nrow = 4, byrow = TRUE,
                 dimnames = list(NULL, c("przed", "po", "miesiac")))

# 1) „ręcznie”: rangi w wierszach, sumy rang, S i W
rangi <- t(apply(wyniki, 1, rank))
R <- colSums(rangi)                             # 4 9 11
S <- sum((R - mean(R))^2)                       # 26
m <- 4; k <- 3
W <- 12 * S / (m^2 * (k^3 - k))                 # 0.8125
chi2 <- m * (k - 1) * W                         # 6.5
c(S = S, W = W, chi2 = chi2, p = pchisq(chi2, k - 1, lower.tail = FALSE))

# 2) gotowe funkcje: W z testu Friedmana i z pakietu effectsize
ft <- friedman.test(wyniki)
unname(ft$statistic) / (m * (k - 1))            # W = chi2_F / (N(k - 1))
suppressPackageStartupMessages(library(effectsize))
kendalls_w(wyniki, ci = NULL)
Wynik w konsoli R:
          S           W        chi2           p
26.00000000  0.81250000  6.50000000  0.03877421
[1] 0.8125
Kendall's W
-----------
0.81
Funkcja kendalls_w() z pakietu effectsize traktuje wiersze jako osoby (oceniających), a kolumny jako pomiary (oceniane obiekty).
W Kendalla przy ocenianiu przez sędziów – jak ustawić dane?
To ten sam wzór, tylko z inną nazwą wierszy i kolumn. Wiersze to sędziowie (np. promotorzy), a kolumny – oceniane obiekty (np. prace). Każdy sędzia nadaje rangi od 1 do k obiektom, a W mówi, na ile ich rankingi się pokrywają. Częsty błąd to odwrócenie tabeli: rangi muszą być nadawane w obrębie jednego sędziego. Gdy sędzia daje dwóm pracom tę samą ocenę, dostają średnią rangę, a programy dodają do mianownika poprawkę na remisy – wtedy W liczone ręcznie bez poprawki wyjdzie trochę niższe.
Najczęstsze błędy
- Interpretowanie W jako procentu wyjaśnionej zmienności.
- Nadawanie rang wszystkim wynikom razem zamiast osobno w wierszu każdej osoby.
- Odwrócenie wierszy i kolumn – W policzone dla złej orientacji tabeli to zupełnie inna liczba.
- Pisanie „W = 0,81, więc różnice są istotne” – o istotności decyduje test (χ² i p), a W opisuje siłę.
- Liczenie W przy dwóch kolumnach zamiast prostej korelacji rang.
Bibliografia
- Kendall, M. G., & Babington Smith, B. (1939). The problem of m rankings. The Annals of Mathematical Statistics, 10(3), 275–287.
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Tomczak, M., & Tomczak, E. (2014). The need to report effect size estimates revisited. An overview of some recommended measures of effect size. Trends in Sport Sciences, 21(1), 19–25.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Friedmana
- Słownik wzorówWielkość efektu r w testach nieparametrycznych
- Słownik wzorówTau Kendalla
- PoradnikTesty parametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.