

Wielkość efektu r w testach nieparametrycznych – wzór i przykład
Wielkość efektu r to liczba od 0 do 1, która mówi, jak silna jest różnica wykryta testem U Manna-Whitneya albo testem Wilcoxona. Typowe pytanie z pracy dyplomowej: test U wyszedł istotny – ale czy różnica między grupami jest mała, średnia czy duża?
W prostych słowachWartość p zależy od dwóch rzeczy naraz: od siły różnicy i od liczby osób. Przy tysiącu osób nawet drobiazg bywa istotny. Wielkość efektu r „wyciąga” z wyniku samą siłę różnicy. Jest też druga, bardzo intuicyjna miara: korelacja rangowo-dwuseryjna. Mówi, o ile częściej jedna grupa „wygrywa” w porównaniach osoba z osobą, niż przegrywa.
Kiedy liczyć r w testach nieparametrycznych?
- porównałeś dwie niezależne grupy testem U Manna-Whitneya;
- porównałeś dwa pomiary tych samych osób testem Wilcoxona;
- promotor lub recenzent prosi o wielkość efektu obok wartości p – a test rangowy nie daje d Cohena.
Przy trzech i więcej pomiarach tych samych osób (test Friedmana) zamiast r podaje się W Kendalla. Po teście Kruskala-Wallisa r liczy się dla każdej pary porównywanej testem Dunna.
Wzory na r i korelację rangowo-dwuseryjną
- \(z\)
- statystyka testu zamieniona na skalę rozkładu normalnego; bierzemy ją bez znaku minus
- \(N\)
- liczba obserwacji: w teście U wszystkie osoby z obu grup; w teście Wilcoxona zwykle liczba par (część autorów bierze liczbę pomiarów, czyli 2 × pary)
- \(U\)
- statystyka testu U: liczba par, w których osoba z grupy 1 ma wyższy wynik niż osoba z grupy 2
- \(n_1,\ n_2\)
- liczebności grup; \(n_1 n_2\) to liczba wszystkich par „osoba z grupy 1 – osoba z grupy 2”
- \(r_{rb}\)
- korelacja rangowo-dwuseryjna dla dwóch grup: różnica między odsetkiem par „wygranych” i „przegranych”
- \(T_+,\ T_-\)
- w teście Wilcoxona: suma rang dodatnich i ujemnych różnic
Jak przeczytać pierwszy wzór na głos: „r to odległość wyniku od zera w jednostkach z, podzielona przez pierwiastek z liczby obserwacji”.
Przykład krok po kroku
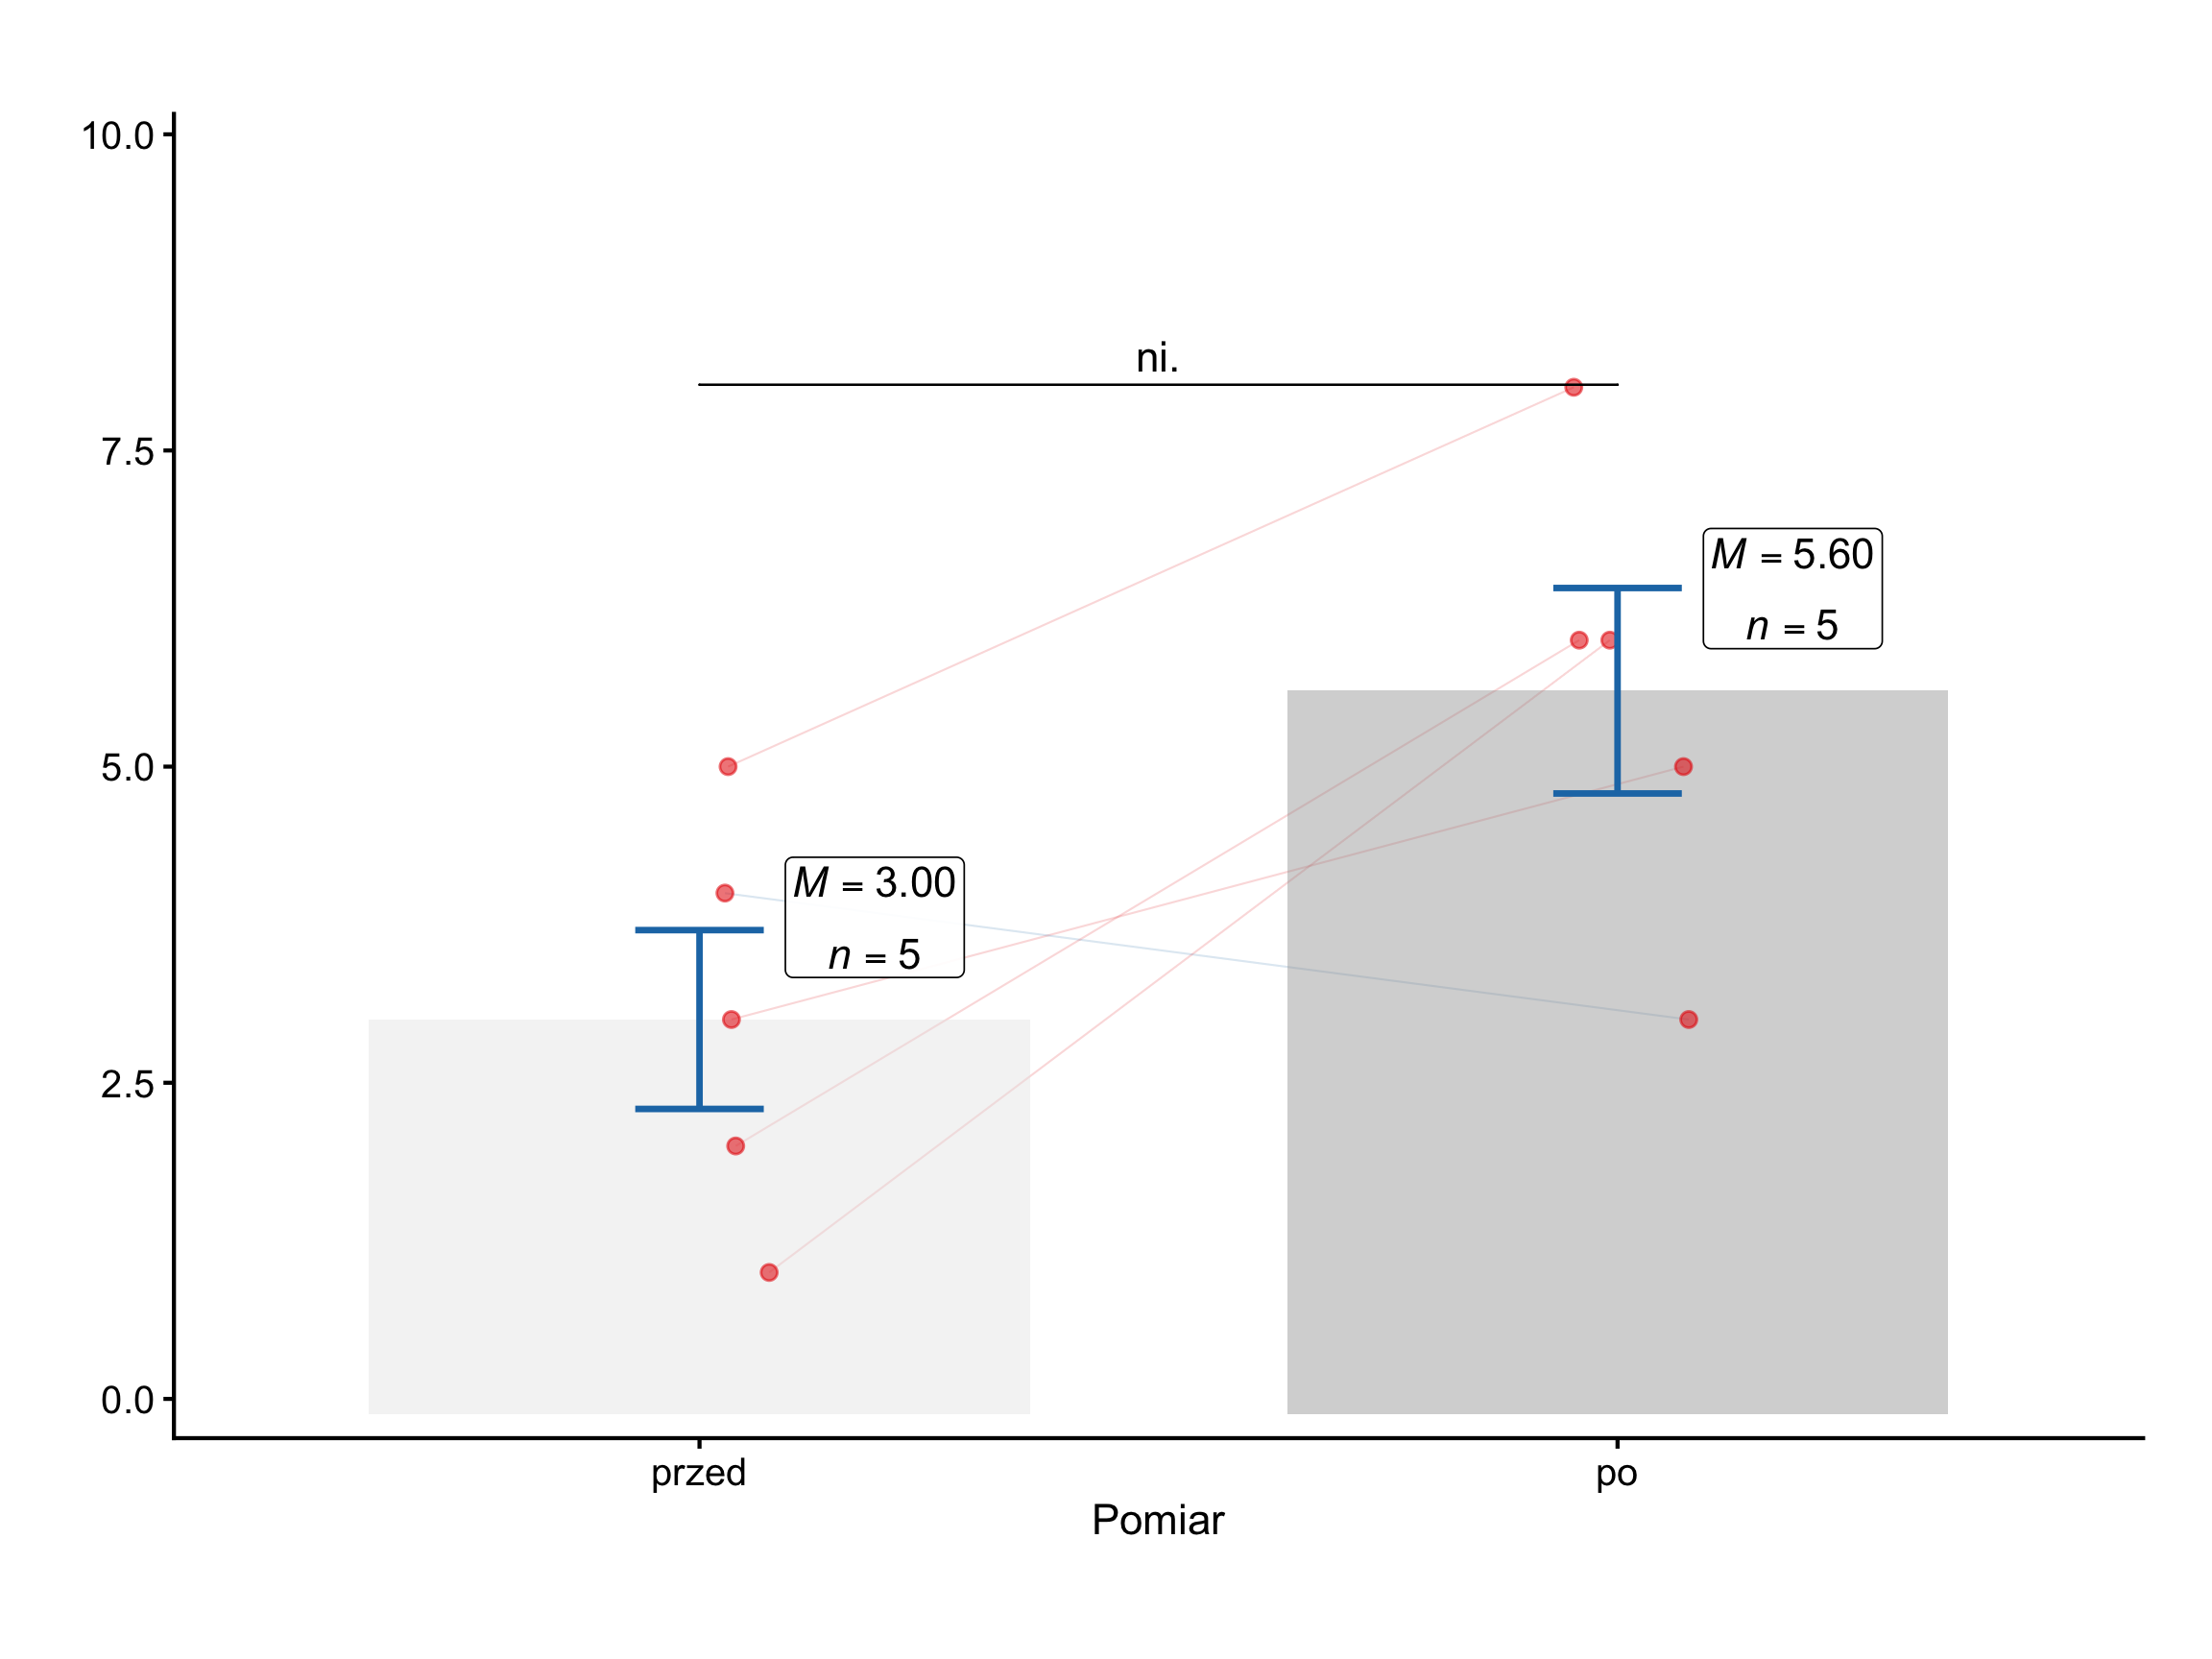
Część 1 – test U na danych z hasła o teście Manna-Whitneya. Notatki: 1, 2, 3, 5, 6 punktów. Quizy: 4, 7, 8, 9, 10 punktów. Wcześniej wyszło U = 2 i dokładne p = 0,032. Część 2 – test Wilcoxona na danych z hasła o tym teście: pięć osób przed warsztatami i po nich, T₊ = 14, T₋ = 1.
| Krok | Test U (n₁ = n₂ = 5) | Test Wilcoxona (5 par) |
|---|---|---|
| statystyka | U = 2 | T = min(14, 1) = 1 |
| wartość oczekiwana przy H0 | 5 · 5 / 2 = 12,5 | 5 · 6 / 4 = 7,5 |
| odchylenie standardowe | √(25 · 11 / 12) = √22,92 = 4,787 | √(5 · 6 · 11 / 24) = √13,75 = 3,708 |
| z | (2 − 12,5) / 4,787 = −2,19 | (1 − 7,5) / 3,708 = −1,75 |
| N i √N | 10; √10 = 3,162 | 5; √5 = 2,236 |
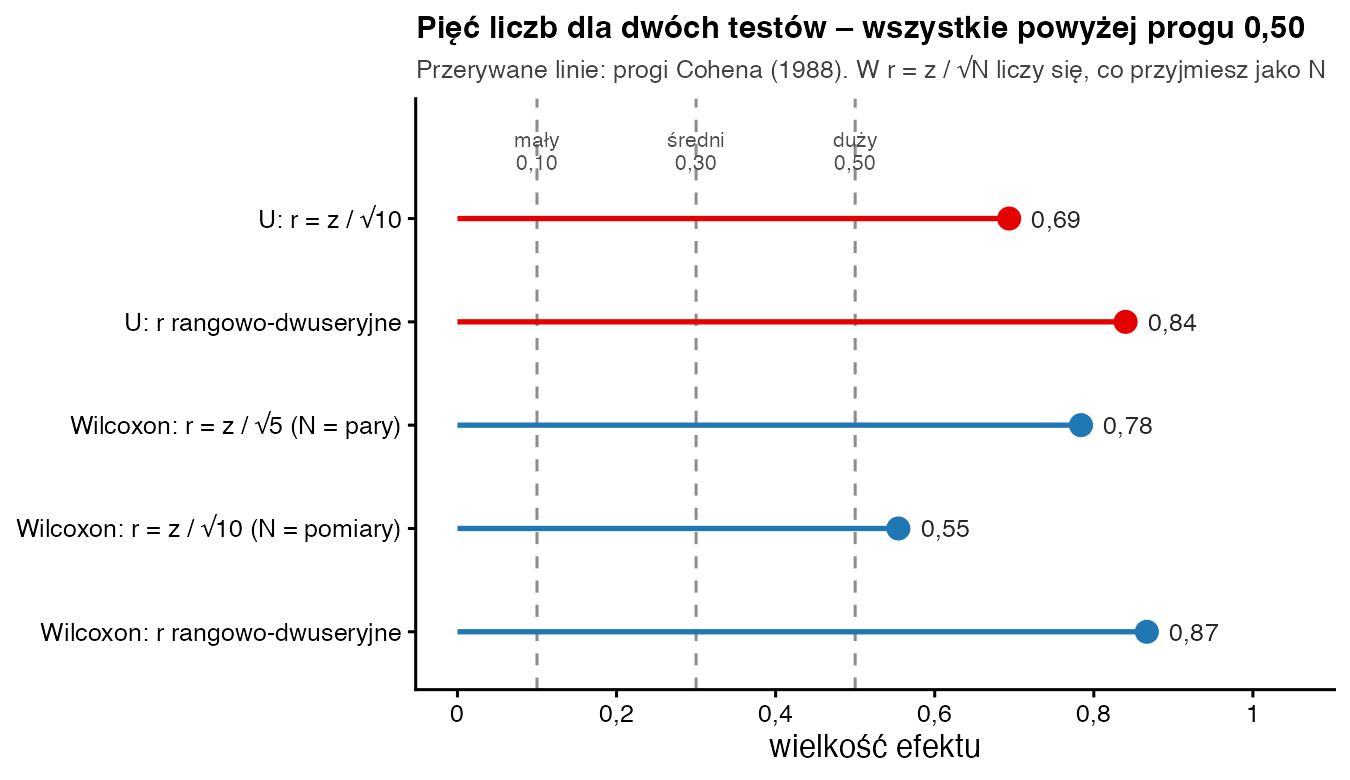
| r = |z| / √N | 2,19 / 3,162 = 0,69 | 1,75 / 2,236 = 0,78 |
| rrb | 1 − 2 · 2 / 25 = 0,84 | (14 − 1) / 15 = 0,87 |
- Środek rozkładu U. Gdyby grupy się nie różniły, każda „wygrywałaby” w połowie z 25 par: 25 / 2 = 12,5.
- Rozrzut U. 5 · 5 · (5 + 5 + 1) / 12 = 275 / 12 = 22,92, a pierwiastek z tego to 4,787.
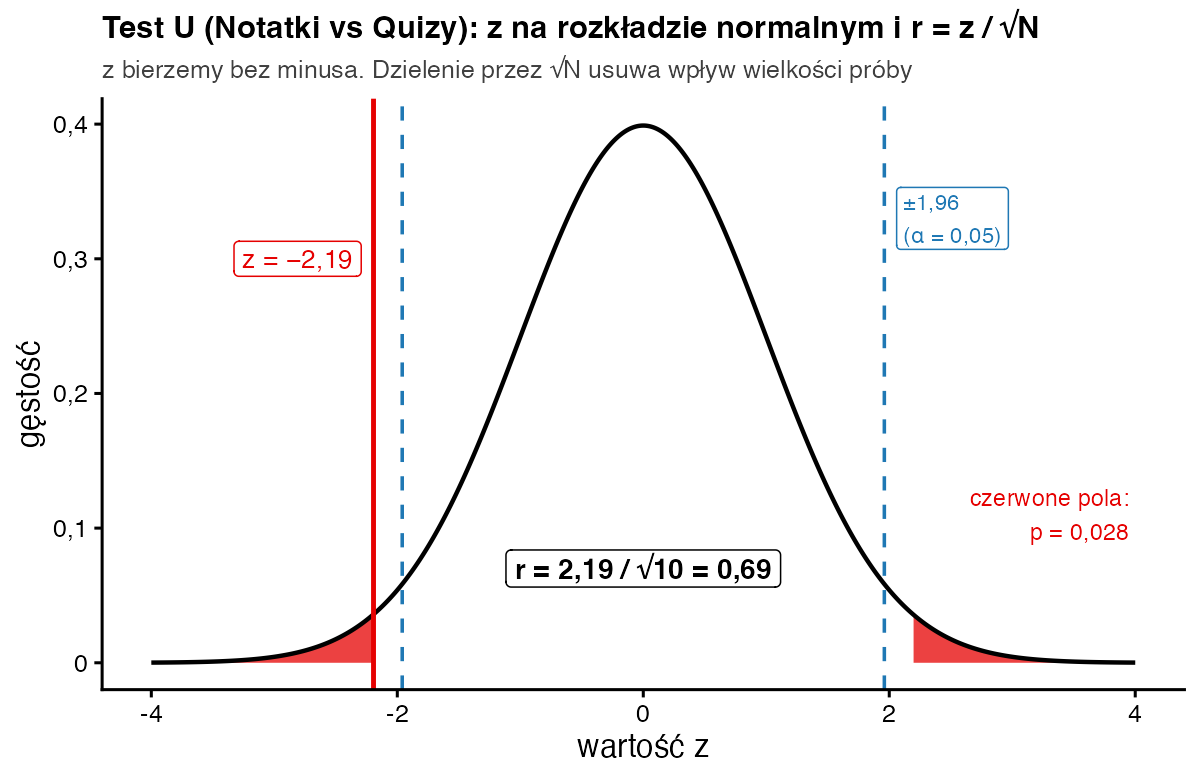
- Wartość z. Nasze U = 2 leży 2 − 12,5 = −10,5 punktu od środka, czyli −10,5 / 4,787 = −2,19 odchylenia standardowego. Z tablic rozkładu normalnego (w R
2 * pnorm(-10.5 / 4.787)) p ≈ 0,028. Granica istotności to ±1,96 (qnorm(0.975)). - r dla testu U. N = 10 osób, √10 = 3,162. r = 2,19 / 3,162 = 0,69.
- Korelacja rangowo-dwuseryjna. Quizy wygrywają w 23 parach, Notatki w 2. Różnica odsetków: 23/25 − 2/25 = 0,92 − 0,08 = 0,84. To samo daje wzór 1 − 2 · 2 / 25 = 1 − 0,16 = 0,84.
- Test Wilcoxona. z = (1 − 7,5) / 3,708 = −1,75, więc r = 1,75 / √5 = 0,78. Gdybyś jako N wziął 10 pomiarów, wyszłoby 1,75 / 3,162 = 0,55. Korelacja rangowo-dwuseryjna: (14 − 1) / (14 + 1) = 13 / 15 = 0,87.
Jak zinterpretować i opisać wynik?
Dla r przyjmuje się progi 0,10 – efekt mały, 0,30 – średni i 0,50 – duży (Cohen, 1988). Nasze r = 0,69 w teście U to efekt duży. Te same progi stosuje się zwyczajowo do rrb, choć to inna miara i bywa wyraźnie wyższa niż r. Pamiętaj, że przy małych próbach wielkość efektu jest bardzo niepewna. W teście Wilcoxona efekt jest duży (r = 0,78), a wynik i tak nieistotny. To nie sprzeczność: brak istotności oznacza tylko, że dane nie pozwalają wykluczyć przypadku, a nie że efektu nie ma.
Zapis w stylu APA: Studenci uczący się z quizów uzyskiwali wyższe wyniki niż studenci uczący się z notatek, U = 2; z = −2,19; p = 0,032 (dokładne); r = 0,69; rrb = 0,84, co wskazuje na duży efekt.
Jak policzyć r w R?
notatki <- c(1, 2, 3, 5, 6); quizy <- c(4, 7, 8, 9, 10)
przed   <- c(3, 5, 4, 2, 1);  po    <- c(5, 8, 3, 6, 6)

# 1) „ręcznie”: test U, potem z i r = |z| / sqrt(N)
U <- sum(outer(notatki, quizy, ">"))               # 2
z <- (U - 5 * 5 / 2) / sqrt(5 * 5 * (5 + 5 + 1) / 12)
c(U = U, z = z, r = abs(z) / sqrt(10), r_rb = 1 - 2 * U / 25)

# test Wilcoxona: T+ i T-, potem z, r i r_rb
d <- po - przed; rangi <- rank(abs(d))
Tp <- sum(rangi[d > 0]); Tm <- sum(rangi[d < 0])  # 14 i 1
zw <- (Tm - 5 * 6 / 4) / sqrt(5 * 6 * 11 / 24)
c(T_plus = Tp, T_minus = Tm, z = zw, r = abs(zw) / sqrt(5), r_rb = (Tp - Tm) / 15)

# 2) gotowe funkcje
suppressPackageStartupMessages({library(rstatix); library(effectsize)})
dane <- data.frame(grupa = rep(c("Notatki", "Quizy"), each = 5), punkty = c(notatki, quizy))
wilcox_effsize(dane, punkty ~ grupa)$effsize       # r = |z| / sqrt(N)
rank_biserial(quizy, notatki)$r_rank_biserial
rank_biserial(po, przed, paired = TRUE)$r_rank_biserial
Wynik w konsoli R:
         U          z          r       r_rb
 2.0000000 -2.1933785  0.6936072  0.8400000
    T_plus    T_minus          z          r       r_rb
14.0000000  1.0000000 -1.7529196  0.7839295  0.8666667
Effect size (r)
      0.6936072
[1] 0.84
[1] 0.8666667
Funkcja wilcox_effsize() z pakietu rstatix liczy r = |z| / √N, a rank_biserial() z pakietu effectsize – korelację rangowo-dwuseryjną.
Dlaczego różne programy podają różne r?
Są trzy główne źródła różnic. Po pierwsze, z bywa liczone z poprawką na ciągłość: wtedy dla naszego testu U wychodzi z = −2,09 i r = 0,66 zamiast 0,69. Po drugie, przy remisach wzór na rozrzut U ma poprawkę. Po trzecie, w teście Wilcoxona część autorów dzieli przez liczbę par, a część – przez liczbę wszystkich pomiarów (Field i in., 2012). Żaden wybór nie jest „jedynie słuszny”. Ważne, by napisać, co policzyłeś, i trzymać się tego w całej pracy.
Najczęstsze błędy
- Podawanie r ze znakiem minus i pisanie o „ujemnym efekcie” – kierunek opisz słowami, np. „wyższe wyniki w grupie Quizy”.
- Mylenie r w teście U z korelacją Pearsona między dwiema zmiennymi ilościowymi.
- Podpisywanie korelacji rangowo-dwuseryjnej jako „r” bez wyjaśnienia – to inna liczba.
- Liczenie r z wartości z przybliżenia normalnego przy bardzo małych grupach bez zaznaczenia, że p podajesz dokładne.
- Wniosek „efekt jest duży, więc różnica na pewno istnieje”, gdy p > 0,05.
Bibliografia
- Rosenthal, R. (1991). Meta-analytic procedures for social research (Rev. ed.). SAGE.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1
- Tomczak, M., & Tomczak, E. (2014). The need to report effect size estimates revisited. An overview of some recommended measures of effect size. Trends in Sport Sciences, 21(1), 19–25.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest U Manna-Whitneya
- Słownik wzorówTest Wilcoxona
- Słownik wzorówd Cohena – wielkość efektu
- Słownik wzorówW Kendalla
- Słownik wzorówEpsilon² dla testu Kruskala-Wallisa
- PoradnikTesty parametryczne
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.