

Współczynnik korelacji wewnątrzklasowej ICC – wzór i przykład
ICC (ang. intraclass correlation coefficient) mówi, na ile oceny liczbowe kilku sędziów są zgodne, czyli jaka część różnic w ocenach wynika z prawdziwych różnic między ocenianymi osobami. Przykładowe pytanie z pracy dyplomowej: czy trzech prowadzących podobnie punktuje prezentacje studentów?
W prostych słowachWyobraź sobie, że kilku sędziów ocenia tych samych studentów. Jeśli oceny różnią się głównie dlatego, że studenci naprawdę wypadli różnie, ICC jest bliskie 1. Jeśli różnią się dlatego, że każdy sędzia ocenia „po swojemu”, ICC spada w stronę 0. ICC to więc udział prawdziwych różnic między osobami w całej zmienności ocen.
Kiedy stosować ICC?
- oceny są liczbowe (punkty, skala 1–10, czas, wynik pomiaru);
- każdą osobę lub obiekt ocenia dwóch lub więcej sędziów albo ta sama osoba mierzy coś kilka razy (rzetelność test–retest);
- chcesz sprawdzić zgodność ocen, a nie tylko to, czy idą w parze.
Gdy oceny są kategoriami (zaliczone/niezaliczone) i masz dwóch oceniających, użyj kappy Cohena. Zwykła korelacja Pearsona nie nadaje się do oceny zgodności: sędzia, który każdemu daje o 2 punkty więcej, ma z kolegą r = 1, choć ich oceny nigdy się nie pokrywają. ICC liczy się z tabeli analizy wariancji z powtarzanymi pomiarami, a jego wersja dla średniej ocen jest blisko spokrewniona z alfą Cronbacha.
Wzór na ICC
Na głos: „ICC to nadwyżka różnic między osobami nad błędem, podzielona przez wszystkie źródła zmienności ocen”. Wersja (2,1) liczy w mianowniku także różnice między sędziami, a wersja (3,1) – nie.
- \(n\)
- liczba ocenianych osób (tu 5)
- \(k\)
- liczba sędziów (tu 3)
- \(MS_{\text{os}}\)
- średni kwadrat dla osób: jak bardzo różnią się średnie oceny poszczególnych osób
- \(MS_{\text{sęd}}\)
- średni kwadrat dla sędziów: jak bardzo jeden sędzia jest surowszy lub łagodniejszy od innych
- \(MS_{\text{bł}}\)
- średni kwadrat błędu: rozbieżności, których nie da się wyjaśnić ani osobą, ani sędzią
- MS
- skrót od mean square: suma kwadratów (SS) podzielona przez jej stopnie swobody
- ICC(2,1)
- zgodność bezwzględna (ang. absolute agreement): sędziowie mają dawać te same liczby
- ICC(3,1)
- spójność (ang. consistency): wystarczy, że sędziowie tak samo porządkują osoby, nawet jeśli jeden jest stale surowszy
Przykład krok po kroku
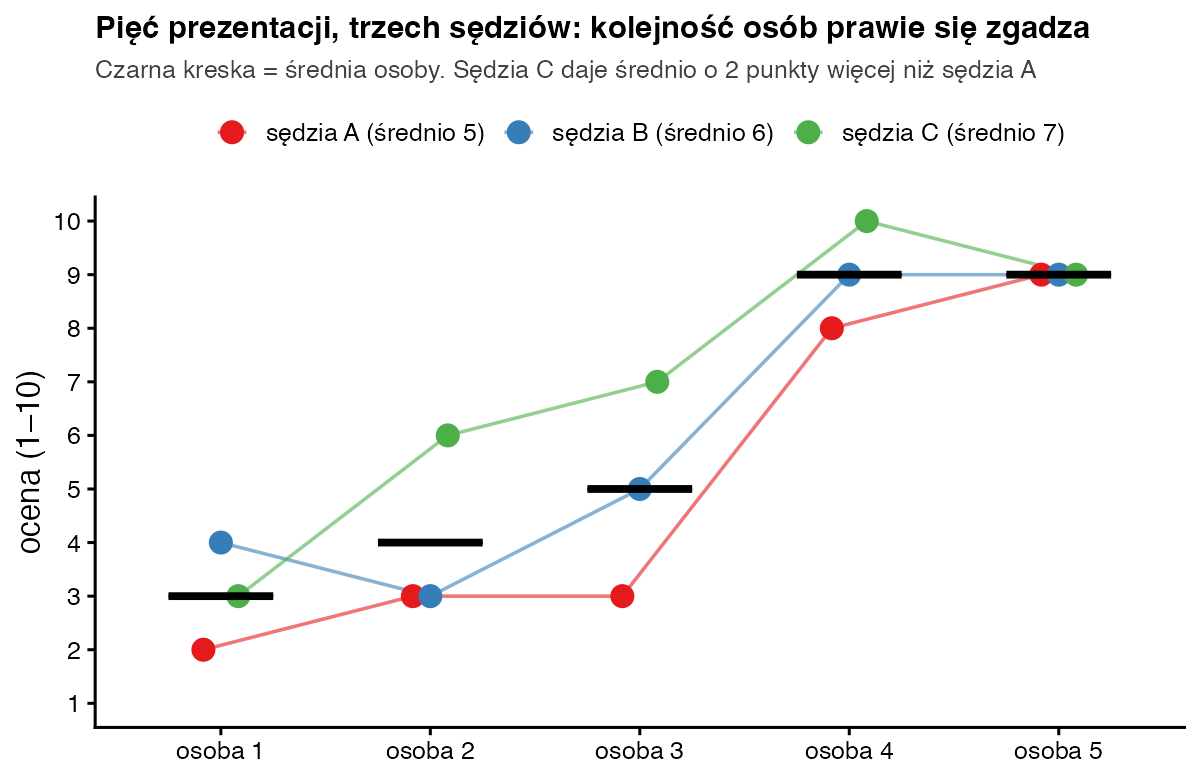
Trzech prowadzących (sędziowie A, B i C) oceniło na skali 1–10 prezentacje pięciorga studentów. Średnia wszystkich 15 ocen wynosi 90 / 15 = 6.
| osoba | A | B | C | średnia osoby | (średnia osoby − 6)² | (A − 6)² + (B − 6)² + (C − 6)² |
|---|---|---|---|---|---|---|
| 1 | 2 | 4 | 3 | 9 / 3 = 3 | (−3)² = 9 | 16 + 4 + 9 = 29 |
| 2 | 3 | 3 | 6 | 12 / 3 = 4 | (−2)² = 4 | 9 + 9 + 0 = 18 |
| 3 | 3 | 5 | 7 | 15 / 3 = 5 | (−1)² = 1 | 9 + 1 + 1 = 11 |
| 4 | 8 | 9 | 10 | 27 / 3 = 9 | 3² = 9 | 4 + 9 + 16 = 29 |
| 5 | 9 | 9 | 9 | 27 / 3 = 9 | 3² = 9 | 9 + 9 + 9 = 27 |
| suma | 25 | 30 | 35 | 30 | 32 | 114 |
| średnia sędziego | 5 | 6 | 7 | 6 |
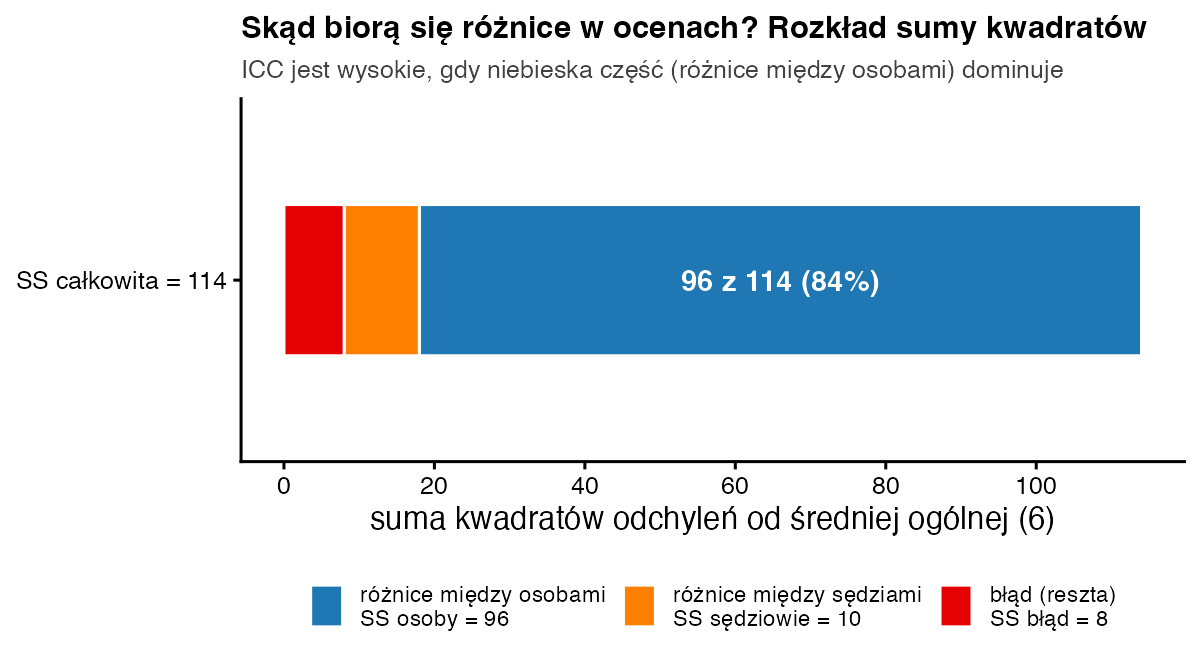
- Suma kwadratów dla osób. Każda średnia osoby powstała z 3 ocen, więc mnożymy sumę z przedostatniej kolumny przez k = 3: \(SS_{\text{os}} = 3 \cdot 32 = 96\). To różnice, które chcemy zmierzyć.
- Suma kwadratów dla sędziów. Średnie sędziów to 5, 6 i 7. Odchylenia od 6: −1, 0, 1; ich kwadraty: 1, 0, 1; suma 2. Każda średnia sędziego powstała z 5 ocen, więc \(SS_{\text{sęd}} = 5 \cdot 2 = 10\).
- Całkowita suma kwadratów i błąd. Z ostatniej kolumny: \(SS_{\text{całk}} = 114\). To, czego nie wyjaśniają osoby ani sędziowie, to błąd: 114 − 96 − 10 = 8.
- Średnie kwadraty. Dzielimy przez stopnie swobody: \(MS_{\text{os}} = 96 / (5 - 1) = 96/4 = 24\); \(MS_{\text{sęd}} = 10 / (3 - 1) = 10/2 = 5\); \(MS_{\text{bł}} = 8 / (4 \cdot 2) = 8/8 = 1\).
- ICC(3,1) – spójność. Licznik: 24 − 1 = 23. Mianownik: 24 + (3 − 1) · 1 = 24 + 2 = 26. ICC = 23 / 26 = 0,885.
- ICC(2,1) – zgodność bezwzględna. Do mianownika dochodzi kara za różnice między sędziami: 3 · (5 − 1) / 5 = 12 / 5 = 2,4. Mianownik: 26 + 2,4 = 28,4. ICC = 23 / 28,4 = 0,810.
- Test istotności. F = MSos / MSbł = 24 / 1 = 24,00 przy df = 4 i 8. Wartość krytyczna z tablic F dla α = 0,05 to 3,84 (w R:
qf(0.95, 4, 8)). Nasze F jest dużo większe, p < 0,001.
Dlaczego ICC(2,1) wyszło niższe? Sędzia C daje średnio o 2 punkty więcej niż sędzia A. Przy spójności to nie przeszkadza, przy zgodności bezwzględnej – obniża wynik.
Które ICC wybrać?
Shrout i Fleiss (1979) opisali sześć wersji ICC, a Koo i Li (2016) podali prostą ścieżkę wyboru. Zadaj sobie trzy pytania.
- Model. Czy każdą osobę oceniali inni sędziowie? Wtedy ICC(1). Czy sędziowie to losowa próbka ludzi, którzy mogliby oceniać, i chcesz uogólnić wynik? ICC(2). Czy interesują Cię tylko ci konkretni sędziowie? ICC(3).
- Typ. Czy liczy się zgodność bezwzględna (te same liczby), czy tylko spójność (ta sama kolejność)? Przy ocenianiu, które ma skutki, wybieraj zgodność bezwzględną.
- Jednostka. Czy w dalszej analizie użyjesz oceny jednego sędziego (ICC(2,1)), czy średniej z k sędziów (ICC(2,k))? Średnia jest pewniejsza, więc jej ICC jest wyższe: tu ICC(2,k) = 0,927.
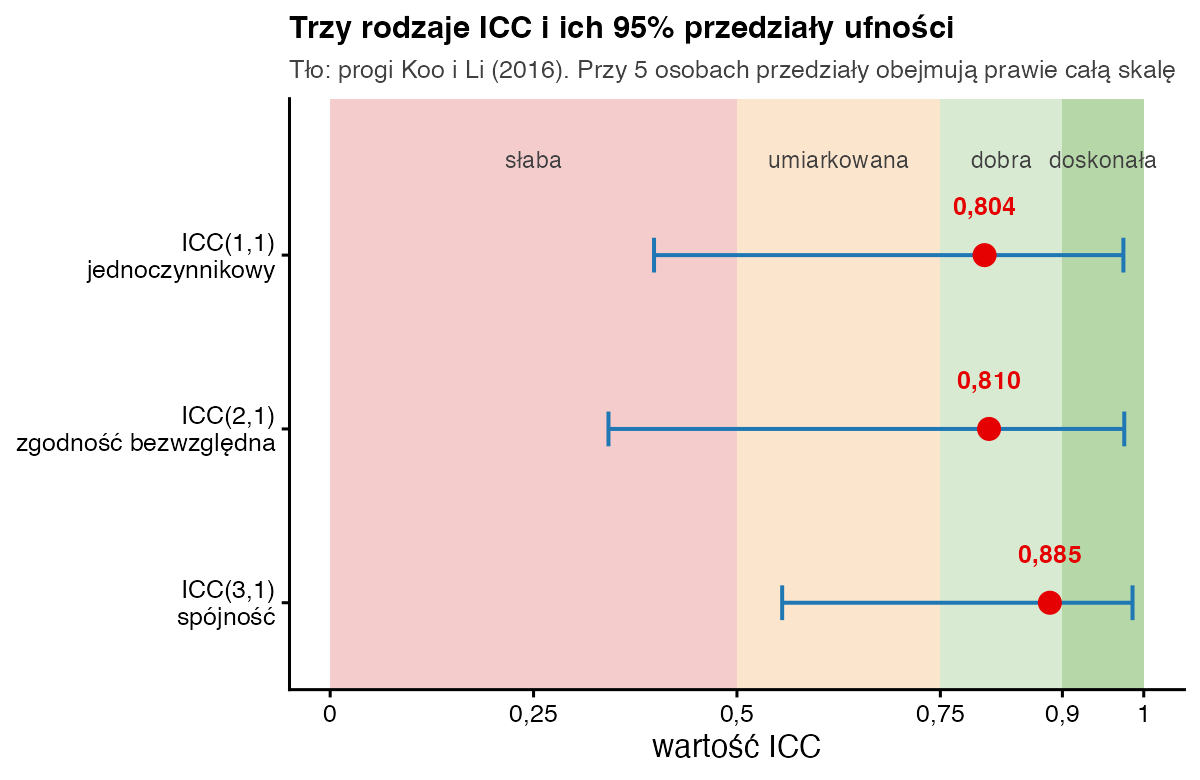
W naszym przykładzie ICC(1,1) wynosi 0,804. W modelu jednoczynnikowym różnice między sędziami trafiają do błędu: \(MS_{w} = (10 + 8)/(5 \cdot 2) = 1{,}8\), więc ICC = (24 − 1,8) / (24 + 2 · 1,8) = 22,2 / 27,6 = 0,804.
Jak zinterpretować i opisać wynik?
Koo i Li (2016) proponują progi: poniżej 0,50 – rzetelność słaba, 0,50–0,75 – umiarkowana, 0,75–0,90 – dobra, powyżej 0,90 – doskonała. Zalecają oceniać wynik po całym przedziale ufności, a nie tylko po wartości punktowej. Nasze ICC(2,1) = 0,81 to wynik dobry, ale przedział od 0,34 do 0,98 pokazuje, że do mocnego wniosku potrzeba więcej ocenianych osób. W opisie zawsze podaj model, typ i jednostkę ICC.
Zapis w stylu APA: Zgodność ocen trzech sędziów oszacowano współczynnikiem korelacji wewnątrzklasowej w modelu dwuczynnikowym losowym, dla zgodności bezwzględnej i pojedynczego sędziego. Zgodność była dobra, ICC(2,1) = 0,81; 95% CI [0,34; 0,98]; F(4, 8) = 24,00; p < 0,001.
Jak policzyć ICC w R?
oceny <- matrix(c(2, 4,  3,     # osoba 1 – sędziowie A, B, C
                  3, 3,  6,     # osoba 2
                  3, 5,  7,     # osoba 3
                  8, 9, 10,     # osoba 4
                  9, 9,  9),    # osoba 5
                ncol = 3, byrow = TRUE)

# 1) „ręcznie”: sumy kwadratów i średnie kwadraty jak w ANOVA
n <- nrow(oceny); k <- ncol(oceny); M <- mean(oceny)            # 5 osób, 3 sędziów, M = 6
SS_os  <- k * sum((rowMeans(oceny) - M)^2)                      # 96
SS_sed <- n * sum((colMeans(oceny) - M)^2)                      # 10
SS_bl  <- sum((oceny - M)^2) - SS_os - SS_sed                   # 114 - 96 - 10 = 8
MS_os <- SS_os / (n - 1); MS_sed <- SS_sed / (k - 1); MS_bl <- SS_bl / ((n - 1) * (k - 1))
c(MS_os = MS_os, MS_sed = MS_sed, MS_bl = MS_bl)                # 24, 5, 1
c(ICC_2_1 = (MS_os - MS_bl) / (MS_os + (k - 1) * MS_bl + k * (MS_sed - MS_bl) / n),
  ICC_3_1 = (MS_os - MS_bl) / (MS_os + (k - 1) * MS_bl))

# 2) gotową funkcją z pakietu psych
w <- psych::ICC(oceny)$results
data.frame(typ = w$type, ICC = round(w$ICC, 3), F = round(w$F, 2),
           CI_dolna = round(w$`lower bound`, 2), CI_gorna = round(w$`upper bound`, 2))
Wynik w konsoli R:
 MS_os MS_sed  MS_bl
    24      5      1
  ICC_2_1   ICC_3_1
0.8098592 0.8846154
    typ   ICC     F CI_dolna CI_gorna
1  ICC1 0.804 13.33     0.40     0.97
2  ICC2 0.810 24.00     0.34     0.98
3  ICC3 0.885 24.00     0.56     0.99
4 ICC1k 0.925 13.33     0.66     0.99
5 ICC2k 0.927 24.00     0.61     0.99
6 ICC3k 0.958 24.00     0.79     1.00
Funkcja psych::ICC() zwraca wszystkie sześć wersji. ICC1, ICC2 i ICC3 to oceny pojedynczego sędziego, a wiersze z literą k – średnie z k sędziów. Wybierz jeden wiersz zgodnie z planem badania, zanim zobaczysz wyniki.
Najczęstsze błędy
- Podawanie „ICC = 0,81” bez informacji, która to wersja – różnice między wersjami bywają duże.
- Wybieranie wersji z najwyższym wynikiem już po obliczeniach.
- Liczenie korelacji Pearsona między sędziami zamiast ICC – Pearson nie widzi stałej różnicy w surowości.
- Interpretowanie samej wartości punktowej, gdy ocenianych osób jest kilka, a przedział ufności jest bardzo szeroki.
- Używanie ICC dla ocen kategorialnych – tu lepsza jest kappa.
Bibliografia
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
- McGraw, K. O., & Wong, S. P. (1996). Forming inferences about some intraclass correlation coefficients. Psychological Methods, 1(1), 30–46. https://doi.org/10.1037/1082-989X.1.1.30
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKappa Cohena
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówANOVA z powtarzanymi pomiarami
- Słownik wzorówRzetelność test-retest
- PoradnikAlfa Cronbacha – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportPrzykład SZTOS: analiza rzetelności skal
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.