

Diagnostyka regresji na wykresach – reszty, Q-Q, dźwignia i VIF
Zanim opiszesz współczynniki regresji, sprawdź, czy model w ogóle pasuje do danych. Najszybciej zrobisz to na czterech wykresach diagnostycznych. Pokazujemy je na dwóch modelach: dobrym i takim, który na pierwszy rzut oka „przechodzi” testy, a wykres zdradza poważny problem. Typowe pytanie z pracy dyplomowej: jak udowodnić promotorowi, że założenia regresji są spełnione?
W skrócieReszty vs wartości dopasowane (liniowość) → wykres Q-Q reszt (normalność) → scale-location (stała wariancja) → dźwignia i odległość Cooka (obserwacje wpływowe) → VIF (współliniowość). Wykres pokazuje jaki jest problem, test tylko czy przekroczono próg. Sam model i jego opis znajdziesz we wpisie analiza regresji – przykład krok po kroku.
Dlaczego wykresy, a nie same testy?
Wszystkie założenia regresji dotyczą reszt, czyli różnic „wynik − przewidywanie modelu”, a nie surowych zmiennych. Testy (Shapiro-Wilk, Breusch-Pagan) dają jedną liczbę i przy małej próbie łatwo przeoczają problem. Przy dużej próbie z kolei alarmują z powodu drobiazgów. Wykres pokazuje kształt problemu i podpowiada, co poprawić. Dlatego w pracy pokaż oba: wykres i liczbę.
Krok 1. Cztery wykresy – co sprawdzają i jak je czytać
| Wykres | Założenie | Dobrze, gdy… | Problem, gdy… | Co wtedy zrobić |
|---|---|---|---|---|
| Reszty vs wartości dopasowane | liniowość | chmura wokół zera bez wzoru | łuk lub fala | dodaj człon kwadratowy, przekształć zmienną |
| Q-Q reszt | normalność reszt | punkty przy linii | „ogony” odginają się od linii | przy dużej próbie zwykle bez znaczenia; przy małej – bootstrap |
| Scale-location (√|reszty standaryzowane|) | stała wariancja | pozioma, płaska linia | lejek: rozrzut rośnie z przewidywaniem | odporne błędy standardowe HC3, transformacja y |
| Dźwignia i odległość Cooka | brak obserwacji wpływowych | punkty wewnątrz konturów Cooka | punkt poza konturem | sprawdź dane, policz model z tą osobą i bez niej |
| VIF (dodatkowo) | brak współliniowości | VIF < 5 | VIF ≥ 5–10 | połącz lub usuń predyktor, wyśrodkuj zmienne przy członach x² |
Model dobry to dziesięciu studentów z wpisu o regresji: punkty z kolokwium przewidujemy na podstawie godzin nauki i stresu (R² = 0,92). Aplikacja SZTOS rysuje wszystkie panele naraz (rys. 1).
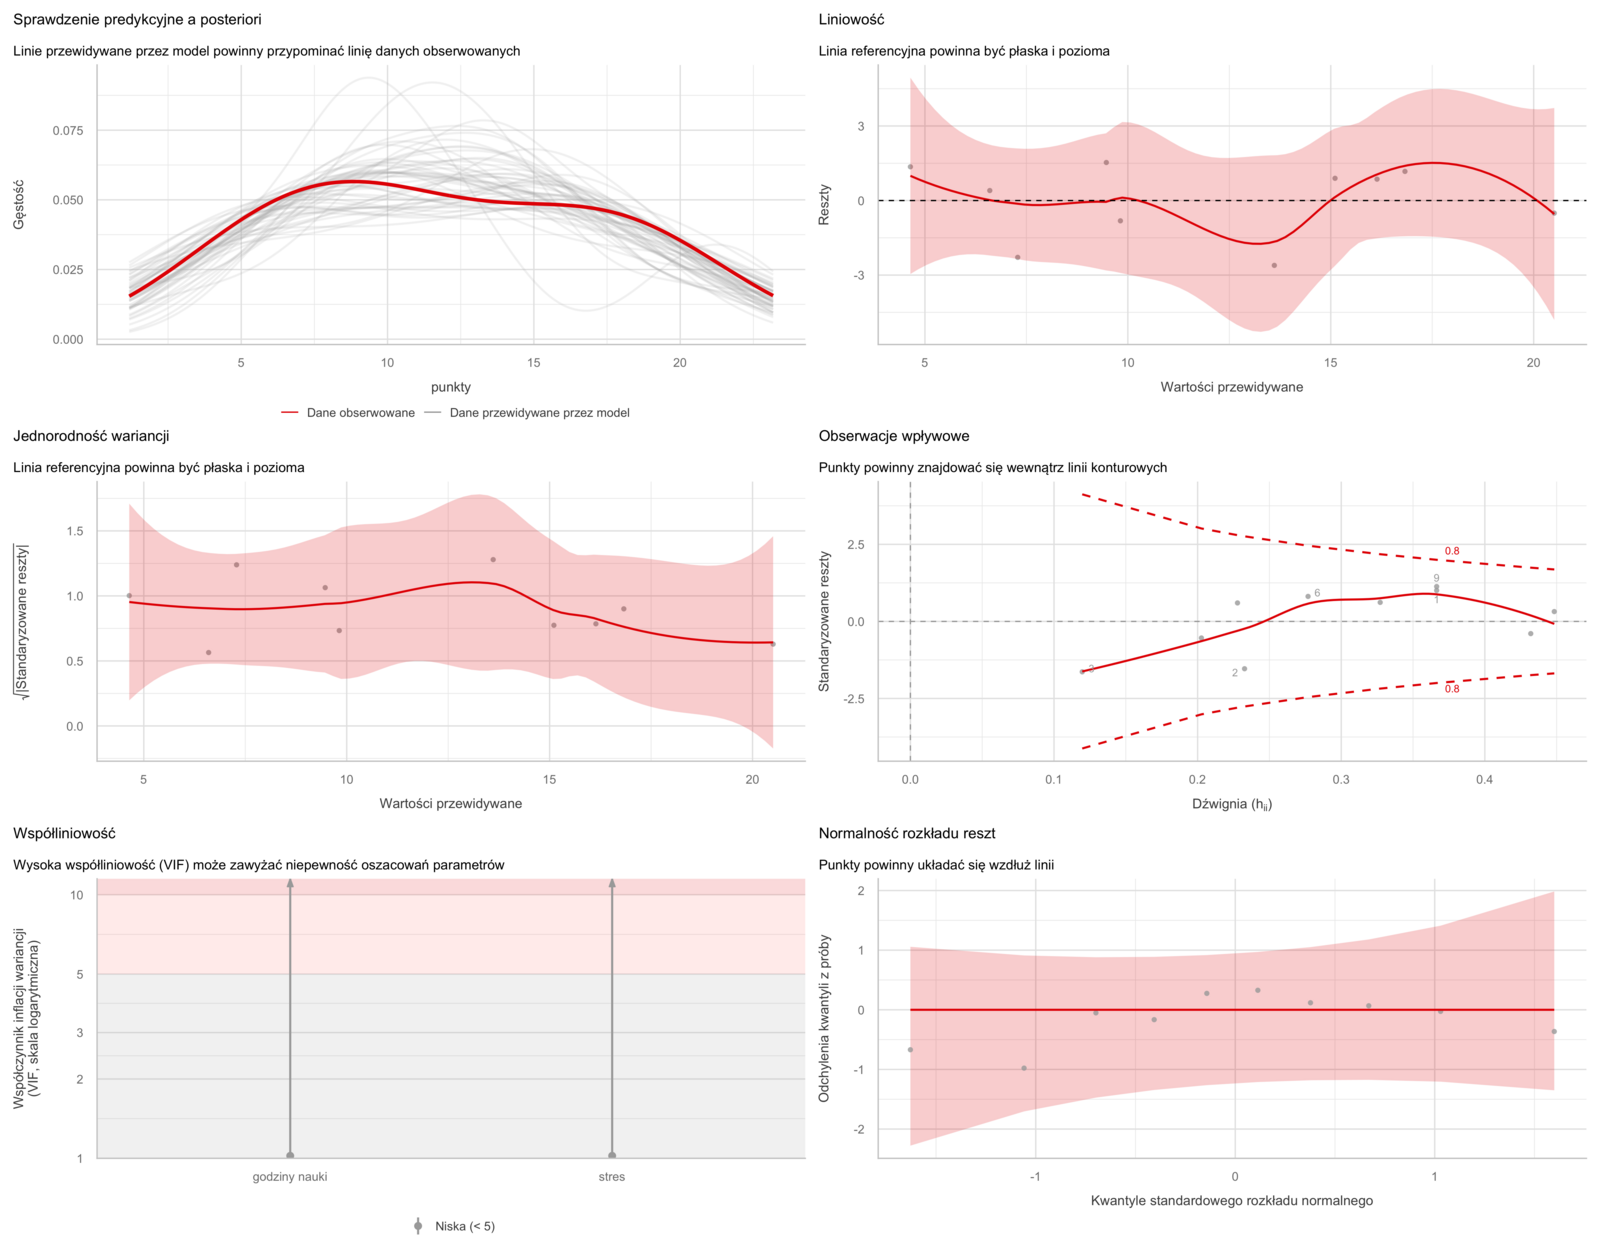
- Liniowość. Reszty skaczą raz nad, raz pod zerem, czerwona linia wygładzenia faluje w szerokim pasie i nie układa się w łuk. Przy 10 punktach to wystarczy.
- Normalność reszt. Wszystkie punkty mieszczą się w pasie. Test Shapiro-Wilka to potwierdza: W = 0,87; p = 0,096. Szczegóły czytania znajdziesz w haśle wykres Q-Q.
- Stała wariancja. Linia jest prawie pozioma, bez lejka. Test Breuscha-Pagana: p = 0,330.
- Obserwacje wpływowe. Największa dźwignia wynosi 0,45, mniej niż często stosowany próg 2(k + 1)/n = 2 · 3/10 = 0,6. Największa odległość Cooka to 0,25 (próg 1). Żaden punkt nie wychodzi poza kontur.
- Współliniowość. VIF = 1,02 dla obu predyktorów, czyli nauka i stres prawie się nie pokrywają.
Krok 2. Model z problemem: łuk, którego testy nie widzą
Drugie badanie: 12 studentów podało, ile filiżanek kawy dziennie pili w sesji (0–5), i ile punktów zdobyli na kolokwium. Zwykła regresja liniowa daje nachylenie b = 0,89; p = 0,098; R² = 0,25. Kusi, by napisać „brak związku”. Testy założeń nie protestują: Shapiro-Wilk p = 0,207, Breusch-Pagan p = 0,484. Ale wykres reszt mówi co innego (rys. 2).
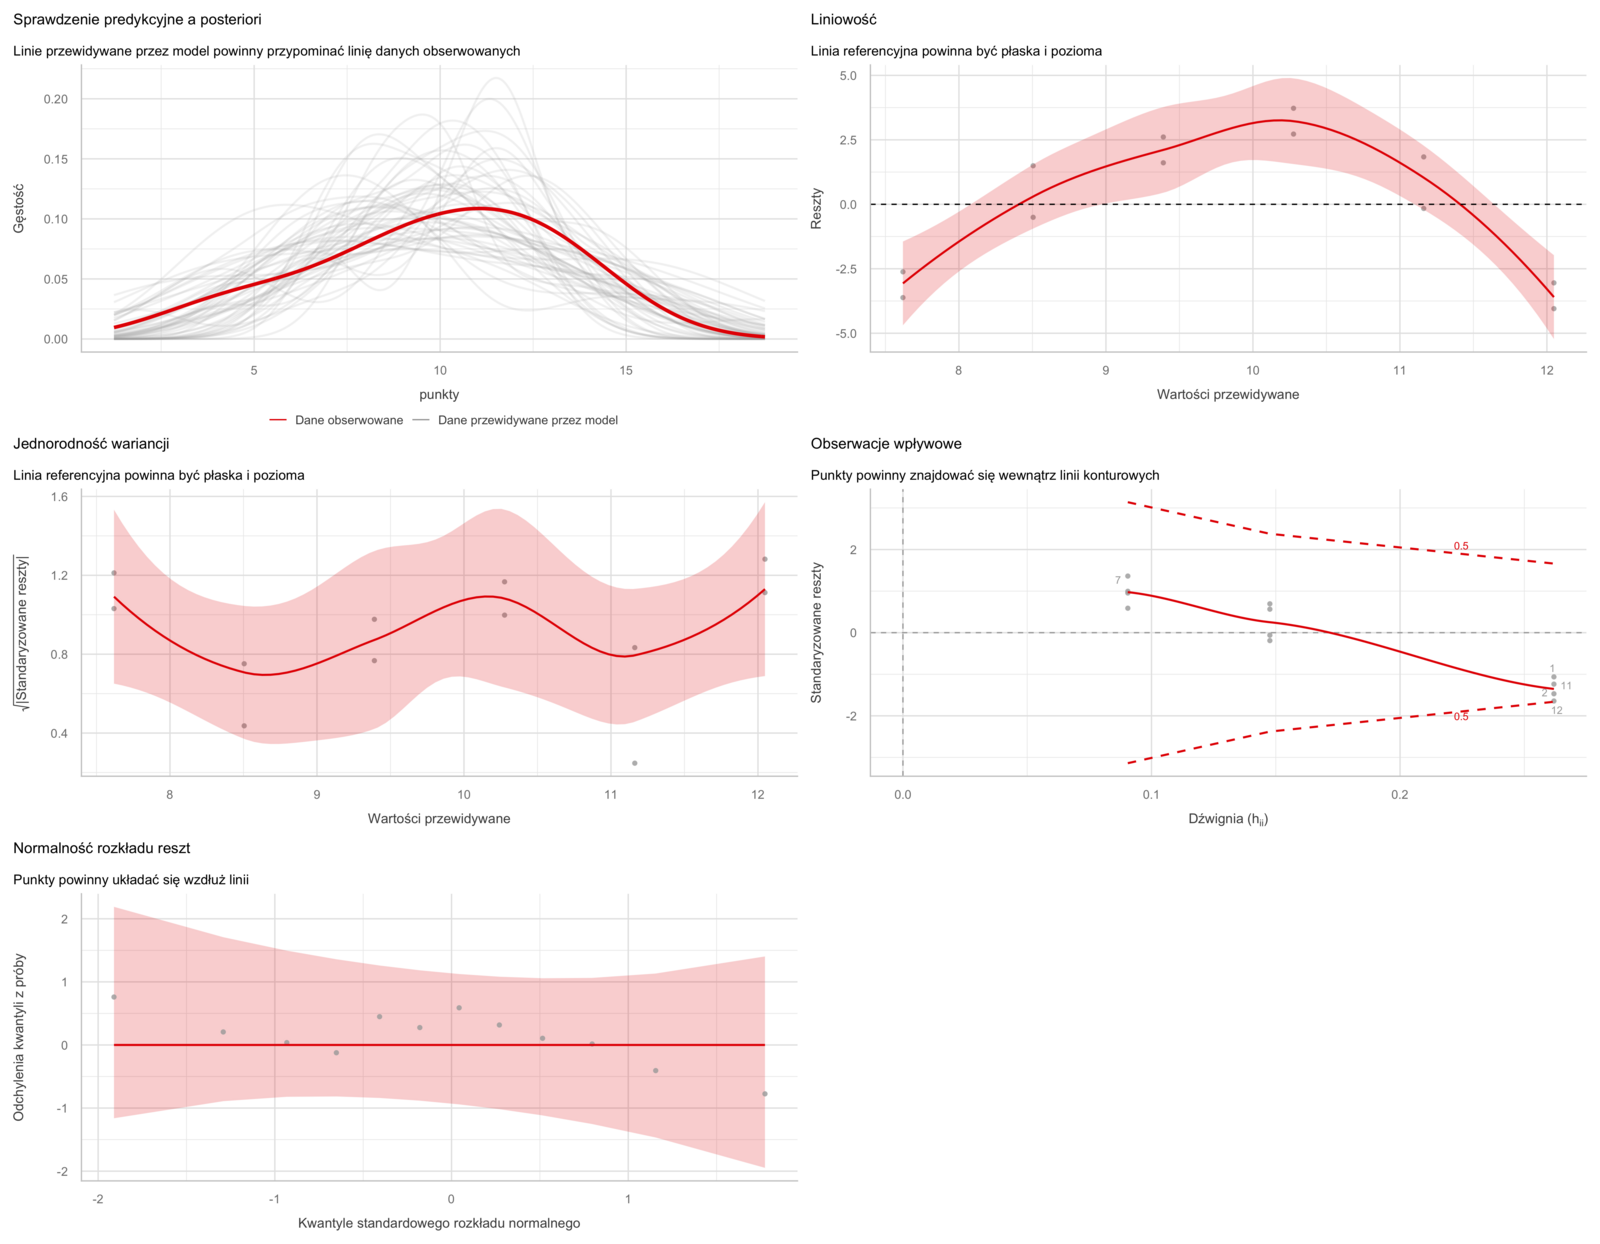
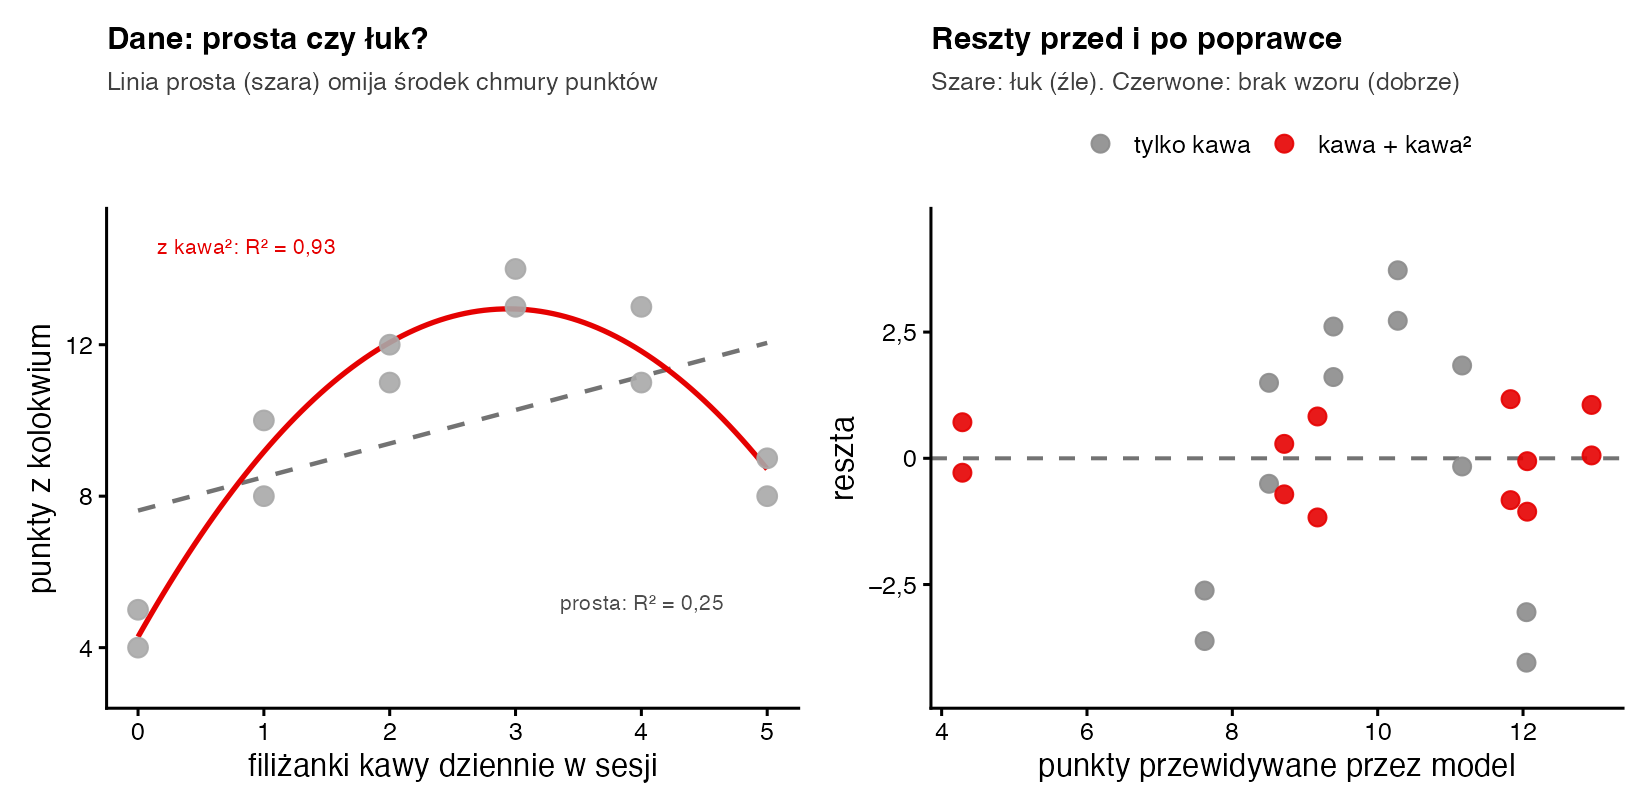
Łuk oznacza, że prosta to zły kształt modelu. Tu związek ma postać odwróconego U: wyniki rosną do około trzech filiżanek, a potem spadają (rys. 3). Pamiętaj, że to dane korelacyjne. Nie wynika z nich, że kawa „podnosi” lub „obniża” wynik.
Krok 3. Poprawka modelu i pułapka VIF
Dodajemy człon kwadratowy: punkty = 4,29 + 5,89 · kawa − 1,00 · kawa². R² rośnie z 0,25 do 0,93, a porównanie modeli daje F(1, 9) = 89,09; p < 0,001. Szczyt paraboli wypada przy −b1 / (2b2) ≈ 2,94 filiżanki, czyli około trzech. Jak porównywać modele zagnieżdżone, opisuje hasło regresja hierarchiczna i ΔR².
Teraz pułapka. W modelu z kawa i kawa² VIF wynosi 12,72, bo obie zmienne są niemal tym samym (korelacja 0,96). To współliniowość „zrobiona przez nas”. Wystarczy wyśrodkować kawę (odjąć średnią 2,5) przed podniesieniem do kwadratu, a VIF spada do 1,00. Dopasowanie modelu i R² się nie zmieniają.
Co napisać w pracy?
Zapis w stylu APA (model dobry): Założenia modelu oceniono na podstawie wykresów reszt (rys. A1 w aneksie) oraz testów. Wykres reszt względem wartości przewidywanych nie wskazywał na nieliniowość ani zmienną wariancję (test Breuscha-Pagana: p = 0,330), a rozkład reszt nie odbiegał istotnie od normalnego (W = 0,87; p = 0,096). Największa odległość Cooka wynosiła 0,25, a VIF = 1,02, co nie wskazuje na obserwacje wpływowe ani współliniowość.
Zapis w stylu APA (model poprawiony): Wykres reszt modelu liniowego wskazał na nieliniowy związek (łuk reszt), dlatego dodano człon kwadratowy wyśrodkowanej liczby filiżanek kawy. Model z członem kwadratowym wyjaśniał istotnie więcej zmienności punktów, ΔR² = 0,68; F(1, 9) = 89,09; p < 0,001; R² = 0,93.
- Wykres diagnostyczny wklej do aneksu i odwołaj się do niego w tekście.
- Napisz, które założenia sprawdzałeś i czym (wykres + test).
- Jeśli coś poprawiłeś, opisz co i dlaczego. Recenzent woli widzieć problem i poprawkę niż „wszystkie założenia spełnione” bez dowodu.
Tak wygląda pełny raport z diagnostyką: przykładowy raport SZTOS z analizy regresji.
Cała analiza w R
library(car); library(lmtest)   # vif(), bptest()
# Model 1 (dobry): 10 studentów – godziny nauki, stres (1–10) i punkty z kolokwium
dobry <- data.frame(nauka  = c(3, 4, 6, 5, 3, 8, 5, 1, 6, 9),
                    stres  = c(9, 8, 5, 2, 4, 5, 1, 4, 9, 3),
                    punkty = c(6, 5, 11, 16, 9, 18, 17, 7, 11, 20))
m_dobry <- lm(punkty ~ nauka + stres, data = dobry)
par(mfrow = c(2, 2)); plot(m_dobry)     # 4 wykresy diagnostyczne
# performance::check_model(m_dobry)     # to samo w wersji ggplot (jak w SZTOS)

# liczby, które potwierdzają ocenę wzrokową
round(c(SW_p = shapiro.test(resid(m_dobry))$p.value, BP_p = unname(bptest(m_dobry)$p.value),
  max_h = max(hatvalues(m_dobry)), max_Cook = max(cooks.distance(m_dobry))), 3)
round(vif(m_dobry), 2)

# Model 2 (z problemem): 12 studentów – filiżanki kawy dziennie w sesji i punkty
kawa <- data.frame(kawa = rep(0:5, each = 2),
                   punkty = c(5, 4, 8, 10, 12, 11, 14, 13, 11, 13, 9, 8))
m_prosty <- lm(punkty ~ kawa, data = kawa)
plot(m_prosty, which = 1)               # reszty vs dopasowane: wyraźny łuk
round(c(R2 = summary(m_prosty)$r.squared, p = coef(summary(m_prosty))[2, 4],
  SW_p = shapiro.test(resid(m_prosty))$p.value, BP_p = unname(bptest(m_prosty)$p.value)), 3)

# Poprawka: człon kwadratowy, najlepiej na kawie wyśrodkowanej (inaczej VIF rośnie)
m_kw  <- lm(punkty ~ kawa + I(kawa^2), data = kawa)
kawa$kawa_c <- kawa$kawa - mean(kawa$kawa)
m_kwc <- lm(punkty ~ kawa_c + I(kawa_c^2), data = kawa)
anova(m_prosty, m_kw)                   # czy łuk istotnie poprawia model?
round(coef(m_kw), 2); round(summary(m_kw)$r.squared, 2)
round(rbind(bez_centrowania = vif(m_kw), po_centrowaniu = vif(m_kwc)), 2)
Wynik w konsoli R:
    SW_p     BP_p    max_h max_Cook
   0.096    0.330    0.448    0.247
nauka stres
 1.02  1.02
   R2     p  SW_p  BP_p
0.250 0.098 0.207 0.484
Analysis of Variance Table

Model 1: punkty ~ kawa
Model 2: punkty ~ kawa + I(kawa^2)
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1     10 82.210
2      9  7.543  1    74.667 89.091 5.775e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Intercept)        kawa   I(kawa^2)
       4.29        5.89       -1.00
[1] 0.93
                 kawa I(kawa^2)
bez_centrowania 12.72     12.72
po_centrowaniu   1.00      1.00
Pytania promotora i recenzenta
Mam lejek na wykresie reszt – co robić?
To heteroskedastyczność: rozrzut reszt rośnie wraz z przewidywaniem. Współczynniki b nadal są nieobciążone, ale błędy standardowe i wartości p są niewiarygodne. Najprościej podać odporne błędy standardowe HC3 (Long i Ervin, 2000), w R: coeftest(model, vcov = hccm(model, type = "hc3")).
Czy mogę usunąć obserwację wpływową?
Tylko jeśli to błąd danych. W innym wypadku pokaż model z tą osobą i bez niej. Więcej we wpisie obserwacje odstające – reguła IQR i odległość Cooka.
Czy mam sprawdzać normalność samych zmiennych?
Nie. W regresji liczy się rozkład reszt. Zmienna zależna może być skośna, a reszty – w porządku.
Bibliografia
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówHomoskedastyczność i test Breuscha-Pagana
- Słownik wzorówWykres Q-Q
- Słownik wzorówVIF – współliniowość predyktorów
- PoradnikRegresja liniowa – przykład
- PoradnikKorelacja Pearsona – przykład
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.