

Obserwacje odstające – reguła IQR i odległość Cooka na przykładzie
Jedna nietypowa osoba potrafi zmienić średnią w grupie albo przechylić całą linię regresji. Pokazujemy dwa najprostsze narzędzia do jej wykrycia: regułę 1,5 × IQR w porównaniach grup i odległość Cooka w regresji. Potem przechodzimy do tego, co z taką osobą zrobić, a czego nie robić, i jak to opisać w pracy.
W skrócieWykryj (IQR w każdej grupie osobno, Cook w modelu) → sprawdź, czy to nie pomyłka → policz wyniki z tą osobą i bez niej → opisz obie wersje. Wzory krok po kroku znajdziesz w hasłach kwartyle i rozstęp międzykwartylowy oraz odległość Cooka.
Odstająca, wpływowa, błędna – to nie to samo
Obserwacja odstająca ma wynik daleko od reszty grupy albo daleko od linii regresji. Obserwacja wpływowa zmienia wyniki analizy: średnią, nachylenie, wartość p. Obserwacja błędna to pomyłka, np. wpisane 71 zamiast 17. Tylko błąd poprawiasz bez wahania. Prawdziwy, choć nietypowy wynik jest częścią danych i jego los rozstrzyga analiza wrażliwości (Aguinis i in., 2013).
Krok 1. Reguła 1,5 × IQR w grupie
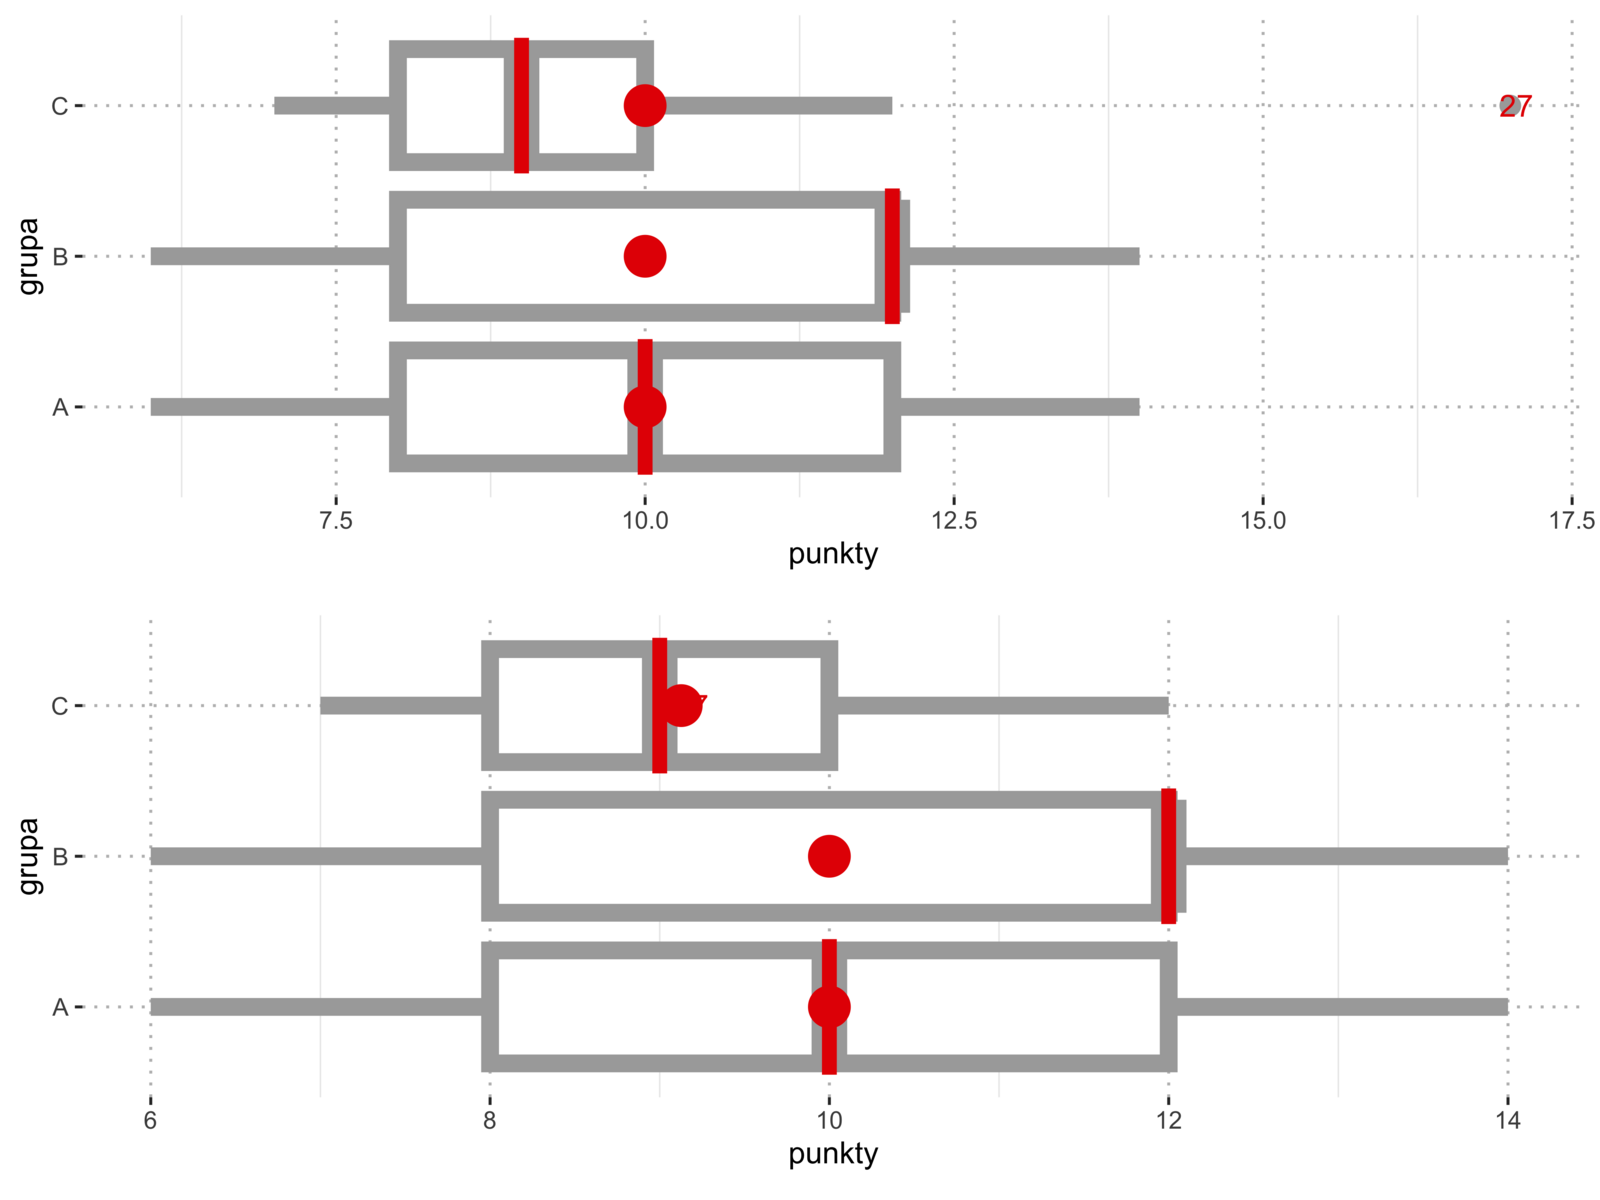
Bierzemy grupę C z wpisu o wykresach raincloud i violin: punkty z kolokwium dziewięciu osób. Reguła Tukeya (1977) wyznacza dwa „płoty” i za odstające uznaje wyniki poza nimi.
| Krok | Działanie | Wynik |
|---|---|---|
| dane uporządkowane | 7, 8, 8, 9, 9, 10, 10, 12, 17 | n = 9 |
| kwartyle | Q1 – 3. wynik, Q3 – 7. wynik (metoda R i Excela) | Q1 = 8; Q3 = 10 |
| rozstęp międzykwartylowy | IQR = 10 − 8 | 2 |
| dolny płot | 8 − 1,5 · 2 = 8 − 3 | 5 |
| górny płot | 10 + 1,5 · 2 = 10 + 3 | 13 |
| decyzja | 17 > 13, a nikt nie ma mniej niż 5 | odstaje wynik 17 |
- Licz w każdej grupie osobno. Gdy wrzucisz wszystkie 27 osób z trzech grup do jednego worka, kwartyle wynoszą 8 i 12, płoty 2 i 18, a wynik 17 przestaje odstawać. Nietypowość ocenia się względem własnej grupy.
- Sprawdź, czy wynik zależy od metody kwartyli. SPSS liczy je inaczej i daje Q3 = 11, więc górny płot to 11 + 1,5 · 3 = 15,5. Wynik 17 odstaje i tak. Gdy wniosek zależy od metody, napisz to wprost.
- Zobacz, co ta osoba zmienia. Średnia grupy C spada z 10 do 9,125 po pominięciu wyniku 17, a mediana zostaje równa 9. Mediana i inne metody oparte na rangach są na takie wyniki mało wrażliwe.
Krok 2. Odległość Cooka w regresji
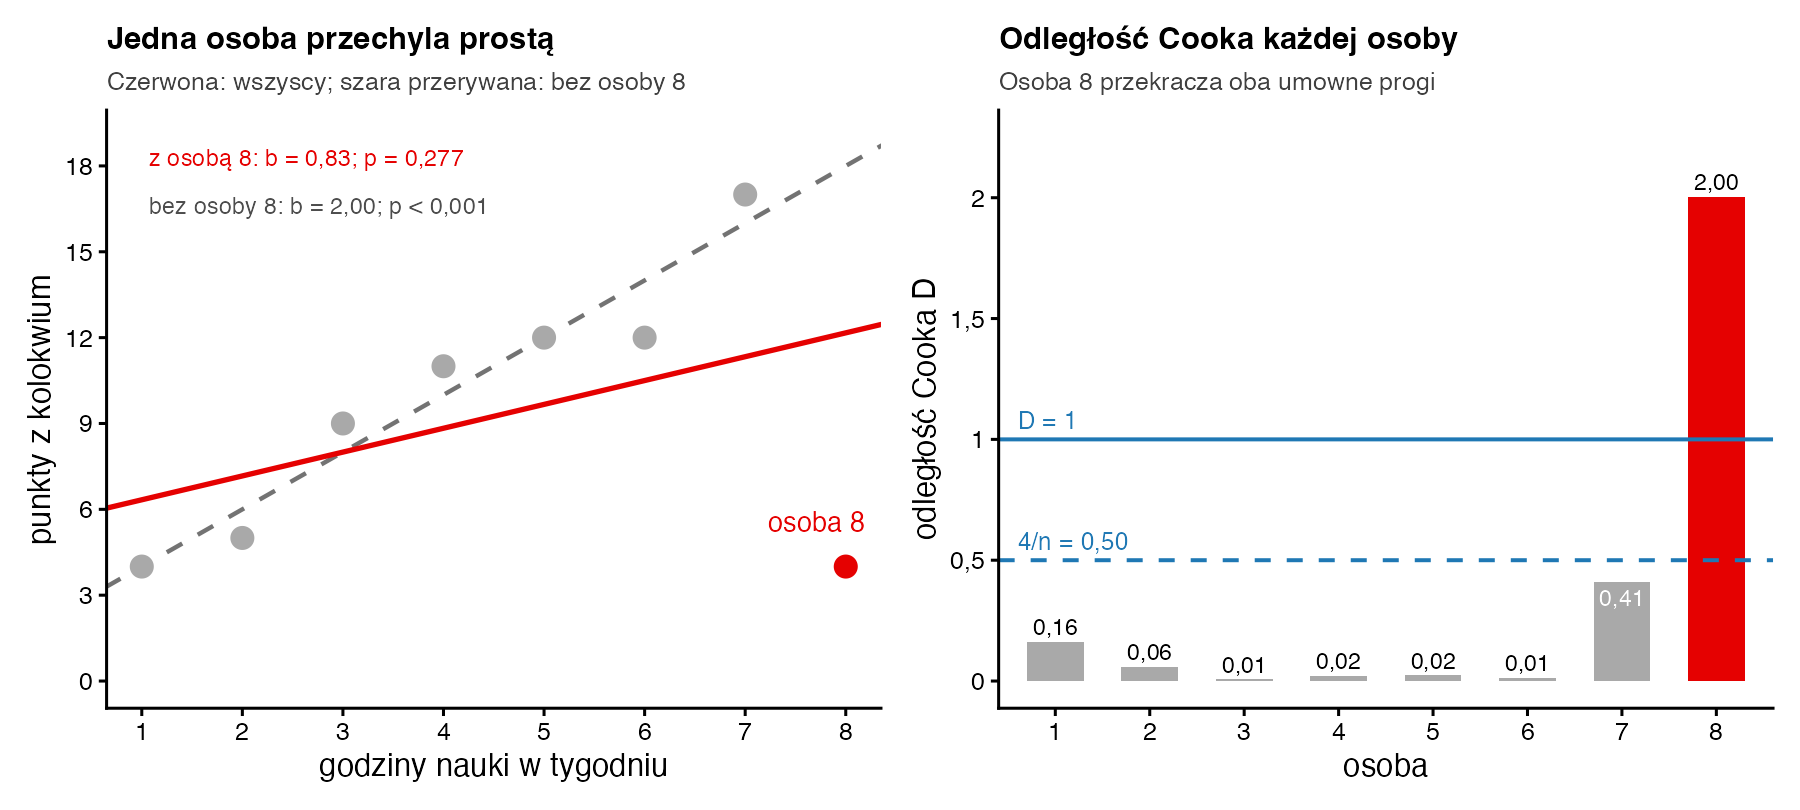
W regresji samo IQR nie wystarczy, bo liczy się para wyników. Ośmiu studentów podało godziny nauki w tygodniu (1–8) i punkty z kolokwium. Osoba 8 uczyła się najdłużej, a zdobyła tylko 4 punkty. Reguła IQR na samych punktach nic nie wykrywa (płoty −6,125 i 22,875), bo 4 punkty miała też osoba 1. Nietypowe jest dopiero połączenie: najdłuższa nauka i jeden z najniższych wyników.
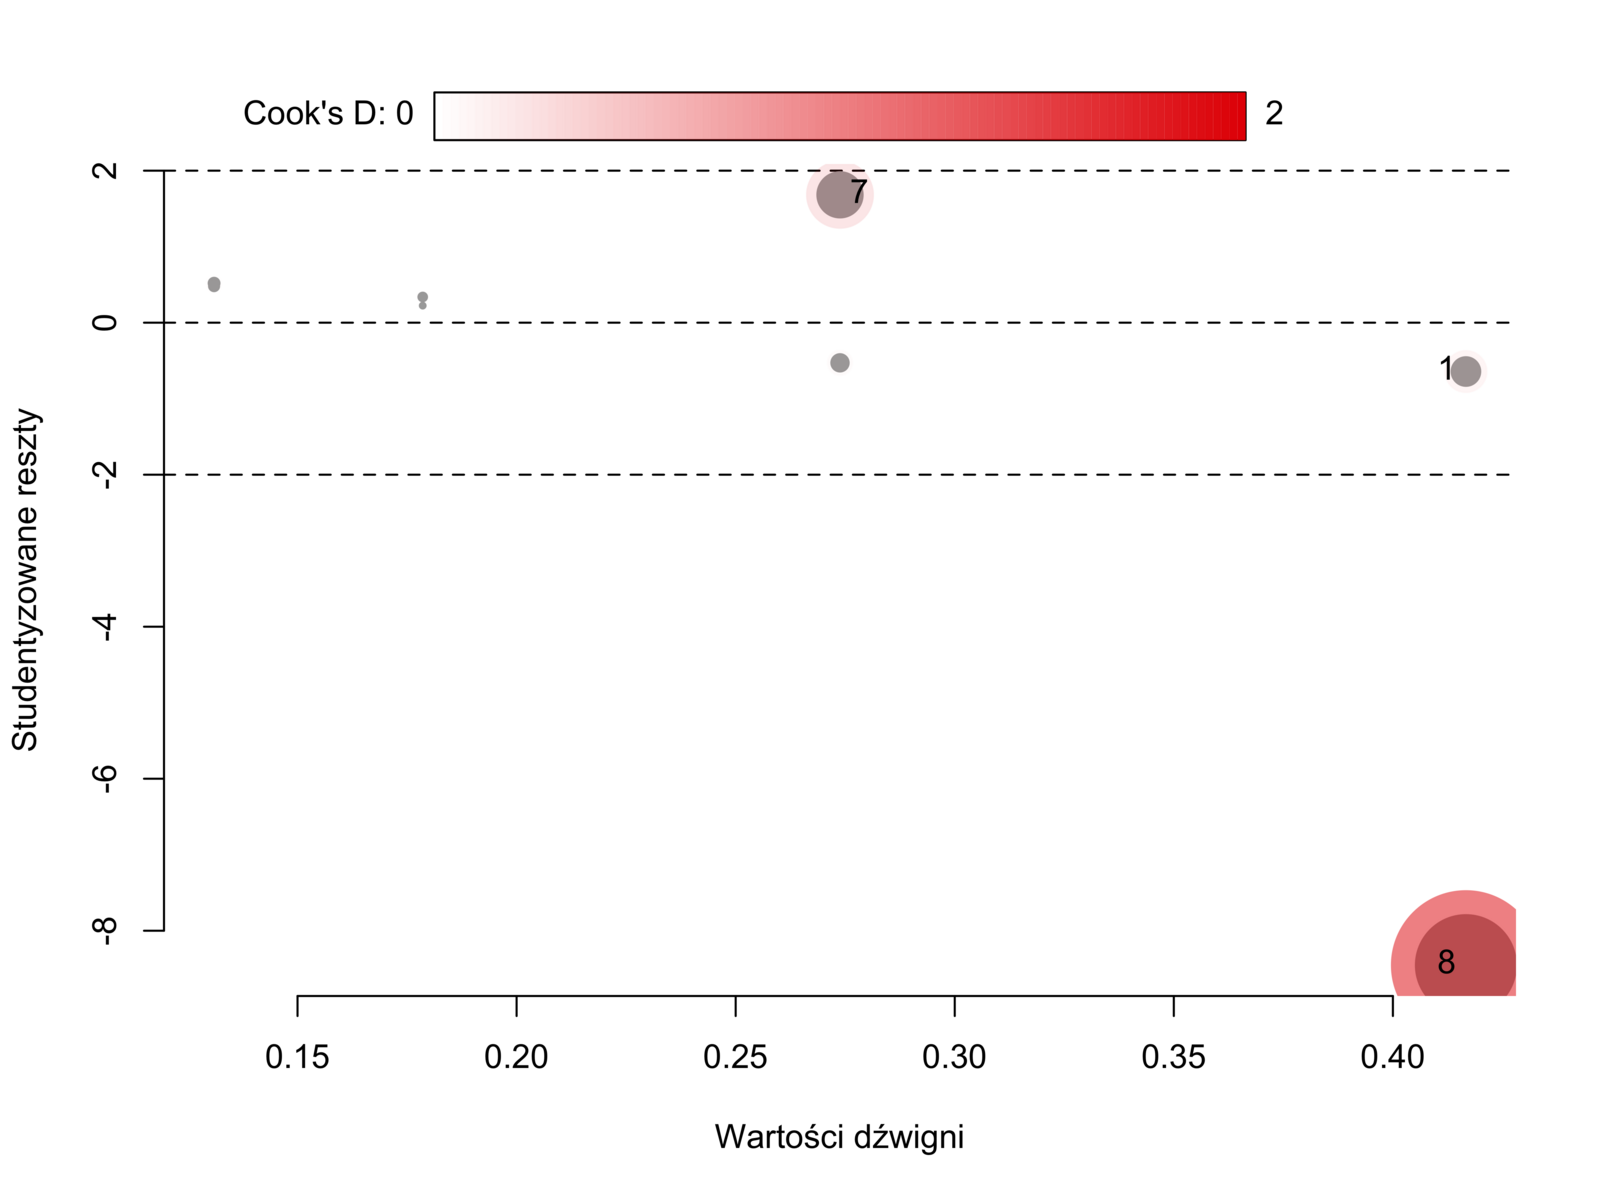
Odległość Cooka (Cook, 1977) mierzy, jak bardzo zmieniłyby się wszystkie przewidywania modelu po usunięciu danej osoby. Łączy dwie rzeczy: dźwignię, czyli nietypowość na osi x, i resztę, czyli odległość od prostej. U osoby 8 dźwignia wynosi 0,42, a reszta studentyzowana −8,45. Razem daje to D = 2,00. To więcej niż oba umowne progi: D > 1 (Cook i Weisberg, 1982) i ostrzejszy 4/n = 0,50. Druga największa wartość to 0,41 (osoba 7).
Krok 3. Co zrobić z obserwacją odstającą?
- Sprawdź, czy to błąd. Porównaj wynik z arkuszem źródłowym, formularzem albo ankietą papierową. Pomyłkę popraw i zapisz to w notatkach z analizy. W naszym przykładzie arkusz potwierdza 4 punkty, więc to nie pomyłka.
- Sprawdź, czy osoba należy do badanej populacji i czy badanie przebiegło u niej tak samo jak u innych. Wykluczenie musi wynikać z kryterium ustalonego niezależnie od wyniku.
- Zrób analizę wrażliwości: policz model z tą osobą i bez niej (Tabela 2).
- Opisz obie wersje i napisz, która jest główna i dlaczego.
| Wariant | n | b | 95% CI dla b | t | p | R² |
|---|---|---|---|---|---|---|
| wszystkie osoby | 8 | 0,83 | [−0,87; 2,54] | 1,20 | 0,277 | 0,19 |
| bez osoby 8 | 7 | 2,00 | [1,39; 2,61] | 8,37 | < 0,001 | 0,93 |
| Wniosek o istotności zależy od jednej osoby – trzeba to napisać w pracy | ||||||
Zapis w stylu APA: W modelu regresji liniowej jedna obserwacja okazała się silnie wpływowa (osoba 8: 8 godzin nauki, 4 punkty; odległość Cooka D = 2,00). Wynik sprawdzono z arkuszem źródłowym; nie był błędem wpisu. Z tą osobą związek godzin nauki z wynikiem kolokwium był nieistotny statystycznie, b = 0,83; 95% CI [−0,87; 2,54]; t(6) = 1,20; p = 0,277; R² = 0,19. Bez niej był dodatni i istotny, b = 2,00; 95% CI [1,39; 2,61]; t(5) = 8,37; p < 0,001; R² = 0,93. Wniosek zależy od jednej obserwacji, dlatego należy go traktować ostrożnie.
Czego nie robić
- Nie usuwaj osób po cichu ani dlatego, że „psują” istotność.
- Nie czyść danych w kółko. Po usunięciu osoby 8 próg 4/n wynosi 4/7 ≈ 0,57 i przekracza go nowa osoba (osoba 6, D = 0,70). Zawsze znajdzie się kolejna „najbardziej wpływowa”.
- Nie stosuj reguły IQR do całej próby naraz, gdy porównujesz grupy.
- Nie zastępuj wyniku średnią bez słowa w pracy. Każda zmiana danych musi być opisana i porównana z wersją surową.
- Nie wnioskuj o przyczynie: nawet bez osoby 8 to badanie korelacyjne, więc nie piszesz, że nauka „powoduje” wyższy wynik.
Cała analiza w R
# Część 1. Reguła 1,5 × IQR w grupie C (punkty z kolokwium, n = 9)
C <- c(7, 8, 8, 9, 9, 10, 10, 12, 17)
q <- quantile(C, c(.25, .75))                       # Q1 = 8, Q3 = 10 (metoda R i Excela)
iqr <- q[[2]] - q[[1]]                              # IQR = 2
c(dolny = q[[1]] - 1.5 * iqr, gorny = q[[2]] + 1.5 * iqr)   # płoty Tukeya: 5 i 13
C[C < q[[1]] - 1.5 * iqr | C > q[[2]] + 1.5 * iqr]   # wynik odstający
quantile(C, c(.25, .75), type = 6)                  # SPSS: Q3 = 11, płot 15,5 – 17 nadal odstaje
round(c(M = mean(C), M_bez_17 = mean(C[C != 17]), Me = median(C), Me_bez_17 = median(C[C != 17])), 2)

# Część 2. Odległość Cooka w regresji: godziny nauki i punkty, n = 8
d <- data.frame(godziny = 1:8, punkty = c(4, 5, 9, 11, 12, 12, 17, 4))
m <- lm(punkty ~ godziny, data = d)
round(data.frame(h = hatvalues(m), r_stud = rstudent(m), D = cooks.distance(m)), 2)
which(cooks.distance(m) > 4 / nrow(d))              # próg 4/n = 0,50
boxplot.stats(d$punkty)$out                         # IQR na samej zmiennej y nic nie wykrywa

# Część 3. Analiza wrażliwości: model z osobą 8 i bez niej
m_bez <- lm(punkty ~ godziny, data = d[-8, ])
wiersz <- function(mod) { s <- summary(mod); ci <- confint(mod)[2, ]
  round(c(n = nobs(mod), b = coef(mod)[[2]], CI_dol = ci[[1]], CI_gora = ci[[2]],
          t = s$coefficients[2, 3], p = s$coefficients[2, 4], R2 = s$r.squared), 3) }
rbind(z_osoba_8 = wiersz(m), bez_osoby_8 = wiersz(m_bez))
round(cooks.distance(m_bez), 2)                     # po usunięciu 8 „wyskakuje” osoba 6
Wynik w konsoli R:
dolny gorny
    5    13
[1] 17
25% 75%
  8  11
        M  M_bez_17        Me Me_bez_17
    10.00      9.12      9.00      9.00
     h r_stud    D
1 0.42  -0.64 0.16
2 0.27  -0.53 0.06
3 0.18   0.22 0.01
4 0.13   0.48 0.02
5 0.13   0.52 0.02
6 0.18   0.34 0.01
7 0.27   1.68 0.41
8 0.42  -8.45 2.00
8
8
numeric(0)
            n     b CI_dol CI_gora     t     p    R2
z_osoba_8   8 0.833 -0.872   2.538 1.196 0.277 0.193
bez_osoby_8 7 2.000  1.386   2.614 8.367 0.000 0.933
   1    2    3    4    5    6    7
0.00 0.18 0.08 0.06 0.00 0.70 0.51
Pytania promotora i recenzenta
Czy mogę usunąć obserwacje odstające z pracy magisterskiej?
Możesz, jeśli masz powód niezależny od wyniku (błąd, osoba spoza populacji, przerwane badanie) i opiszesz go w metodzie. Sam fakt odstawania nie jest powodem. Pokaż wtedy, jak wyglądałyby wyniki bez wykluczenia.
Jaki próg odległości Cooka przyjąć: 1 czy 4/n?
Oba są umowne. D > 1 wskazuje wyraźny wpływ, a 4/n służy raczej do wyłowienia osób, które warto obejrzeć. Podaj w pracy, którego progu użyłeś, i zawsze zestaw go z wykresem. Więcej o wykresach diagnostycznych przeczytasz we wpisie diagnostyka regresji na wykresach.
A może wystarczy wynik z powyżej 3?
Reguła „3 odchylenia standardowe od średniej” sama jest psuta przez osobę odstającą, bo ta zawyża średnią i SD. Leys i współpracownicy (2013) zalecają zamiast niej odchylenie od mediany (MAD). Do tego przy 10 lub mniej osobach w grupie wynik standaryzowany z w ogóle nie może przekroczyć 3 – w grupie C wynik 17 ma z = 2,33.
Bibliografia
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Aguinis, H., Gottfredson, R. K., & Joo, H. (2013). Best-practice recommendations for defining, identifying, and handling outliers. Organizational Research Methods, 16(2), 270–301.
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766.
- Stekhoven, D. J., & Bühlmann, P. (2012). MissForest – non-parametric missing value imputation for mixed-type data. Bioinformatics, 28(1), 112–118. https://doi.org/10.1093/bioinformatics/btr597
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKwartyle i rozstęp międzykwartylowy
- Słownik wzorówOdległość Cooka
- Poradnikprzykladowe-raporty/obserwacje-odstajace-regresja.html
- PoradnikDiagnostyka regresji na wykresach – reszty, Q-Q, VIF
- PoradnikAnaliza statystyczna – co to jest
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.