

Wynik standaryzowany z – wzór, przykład i odczyt z tablic
Wynik z mówi, o ile odchyleń standardowych dany wynik leży powyżej lub poniżej średniej. Przykładowe pytanie z pracy dyplomowej: na którym kolokwium student wypadł lepiej na tle grupy, skoro jedno oceniano w skali 0–20, a drugie 0–100?
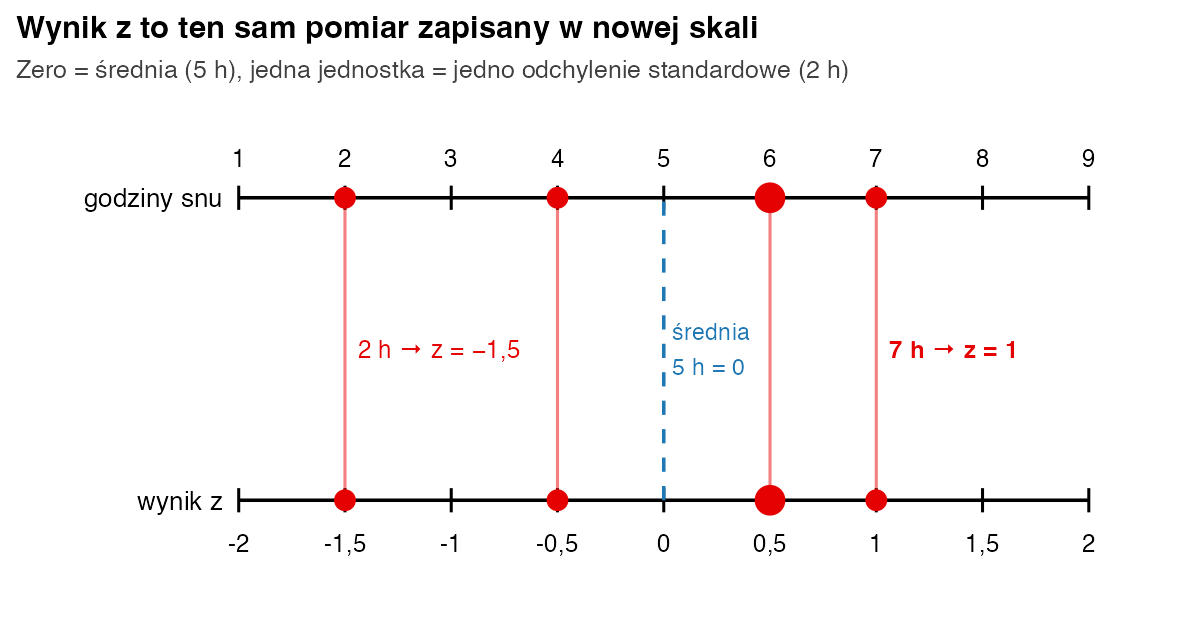
W prostych słowachWynik z przelicza pomiar na wspólną „linijkę”. Zero na tej linijce to średnia grupy. Jedna kreska to jedno odchylenie standardowe. Wynik z = 1 znaczy „o jedno typowe odchylenie lepiej niż przeciętnie”, a z = −1,5 – „półtora typowego odchylenia gorzej niż przeciętnie”. Dzięki temu możesz porównywać wyniki z różnych testów i skal.
Kiedy liczyć wynik z?
- chcesz ocenić położenie jednej osoby na tle grupy (np. czy 7 godzin snu to dużo);
- porównujesz wyniki z różnych skal (kolokwium 0–20 i egzamin 0–100);
- szukasz obserwacji odstających – wyniki z poniżej −3 lub powyżej 3 są bardzo nietypowe;
- chcesz odczytać z tablic rozkładu normalnego, jaki odsetek osób ma wynik niższy.
Ten sam pomysł pojawia się w wielu miejscach statystyki: w resztach standaryzowanych regresji, w testach z i w obliczaniu wartości p. Do wyniku z potrzebujesz tylko średniej i odchylenia standardowego.
Wzór na wynik standaryzowany z
- \(z_i\)
- wynik standaryzowany i-tej osoby – liczba bez jednostek (nie ma już „godzin” ani „punktów”)
- \(x_i\)
- surowy wynik tej osoby, np. 7 godzin snu
- \(\bar{x}\)
- średnia arytmetyczna grupy
- \(x_i - \bar{x}\)
- odchylenie: o ile wynik jest wyższy (plus) lub niższy (minus) od średniej
- \(s\)
- odchylenie standardowe grupy – „typowa” odległość wyników od średniej
Na głos wzór czytamy tak: „z to wynik minus średnia, podzielone przez odchylenie standardowe”.
Przykład krok po kroku
Pięcioro studentów spało przed kolokwium 6, 2, 7, 4 i 6 godzin. Średnia wynosi 5 h, a odchylenie standardowe 2 h (obliczenia znajdziesz w haśle o wariancji). Ile wynosi z dla osoby, która spała 7 godzin? A dla pozostałych?
| Osoba | Sen x (h) | Odchylenie x − 5 | Dzielenie przez s = 2 | Wynik z |
|---|---|---|---|---|
| 1 | 6 | 6 − 5 = 1 | 1 / 2 | 0,5 |
| 2 | 2 | 2 − 5 = −3 | −3 / 2 | −1,5 |
| 3 | 7 | 7 − 5 = 2 | 2 / 2 | 1,0 |
| 4 | 4 | 4 − 5 = −1 | −1 / 2 | −0,5 |
| 5 | 6 | 6 − 5 = 1 | 1 / 2 | 0,5 |
| Σ | 25 | 0 | – | 0 |
- Średnia. 6 + 2 + 7 + 4 + 6 = 25, a 25 / 5 = 5 godzin.
- Odchylenie standardowe. Suma kwadratów odchyleń to 1 + 9 + 4 + 1 + 1 = 16. Wariancja: 16 / 4 = 4. Odchylenie standardowe: \(\sqrt{4} = 2\) godziny.
- Odchylenie od średniej. Dla osoby z 7 godzinami: 7 − 5 = 2 godziny więcej niż przeciętnie.
- Dzielenie przez s. 2 / 2 = 1. Ta osoba spała o jedno odchylenie standardowe dłużej niż średnio: z = 1,00.
- Sprawdzenie. Wyniki z całej grupy sumują się do 0 (0,5 − 1,5 + 1 − 0,5 + 0,5 = 0). Ich średnia zawsze wynosi 0, a odchylenie standardowe 1.
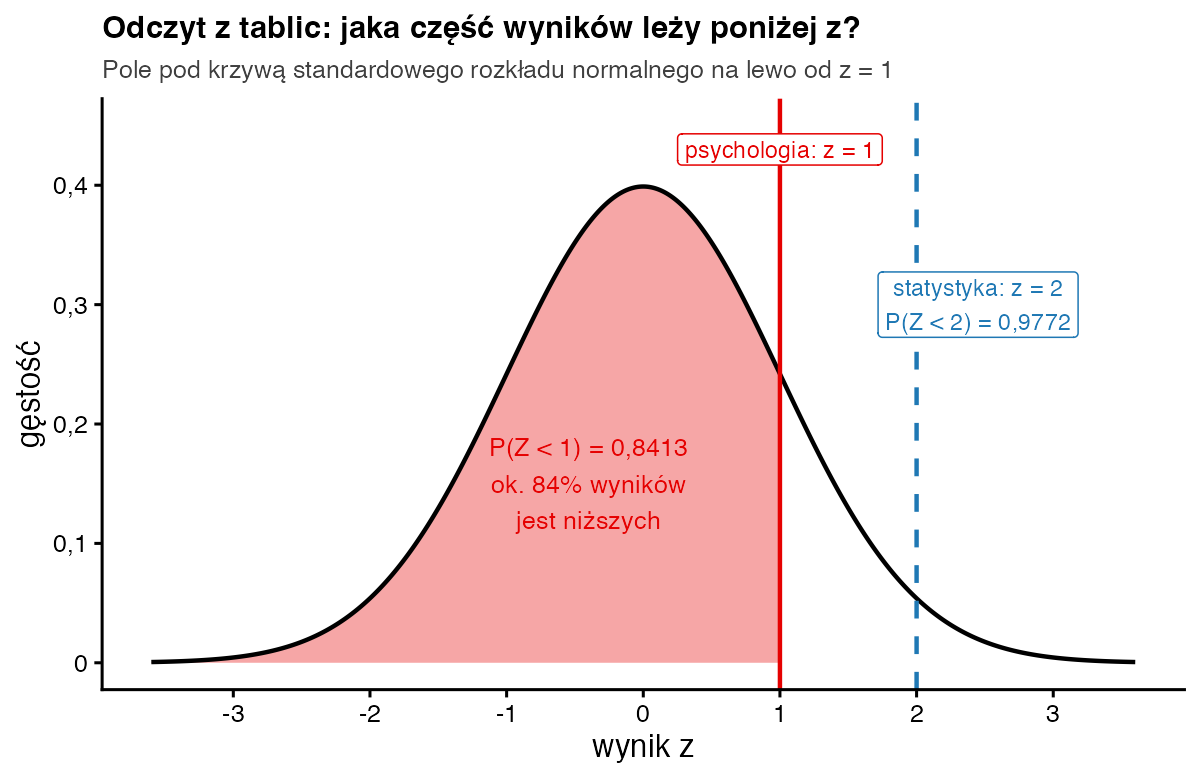
- Odczyt z tablic. W tablicy standardowego rozkładu normalnego znajdź wiersz 1,0 i kolumnę 0,00. Odczytasz 0,8413. Jeśli sen ma rozkład normalny, około 84% studentów śpi krócej niż 7 godzin. W R tę samą liczbę daje
pnorm(1), a odwrotną operację –qnorm(0.8413).
Przy pięciu osobach to oczywiście tylko ilustracja. Odczyt odsetka z tablic ma sens wtedy, gdy rozkład wyników jest w przybliżeniu normalny.
Porównanie wyników z dwóch kolokwiów
Na kolokwium ze statystyki (skala 0–20) zdobyłeś 18 punktów, przy średniej grupy 14 i odchyleniu standardowym 2. Na kolokwium z psychologii (skala 0–100) zdobyłeś 60 punktów, przy średniej 50 i odchyleniu 10. Surowo 60 wygląda lepiej niż 18, ale skale są różne. Liczysz więc wyniki z:
- statystyka: (18 − 14) / 2 = 4 / 2 = 2,00 – wynik wyższy niż u około 97,7% grupy (tablice: 0,9772);
- psychologia: (60 − 50) / 10 = 10 / 10 = 1,00 – wynik wyższy niż u około 84,1% grupy (tablice: 0,8413).
Na tle swojej grupy lepiej wypadłeś ze statystyki, choć surowa liczba punktów była mniejsza.
Jak zinterpretować i opisać wynik?
Znak z mówi o kierunku (powyżej lub poniżej średniej), a wartość – o odległości w odchyleniach standardowych. Wyniki między −1 a 1 są typowe. Wyniki poza ±2 zdarzają się rzadko (w rozkładzie normalnym u około 5% osób), a poza ±3 – bardzo rzadko i warto je sprawdzić jako możliwe obserwacje odstające. Pamiętaj, że wynik z opisuje położenie względem tej konkretnej grupy. W innej grupie te same 7 godzin może dać zupełnie inne z.
Zapis w stylu APA: Osoba, która spała 7 godzin, uzyskała wynik o jedno odchylenie standardowe wyższy od średniej grupy (M = 5,00; SD = 2,00), z = 1,00.
Jak policzyć wynik z w R?
sen <- c(6, 2, 7, 4, 6)                 # godziny snu przed kolokwium

# 1) „ręcznie”, krok po kroku
M <- mean(sen)                          # 5
s <- sd(sen)                            # 2
z <- (sen - M) / s
z                                       # 0.5 -1.5 1.0 -0.5 0.5
c(mean(z), sd(z))                       # wyniki z mają średnią 0 i SD 1

# 2) gotowa funkcja scale() – te same wartości
all.equal(as.vector(scale(sen)), z)

# 3) tablice rozkładu normalnego w R
pnorm(1)                                # P(Z < 1) = 0.8413
qnorm(0.8413)                           # i z powrotem: z ≈ 1

# 4) dwa kolokwia o różnych skalach
(18 - 14) / 2                           # statystyka: z = 2
(60 - 50) / 10                          # psychologia: z = 1
pnorm(c(2, 1))                          # odsetek niższych wyników
Wynik w konsoli R:
> z
[1]  0.5 -1.5  1.0 -0.5  0.5
> c(mean(z), sd(z))
[1] 0 1
> all.equal(as.vector(scale(sen)), z)
[1] TRUE
> pnorm(1)
[1] 0.8413447
> qnorm(0.8413)
[1] 0.9998151
> (18 - 14)/2
[1] 2
> (60 - 50)/10
[1] 1
> pnorm(c(2, 1))
[1] 0.9772499 0.8413447
Funkcja scale() zwraca macierz, dlatego w kodzie zamieniamy ją na zwykły wektor przez as.vector(). Używa odchylenia standardowego z próby (dzielenie przez n − 1), tak jak sd(). SPSS zapisuje wyniki z jako nowe zmienne z literą Z na początku nazwy i liczy je tak samo.
Czy standaryzacja zmienia rozkład na normalny?
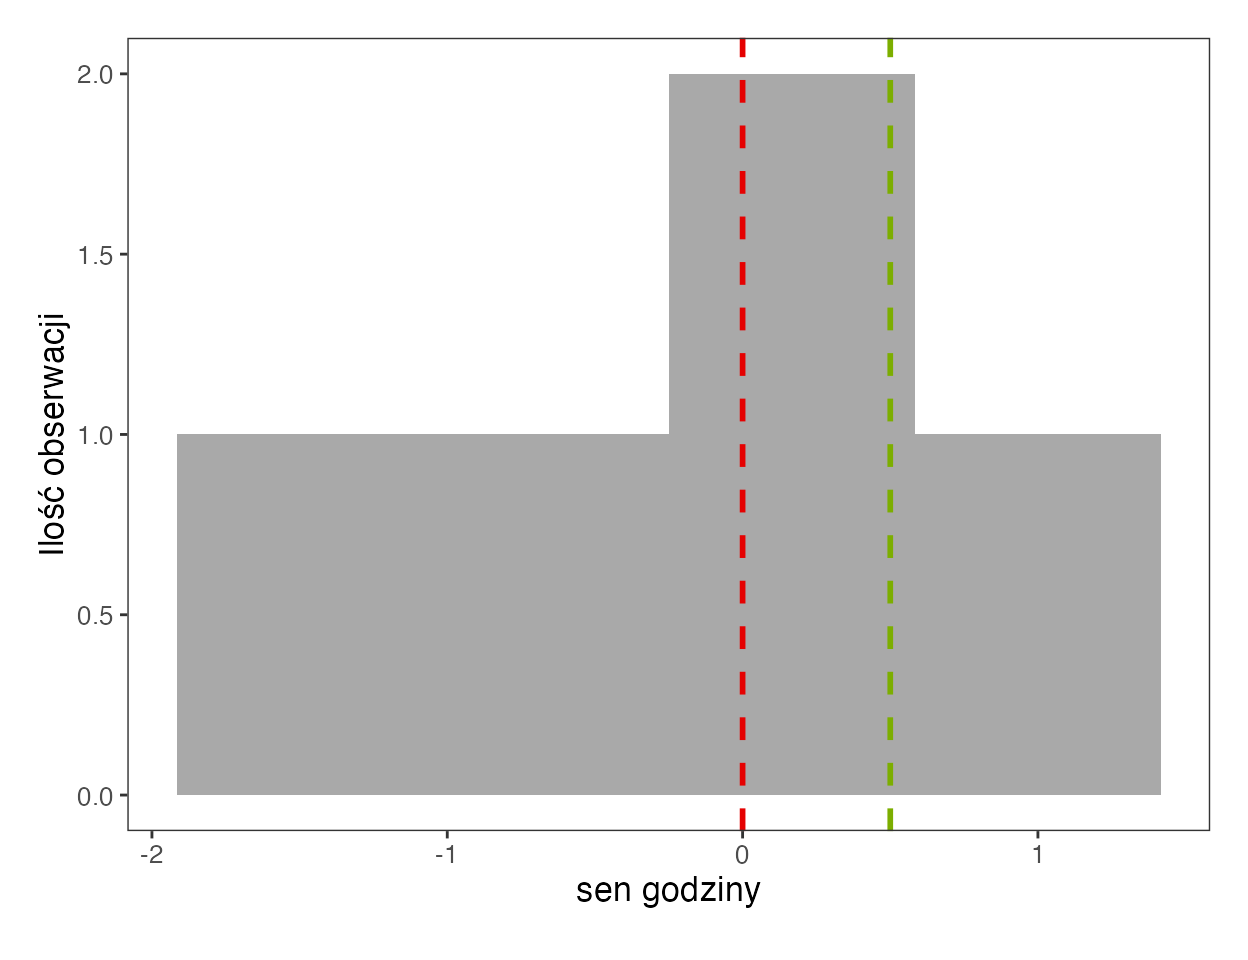
Nie. To jedno z najczęstszych nieporozumień. Standaryzacja tylko przesuwa i rozciąga skalę, więc kształt rozkładu zostaje dokładnie ten sam (zobacz Rys. 3). Rozkład skośny po standaryzacji nadal jest skośny. Jeśli rozkład nie jest normalny, odsetki z tablic mogą być mylące. Wtedy zamiast nich podaj rangę procentową, czyli policz wprost, jaki odsetek osób w próbie ma niższy wynik.
Najczęstsze błędy
- Przekonanie, że standaryzacja „normalizuje” rozkład – kształt się nie zmienia.
- Dzielenie przez wariancję zamiast przez odchylenie standardowe.
- Odczytywanie odsetków z tablic rozkładu normalnego dla danych wyraźnie skośnych.
- Porównywanie wyników z policzonych względem różnych grup tak, jakby odnosiły się do tej samej grupy.
- Mylenie P(Z < z) z P(Z > z) – tablice zwykle podają pole na lewo od z; pole na prawo to 1 minus ta wartość.
Bibliografia
- Bedyńska, S., & Cypryańska, M. (Red.). (2013). Statystyczny drogowskaz 1. Praktyczne wprowadzenie do wnioskowania statystycznego. Wydawnictwo Akademickie Sedno.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRozkład normalny
- Słownik wzorówOdchylenie standardowe
- Słownik wzorówReszty standaryzowane
- Słownik wzorówIstotność statystyczna i wartość p
- Słownik wzorówPercentyle i centyle
- PoradnikStatystyka opisowa – przykład
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.