

Wykres raincloud i violin – jak pokazać różnice między grupami
Wykres słupkowy ze średnią to najczęstszy rysunek w pracach dyplomowych i jednocześnie ten, który ukrywa najwięcej. Na jednym zbiorze trzech grup pokazujemy, co widać na słupkach, a co dopiero na wykresie pudełkowym, skrzypcowym (violin) i raincloud – i jak taki rysunek podpisać w pracy.
W skrócieTrzy grupy mają identyczną średnią i identyczne odchylenie standardowe, więc słupki są takie same. Rozkłady są jednak zupełnie różne: jeden symetryczny, drugi z dwiema „górkami”, trzeci skośny z jedną osobą odstającą. Widać to dopiero na wykresie, który pokazuje kształt rozkładu i pojedyncze osoby. Więcej o rodzajach wykresów przeczytasz we wpisie prezentacja danych statystycznych.
Krok 1. Dane: trzy grupy ćwiczeniowe po 9 osób
Pytanie z pracy: czy wyniki kolokwium (0–20 punktów) różnią się między trzema grupami ćwiczeniowymi? Hipoteza zerowa mówi, że średnie w populacji są równe. Zanim policzysz jakikolwiek test, zrób opis i rysunek. Tabela pokazuje surowe wyniki i statystyki, które zwykle trafiają do pracy.
| Grupa | Wyniki | M | SD | SE | Me | Q1–Q3 | min–max |
|---|---|---|---|---|---|---|---|
| A | 6, 6, 8, 10, 10, 10, 12, 14, 14 | 10,00 | 3,00 | 1,00 | 10 | 8–12 | 6–14 |
| B | 6, 6, 8, 8, 12, 12, 12, 12, 14 | 10,00 | 3,00 | 1,00 | 12 | 8–12 | 6–14 |
| C | 7, 8, 8, 9, 9, 10, 10, 12, 17 | 10,00 | 3,00 | 1,00 | 9 | 8–10 | 7–17 |
| Średnie, odchylenia i błędy standardowe są identyczne; mediany i kwartyle już nie | |||||||
Same liczby coś podpowiadają: w grupie B mediana (12) jest wyraźnie wyżej niż średnia, a w grupie C rozstęp sięga 17 punktów, choć trzy czwarte osób ma najwyżej 10. Na rysunku widać to od razu.
Krok 2. Słupek ze średnią – co pokazuje, a czego nie
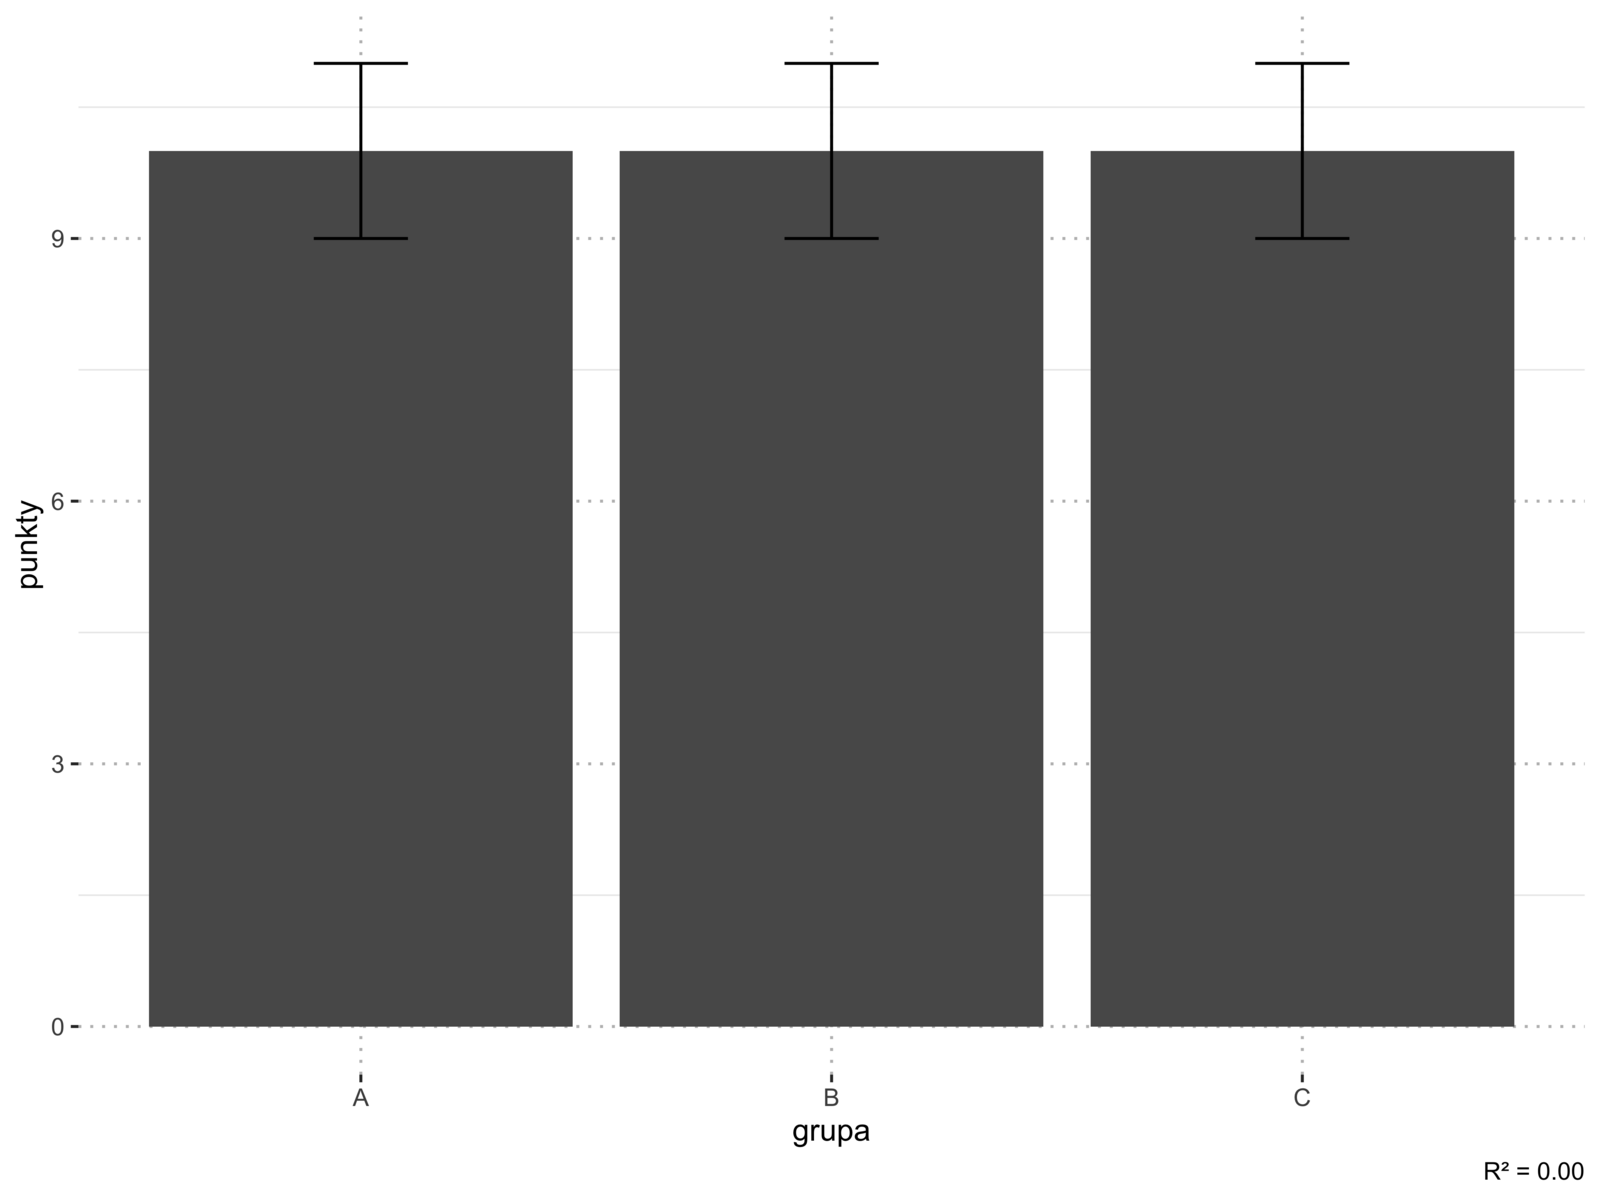
Słupek pokazuje jedną liczbę na grupę i jej niepewność. Nie pokazuje, ile osób było w grupie, jak rozkładają się wyniki ani czy ktoś odstaje. Dlatego Weissgerber i współpracownicy (2015) zalecają, by przy małych próbach zamiast słupków pokazywać pojedyncze obserwacje. Słupki zostaw dla liczebności i procentów, gdzie wysokość słupka naprawdę coś znaczy.
Krok 3. Te same dane na wykresie pudełkowym, skrzypcowym i raincloud
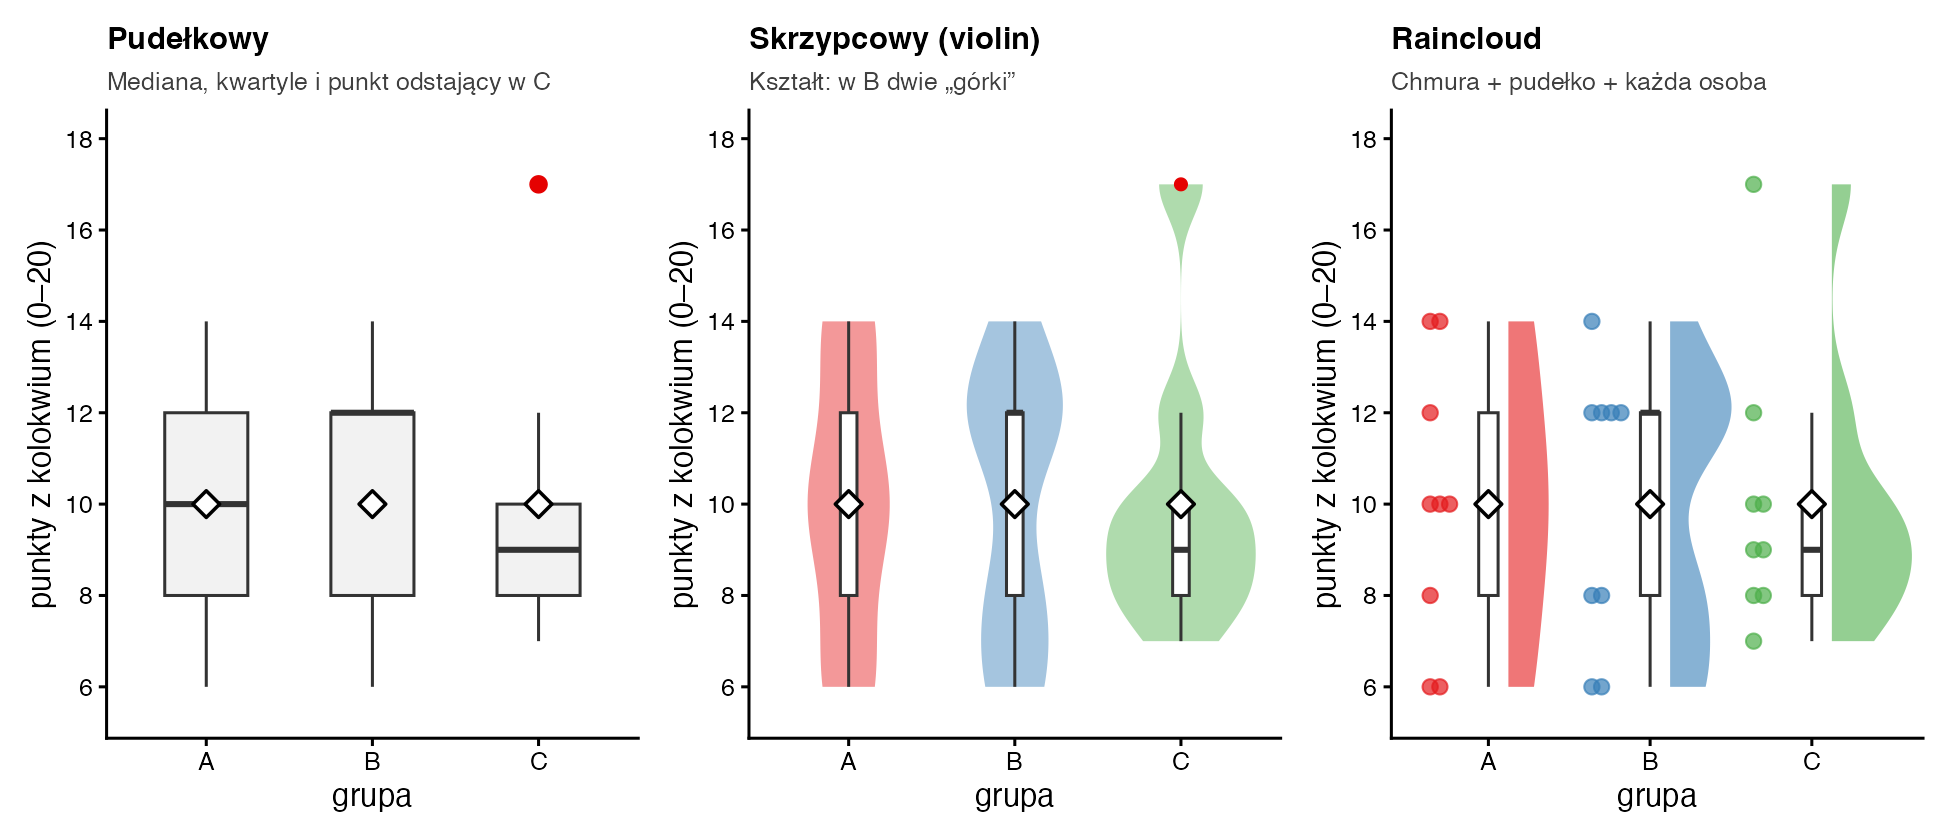
- Wykres pudełkowy pokazuje medianę, kwartyle i rozstęp międzykwartylowy oraz punkty odstające według reguły 1,5 × IQR. W grupie C pudełko jest wąskie (8–10), a wynik 17 leży poza górnym „płotem” 10 + 1,5 · 2 = 13, więc program rysuje go osobno. W grupie B mediana leży na górnej krawędzi pudełka – to sygnał, że coś jest nie tak, ale pudełko nie powie, co.
- Wykres skrzypcowy (violin) to gładka krzywa gęstości odbita lustrzanie (Hintze i Nelson, 1998). W grupie B ma wcięcie w środku i dwie wypukłości: część osób zdobyła 6–8 punktów, część 12–14, a nikt nie ma wyniku pośredniego. Średnia 10 opisuje tu wynik, którego nie uzyskała żadna osoba.
- Wykres raincloud (Allen i in., 2019) łączy połowę skrzypiec („chmura”), małe pudełko i surowe dane („deszcz”). Przy 9 osobach w grupie to najuczciwsza forma: czytelnik widzi kształt, podsumowanie i to, na ilu osobach opiera się każda górka.
Krok 4. Testy też nie zobaczą różnicy kształtu
Jednoczynnikowa analiza wariancji porównuje średnie, więc daje F(2, 24) = 0,00; p = 1,000. Test Kruskala-Wallisa porównuje rangi: H(2) = 0,06; p = 0,973. Test Levene’a nie widzi różnic w rozrzucie: F(2, 24) = 0,13; p = 0,879. Nawet test Shapiro-Wilka w grupie B daje p = 0,077, czyli brak podstaw do odrzucenia normalności, choć rozkład ma dwie górki. Przy 9 osobach testy mają małą moc, dlatego normalność sprawdzaj także na wykresie. Brak istotnej różnicy średnich nie znaczy, że grupy są takie same.
Krok 5. Wykres do pracy i opis wyniku
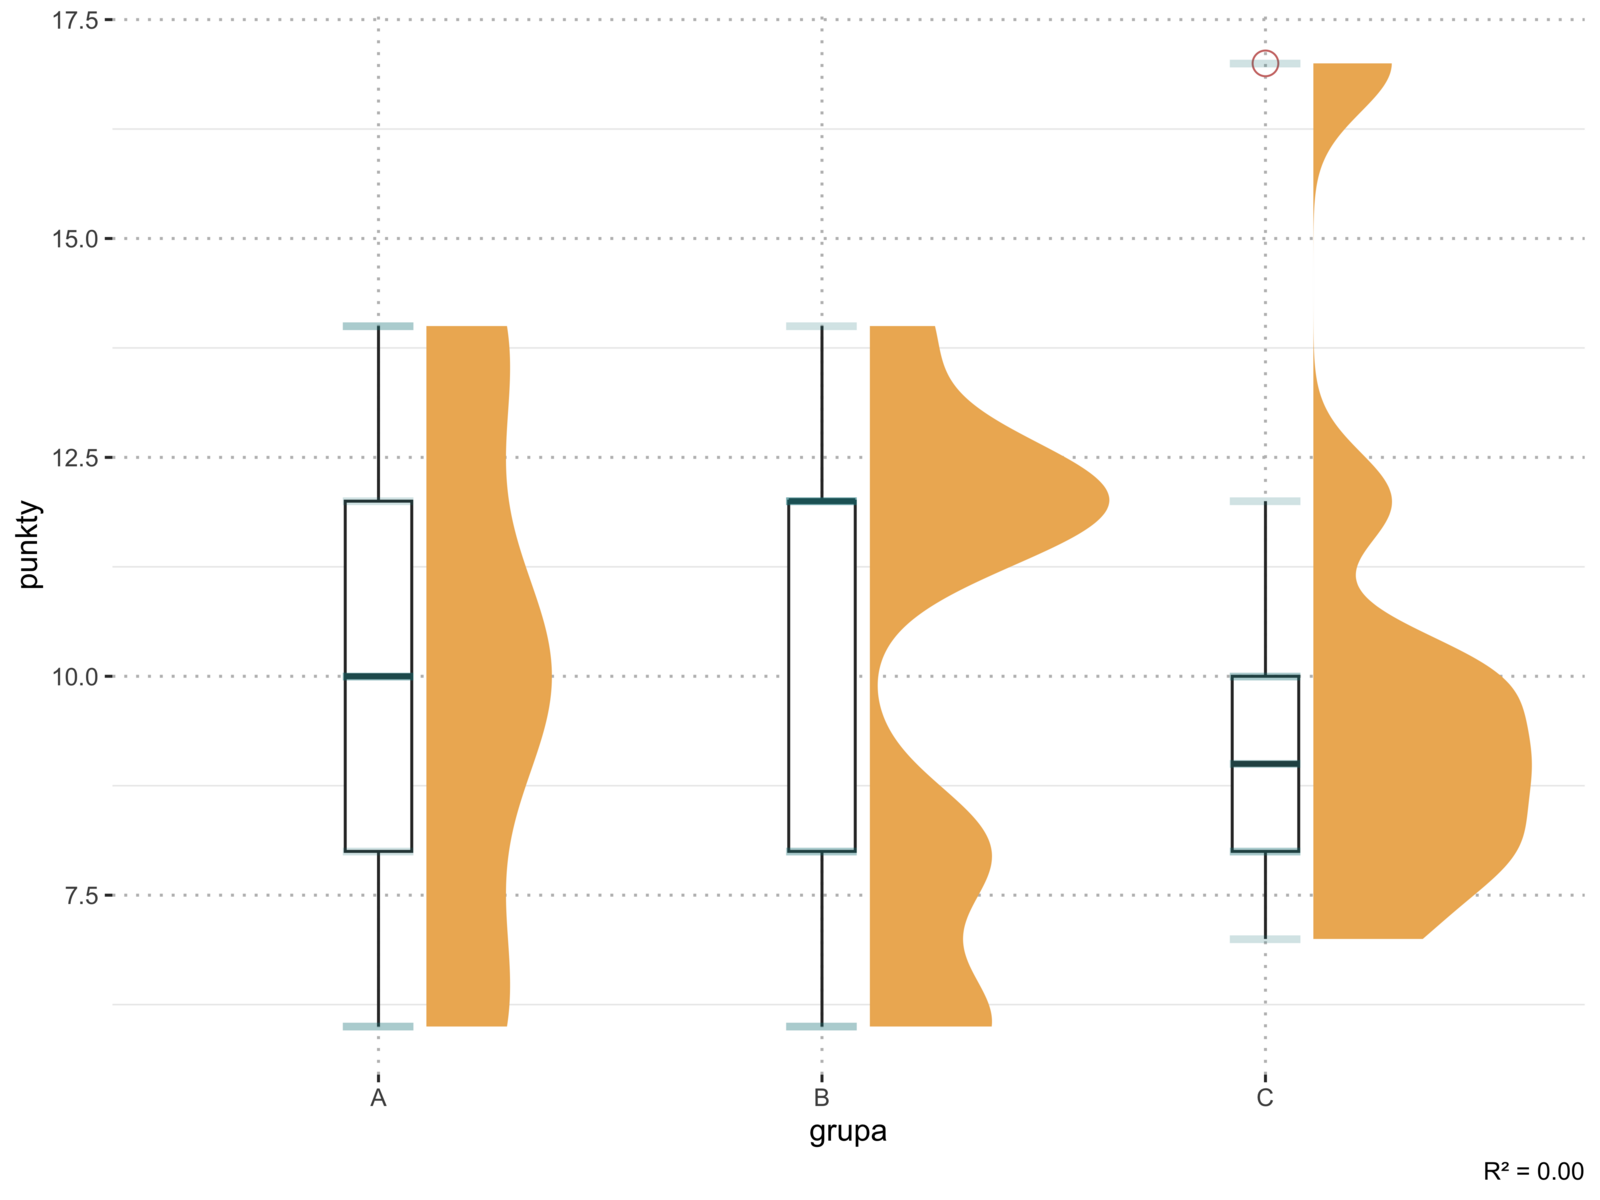
Zapis w stylu APA: Średnie wyniki kolokwium były jednakowe we wszystkich trzech grupach (M = 10,00; SD = 3,00), F(2, 24) = 0,00; p = 1,000. Rozkłady różniły się jednak kształtem (Rysunek 3): w grupie A był symetryczny (Me = 10), w grupie B dwumodalny – wyniki skupiały się wokół 6–8 i 12–14 punktów (Me = 12), a w grupie C prawostronnie skośny z jedną obserwacją odstającą (17 punktów; Me = 9).
Jak podpisać rysunek w pracy?
Najpierw sprawdź wytyczne swojej uczelni – one mają pierwszeństwo. Jeśli obowiązuje styl APA 7 (American Psychological Association, 2020), nad rysunkiem piszesz pogrubiony numer („Rysunek 3”), w kolejnym wierszu tytuł kursywą, a pod rysunkiem notę zaczynającą się od słowa „Nota.” kursywą. W nocie wyjaśnij każdy element wykresu i podaj liczebności. Przykład noty: „Nota. Kreski – wyniki poszczególnych osób; pudełko – mediana i kwartyle; zacieniony obszar – rozkład gęstości; kółko – obserwacja odstająca według reguły 1,5 × IQR; n = 9 w każdej grupie”. W tekście zawsze odwołaj się do rysunku i napisz, co z niego wynika. Więcej gotowych zdań znajdziesz we wpisie opis wyników w stylu APA 7.
| Wykres | Co pokazuje | Kiedy wybrać | Uwaga |
|---|---|---|---|
| Słupkowy ze średnią | średnią i SE albo 95% CI | liczebności, procenty | ukrywa kształt i liczbę osób |
| Pudełkowy | medianę, kwartyle, punkty odstające | wiele grup, duże próby | nie pokazuje dwóch górek |
| Skrzypcowy (violin) | kształt rozkładu | od kilkudziesięciu osób w grupie | przy małym n krzywa bywa myląca |
| Raincloud | kształt, podsumowanie i każdą osobę | małe i średnie próby, praca dyplomowa | zajmuje więcej miejsca |
Cała analiza w R
library(ggplot2)
# Dane: punkty z kolokwium (0–20) w trzech grupach ćwiczeniowych po 9 osób
d <- data.frame(grupa  = factor(rep(c("A", "B", "C"), each = 9)),
                punkty = c(6, 6, 8, 10, 10, 10, 12, 14, 14,     # A
                           6, 6, 8, 8, 12, 12, 12, 12, 14,      # B
                           7, 8, 8, 9, 9, 10, 10, 12, 17))      # C

# 1) to, co pokazuje wykres słupkowy: M, SD i błąd standardowy
opis <- function(x) c(M = mean(x), SD = sd(x), SE = sd(x) / sqrt(length(x)),
                      Me = median(x), Q1 = quantile(x, .25, names = FALSE),
                      Q3 = quantile(x, .75, names = FALSE), min = min(x), max = max(x))
round(t(sapply(split(d$punkty, d$grupa), opis)), 2)

# 2) testy różnic: średnie, rangi, rozrzut – żaden nie widzi różnicy kształtu
summary(aov(punkty ~ grupa, data = d))
kruskal.test(punkty ~ grupa, data = d)$p.value
car::leveneTest(punkty ~ grupa, data = d)
sapply(split(d$punkty, d$grupa), function(x) round(shapiro.test(x)$p.value, 3))
boxplot.stats(d$punkty[d$grupa == "C"])$out           # punkt odstający (reguła 1,5 × IQR)

# 3) wykres raincloud: chmura (gęstość) + pudełko + każda osoba
p <- ggplot(d, aes(grupa, punkty)) +
  ggdist::stat_halfeye(adjust = .8, width = .55, justification = -.25, .width = 0) +
  geom_boxplot(width = .12, outlier.shape = NA) +
  geom_jitter(width = .05, height = 0, alpha = .6) +
  stat_summary(fun = mean, geom = "point", shape = 23, size = 3, fill = "white") +
  labs(x = "grupa", y = "punkty z kolokwium (0–20)") + theme_classic()
ggsave("raincloud.png", p, width = 8, height = 5, dpi = 300)
Wynik w konsoli R:
   M SD SE Me Q1 Q3 min max
A 10  3  1 10  8 12   6  14
B 10  3  1 12  8 12   6  14
C 10  3  1  9  8 10   7  17
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        2      0       0       0      1
Residuals   24    216       9
[1] 0.9727232
Levene's Test for Homogeneity of Variance (center = median)
      Df F value Pr(>F)
group  2  0.1293 0.8794
      24
    A     B     C
0.319 0.077 0.033
[1] 17
Checklista przed wklejeniem wykresu
- Czy widać pojedyncze osoby albo przynajmniej kształt rozkładu, a nie tylko średnią?
- Czy w nocie jest wyjaśnione, co oznaczają wąsy, pudełko, kropki i chmura?
- Czy oś pionowa ma nazwę zmiennej, jednostkę i przecinek dziesiętny?
- Czy wszystkie grupy mają tę samą skalę osi?
- Czy w tekście jest odwołanie do rysunku i jedno zdanie o tym, co z niego wynika?
Pytania promotora i recenzenta
Raincloud czy violin – co wybrać?
Przy kilkunastu osobach w grupie wybierz raincloud, bo krzywa gęstości z tak małej próby może pokazać górkę, której nie ma. Kropki pozwalają to sprawdzić. Przy setkach osób kropki się zlewają i wystarczy wykres skrzypcowy z pudełkiem w środku.
Czy wykres słupkowy jest błędem?
Nie, jeśli pokazujesz liczebności albo procenty. Przy średnich wyników zawsze dodaj w nocie, czy wąsy to SD, SE czy 95% CI, bo dają różne wrażenie.
Co zrobić z osobą odstającą w grupie C?
Nie usuwaj jej po cichu. Sprawdź, czy to nie pomyłka we wpisywaniu, i porównaj wyniki z tą osobą i bez niej. Krok po kroku opisujemy to we wpisie obserwacje odstające – reguła IQR i odległość Cooka, a tak wygląda przykładowy raport SZTOS z obserwacjami odstającymi w grupach.
Bibliografia
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63.
- Hintze, J. L., & Nelson, R. D. (1998). Violin plots: A box plot-density trace synergism. The American Statistician, 52(2), 181–184.
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLoS Biology, 13(4), e1002128. https://doi.org/10.1371/journal.pbio.1002128
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikPrezentacja danych – tabele i wykresy
- Poradnikprzykladowe-raporty/obserwacje-odstajace-porownania-grup.html
- Słownik wzorówKwartyle i rozstęp międzykwartylowy
- PoradnikObserwacje odstające – reguła IQR i odległość Cooka
- PoradnikAnaliza statystyczna – co to jest
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.