

Test McNemara – wzór i przykład krok po kroku
Test McNemara sprawdza, czy odsetek odpowiedzi „tak” zmienił się, gdy te same osoby badasz dwa razy, a wynik ma tylko dwie wartości. Typowe pytanie z pracy dyplomowej: czy po warsztatach więcej studentów zalicza kolokwium niż przed nimi?
W prostych słowachOsoby, które za pierwszym i za drugim razem miały ten sam wynik, nic nie mówią o zmianie. Test McNemara patrzy więc tylko na tych, którzy zmienili zdanie albo wynik. Jeśli zmiany nie ma, to poprawa i pogorszenie powinny zdarzać się mniej więcej równie często – jak orzeł i reszka. Im bardziej jedna strona przeważa, tym mniejsze p.
Kiedy stosować test McNemara?
- masz pomiar przed i po (albo dwa pomiary tych samych osób) – to są próby zależne;
- wynik jest dwuwartościowy: zaliczył/nie zaliczył, tak/nie, objaw jest/nie ma;
- chcesz porównać dwa odsetki z tej samej grupy osób, np. odsetek zaliczeń przed i po zajęciach.
Gdy grupy to różne osoby, użyj testu chi-kwadrat albo, przy małych liczebnościach, dokładnego testu Fishera. Gdy wynik przed i po jest liczbą (np. punkty), wybierz test t dla prób zależnych albo test Wilcoxona.
Wzór na statystykę McNemara
- \(b\)
- liczba osób, które zmieniły wynik w jedną stronę – u nas: przed warsztatami nie zaliczyły, po warsztatach zaliczyły (poprawa)
- \(c\)
- liczba osób, które zmieniły wynik w drugą stronę – przed zaliczyły, po nie zaliczyły (pogorszenie)
- \(b + c\)
- wszystkie pary niezgodne, czyli osoby, którym wynik się zmienił
- \(|b - c|\)
- wartość bezwzględna różnicy – zawsze dodatnia
- \(-1\)
- poprawka ciągłości (Edwards, 1948): trochę zmniejsza statystykę, bo liczebności są całkowite, a rozkład χ² – ciągły
- \(\chi^2,\ df\)
- statystyka testu i jej liczba stopni swobody; p odczytujesz z rozkładu chi-kwadrat z 1 stopniem swobody
Jak przeczytać ten wzór na głos: „kwadrat różnicy między liczbą poprawień a liczbą pogorszeń, podzielony przez liczbę wszystkich zmian”. Osoby bez zmiany (komórki a i d) w ogóle nie wchodzą do wzoru.
Przykład krok po kroku
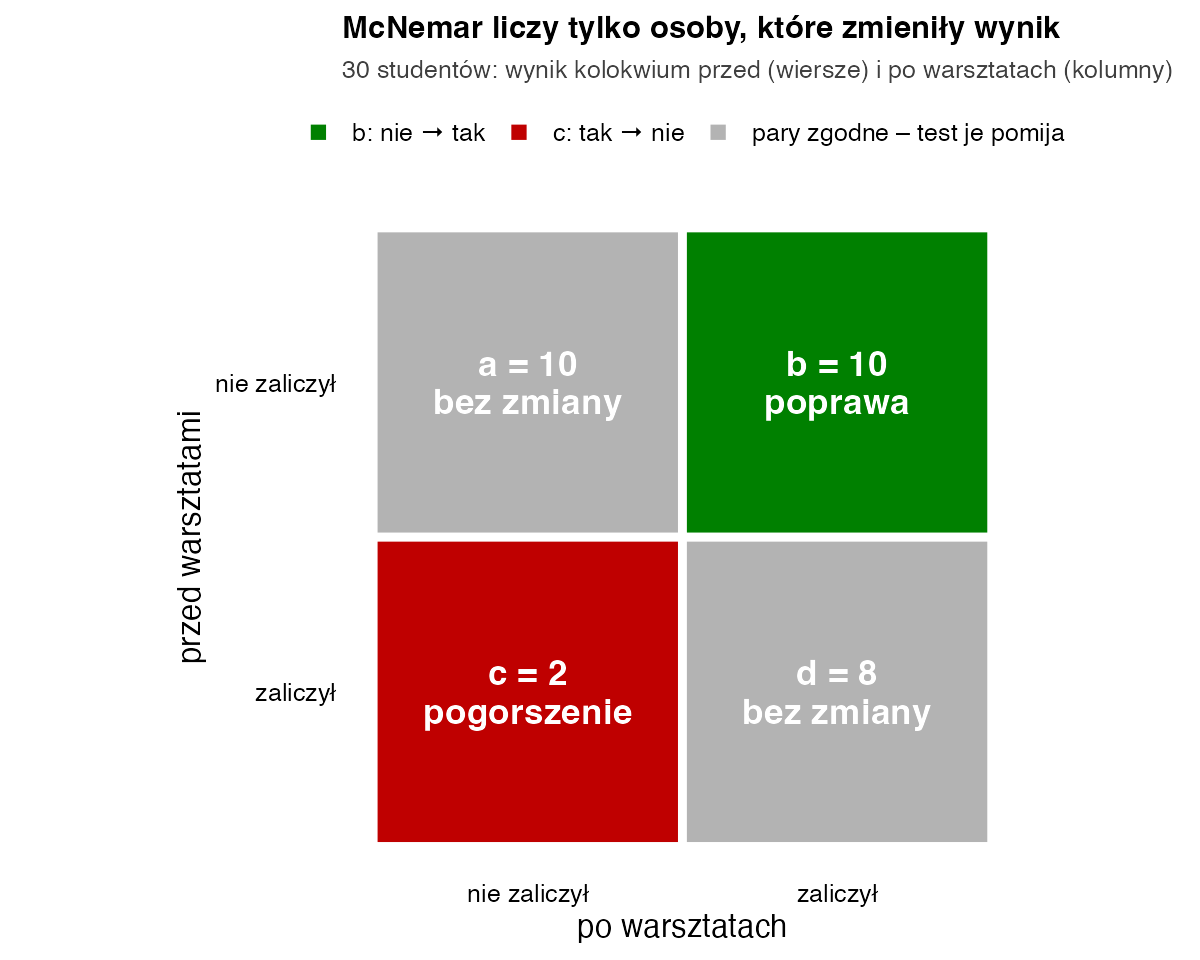
30 studentów pisało kolokwium przed warsztatami z metod uczenia się i po nich. Przed warsztatami zaliczyło 10 osób, po warsztatach 18. Tabela pokazuje, jak zmieniały się wyniki poszczególnych osób.
| Przed \ Po | nie zaliczył | zaliczył | Razem przed |
|---|---|---|---|
| nie zaliczył | a = 10 (bez zmiany) | b = 10 (poprawa) | 20 |
| zaliczył | c = 2 (pogorszenie) | d = 8 (bez zmiany) | 10 |
| Razem po | 12 | 18 | 30 |
- Odsetki przed i po. Przed: 10 / 30 = 0,333 (33,3%). Po: 18 / 30 = 0,600 (60,0%). Różnica: 0,600 − 0,333 = 0,267. Ten sam wynik dają pary niezgodne: (b − c) / n = (10 − 2) / 30 = 8 / 30 = 0,267.
- Pary niezgodne. Zmiana dotyczy b + c = 10 + 2 = 12 osób. Gdyby warsztaty nic nie dawały, oczekiwalibyśmy po 6 poprawień i pogorszeń.
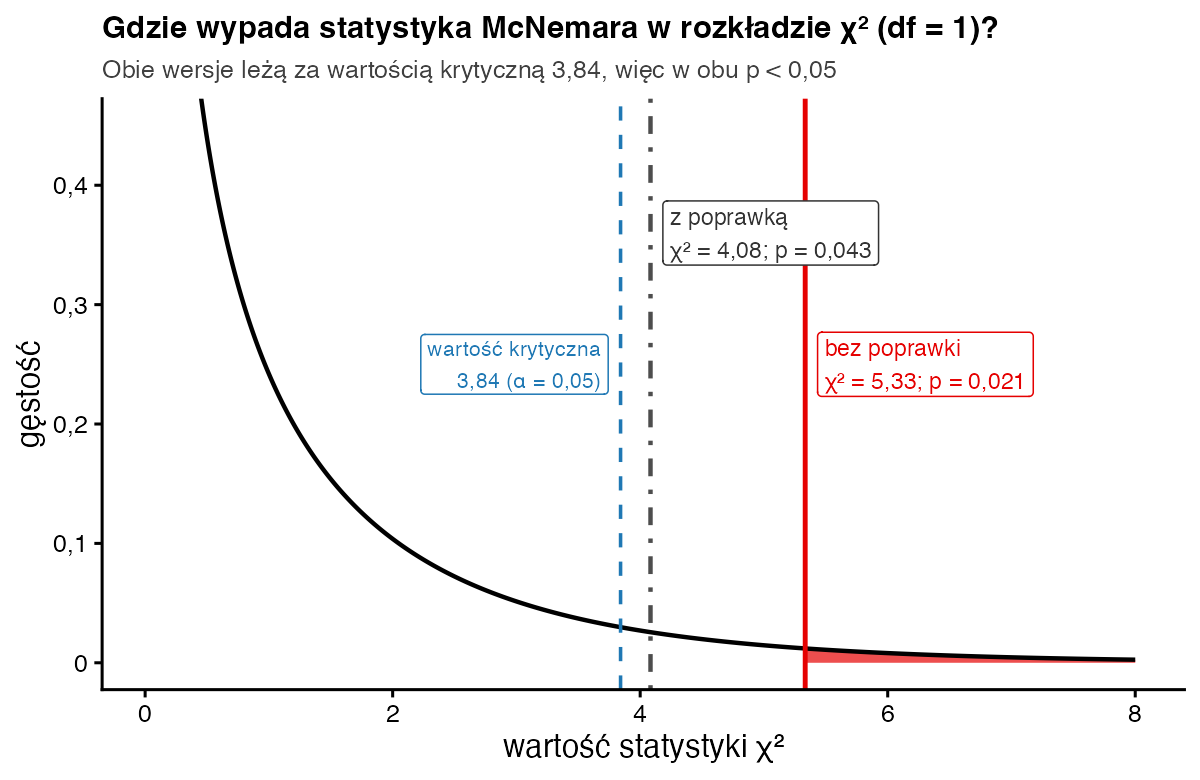
- Statystyka bez poprawki. b − c = 10 − 2 = 8; 8² = 64; 64 / 12 = 5,33.
- Wartość krytyczna. Z tablic rozkładu χ² dla df = 1 i α = 0,05 odczytujesz 3,84 (w R:
qchisq(0.95, 1)). 5,33 > 3,84, więc wynik jest istotny. Dokładnie: p = 0,021 (w R:pchisq(5.33, 1, lower.tail = FALSE)). - Z poprawką ciągłości. |10 − 2| − 1 = 8 − 1 = 7; 7² = 49; 49 / 12 = 4,08; p = 0,043. Wynik nadal istotny, ale p jest większe.
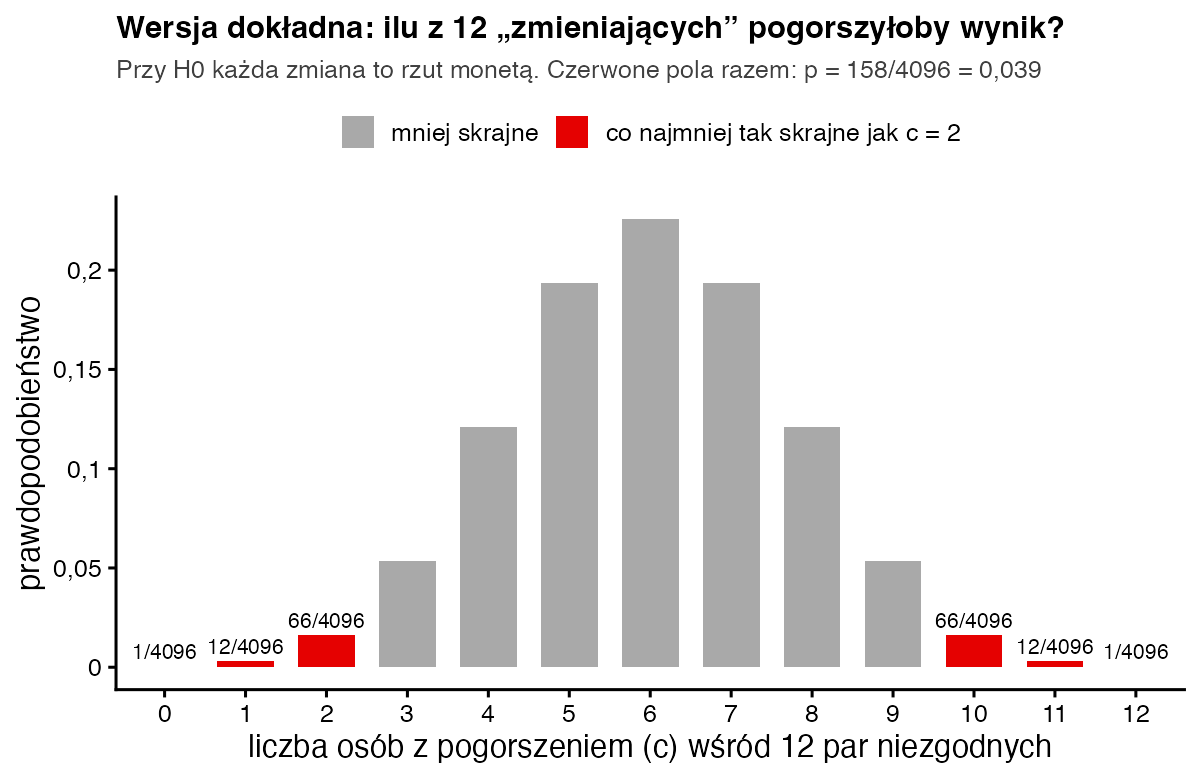
- Wersja dokładna. Przy prawdziwej H0 każda z 12 zmian to „rzut monetą”: poprawa albo pogorszenie z prawdopodobieństwem 0,5. Szansa, że pogorszeń będzie 2 albo mniej: (1 + 12 + 66) / 2¹² = 79 / 4096 = 0,0193. Liczba 66 to \(\binom{12}{2} = \frac{12 \cdot 11}{2}\). Test jest dwustronny, więc mnożysz przez 2: p = 158 / 4096 = 0,039.
- Wielkość efektu. Iloraz szans dla par: b / c = 10 / 2 = 5. Na jedną osobę, której się pogorszyło, przypada pięć osób, którym się poprawiło.
Jak zinterpretować i opisać wynik?
Po warsztatach kolokwium zaliczało wyraźnie więcej osób. Poprawa wystąpiła u 10 osób, pogorszenie tylko u 2. Taka nierównowaga byłaby mało prawdopodobna, gdyby warsztaty nie miały związku ze zmianą. Pamiętaj jednak, że badanie przed i po bez grupy kontrolnej nie dowodzi, że to warsztaty spowodowały poprawę. Studenci mogli po prostu lepiej poznać wykładowcę albo materiał. Podaj, którą wersję testu wybrałeś.
Zapis w stylu APA: Odsetek osób, które zaliczyły kolokwium, wzrósł z 33,3% przed warsztatami do 60,0% po nich. Test McNemara wykazał istotną zmianę, χ²(1) = 5,33; p = 0,021 (bez poprawki ciągłości; dokładny test dwumianowy: p = 0,039).
Jak policzyć test McNemara w R?
# Kolokwium przed i po warsztatach (30 studentów)
tab <- matrix(c(10, 10,
                 2,  8), nrow = 2, byrow = TRUE,
              dimnames = list(przed = c("nie zaliczył", "zaliczył"),
                              po    = c("nie zaliczył", "zaliczył")))
b <- tab[1, 2]; c_ <- tab[2, 1]              # pary niezgodne: b = 10, c = 2

# 1) „ręcznie”
chi2     <- (b - c_)^2 / (b + c_)             # 64 / 12 = 5,33
chi2_cc  <- (abs(b - c_) - 1)^2 / (b + c_)    # 49 / 12 = 4,08
p_dokl   <- 2 * pbinom(min(b, c_), b + c_, 0.5) # wersja dokładna
round(c(chi2 = chi2, p = pchisq(chi2, 1, lower.tail = FALSE),
        chi2_cc = chi2_cc, p_cc = pchisq(chi2_cc, 1, lower.tail = FALSE),
        p_dokladne = p_dokl), 4)

# 2) gotowe funkcje
mcnemar.test(tab, correct = FALSE)            # bez poprawki
mcnemar.test(tab)                             # z poprawką ciągłości
binom.test(c_, b + c_)$p.value                # dokładny (dwumianowy)
Wynik w konsoli R:
      chi2          p    chi2_cc       p_cc p_dokladne
    5.3333     0.0209     4.0833     0.0433     0.0386

	McNemar's Chi-squared test

data:  tab
McNemar's chi-squared = 5.3333, df = 1, p-value = 0.02092


	McNemar's Chi-squared test with continuity correction

data:  tab
McNemar's chi-squared = 4.0833, df = 1, p-value = 0.04331

[1] 0.03857422
Uwaga: funkcja mcnemar.test domyślnie stosuje poprawkę ciągłości. Jeśli chcesz wersji bez poprawki, dopisz correct = FALSE.
Z poprawką, bez poprawki czy dokładny?
Gdy par niezgodnych jest mało (w podręcznikach często pada próg b + c < 25), lepiej nie polegać na przybliżeniu χ². Wtedy użyj wersji dokładnej, opartej na teście dwumianowym. Poprawka ciągłości sprawia, że test jest ostrożniejszy, ale często aż za bardzo. Fagerland i in. (2013) pokazali, że wersja bez poprawki zwykle dobrze trzyma poziom błędu I rodzaju nawet w małych próbach. Wersja dokładna bywa za to zbyt zachowawcza. Najważniejsze: zdecyduj przed analizą i napisz w pracy, którą wersję wybrałeś.
Najczęstsze błędy
- Wpisanie danych przed i po do zwykłego testu chi-kwadrat, tak jakby to były dwie różne grupy osób.
- Liczenie testu na liczebnościach brzegowych (10 i 18) zamiast na parach niezgodnych.
- Niepodanie, czy użyto poprawki ciągłości – wyniki różnią się wtedy między programami.
- Wniosek „warsztaty poprawiły wyniki” bez grupy kontrolnej – test pokazuje zmianę, a nie jej przyczynę.
- Pisanie „przyjęto H0”, gdy p > 0,05 – poprawnie: brak podstaw do odrzucenia H0.
Bibliografia
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153–157. https://doi.org/10.1007/BF02295996
- Edwards, A. L. (1948). Note on the “correction for continuity” in testing the significance of the difference between correlated proportions. Psychometrika, 13(3), 185–187. https://doi.org/10.1007/BF02289261
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13, 91. https://doi.org/10.1186/1471-2288-13-91
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówDokładny test Fishera
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówTest t Studenta dla prób zależnych
- Słownik wzorówTest Wilcoxona
- PoradnikTest chi-kwadrat – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.