

Skala Likerta – średnia czy mediana i jak ją analizować krok po kroku
Skala Likerta to zestaw stwierdzeń, przy których badany zaznacza, w jakim stopniu się z nimi zgadza, np. od 1 („zdecydowanie nie”) do 5 („zdecydowanie tak”). Typowe pytanie z pracy dyplomowej: czy z odpowiedzi wolno liczyć średnią, czy trzeba podawać medianę, i co zrobić z pytaniem odwróconym?
W prostych słowachNajpierw pokazujesz, jak ludzie odpowiadali na każde pytanie. Potem odwracasz pytania sformułowane „na odwrót”, łączysz pozycje w jeden wynik skali i sprawdzasz, czy pytania mierzą to samo (alfa Cronbacha). Pojedyncze pytanie opisujesz rozkładem odpowiedzi i medianą, a wynik całej skali – średnią i odchyleniem standardowym.
Mini-ankieta: 6 osób i 4 pytania
Sześciu studentów oceniło zajęcia online na skali 1–5. Pytania Z1–Z3 są sformułowane „za” zajęciami online: Z1 „Zajęcia online są dla mnie wygodne”, Z2 „Na zajęciach online łatwo mi się skupić”, Z3 „Chętnie wybiorę kolejne zajęcia online”. Pytanie Z4 „Na zajęciach online szybko się nudzę” jest odwrócone: wysoka odpowiedź oznacza tu niskie zadowolenie. Tak małą ankietę bierzemy tylko po to, żeby każdy krok dało się sprawdzić na kartce. Dane z Formularzy Google wyglądają tak samo, tylko wierszy jest więcej.
| Osoba | Z1 | Z2 | Z3 | Z4 | Z4r = 6 − Z4 | Wynik skali (średnia) | Wynik skali (suma) |
|---|---|---|---|---|---|---|---|
| 1 | 3 | 3 | 4 | 2 | 4 | 3,5 | 14 |
| 2 | 5 | 3 | 3 | 3 | 3 | 3,5 | 14 |
| 3 | 5 | 5 | 4 | 2 | 4 | 4,5 | 18 |
| 4 | 2 | 3 | 1 | 4 | 2 | 2,0 | 8 |
| 5 | 3 | 3 | 1 | 3 | 3 | 2,5 | 10 |
| 6 | 3 | 1 | 2 | 4 | 2 | 2,0 | 8 |
| Mediana | 3 | 3 | 2,5 | 3 | 3 | 3,0 | 12 |
| Średnia | 3,5 | 3,0 | 2,5 | 3,0 | 3,0 | 3,0 | 12 |
Analiza skali Likerta krok po kroku
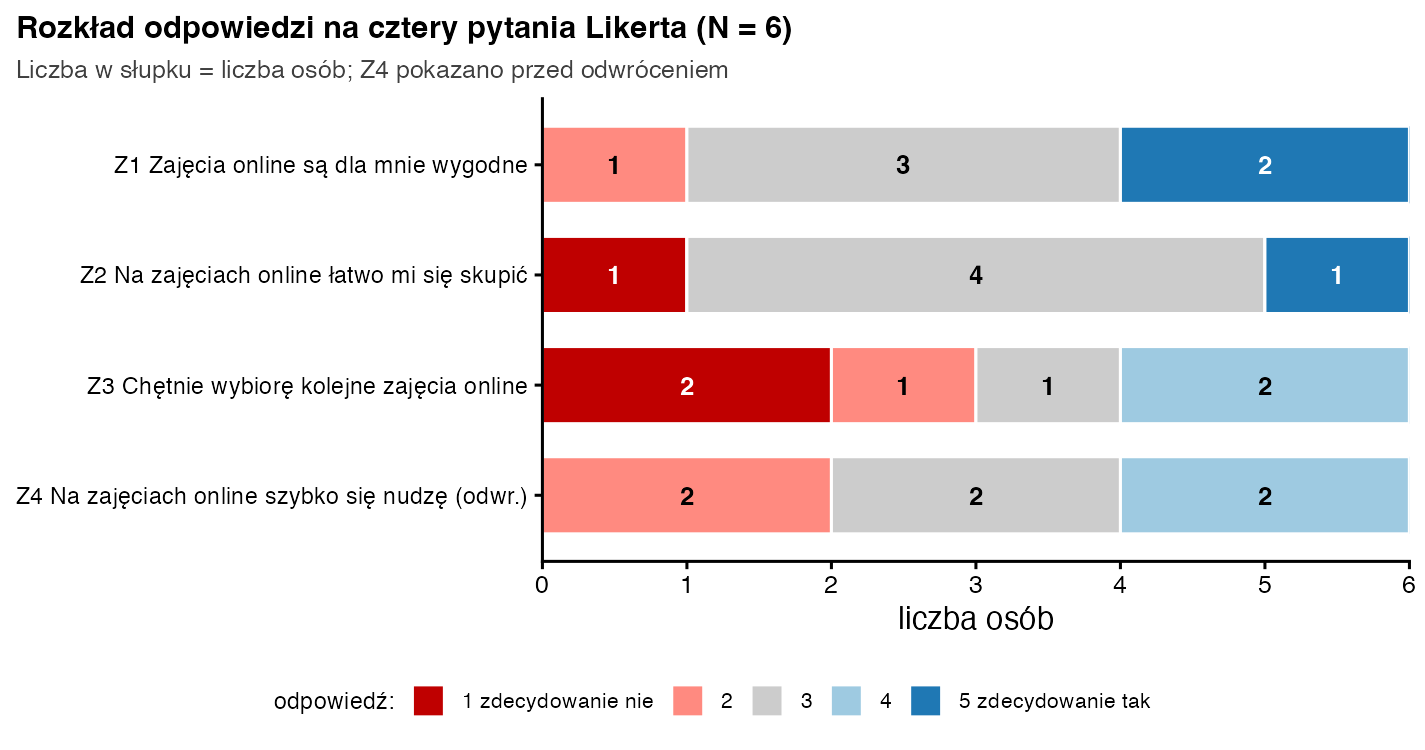
- Pokaż rozkład odpowiedzi. Dla każdego pytania policz, ile osób zaznaczyło 1, 2, 3, 4 i 5 (częstości i procenty). Najczytelniejszy jest jeden skumulowany wykres słupkowy (Rys. 1). Widać na nim np., że w Z1 nikt nie zaznaczył 1 ani 4, a dwie osoby z sześciu (33,3%) – odpowiedź 5.
- Odwróć pytanie odwrócone. Na skali 1–5 nowa wartość to 6 minus stara: 1 zamienia się w 5, 2 w 4, 3 zostaje 3. Osoba 1 zaznaczyła w Z4 dwójkę, więc po odwróceniu ma 6 − 2 = 4. Na skali 1–7 odejmujesz od 8.
- Policz wynik skali. Osoba 1: (3 + 3 + 4 + 4) / 4 = 14 / 4 = 3,5. Suma to po prostu 14. Średnia i suma niosą tę samą informację (suma = 4 × średnia), więc dają te same korelacje i wyniki testów. Średnia ma jedną zaletę: zostaje na skali 1–5, więc 3,0 czytasz jako „ani tak, ani nie”.
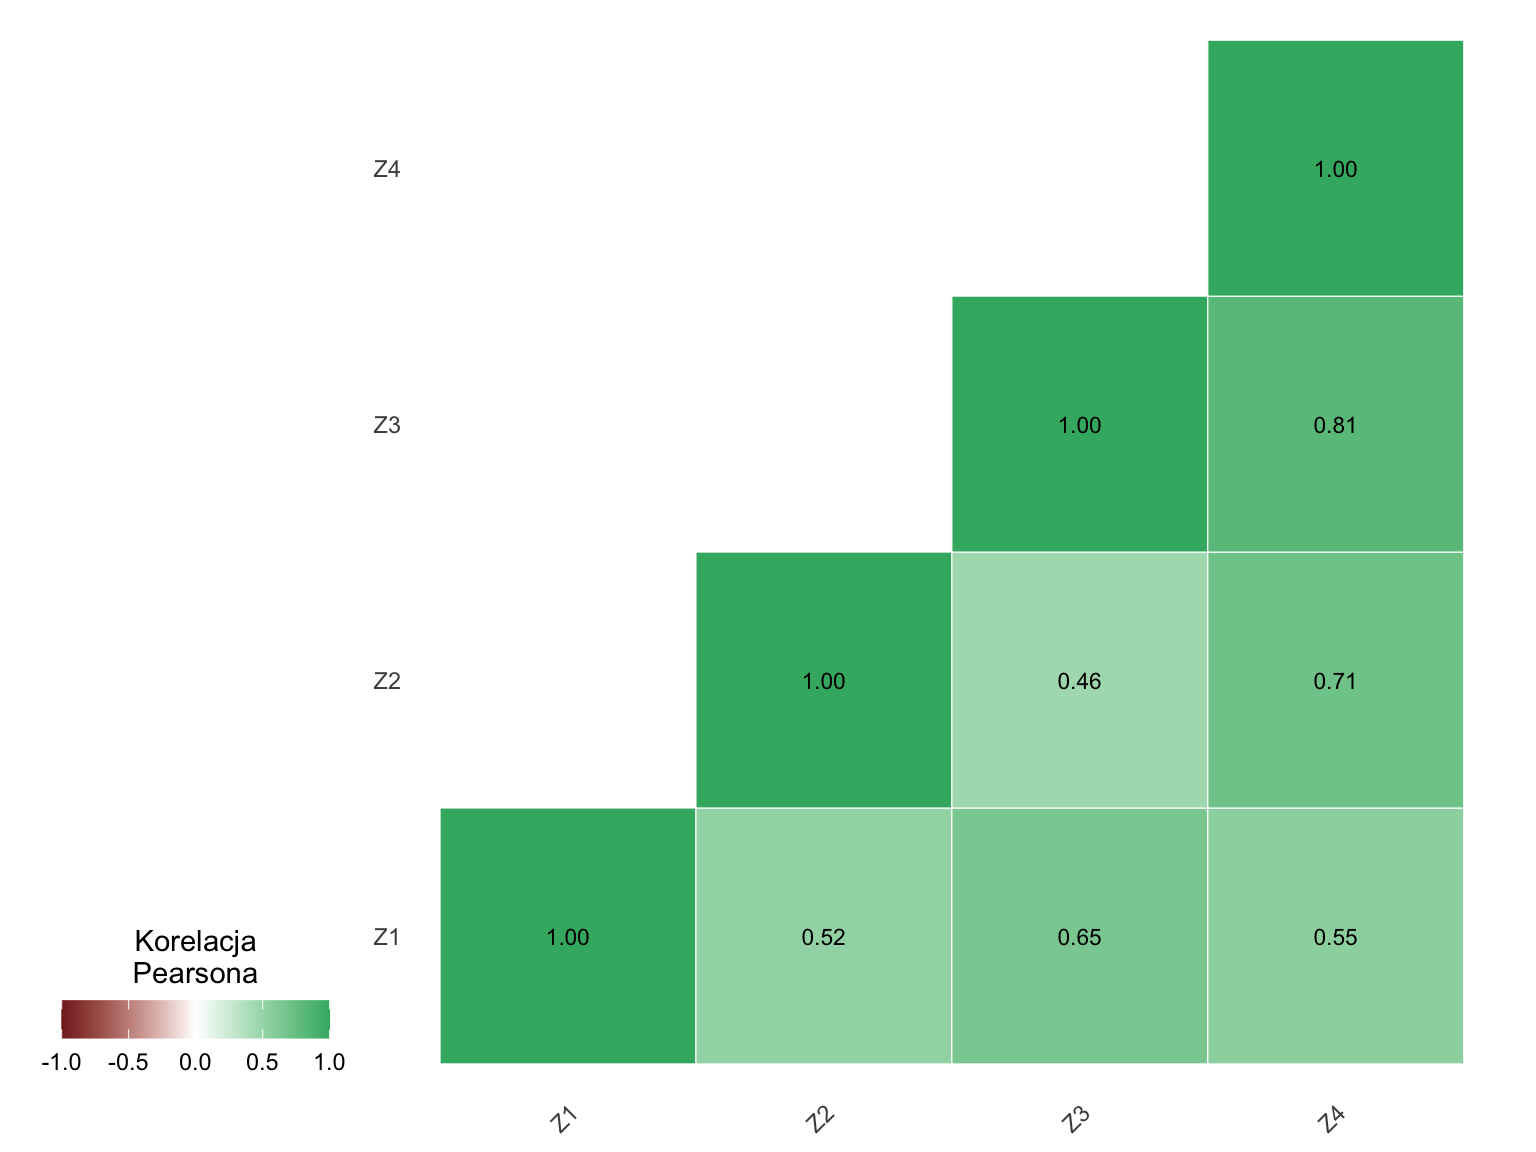
- Sprawdź rzetelność. Alfa Cronbacha dla czterech pozycji po odwróceniu Z4 wynosi 0,85. Gdybyś zapomniał o odwróceniu, alfa spadłaby do 0,13, bo Z4 korelowałoby z pozostałymi pytaniami ujemnie (od −0,81 do −0,55). Sprawdź też korelację pozycja–całość: wszystkie skorygowane korelacje (od 0,61 do 0,83) przekraczają często przyjmowany próg 0,30 (Field i in., 2012), a usunięcie dowolnej pozycji obniżyłoby alfę (od 0,78 do 0,84).
- Opisz wyniki. Pojedyncze pytania – rozkład odpowiedzi i mediana. Wynik skali – średnia i odchylenie standardowe: M = 3,00; SD = 1,00 (dla sumy: M = 12,00; SD = 4,00).
Średnia czy mediana – na czym polega spór?
Pojedyncza odpowiedź na skali Likerta to dane porządkowe: wiemy, że 4 to więcej niż 3, ale nie wiemy, czy odstęp między 3 a 4 jest taki sam jak między 4 a 5. Dlatego Jamieson (2004) zaleca dla pojedynczych pytań medianę i testy nieparametryczne. Norman (2010) pokazuje z kolei, że testy parametryczne dają zwykle poprawne wnioski także dla takich danych, zwłaszcza gdy łączysz kilka pozycji w wynik skali. Liddell i Kruschke (2018) przypominają jednak, że dla pojedynczych pytań średnia potrafi wprowadzić w błąd, a najdokładniejsze są modele porządkowe. Uczciwie: spór nie jest rozstrzygnięty, ale praktyka jest dość zgodna – i właśnie ją pokazuje Tabela 2.
| Co opisujesz | Statystyki opisowe | Porównania i związki |
|---|---|---|
| Jedno pytanie (np. Z1) | liczba i % odpowiedzi, mediana; średnia najwyżej jako uzupełnienie | testy nieparametryczne (U Manna-Whitneya, Kruskala-Wallisa), korelacja Spearmana, chi-kwadrat |
| Wynik skali (średnia lub suma kilku pozycji) | M, SD, min–maks | testy parametryczne (t, ANOVA, korelacja Pearsona), gdy rozkład w grupach nie odbiega mocno od normalnego |
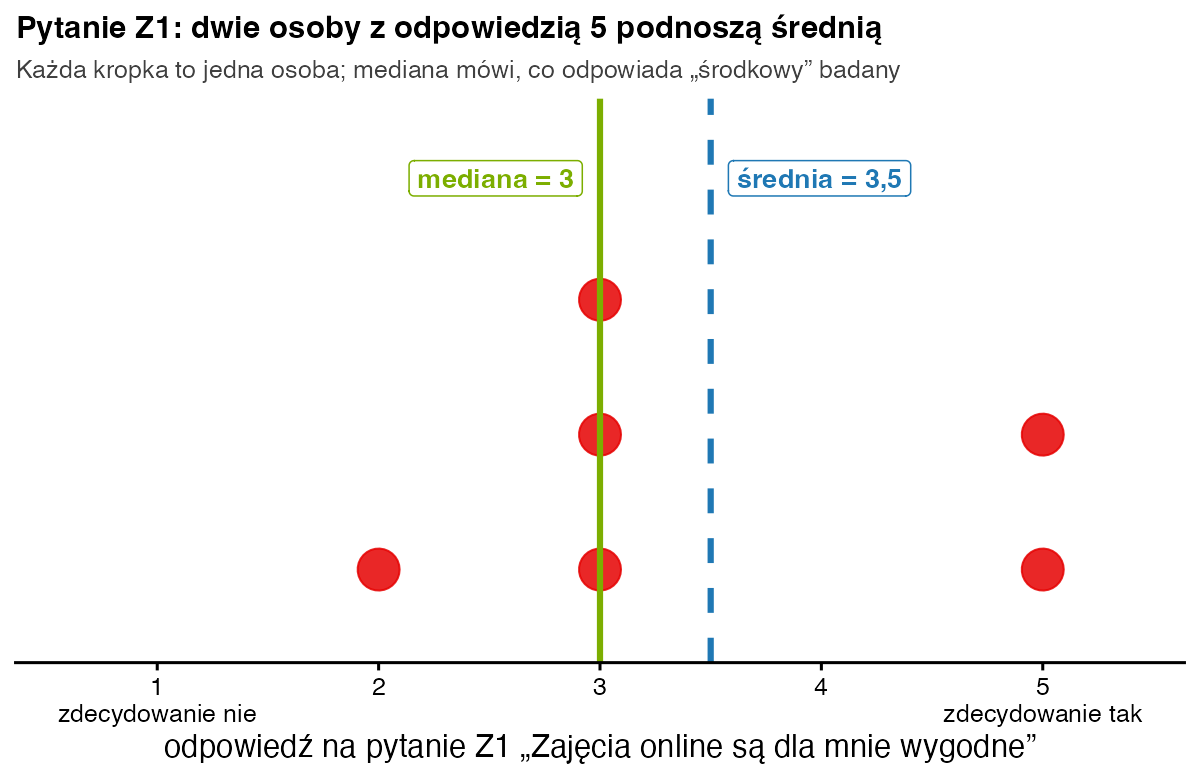
W pytaniu Z1 widać, skąd bierze się różnica: trzy osoby zaznaczyły 3, dwie – 5, jedna – 2. Mediana wynosi 3, a średnia 3,5, bo dwie piątki „ciągną” ją w górę (Rys. 3). Przy wyniku skali ten problem słabnie, bo średnia czterech pozycji ma więcej możliwych wartości i zachowuje się bardziej jak zmienna ilościowa.
Gotowe zdania do pracy
Rekodowanie i wynik skali: Przed obliczeniami odwrócono pozycję Z4 (6 − odpowiedź). Wynik skali zadowolenia z zajęć online obliczono jako średnią czterech pozycji (zakres 1–5).
Rzetelność: Skala miała wysoką rzetelność, α = 0,85. Skorygowane korelacje pozycja–całość wynosiły od 0,61 do 0,83, a usunięcie żadnej pozycji nie podwyższyłoby alfy.
Opis: Średni poziom zadowolenia wyniósł M = 3,00 (SD = 1,00). Najwięcej odpowiedzi „zdecydowanie tak” dotyczyło wygody zajęć online (Z1; 33,3%; Me = 3), a najniższą medianę miała chęć wyboru kolejnych zajęć (Z3; Me = 2,5).
Więcej wzorów zdań i tabel znajdziesz w poradniku jak opisać wyniki ankiety w pracy magisterskiej, a cały proces od surowego pliku – w tekście jak opracować wyniki ankiety.
Jak przeanalizować skalę Likerta w R?
# 1) Import: plik CSV z Formularzy Google; w praktyce read.csv("ankieta.csv")
ankieta <- read.csv(text = '
Z1,Z2,Z3,Z4
3,3,4,2
5,3,3,3
5,5,4,2
2,3,1,4
3,3,1,3
3,1,2,4')

# 2) Rozkład odpowiedzi w pojedynczych pytaniach (Z4 w brzmieniu z ankiety)
sapply(ankieta, function(x) table(factor(x, levels = 1:5)))

# 3) Rekodowanie pozycji odwróconej: na skali 1–5 nowa = 6 − stara
ankieta$Z4r <- 6 - ankieta$Z4
pozycje <- ankieta[, c("Z1", "Z2", "Z3", "Z4r")]

# 4) Wynik skali: średnia i suma pozycji
ankieta$srednia <- rowMeans(pozycje)
ankieta$suma <- rowSums(pozycje)
ankieta[, c("srednia", "suma")]

# 5) Rzetelność: alfa Cronbacha i skorygowana korelacja pozycja–całość
rz <- psych::alpha(pozycje)
round(rz$total$raw_alpha, 2)
round(data.frame(r_skoryg = rz$item.stats$r.drop, alfa_bez = rz$alpha.drop$raw_alpha, row.names = names(pozycje)), 2)

# 6) Opis: pojedyncze pytania – mediana, wynik skali – M i SD
sapply(pozycje, median)
round(c(M = mean(ankieta$srednia), SD = sd(ankieta$srednia), M_suma = mean(ankieta$suma), SD_suma = sd(ankieta$suma)), 2)
Wynik w konsoli R:
  Z1 Z2 Z3 Z4
1  0  1  2  0
2  1  0  1  2
3  3  4  1  2
4  0  0  2  2
5  2  1  0  0
  srednia suma
1     3.5   14
2     3.5   14
3     4.5   18
4     2.0    8
5     2.5   10
6     2.0    8
[1] 0.85
    r_skoryg alfa_bez
Z1      0.66     0.82
Z2      0.61     0.84
Z3      0.73     0.80
Z4r     0.83     0.78
 Z1  Z2  Z3 Z4r
3.0 3.0 2.5 3.0
      M      SD  M_suma SD_suma
      3       1      12       4
Kolumna r_skoryg to korelacja pozycji z sumą pozostałych pozycji, a alfa_bez – alfa po usunięciu danej pozycji. Ręczny rachunek alfy pokazujemy w przykładzie z alfą Cronbacha.
Checklista przed oddaniem rozdziału
- Każde pytanie odwrócone jest zrekodowane, a w metodzie napisałeś, które to pozycje.
- Wynik skali liczysz tak, jak podają autorzy narzędzia (średnia albo suma) i trzymasz się jednej wersji.
- Alfa jest podana dla każdej skali osobno, nie dla całej ankiety.
- Pojedyncze pytania opisujesz rozkładem odpowiedzi, a nie samą średnią.
- Odpowiedź „nie wiem” nie jest zakodowana jako 3 – to brak danych, a nie środek skali.
Pytania, które zadają studenci
Czy skala Likerta jest porządkowa czy przedziałowa?
Pojedyncza pozycja jest porządkowa. Wynik skali z kilku pozycji traktuje się zwykle jak zmienną ilościową (przedziałową) – tak robi większość prac z psychologii i nauk społecznych (Norman, 2010). Napisz w metodzie, jak to rozumiesz.
Czy mogę zrobić test t na jednym pytaniu Likerta?
Bezpieczniej użyć testu U Manna-Whitneya i opisać rozkład odpowiedzi w grupach. Test t na wyniku całej skali jest w porządku, jeśli rozkłady w grupach nie są skrajnie skośne.
Alfa wyszła ujemna albo bardzo niska – co zrobić?
Najczęstsza przyczyna to nieodwrócona pozycja, jak w naszym przykładzie (0,13 zamiast 0,85). Sprawdź korelacje pozycja–całość: ujemna wartość wskazuje pytanie do odwrócenia albo źle zrozumiane przez badanych. Przy krótkich skalach warto podać też omegę McDonalda.
Bibliografia
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05
- Jamieson, S. (2004). Likert scales: How to (ab)use them. Medical Education, 38(12), 1217–1218. https://doi.org/10.1111/j.1365-2929.2004.02012.x
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55.
- Norman, G. (2010). Likert scales, levels of measurement and the „laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówKorelacja pozycja–całość
- Słownik wzorówMediana
- PoradnikJak opracować wyniki ankiety krok po kroku
- PoradnikOpracowanie wyników ankiety
- Przykładowy raportPrzykład SZTOS: analiza rzetelności skal
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.