

Kappa Cohena – wzór, przykład i interpretacja
Kappa Cohena mierzy, na ile dwie osoby oceniające zgadzają się ze sobą ponad to, czego można by się spodziewać przy zgadywaniu. Przykładowe pytanie z pracy dyplomowej: czy dwóch sędziów kompetentnych tak samo przypisuje odpowiedzi z wywiadów do kategorii?
W prostych słowachGdy dwie osoby oceniają te same prace w kategoriach „tak/nie”, część zgodnych ocen pojawi się zupełnie przypadkiem. Kappa odejmuje tę „darmową” zgodność i pokazuje, ile zostało z prawdziwego porozumienia. Wartość 1 oznacza pełną zgodność, 0 – zgodność taką jak przy rzucaniu monetą. Wartości ujemne zdarzają się rzadko i znaczą, że oceniający zgadzają się rzadziej niż przypadkiem.
Kiedy stosować kappę Cohena?
- masz dokładnie dwóch oceniających (sędziów kompetentnych, promotorów, koderów);
- każdy z nich ocenił te same obiekty – prace, odpowiedzi, nagrania;
- oceny są kategoriami: zaliczone/niezaliczone, kategorie tematyczne w analizie treści, obecność objawu;
- kategorie wzajemnie się wykluczają i obaj oceniający używają tego samego zestawu kategorii.
Gdy oceny są liczbami (np. punkty 1–10 za prezentację), lepszy będzie współczynnik korelacji wewnątrzklasowej ICC. Dla kategorii uporządkowanych (np. ocena 1–5) stosuje się kappę ważoną, która mniej „karze” za bliskie rozbieżności. Uwaga: kappa to nie test chi-kwadrat. Chi-kwadrat sprawdza, czy oceny są ze sobą powiązane, a kappa – czy są takie same. Z kolei test McNemara na tej samej tabeli sprawdza, czy jeden z oceniających nie jest systematycznie surowszy.
Wzór na kappę Cohena
Na głos: „kappa to nadwyżka zgodności obserwowanej nad przypadkową, podzielona przez największą nadwyżkę, jaka w ogóle była możliwa”.
- \(\kappa\)
- grecka litera kappa – wynik, zwykle między 0 a 1
- \(p_o\)
- zgodność obserwowana: jaka część prac dostała od obu osób tę samą ocenę (suma liczb na przekątnej tabeli podzielona przez n)
- \(p_e\)
- zgodność oczekiwana przy przypadku: jak często oceny zgadzałyby się, gdyby każdy oceniał „na ślepo”, zachowując tylko swoje proporcje ocen
- \(p_{A,j},\ p_{B,j}\)
- jaką część prac oceniający A (i oceniający B) zaliczył do kategorii j
- \(n\)
- liczba ocenianych obiektów (tu: prac)
- \(1 - p_e\)
- ile zgodności było „do zdobycia” ponad przypadek
Przykład krok po kroku
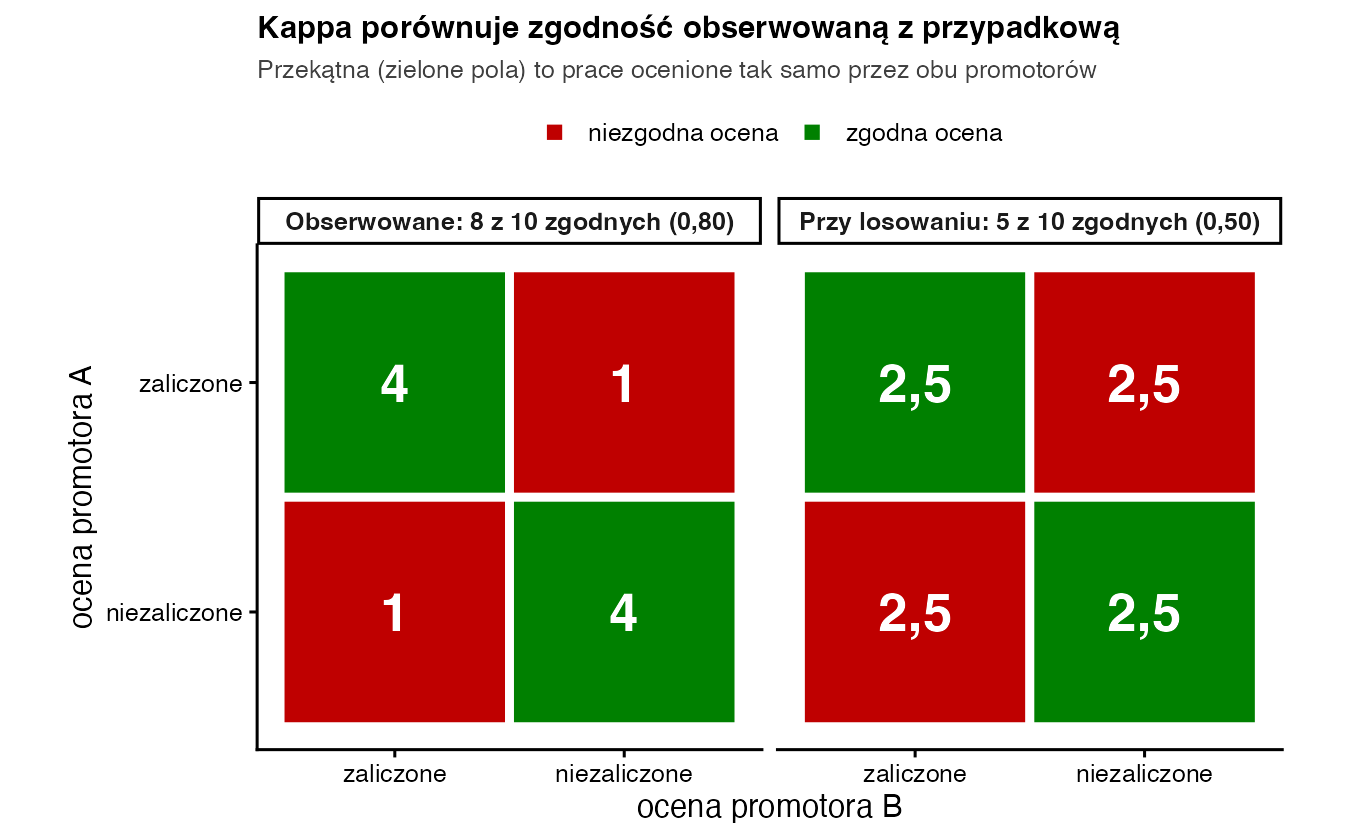
Dwóch promotorów niezależnie oceniło 10 prac zaliczeniowych: zaliczone albo niezaliczone. Zgodzili się co do 8 prac, a przy 2 pracach każdy ocenił inaczej. Wyniki zbiera tabela krzyżowa.
| Promotor A \ Promotor B | zaliczone | niezaliczone | suma A |
|---|---|---|---|
| zaliczone | 4 | 1 | 5 |
| niezaliczone | 1 | 4 | 5 |
| suma B | 5 | 5 | 10 |
| kategoria | zgodne (przekątna) | pA = suma A / 10 | pB = suma B / 10 | pA · pB |
|---|---|---|---|---|
| zaliczone | 4 | 5 / 10 = 0,50 | 5 / 10 = 0,50 | 0,50 · 0,50 = 0,25 |
| niezaliczone | 4 | 5 / 10 = 0,50 | 5 / 10 = 0,50 | 0,50 · 0,50 = 0,25 |
| suma | 8 | 1,00 | 1,00 | pe = 0,50 |
- Zgodność obserwowana. Dodaj liczby z przekątnej tabeli: 4 + 4 = 8 zgodnych ocen. Podziel przez liczbę prac: \(p_o = 8/10 = 0{,}80\).
- Proporcje ocen każdego promotora. Promotor A zaliczył 5 prac z 10, więc \(p_{A} = 5/10 = 0{,}50\). Promotor B też: 0,50. Na „niezaliczone” zostaje u każdego 0,50.
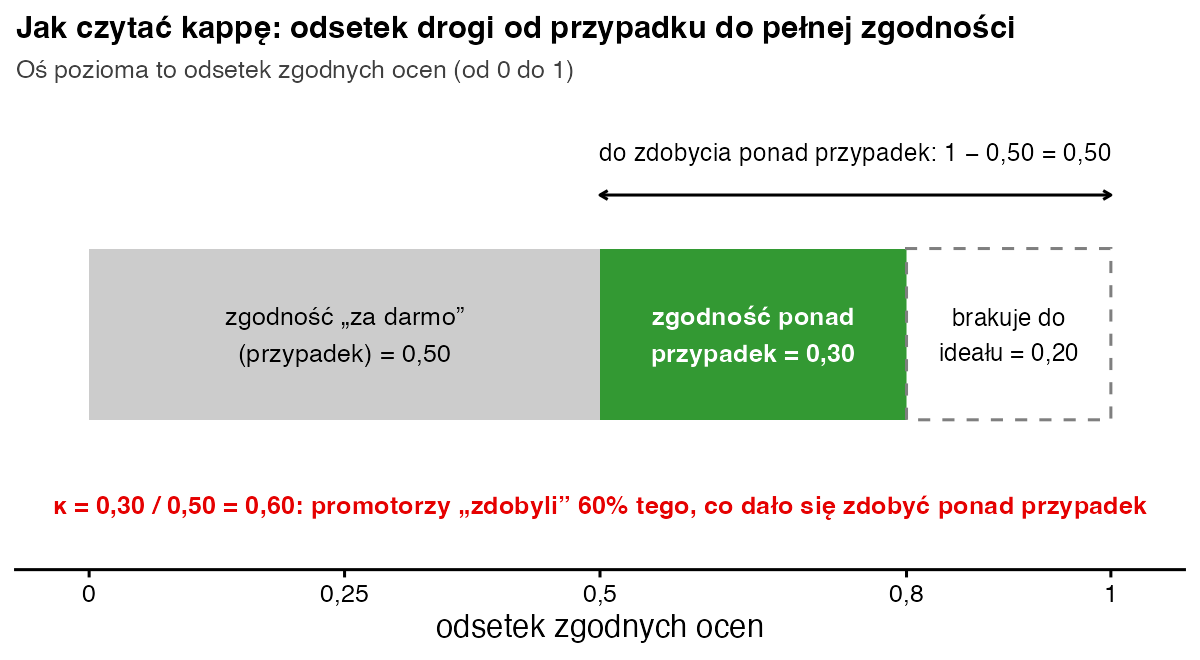
- Zgodność przypadkowa. Gdyby obaj oceniali losowo, „zaliczone” u obu wypadłoby z prawdopodobieństwem 0,50 · 0,50 = 0,25, a „niezaliczone” u obu – też 0,25. Razem \(p_e = 0{,}25 + 0{,}25 = 0{,}50\). Połowa zgodności należała się więc „za darmo”.
- Licznik. Nadwyżka nad przypadek: 0,80 − 0,50 = 0,30.
- Mianownik. Ile dało się zdobyć ponad przypadek: 1 − 0,50 = 0,50.
- Kappa. \(\kappa = 0{,}30 / 0{,}50 = 0{,}60\). Promotorzy osiągnęli 60% możliwej zgodności ponad przypadek.
- Przedział ufności. Pakiet psych podaje wariancję kappy 0,064, więc błąd standardowy to \(\sqrt{0{,}064} = 0{,}253\). Mnożnik 1,96 odczytasz z tablic rozkładu normalnego albo w R:
qnorm(0.975). Granice: 0,60 − 1,96 · 0,253 = 0,10 oraz 0,60 + 1,96 · 0,253 = 1,10. Kappa nie może przekroczyć 1, więc górną granicę przycinamy do 1,00.
Zauważ: „80% zgodności” brzmi świetnie, ale kappa 0,60 mówi uczciwiej, że część tej zgodności to po prostu przypadek.
Jak zinterpretować i opisać wynik?
Najczęściej cytowana skala pochodzi od Landisa i Kocha (1977): poniżej 0 – zgodność słaba, 0,00–0,20 – nieznaczna, 0,21–0,40 – niewielka, 0,41–0,60 – umiarkowana, 0,61–0,80 – znaczna, 0,81–1,00 – prawie doskonała. Nasze 0,60 to górna granica zgodności umiarkowanej. Pamiętaj jednak, że sami autorzy nazwali te progi arbitralnymi. McHugh (2012) zwraca uwagę, że w badaniach, w których od ocen coś zależy, kappa 0,60 to wciąż sporo pomyłek. Podawaj więc zawsze przedział ufności. U nas sięga on od 0,10 do 1,00, bo 10 prac to bardzo mało.
Zapis w stylu APA: Zgodność dwóch promotorów w ocenie 10 prac (zaliczone/niezaliczone) była umiarkowana, κ = 0,60; 95% CI [0,10; 1,00]. Oceniający zgodzili się w 80% przypadków, przy zgodności oczekiwanej przypadkiem równej 50%.
Jak policzyć kappę Cohena w R?
A <- c("zal", "zal", "zal", "zal", "zal", "niezal", "niezal", "niezal", "niezal", "niezal")
B <- c("zal", "zal", "zal", "zal", "niezal", "zal", "niezal", "niezal", "niezal", "niezal")
tab <- table(A, B); tab

# 1) „ręcznie”, dokładnie według wzoru
n  <- sum(tab)                                   # 10 prac
po <- sum(diag(tab)) / n                         # zgodność obserwowana = 0.8
pe <- sum(rowSums(tab) * colSums(tab)) / n^2     # zgodność przypadkowa = 0.5
kappa <- (po - pe) / (1 - pe)
c(po = po, pe = pe, kappa = kappa)

# 2) gotową funkcją z pakietu psych (górna granica CI zostaje przycięta do 1)
k <- suppressWarnings(psych::cohen.kappa(tab))
k$kappa
k$confid["unweighted kappa", ]
Wynik w konsoli R:
        B
A        niezal zal
  niezal      4   1
  zal         1   4
   po    pe kappa
  0.8   0.5   0.6
[1] 0.6
   lower estimate    upper
0.104164 0.600000 1.000000
Ręczny rachunek i funkcja z pakietu psych dają tę samą kappę 0,60. Funkcja psych::cohen.kappa() przyjmuje albo gotową tabelę krzyżową, albo dwie kolumny z ocenami. Liczy też kappę ważoną dla ocen uporządkowanych – przy dwóch kategoriach jest ona równa zwykłej.
Kappa czy procent zgodności – co podać w pracy?
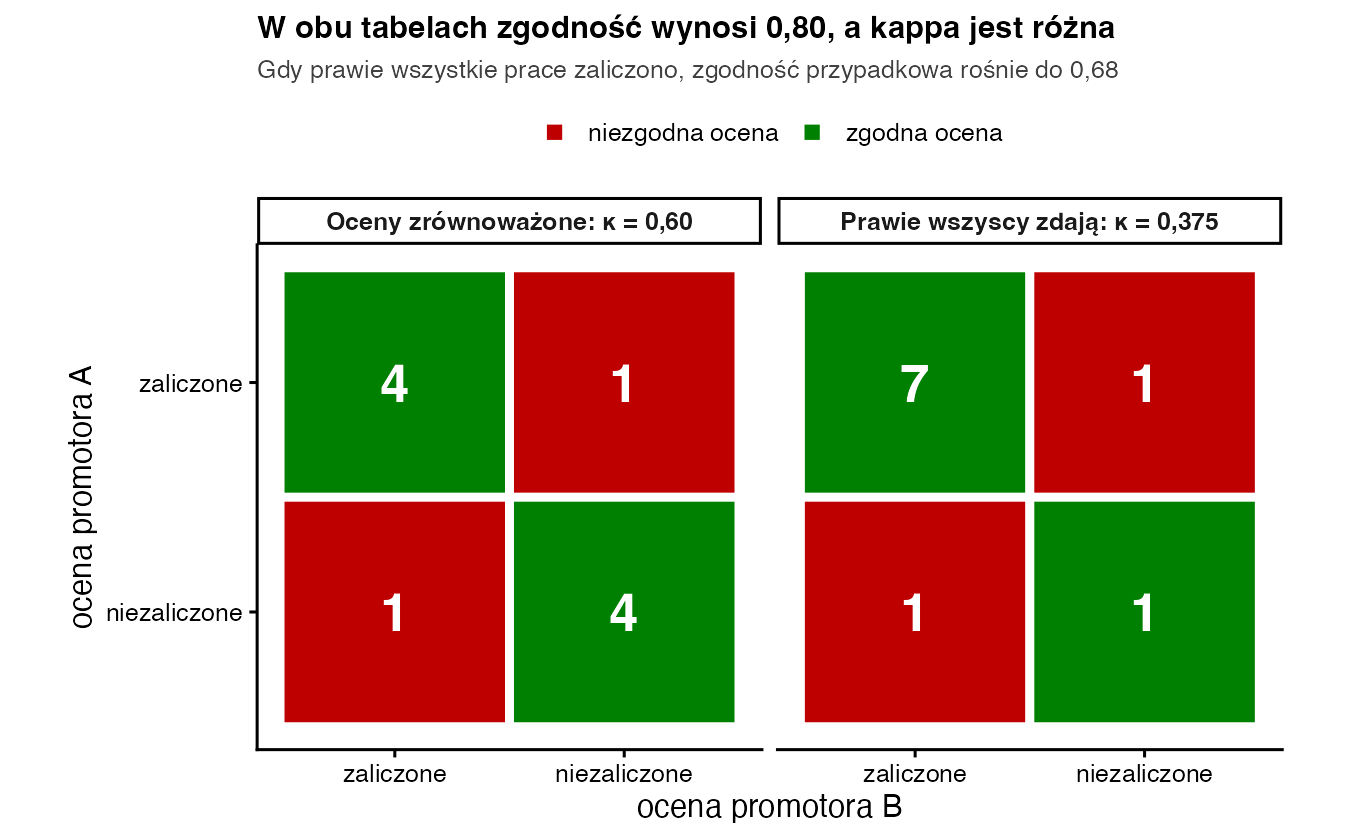
Najlepiej oba. Procent zgodności (u nas 80%) jest łatwy do zrozumienia, ale zawyża obraz, bo nie odejmuje przypadku. Przy dwóch kategoriach i równych proporcjach już samo zgadywanie daje 50% zgodnych ocen. Kappa tę poprawkę robi. Ma jednak słabość pokazaną na rysunku 3: gdy jedna kategoria bardzo dominuje (prawie wszyscy zdają), kappa bywa niska mimo wysokiej zgodności. To tak zwany paradoks kappy. Dlatego w metodologii pracy opisz, ile obiektów oceniono, ile było kategorii, jaki był procent zgodności i ile wyniosła kappa z przedziałem ufności. Gdy oceniających jest więcej niż dwóch, użyj kappy Fleissa albo ICC.
Najczęstsze błędy
- Podawanie samego procentu zgodności i nazywanie go rzetelnością – bez odjęcia przypadku wynik jest zawyżony.
- Liczenie kappy Cohena dla trzech lub więcej oceniających – ten wzór działa tylko dla par.
- Liczenie zwykłej kappy dla ocen na skali 1–5, gdzie pomyłka o 1 punkt i o 4 punkty są traktowane tak samo. Tu lepsza jest kappa ważona albo ICC.
- Traktowanie progów Landisa i Kocha jak twardej granicy („0,61 to już dobrze, 0,59 źle”).
- Brak przedziału ufności przy małej liczbie ocenianych obiektów.
Bibliografia
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159–174. https://doi.org/10.2307/2529310
- McHugh, M. L. (2012). Interrater reliability: The kappa statistic. Biochemia Medica, 22(3), 276–282.
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówWspółczynnik ICC
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówAlfa Cronbacha
- PoradnikAlfa Cronbacha – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportPrzykład SZTOS: analiza rzetelności skal
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.