

MANOVA – wzór na ślad Pillaia i przykład krok po kroku
MANOVA (wielowymiarowa analiza wariancji) sprawdza, czy grupy różnią się kilkoma zmiennymi zależnymi naraz. Typowe pytanie z pracy dyplomowej: czy studenci uczący się z quizów i z notatek różnią się wynikami kolokwium – liczonymi osobno za zadania i za teorię?
W prostych słowachZwykła ANOVA patrzy na jedną zmienną. MANOVA patrzy na kilka zmiennych jednocześnie i bierze pod uwagę, że są ze sobą powiązane. Szuka takiej „mieszanki” zmiennych, która najlepiej rozdziela grupy. Dzięki temu może wykryć różnicę, której nie widać, gdy oglądasz każdą zmienną osobno.
Kiedy stosować MANOVA?
- masz dwie lub więcej grup różnych osób (np. metoda nauki, grupa ćwiczeniowa);
- masz dwie lub więcej zmiennych zależnych ilościowych, które mierzą powiązane rzeczy (np. punkty za zadania i za teorię, kilka podskal jednego kwestionariusza);
- Twoje pytanie dotyczy całego zestawu zmiennych, a nie każdej osobno;
- zmienne zależne są umiarkowanie skorelowane – przy korelacji bliskiej zera wystarczą osobne ANOVA, przy bardzo wysokiej zmienne mierzą to samo.
Gdy masz jedną zmienną zależną, wybierz jednoczynnikową ANOVA albo – przy dwóch grupach – test t. Gdy robisz kilka osobnych ANOVA, kontroluj błąd I rodzaju, np. poprawką Holma. Wielkość efektu opisujesz cząstkowym eta kwadrat.
Wzór na ślad Pillaia
- \(\mathbf{E}\)
- macierz błędu (wewnątrzgrupowa): na przekątnej sumy kwadratów odchyleń od średniej grupy dla każdej zmiennej, poza przekątną – suma iloczynów tych odchyleń (jak bardzo zmienne „chodzą razem” w grupach)
- \(\mathbf{H}\)
- macierz efektu (międzygrupowa): to samo, ale dla odchyleń średnich grup od średniej ogólnej, pomnożonych przez liczbę osób w grupie
- \(\mathbf{H} + \mathbf{E}\)
- macierz całkowita – cała zmienność obu zmiennych
- \((\cdot)^{-1}\)
- macierz odwrotna – macierzowy odpowiednik dzielenia
- \(\operatorname{tr}\)
- ślad macierzy, czyli suma liczb na przekątnej
- \(N,\ p\)
- liczba wszystkich osób i liczba zmiennych zależnych
- \(V\)
- ślad Pillaia: od 0 do 1 (przy dwóch grupach); im bliżej 1, tym lepiej grupy dają się rozdzielić
Jak przeczytać ten wzór na głos: „ślad Pillaia to ślad iloczynu macierzy efektu i odwrotności macierzy całkowitej”. Przy jednej zmiennej zamienia się w znane z ANOVA eta kwadrat: SSmiędzy / SScałk. Wzór na F w ramce dotyczy dwóch grup; dla większej liczby grup programy stosują jego ogólniejszą wersję.
Przykład krok po kroku
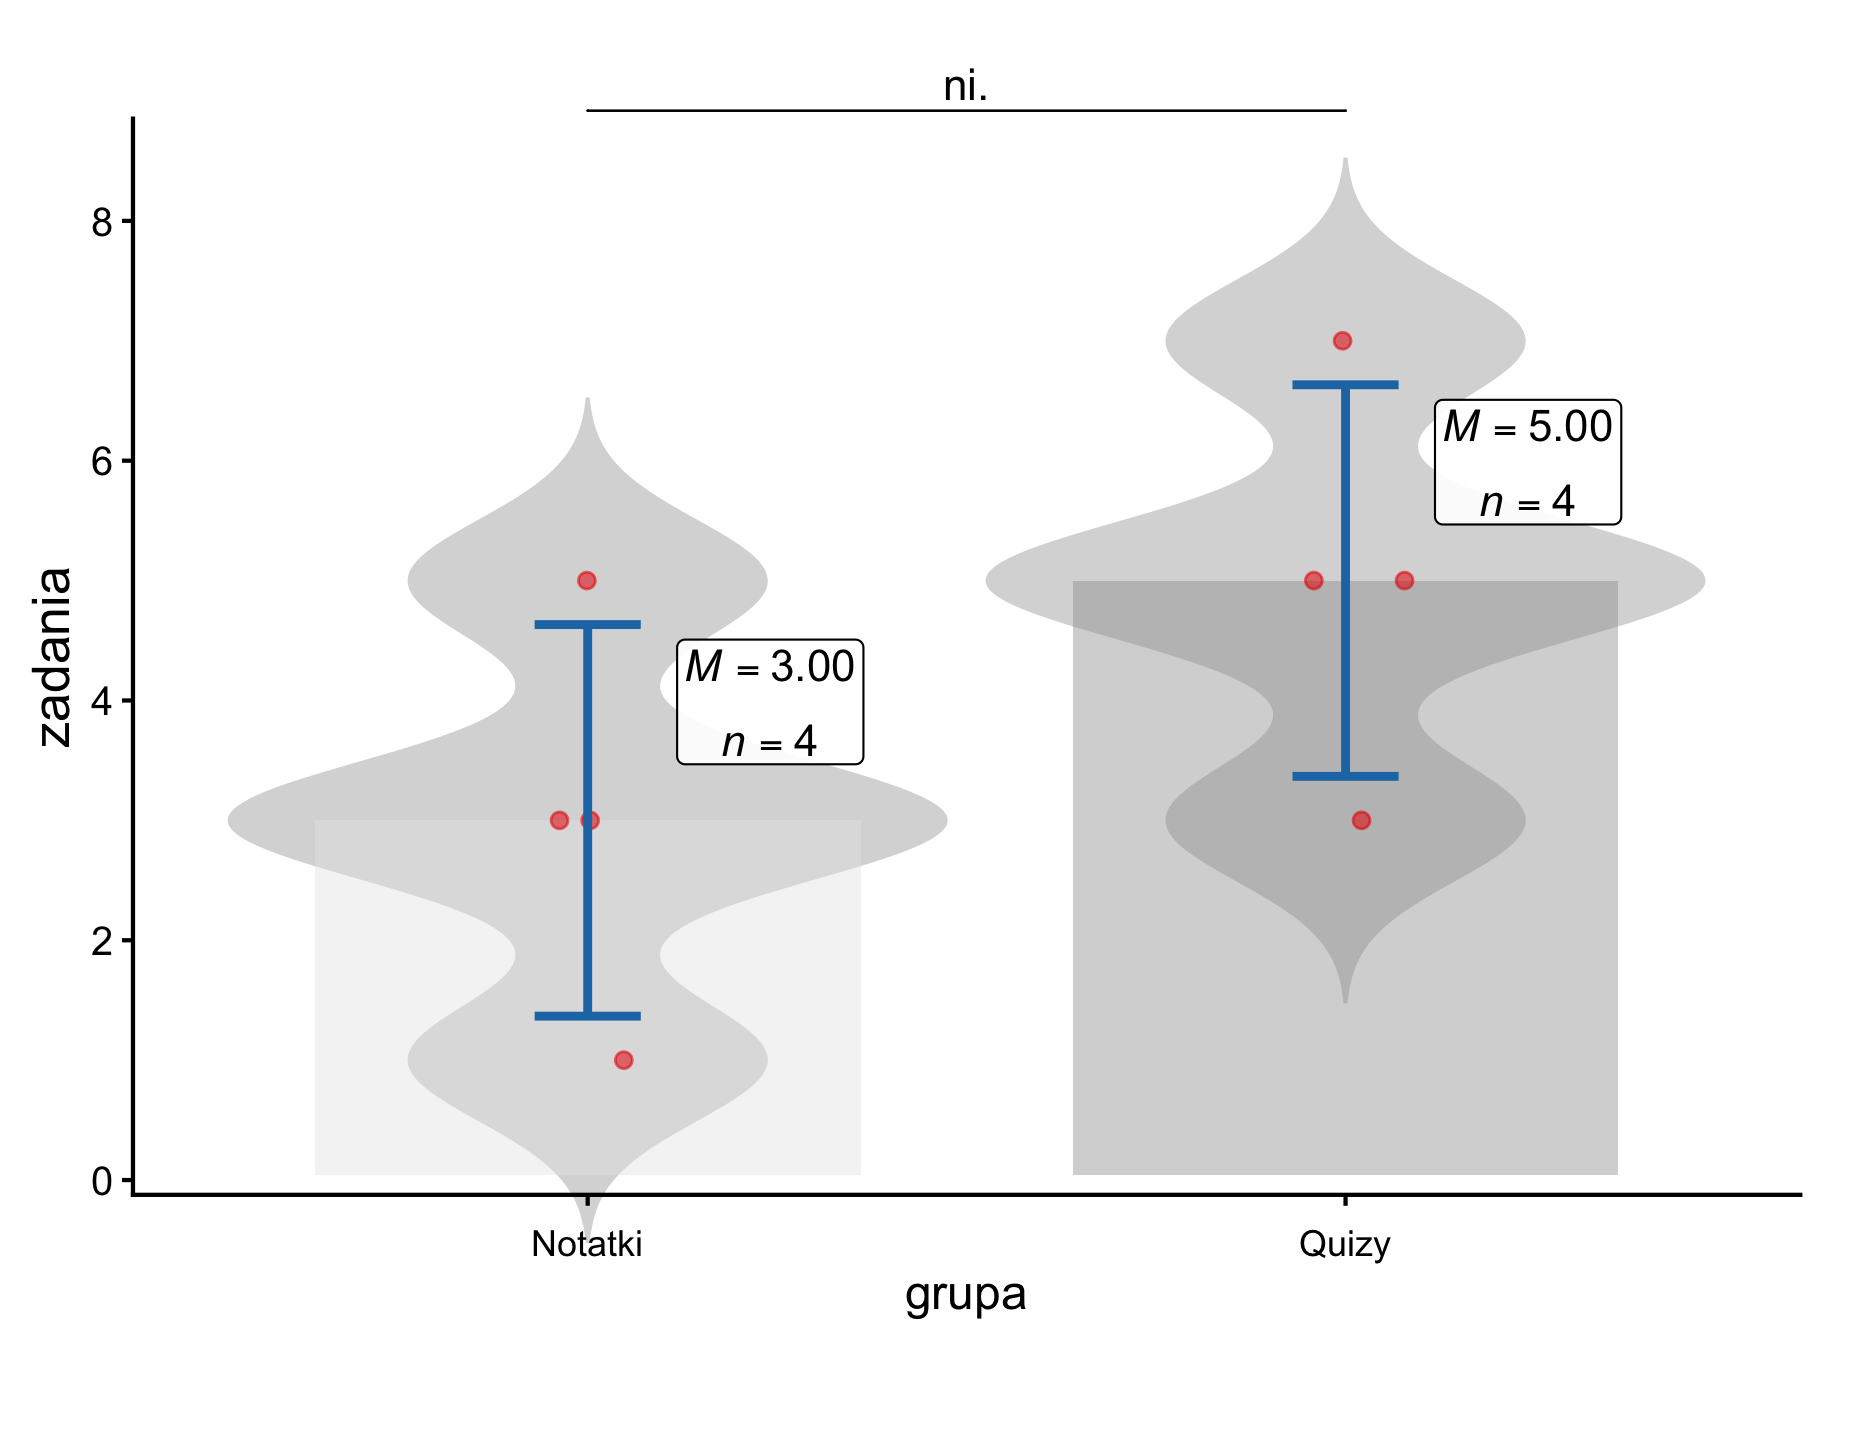
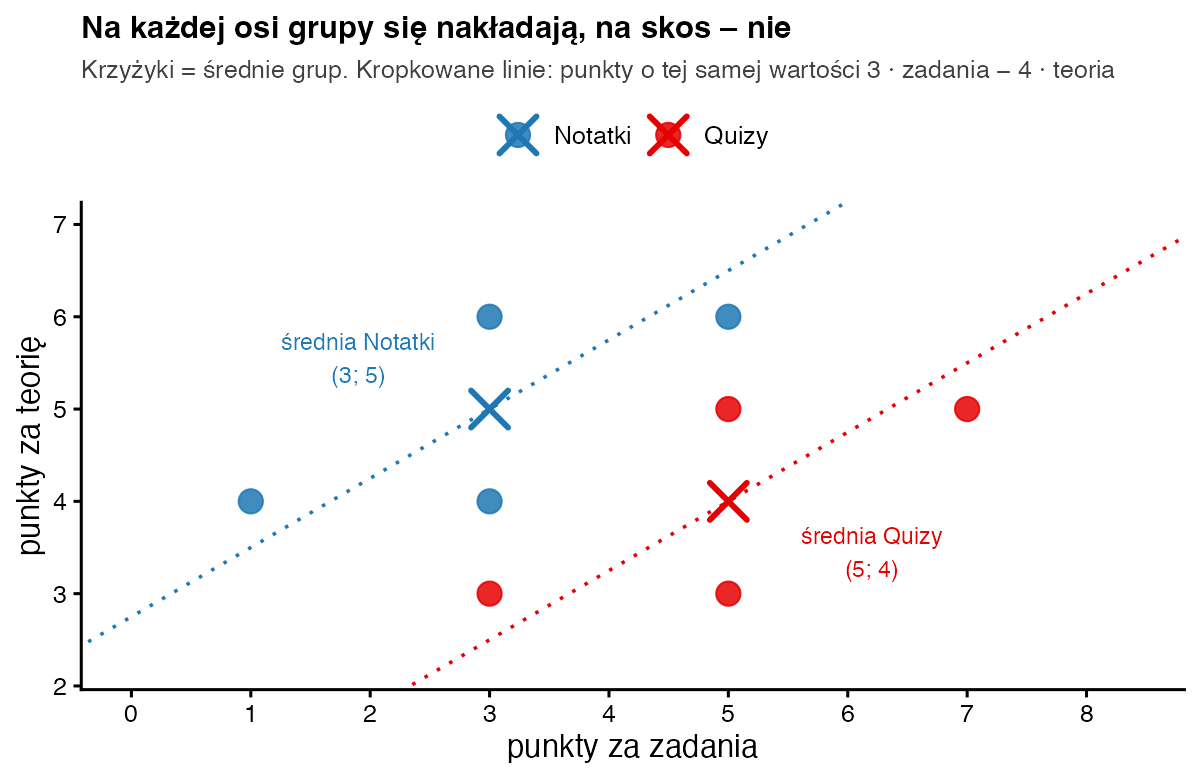
Po 4 studentów uczyło się z notatek i z quizów. Na kolokwium dostali osobno punkty za zadania i za teorię. Dla każdej osoby liczymy odchylenia od średniej jej grupy (Notatki: zadania 3, teoria 5; Quizy: zadania 5, teoria 4).
| Grupa | Zadania | Teoria | a = zad − M | b = teo − M | a² | b² | a · b |
|---|---|---|---|---|---|---|---|
| Notatki | 1 | 4 | 1 − 3 = −2 | 4 − 5 = −1 | 4 | 1 | 2 |
| Notatki | 3 | 6 | 3 − 3 = 0 | 6 − 5 = 1 | 0 | 1 | 0 |
| Notatki | 3 | 4 | 3 − 3 = 0 | 4 − 5 = −1 | 0 | 1 | 0 |
| Notatki | 5 | 6 | 5 − 3 = 2 | 6 − 5 = 1 | 4 | 1 | 2 |
| Quizy | 3 | 3 | 3 − 5 = −2 | 3 − 4 = −1 | 4 | 1 | 2 |
| Quizy | 5 | 5 | 5 − 5 = 0 | 5 − 4 = 1 | 0 | 1 | 0 |
| Quizy | 5 | 3 | 5 − 5 = 0 | 3 − 4 = −1 | 0 | 1 | 0 |
| Quizy | 7 | 5 | 7 − 5 = 2 | 5 − 4 = 1 | 4 | 1 | 2 |
| Σ | 32 | 36 | 0 | 0 | 16 | 8 | 8 |
- Średnie. Notatki: zadania (1 + 3 + 3 + 5) / 4 = 3, teoria (4 + 6 + 4 + 6) / 4 = 5. Quizy: zadania 20 / 4 = 5, teoria 16 / 4 = 4. Średnie ogólne: 32 / 8 = 4 oraz 36 / 8 = 4,5. Quizy mają więcej punktów za zadania (+2), ale mniej za teorię (−1).
- Macierz E. Z sum w tabeli: \(\mathbf{E} = \begin{bmatrix} 16 & 8 \\ 8 & 8 \end{bmatrix}\). Dodatnia liczba 8 poza przekątną znaczy, że w obu grupach kto ma więcej za zadania, ma też więcej za teorię (korelacja 8 / √(16 · 8) = 0,707).
- Macierz H. Odchylenia średnich grup od średnich ogólnych: Notatki (3 − 4; 5 − 4,5) = (−1; 0,5), Quizy (1; −0,5). Każdy element mnożymy przez 4 osoby: H11 = 4 · (1 + 1) = 8; H22 = 4 · (0,25 + 0,25) = 2; H12 = 4 · (−0,5 − 0,5) = −4. Czyli \(\mathbf{H} = \begin{bmatrix} 8 & -4 \\ -4 & 2 \end{bmatrix}\).
- Macierz całkowita i jej odwrotność. \(\mathbf{H} + \mathbf{E} = \begin{bmatrix} 24 & 4 \\ 4 & 10 \end{bmatrix}\). Wyznacznik: 24 · 10 − 4 · 4 = 240 − 16 = 224. Odwrotność macierzy 2 × 2: zamieniasz miejscami liczby na przekątnej, zmieniasz znak pozostałych i dzielisz przez wyznacznik: \(\frac{1}{224}\begin{bmatrix} 10 & -4 \\ -4 & 24 \end{bmatrix}\).
- Ślad iloczynu. Potrzebujesz tylko przekątnej \(\mathbf{H}(\mathbf{H}+\mathbf{E})^{-1}\): pierwszy element (8 · 10 + (−4) · (−4)) / 224 = 96 / 224; drugi ((−4) · (−4) + 2 · 24) / 224 = 64 / 224. V = (96 + 64) / 224 = 160 / 224 = 0,714.
- Statystyka F. V / (1 − V) = 0,714 / 0,286 = 2,5 (dokładnie: 160 / 64). F = 2,5 · (8 − 2 − 1) / 2 = 2,5 · 5 / 2 = 6,25; df = 2 i 5.
- Wartość p. Wartość krytyczna F dla α = 0,05 i df = (2, 5) z tablic to 5,786 (w R:
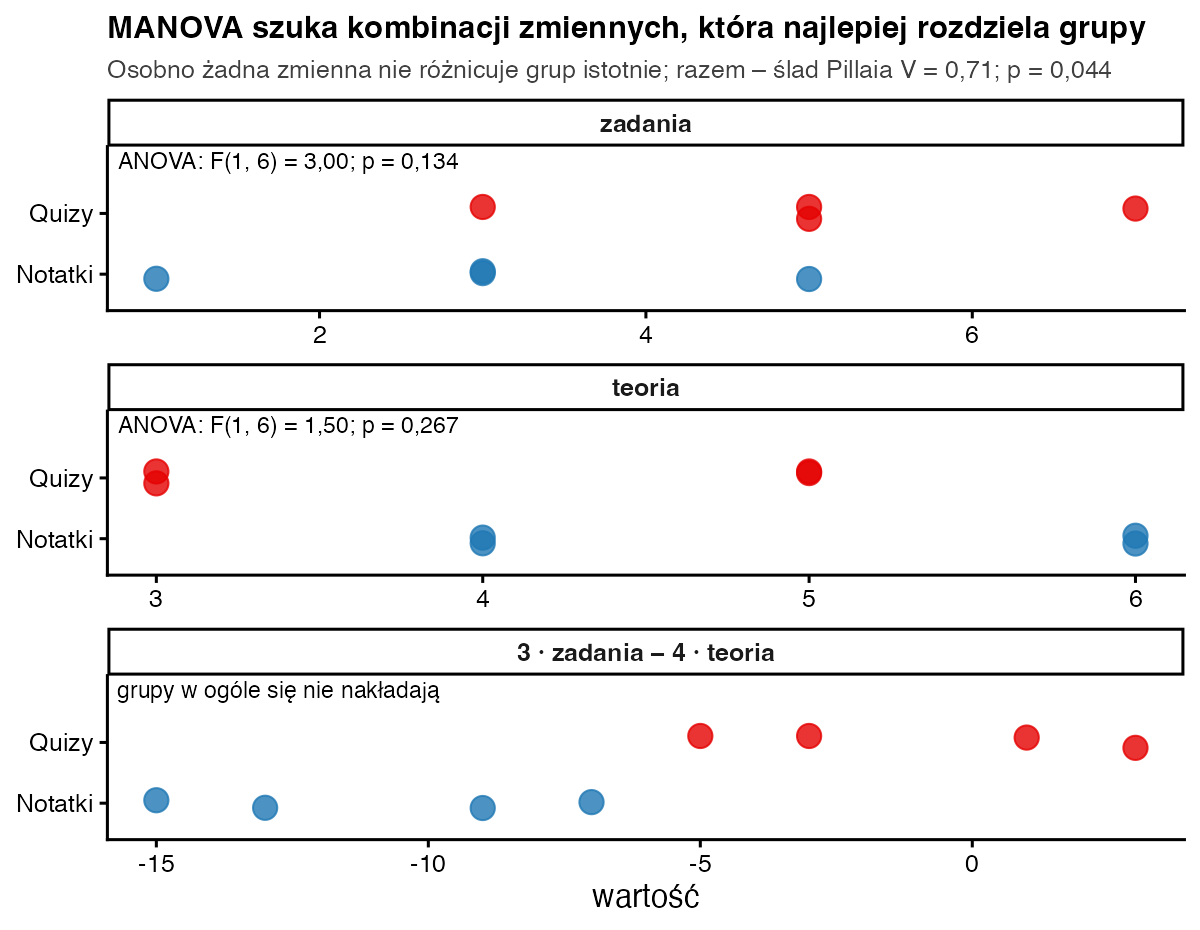
qf(0.95, 2, 5)). Nasze 6,25 ją przekracza; dokładnie p = 0,044 (w R:pf(6.25, 2, 5, lower.tail = FALSE)). - Dla porównania – osobne ANOVA. Zadania: F = (8 / 1) / (16 / 6) = 8 / 2,667 = 3,00; p = 0,134. Teoria: F = (2 / 1) / (8 / 6) = 2 / 1,333 = 1,50; p = 0,267. Liczniki to przekątna H, mianowniki – przekątna E podzielona przez 6 stopni swobody.
Jak zinterpretować i opisać wynik?
Ślad Pillaia V = 0,71 i p = 0,044 oznaczają, że grupy różnią się układem obu wyników łącznie. Nie oznacza to, że różnią się każdą zmienną osobno – tu żadna osobna ANOVA nie jest istotna. Różnica dotyczy profilu: w porównaniu z Notatkami Quizy wypadają lepiej w zadaniach, a słabiej w teorii. Przy dwóch grupach cząstkowe eta kwadrat równa się V (0,71). Po istotnej MANOVA opisz, które zmienne lub jaka ich kombinacja odpowiadają za różnicę. Pamiętaj: 4 osoby w grupie to tylko ilustracja rachunku.
Zapis w stylu APA: Jednoczynnikowa MANOVA wykazała istotną różnicę między grupami Notatki i Quizy w łącznym układzie punktów za zadania i za teorię, V = 0,71; F(2, 5) = 6,25; p = 0,044; η²p = 0,71. Osobne analizy wariancji nie wykazały istotnych różnic ani dla zadań, F(1, 6) = 3,00; p = 0,134, ani dla teorii, F(1, 6) = 1,50; p = 0,267.
Jak policzyć MANOVA w R?
# Dwie grupy po 4 osoby, dwie zmienne zależne: punkty za zadania i za teorię
dane <- data.frame(grupa   = rep(c("Notatki", "Quizy"), each = 4),
                   zadania = c(1, 3, 3, 5,  3, 5, 5, 7),
                   teoria  = c(4, 6, 4, 6,  3, 5, 3, 5))
Y <- as.matrix(dane[, c("zadania", "teoria")])

# 1) „ręcznie”: macierze E (wewnątrz grup) i H (między grupami), ślad Pillaia
Mg <- rowsum(Y, dane$grupa) / 4                 # średnie w grupach
E  <- crossprod(Y - Mg[dane$grupa, ])           # [16 8; 8 8]
H  <- 4 * crossprod(sweep(Mg, 2, colMeans(Y)))  # [8 -4; -4 2]
V  <- sum(diag(H %*% solve(H + E)))             # ślad Pillaia
F  <- V / (1 - V) * (8 - 2 - 1) / 2             # df = 2 i 5
round(c(V = V, F = F, p = pf(F, 2, 5, lower.tail = FALSE)), 4)

# 2) gotowa funkcja
fit <- manova(cbind(zadania, teoria) ~ grupa, data = dane)
summary(fit, test = "Pillai")
summary.aov(fit)                                 # osobne ANOVA
Wynik w konsoli R:
     V      F      p
0.7143 6.2500 0.0436
          Df  Pillai approx F num Df den Df  Pr(>F)
grupa      1 0.71429     6.25      2      5 0.04363 *
Residuals  6
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

 Response zadania :
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        1      8  8.0000       3  0.134
Residuals    6     16  2.6667

 Response teoria :
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        1      2  2.0000     1.5 0.2666
Residuals    6      8  1.3333
Rachunek na macierzach i manova() z summary(test = "Pillai") dają to samo: V = 0,714; F = 6,25; p = 0,044. summary.aov() pokazuje osobne ANOVA dla każdej zmiennej. Inne statystyki (lambda Wilksa, ślad Hotellinga, największy pierwiastek Roya) uzyskasz, zmieniając argument test; przy dwóch grupach wszystkie dają to samo F.
MANOVA czy kilka osobnych ANOVA?
Wybierz MANOVA, gdy pytanie badawcze dotyczy zestawu zmiennych jako całości – np. „czy metoda nauki zmienia profil wyników”. Wybierz osobne ANOVA (z poprawką na wielokrotne testy), gdy każda zmienna to osobne pytanie. Częsty mit: „najpierw MANOVA, a potem ANOVA, bo MANOVA chroni przed błędem I rodzaju”. Huberty i Morris (1989) pokazali, że taka ochrona jest złudna i że po MANOVA lepiej zbadać kombinację zmiennych (np. analizą dyskryminacyjną). Ślad Pillaia jest najbardziej odporny na naruszenia założeń, zwłaszcza na różne macierze kowariancji w grupach, dlatego to dobry wybór domyślny (Olson, 1976). Założenia sprawdzasz podobnie jak w ANOVA: niezależność obserwacji, normalność reszt każdej zmiennej, podobne wariancje (test Levene’a dla każdej zmiennej) i podobne kowariancje (test M Boxa).
Najczęstsze błędy
- Wrzucanie do MANOVA zupełnie niepowiązanych zmiennych „żeby było jedno p”.
- Traktowanie MANOVA jako ochrony przed błędem I rodzaju dla późniejszych osobnych ANOVA.
- Zbyt mało osób: w każdej grupie powinno być więcej osób niż zmiennych zależnych, a najlepiej kilkadziesiąt.
- Pisanie „grupy różnią się każdą zmienną”, gdy istotna jest tylko MANOVA.
- Niepodanie, którą statystykę wielowymiarową raportujesz (Pillai, Wilks, Hotelling, Roy).
Bibliografia
- Pillai, K. C. S. (1955). Some new test criteria in multivariate analysis. The Annals of Mathematical Statistics, 26(1), 117–121. https://doi.org/10.1214/aoms/1177728599
- Olson, C. L. (1976). On choosing a test statistic in multivariate analysis of variance. Psychological Bulletin, 83(4), 579–586. https://doi.org/10.1037/0033-2909.83.4.579
- Huberty, C. J., & Morris, J. D. (1989). Multivariate analysis versus multiple univariate analyses. Psychological Bulletin, 105(2), 302–308. https://doi.org/10.1037/0033-2909.105.2.302
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówJednoczynnikowa ANOVA
- Słownik wzorówCząstkowe η² i ω²
- Słownik wzorówAnaliza kowariancji (ANCOVA)
- PoradnikANOVA – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza wariancji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.