

Przedział ufności dla korelacji – wzór i przykład
Przedział ufności dla korelacji pokazuje, jak silny może być związek dwóch zmiennych w całej populacji, skoro w próbie wyszło konkretne r. Typowe pytanie z pracy dyplomowej: korelacja godzin nauki z punktami z kolokwium wyniosła r = 0,50 – czy to na pewno związek silny, czy równie dobrze może być słaby?
W prostych słowachKorelacja z małej próby bardzo „skacze” – w innej grupie studentów mogłoby wyjść 0,3 albo 0,7. Przedział ufności pokazuje ten zakres. Korelacji nie da się jednak potraktować zwykłym wzorem „wynik ± margines”, bo r nie może przekroczyć 1. Dlatego najpierw zamieniamy r na inną skalę, tam liczymy przedział, a potem wracamy.
Kiedy stosować przedział ufności dla korelacji?
- policzyłeś korelację Pearsona i chcesz pokazać, jak precyzyjne jest to oszacowanie;
- chcesz ocenić, czy związek może być słaby, umiarkowany czy silny – sama wartość p tego nie mówi;
- porównujesz swój wynik z innymi badaniami: jeśli ich r mieści się w Twoim przedziale, wyniki są ze sobą zgodne;
- obie zmienne są ilościowe, a ich rozkład łączny jest zbliżony do normalnego (bez silnych wartości odstających).
Dla korelacji Spearmana stosuje się tę samą transformację z nieco większym błędem standardowym (opis niżej). Ten sam pomysł – oszacowanie ± margines – znajdziesz w haśle przedział ufności dla średniej. Jeśli chcesz zrozumieć, z czego bierze się samo r, zajrzyj do hasła o kowariancji.
Wzór na przedział ufności dla korelacji (transformacja Fishera)
- \(r\)
- korelacja Pearsona z próby
- \(z'\)
- „z Fishera” – korelacja przeniesiona na skalę bez górnego i dolnego limitu; w R to
atanh(r) - \(\ln\)
- logarytm naturalny (klawisz „ln” w kalkulatorze)
- \(n\)
- liczba osób (par wyników)
- \(SE\)
- błąd standardowy z' – zależy tylko od liczby osób, a nie od samego r
- \(1{,}96\)
- wartość z rozkładu normalnego dla 95% ufności
- \(z'_{d},\ z'_{g}\)
- dolna i górna granica przedziału na skali z'
- \(e\)
- liczba Eulera (ok. 2,718); \(e^{x}\) to klawisz „exp” – działanie odwrotne do ln
- \(r_{d},\ r_{g}\)
- granice przedziału z powrotem na skali korelacji; w R to
tanh()
Wzór przeczytasz na głos tak: „zamień r na z Fishera, dodaj i odejmij 1,96 razy jeden przez pierwiastek z n minus 3, a obie granice zamień z powrotem na korelację”.
Przykład krok po kroku
W grupie 28 studentów korelacja godzin nauki z punktami z kolokwium wyniosła r = 0,50. Tabela pokazuje drogę powrotną z z' do r dla obu granic (i dla środka, jako sprawdzenie):
| Punkt | z' | 2 · z' | e2z' | e2z' − 1 | e2z' + 1 | r = iloraz |
|---|---|---|---|---|---|---|
| dolna granica | 0,1573 | 0,3146 | 1,3697 | 0,3697 | 2,3697 | 0,156 |
| środek (sprawdzenie) | 0,5493 | 1,0986 | 3,0000 | 2,0000 | 4,0000 | 0,500 |
| górna granica | 0,9413 | 1,8826 | 6,5706 | 5,5706 | 7,5706 | 0,736 |
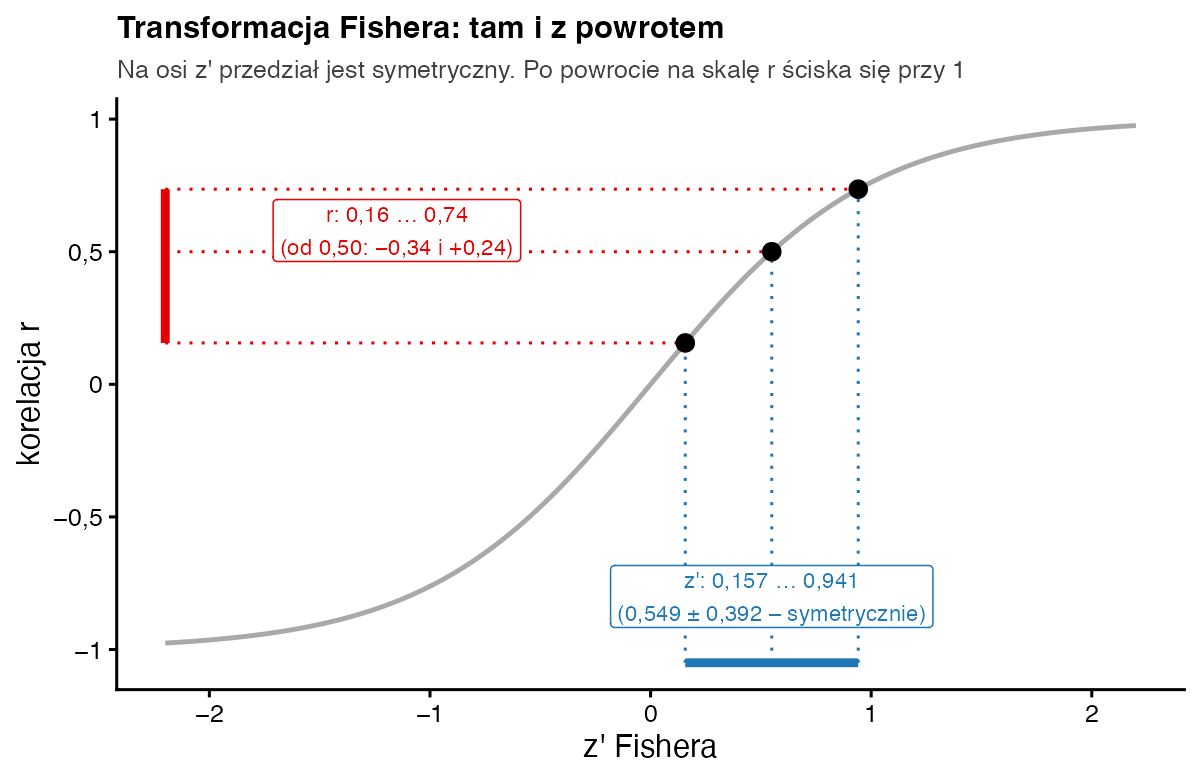
- Zamiana r na z'. (1 + 0,5) / (1 − 0,5) = 1,5 / 0,5 = 3. Logarytm: ln 3 = 1,0986. Połowa: z' = 1,0986 / 2 = 0,5493.
- Błąd standardowy. n − 3 = 28 − 3 = 25; √25 = 5; SE = 1 / 5 = 0,2. Dlatego wybraliśmy 28 osób – wynik jest „okrągły”.
- Margines na skali z'. 1,96 · 0,2 = 0,392. Wartość 1,96 to punkt rozkładu normalnego, poniżej którego leży 97,5% pola (tablica rozkładu normalnego; w R:
qnorm(0.975)). - Granice na skali z'. Dolna: 0,5493 − 0,392 = 0,1573. Górna: 0,5493 + 0,392 = 0,9413. Ten przedział jest symetryczny.
- Powrót do r – dolna granica. 2 · 0,1573 = 0,3146; e0,3146 = 1,3697; (1,3697 − 1) / (1,3697 + 1) = 0,3697 / 2,3697 = 0,156.
- Powrót do r – górna granica. 2 · 0,9413 = 1,8826; e1,8826 = 6,5706; 5,5706 / 7,5706 = 0,736.
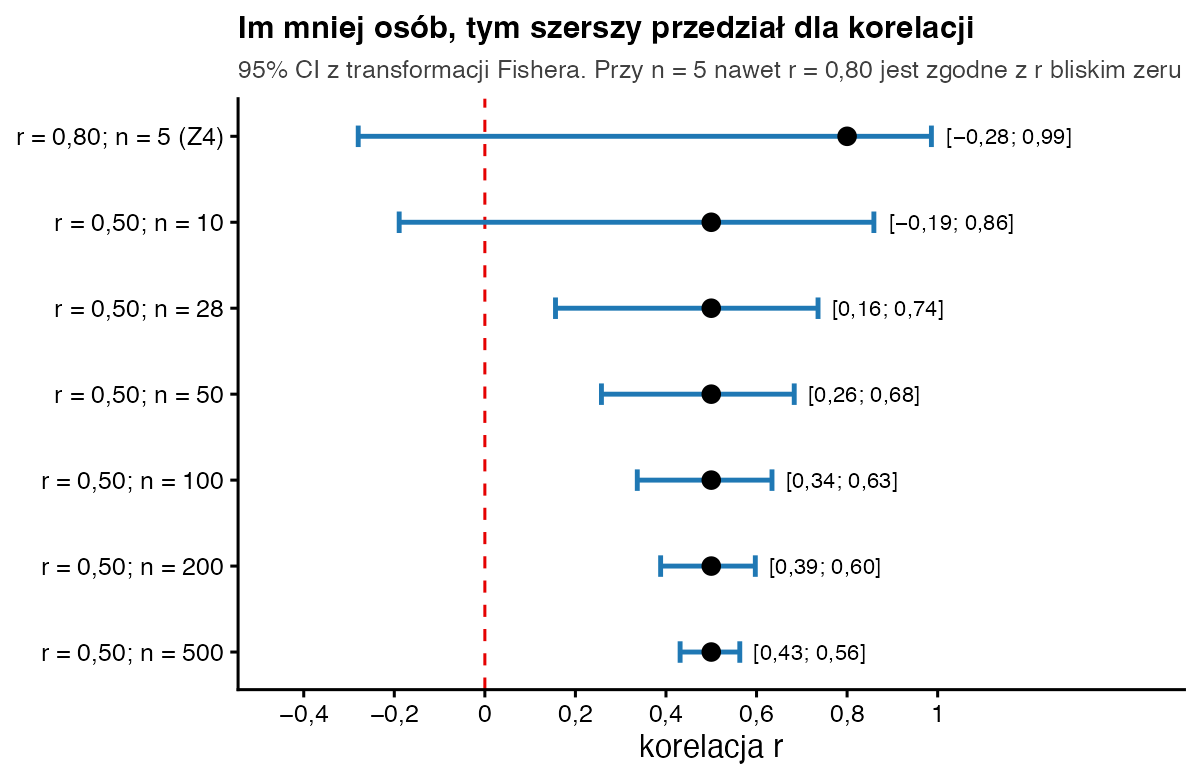
- Wynik. 95% CI dla r: [0,16; 0,74]. Zauważ, że przedział nie jest symetryczny wokół 0,50: w dół sięga o 0,34, a w górę tylko o 0,24, bo im bliżej 1, tym mniej „miejsca”.
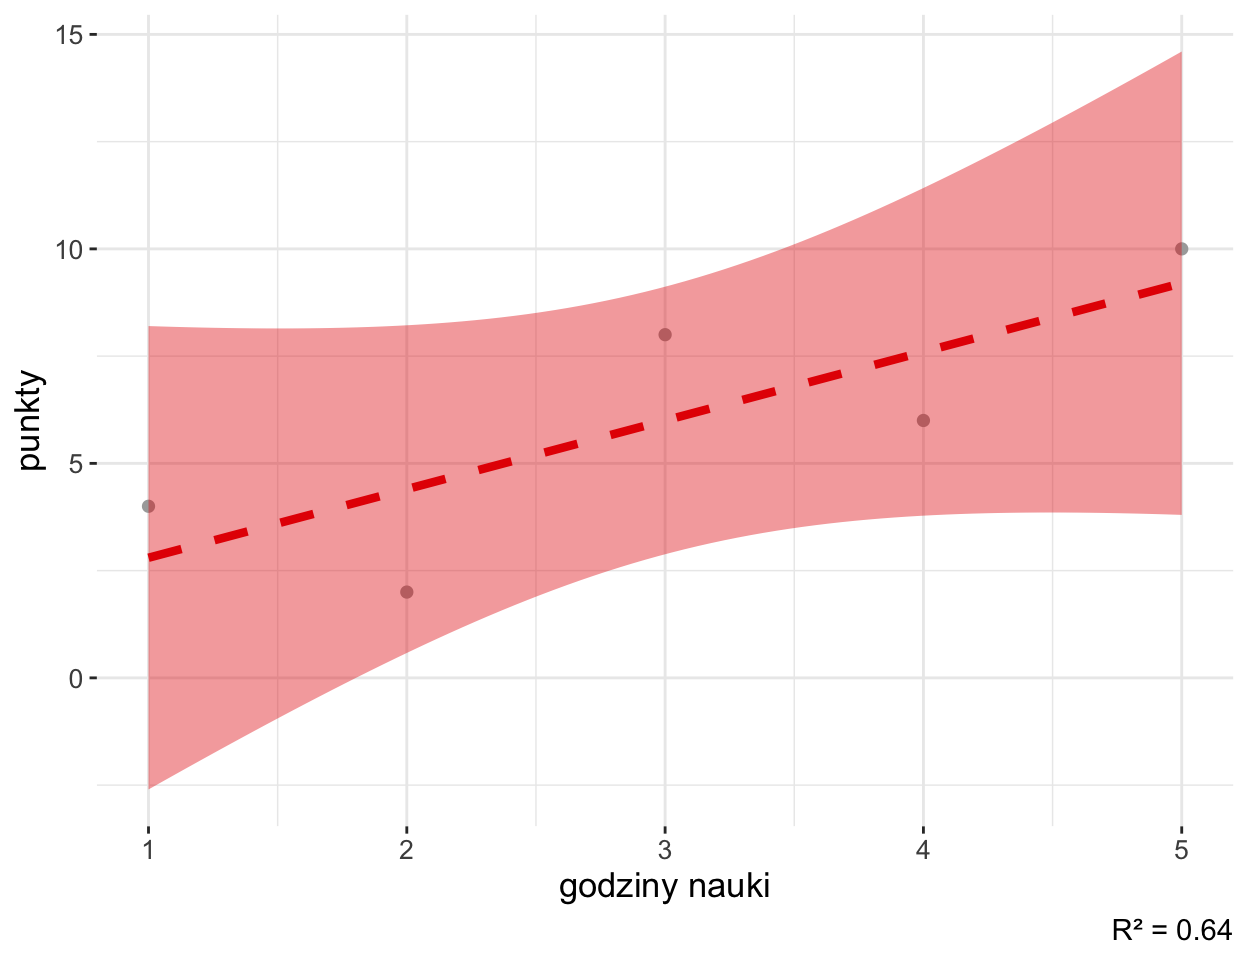
Mała próba – zbiór Z4. W haśle o korelacji Pearsona pięcioro studentów dało r = 0,80. Liczymy tak samo: z' = ½ · ln(1,8 / 0,2) = ½ · ln 9 = ½ · 2,1972 = 1,0986; SE = 1 / √(5 − 3) = 1 / √2 = 0,7071; margines = 1,96 · 0,7071 = 1,386. Granice z': 1,0986 − 1,386 = −0,287 oraz 1,0986 + 1,386 = 2,485. Po powrocie: [−0,28; 0,99]. Przedział obejmuje zarówno brak związku, jak i związek prawie idealny. Tak „silna” korelacja z pięciu osób mówi bardzo niewiele.
Jak zinterpretować i opisać wynik?
Przedział [0,16; 0,74] nie obejmuje zera, więc związek jest istotny statystycznie na poziomie 0,05. Ważniejsze jest jednak to, co mówi o sile związku: dane są zgodne zarówno ze słabą korelacją (około 0,2), jak i z silną (ponad 0,7). Zgodnie z umownymi progami Cohena (1988) – 0,1 słaba, 0,3 umiarkowana, 0,5 silna – nie możesz więc z czystym sumieniem napisać, że związek „jest silny”. Napisz raczej, że oszacowanie wskazuje na związek silny, ale przy tej liczbie osób może on być także słaby. Pamiętaj, że nawet wąski przedział nie dowodzi przyczynowości.
Zapis w stylu APA: Liczba godzin nauki była dodatnio skorelowana z wynikiem kolokwium, r(26) = 0,50; 95% CI [0,16; 0,74].
Jak policzyć przedział ufności dla korelacji w R?
r <- 0.50; n <- 28; z <- qnorm(0.975)   # 1,96

# 1) „ręcznie”: transformacja Fishera tam i z powrotem
z_r <- 0.5 * log((1 + r) / (1 - r))       # to samo co atanh(r)
se  <- 1 / sqrt(n - 3)
granice_z <- z_r + c(-1, 1) * z * se
granice_r <- (exp(2 * granice_z) - 1) / (exp(2 * granice_z) + 1)   # = tanh()
round(c(z_r = z_r, SE = se, z_dolna = granice_z[1], z_gorna = granice_z[2]), 4)
round(granice_r, 3)

# 2) gotowa funkcja z pakietu psych
psych::r.con(r, n)

# 3) zbiór Z4 (n = 5): surowe dane i cor.test()
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)
cor.test(godziny, punkty)$conf.int
Wynik w konsoli R:
    z_r      SE z_dolna z_gorna
 0.5493  0.2000  0.1573  0.9413
[1] 0.156 0.736
[1] 0.1560284 0.7358185
[1] -0.2796400  0.9861962
attr(,"conf.level")
[1] 0.95
Ręczne obliczenia i funkcja psych::r.con() dają ten sam wynik. Dla surowych danych wystarczy cor.test() – podaje przedział Fishera automatycznie, w linii „95 percent confidence interval”.
Jak policzyć przedział ufności dla korelacji Spearmana?
Schemat jest ten sam: zamieniasz rho na z', liczysz granice i wracasz. Zmienia się tylko błąd standardowy – zamiast 1 / √(n − 3) używa się √(1,06 / (n − 3)), czyli przedział jest trochę szerszy (Fieller i in., 1957). Funkcja cor.test(..., method = "spearman") przedziału nie podaje. Możesz policzyć go ręcznie albo metodą bootstrap. Przy kilku osobach żadna metoda nie da wąskiego przedziału – potrzebujesz po prostu więcej danych.
Najczęstsze błędy
- Liczenie przedziału jako r ± 1,96 · SE bez transformacji – granice mogą wtedy wyjść poza 1 albo −1.
- Zapominanie o powrocie z z' do r i podawanie granic na skali z'.
- Opisywanie korelacji jako „silnej” tylko na podstawie r, gdy przedział sięga wartości bliskich zeru.
- Podawanie przedziału dla korelacji z 5–10 osób jak wyniku rozstrzygającego.
- Stosowanie wzoru, gdy jeden punkt odstający „robi” całą korelację – przedział tego nie naprawi; najpierw obejrzyj wykres rozrzutu.
Bibliografia
- Fisher, R. A. (1921). On the “probable error” of a coefficient of correlation deduced from a small sample. Metron, 1, 3–32.
- Fieller, E. C., Hartley, H. O., & Pearson, E. S. (1957). Tests for rank correlation coefficients. I. Biometrika, 44(3–4), 470–481.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówKorelacja Spearmana
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówKowariancja
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.