

Standaryzowany współczynnik β – wzór i przykład krok po kroku
Standaryzowany współczynnik β to współczynnik regresji przeliczony na odchylenia standardowe, dzięki czemu możesz porównać predyktory mierzone w różnych jednostkach. Typowe pytanie z pracy dyplomowej: co silniej przewiduje wynik z kolokwium – godziny nauki czy minuty snu?
W prostych słowachZwykły współczynnik b mówi, o ile punktów zmienia się wynik, gdy predyktor wzrośnie o jedną swoją jednostkę: o godzinę, o minutę, o złotówkę. Kłopot w tym, że minuta i godzina to zupełnie różne „kroki”, więc liczby b nie da się uczciwie zestawić. β zamienia wszystkie zmienne na jedną wspólną miarkę: odchylenie standardowe. Dzięki temu pytasz: o ile odchyleń standardowych zmienia się wynik, gdy predyktor wzrośnie o jedno swoje odchylenie standardowe?
Kiedy stosować współczynnik β?
- masz regresję z kilkoma predyktorami i chcesz wiedzieć, który z nich ma największy udział w przewidywaniu;
- predyktory mają różne jednostki (godziny, minuty, punkty skali, złotówki);
- chcesz porównać wynik z badaniami, w których te same zmienne mierzono innymi narzędziami;
- opisujesz wyniki w stylu APA – czasopisma psychologiczne i pedagogiczne zwykle oczekują podania b i β.
Zwykły współczynnik b wyjaśniamy w haśle o regresji liniowej. W regresji z jednym predyktorem β to po prostu korelacja Pearsona. Sama zamiana wyniku na odchylenia standardowe to wynik standaryzowany z. Jeśli predyktory są ze sobą silnie skorelowane, sprawdź najpierw VIF, bo wtedy β bywa niestabilne.
Wzór na standaryzowany współczynnik β
- \(\beta_j\)
- standaryzowany współczynnik dla j-tego predyktora (czytaj: „beta”)
- \(b_j\)
- zwykły (niestandaryzowany) współczynnik regresji tego predyktora, odczytany z wyniku regresji
- \(s_{x_j}\)
- odchylenie standardowe predyktora – typowa odległość wyników od średniej, w jego własnych jednostkach
- \(s_y\)
- odchylenie standardowe zmiennej wyjaśnianej (np. punktów z kolokwium)
- \(j\)
- numer predyktora: 1 dla godzin nauki, 2 dla snu itd.
Jak przeczytać wzór na głos: „beta to zwykły współczynnik pomnożony przez odchylenie standardowe predyktora i podzielony przez odchylenie standardowe wyniku”. Mnożenie przez sx zamienia „krok o jedną jednostkę” na „krok o jedno odchylenie standardowe”. Dzielenie przez sy wyraża zmianę wyniku w odchyleniach standardowych zamiast w punktach.
Przykład krok po kroku
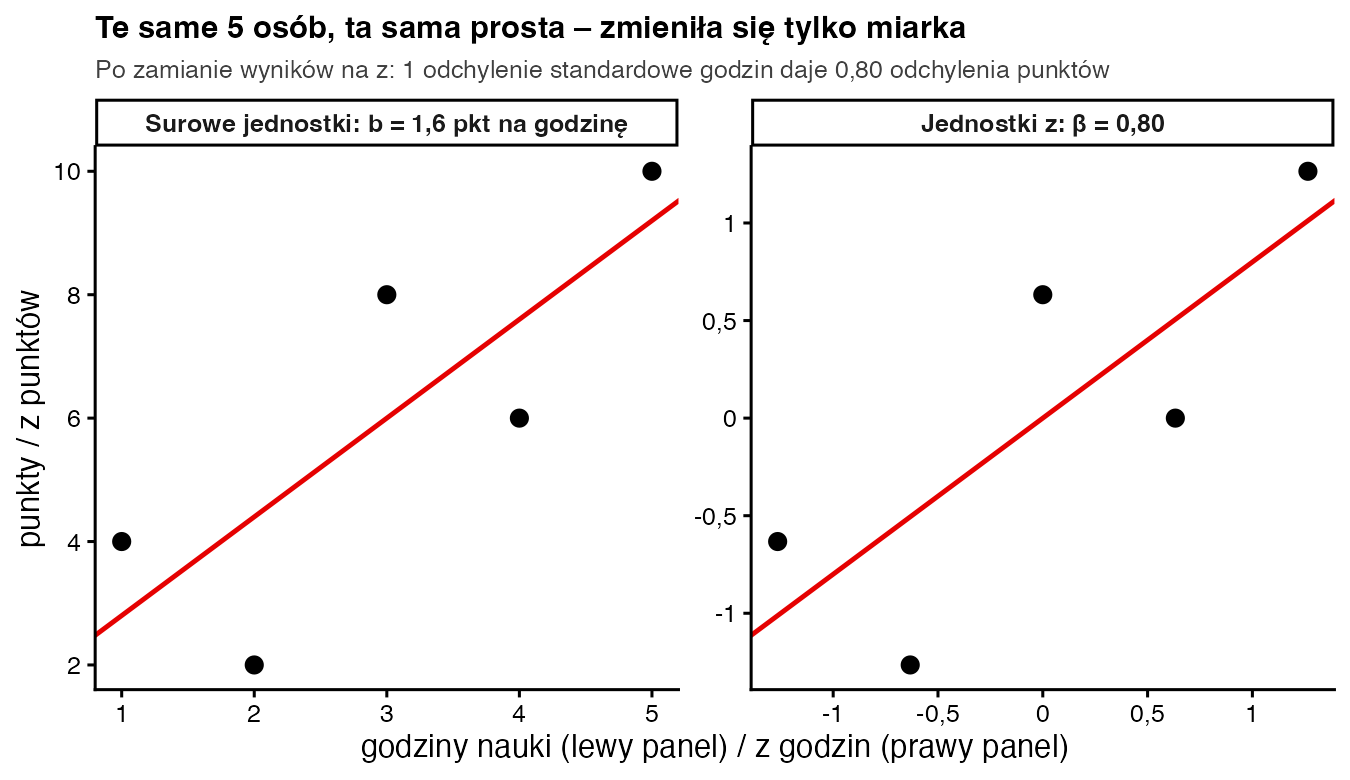
Część 1: jeden predyktor. Pięcioro studentów zapisało godziny nauki (x) i punkty z kolokwium (y). To te same dane co w hasłach o korelacji i regresji. Prosta regresji ma postać ŷ = 1,2 + 1,6x, więc b = 1,6 punktu na godzinę.
| x | x − 3 | (x − 3)² | y | y − 6 | (y − 6)² |
|---|---|---|---|---|---|
| 1 | 1 − 3 = −2 | 4 | 4 | 4 − 6 = −2 | 4 |
| 2 | 2 − 3 = −1 | 1 | 2 | 2 − 6 = −4 | 16 |
| 3 | 3 − 3 = 0 | 0 | 8 | 8 − 6 = 2 | 4 |
| 4 | 4 − 3 = 1 | 1 | 6 | 6 − 6 = 0 | 0 |
| 5 | 5 − 3 = 2 | 4 | 10 | 10 − 6 = 4 | 16 |
| Σ = 15 | 0 | 10 | Σ = 30 | 0 | 40 |
- Średnie. Średnia godzin: 15 / 5 = 3. Średnia punktów: 30 / 5 = 6.
- Odchylenie standardowe x. Suma kwadratów odchyleń wynosi 10. Dzielimy przez n − 1 = 4: 10 / 4 = 2,5. Pierwiastek: sx = √2,5 = 1,581.
- Odchylenie standardowe y. 40 / 4 = 10, więc sy = √10 = 3,162.
- Stosunek odchyleń. 1,581 / 3,162 = 0,5 (dokładnie, bo √2,5 / √10 = √0,25 = 0,5).
- β. β = 1,6 · 0,5 = 0,80. To dokładnie korelacja r = 0,80 z hasła o korelacji Pearsona – przy jednym predyktorze tak jest zawsze.
Część 2: dwa predyktory w różnych jednostkach. Inna piątka studentów podała godziny nauki i minuty snu przed kolokwium.
| godziny x₁ | x₁ − 3 | (x₁ − 3)² | sen x₂ (min) | x₂ − 420 | (x₂ − 420)² | punkty y | y − 8 | (y − 8)² |
|---|---|---|---|---|---|---|---|---|
| 1 | −2 | 4 | 380 | −40 | 1600 | 3 | −5 | 25 |
| 1 | −2 | 4 | 460 | 40 | 1600 | 11 | 3 | 9 |
| 3 | 0 | 0 | 420 | 0 | 0 | 4 | −4 | 16 |
| 5 | 2 | 4 | 380 | −40 | 1600 | 7 | −1 | 1 |
| 5 | 2 | 4 | 460 | 40 | 1600 | 15 | 7 | 49 |
| Σ = 15 | 0 | 16 | Σ = 2100 | 0 | 6400 | Σ = 40 | 0 | 100 |
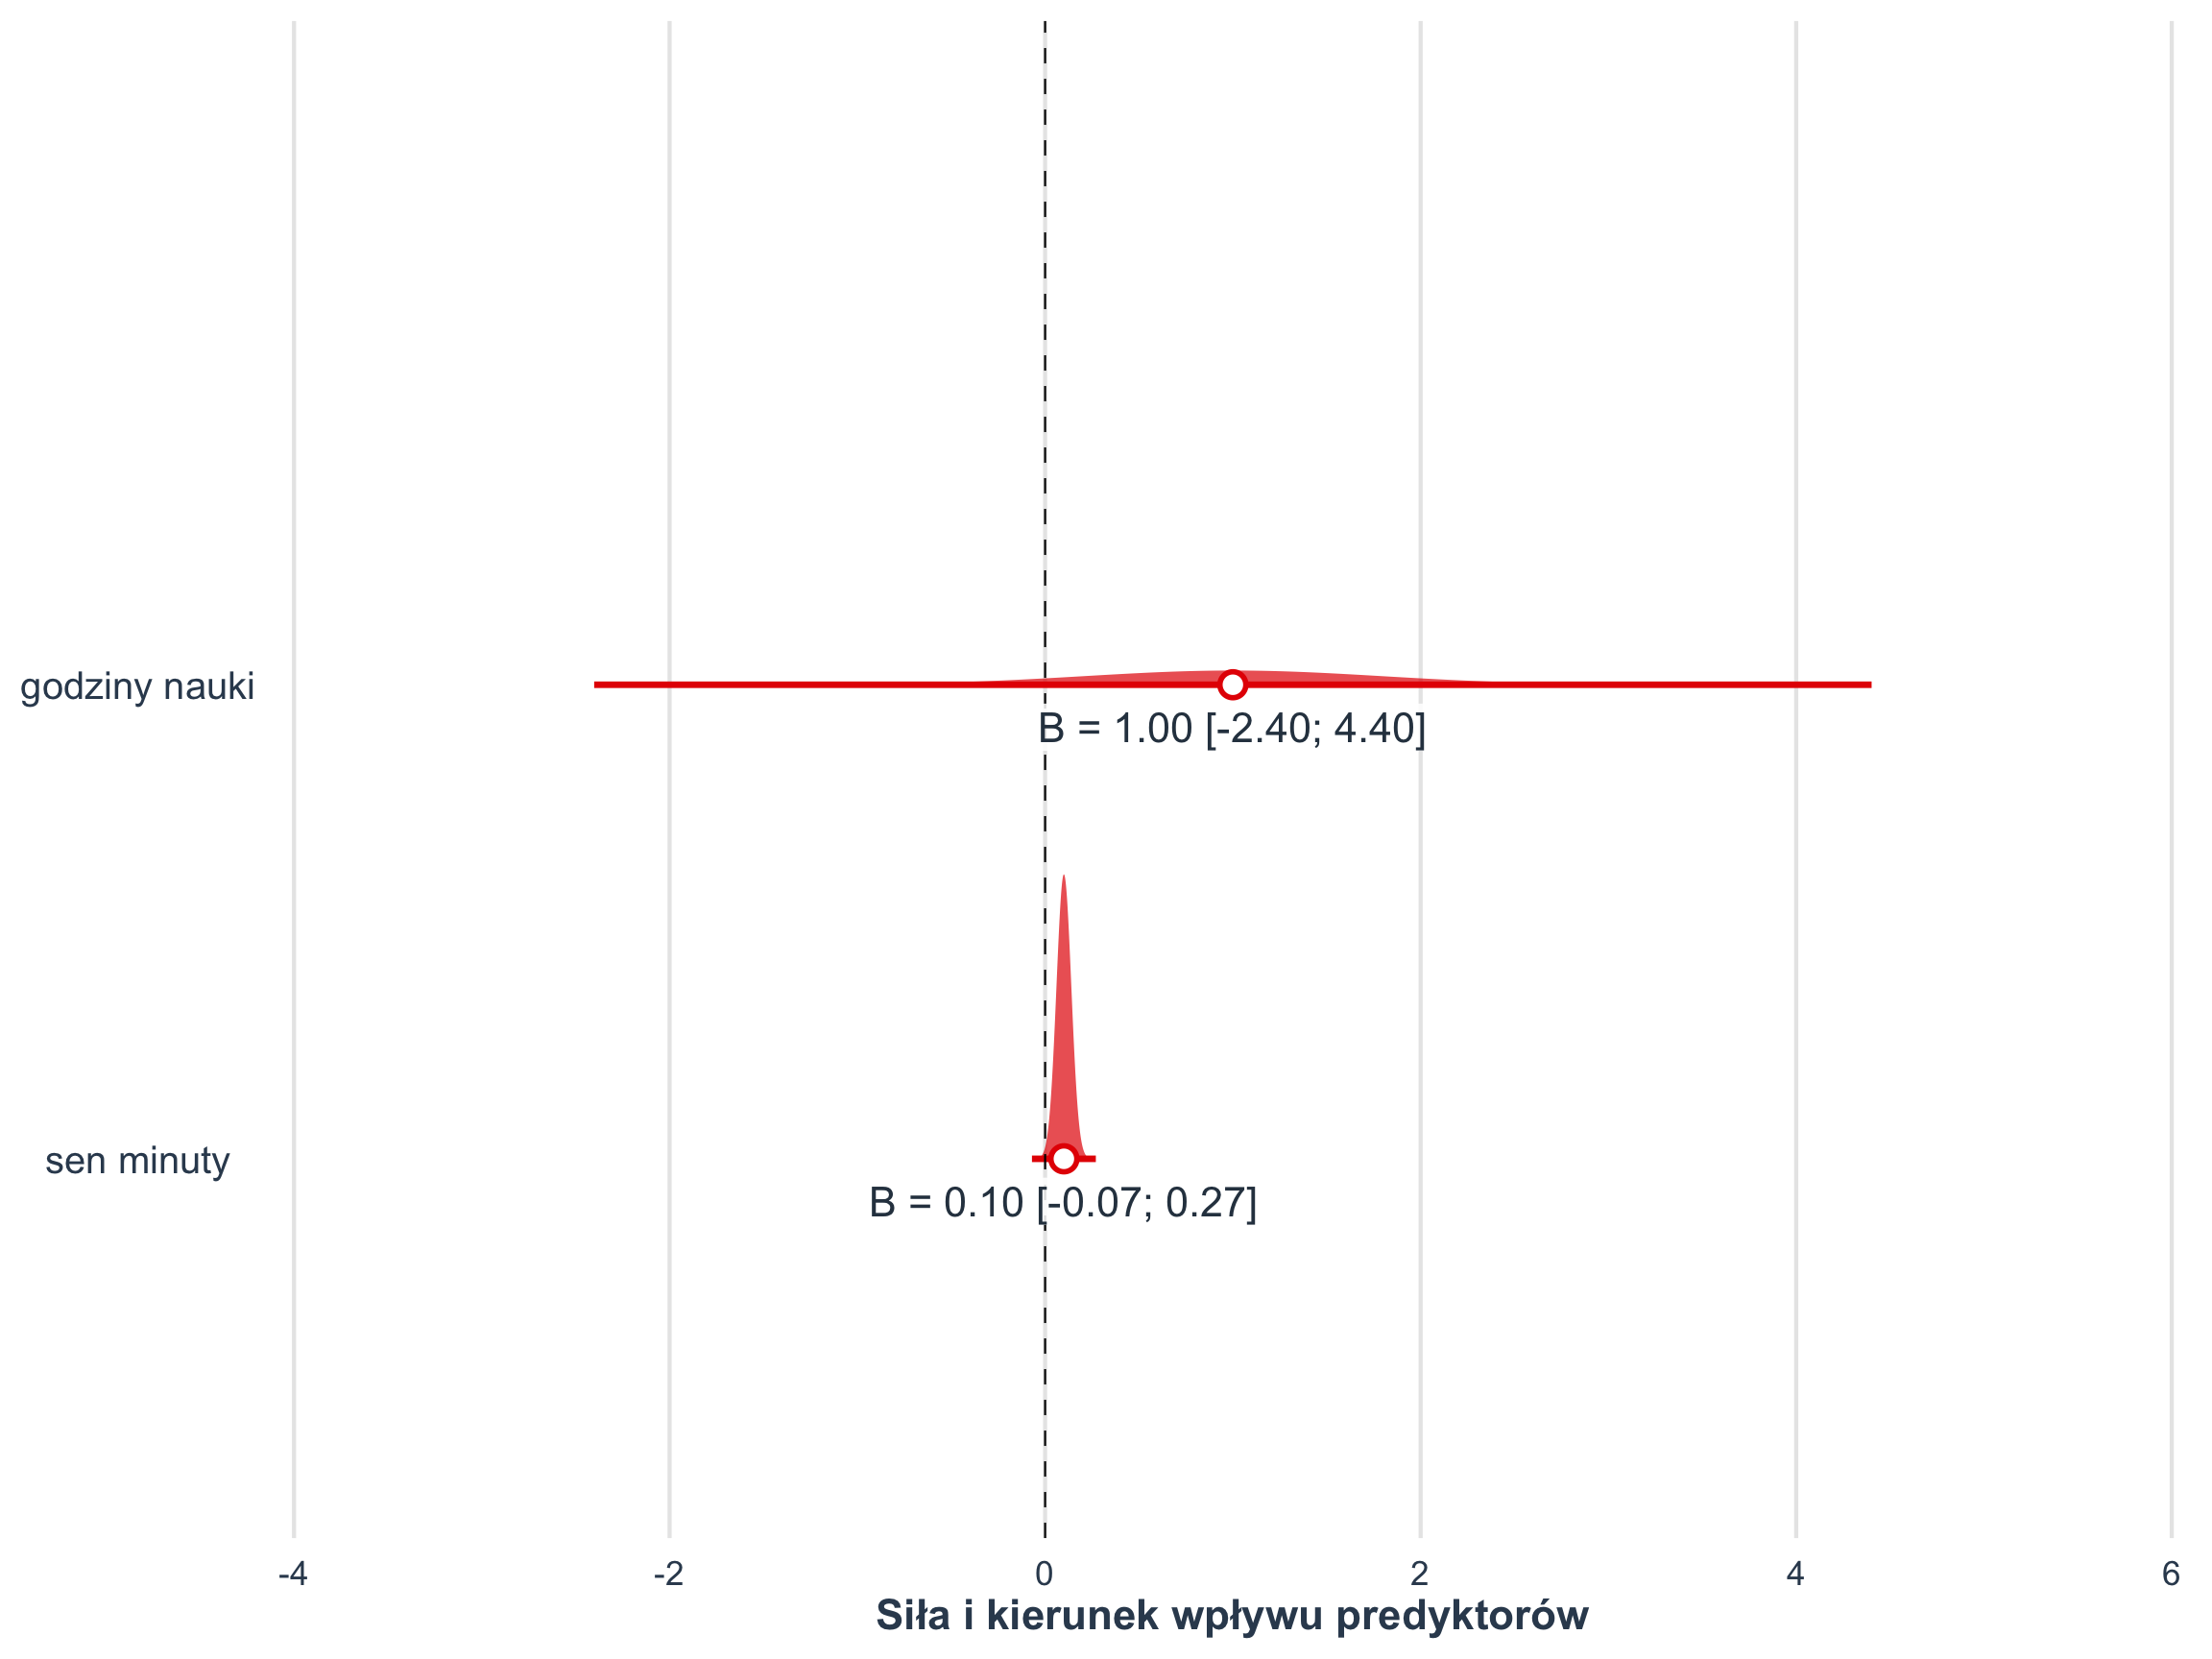
- Współczynniki b. Regresja punktów na obu predyktorach daje ŷ = −37 + 1,0 · godziny + 0,10 · sen. Godzina nauki „daje” 1 punkt, a minuta snu tylko 0,1 punktu. Na pierwszy rzut oka nauka wygląda na dziesięć razy ważniejszą.
- Odchylenia standardowe. sgodziny = √(16 / 4) = √4 = 2 godziny; ssen = √(6400 / 4) = √1600 = 40 minut; sy = √(100 / 4) = √25 = 5 punktów.
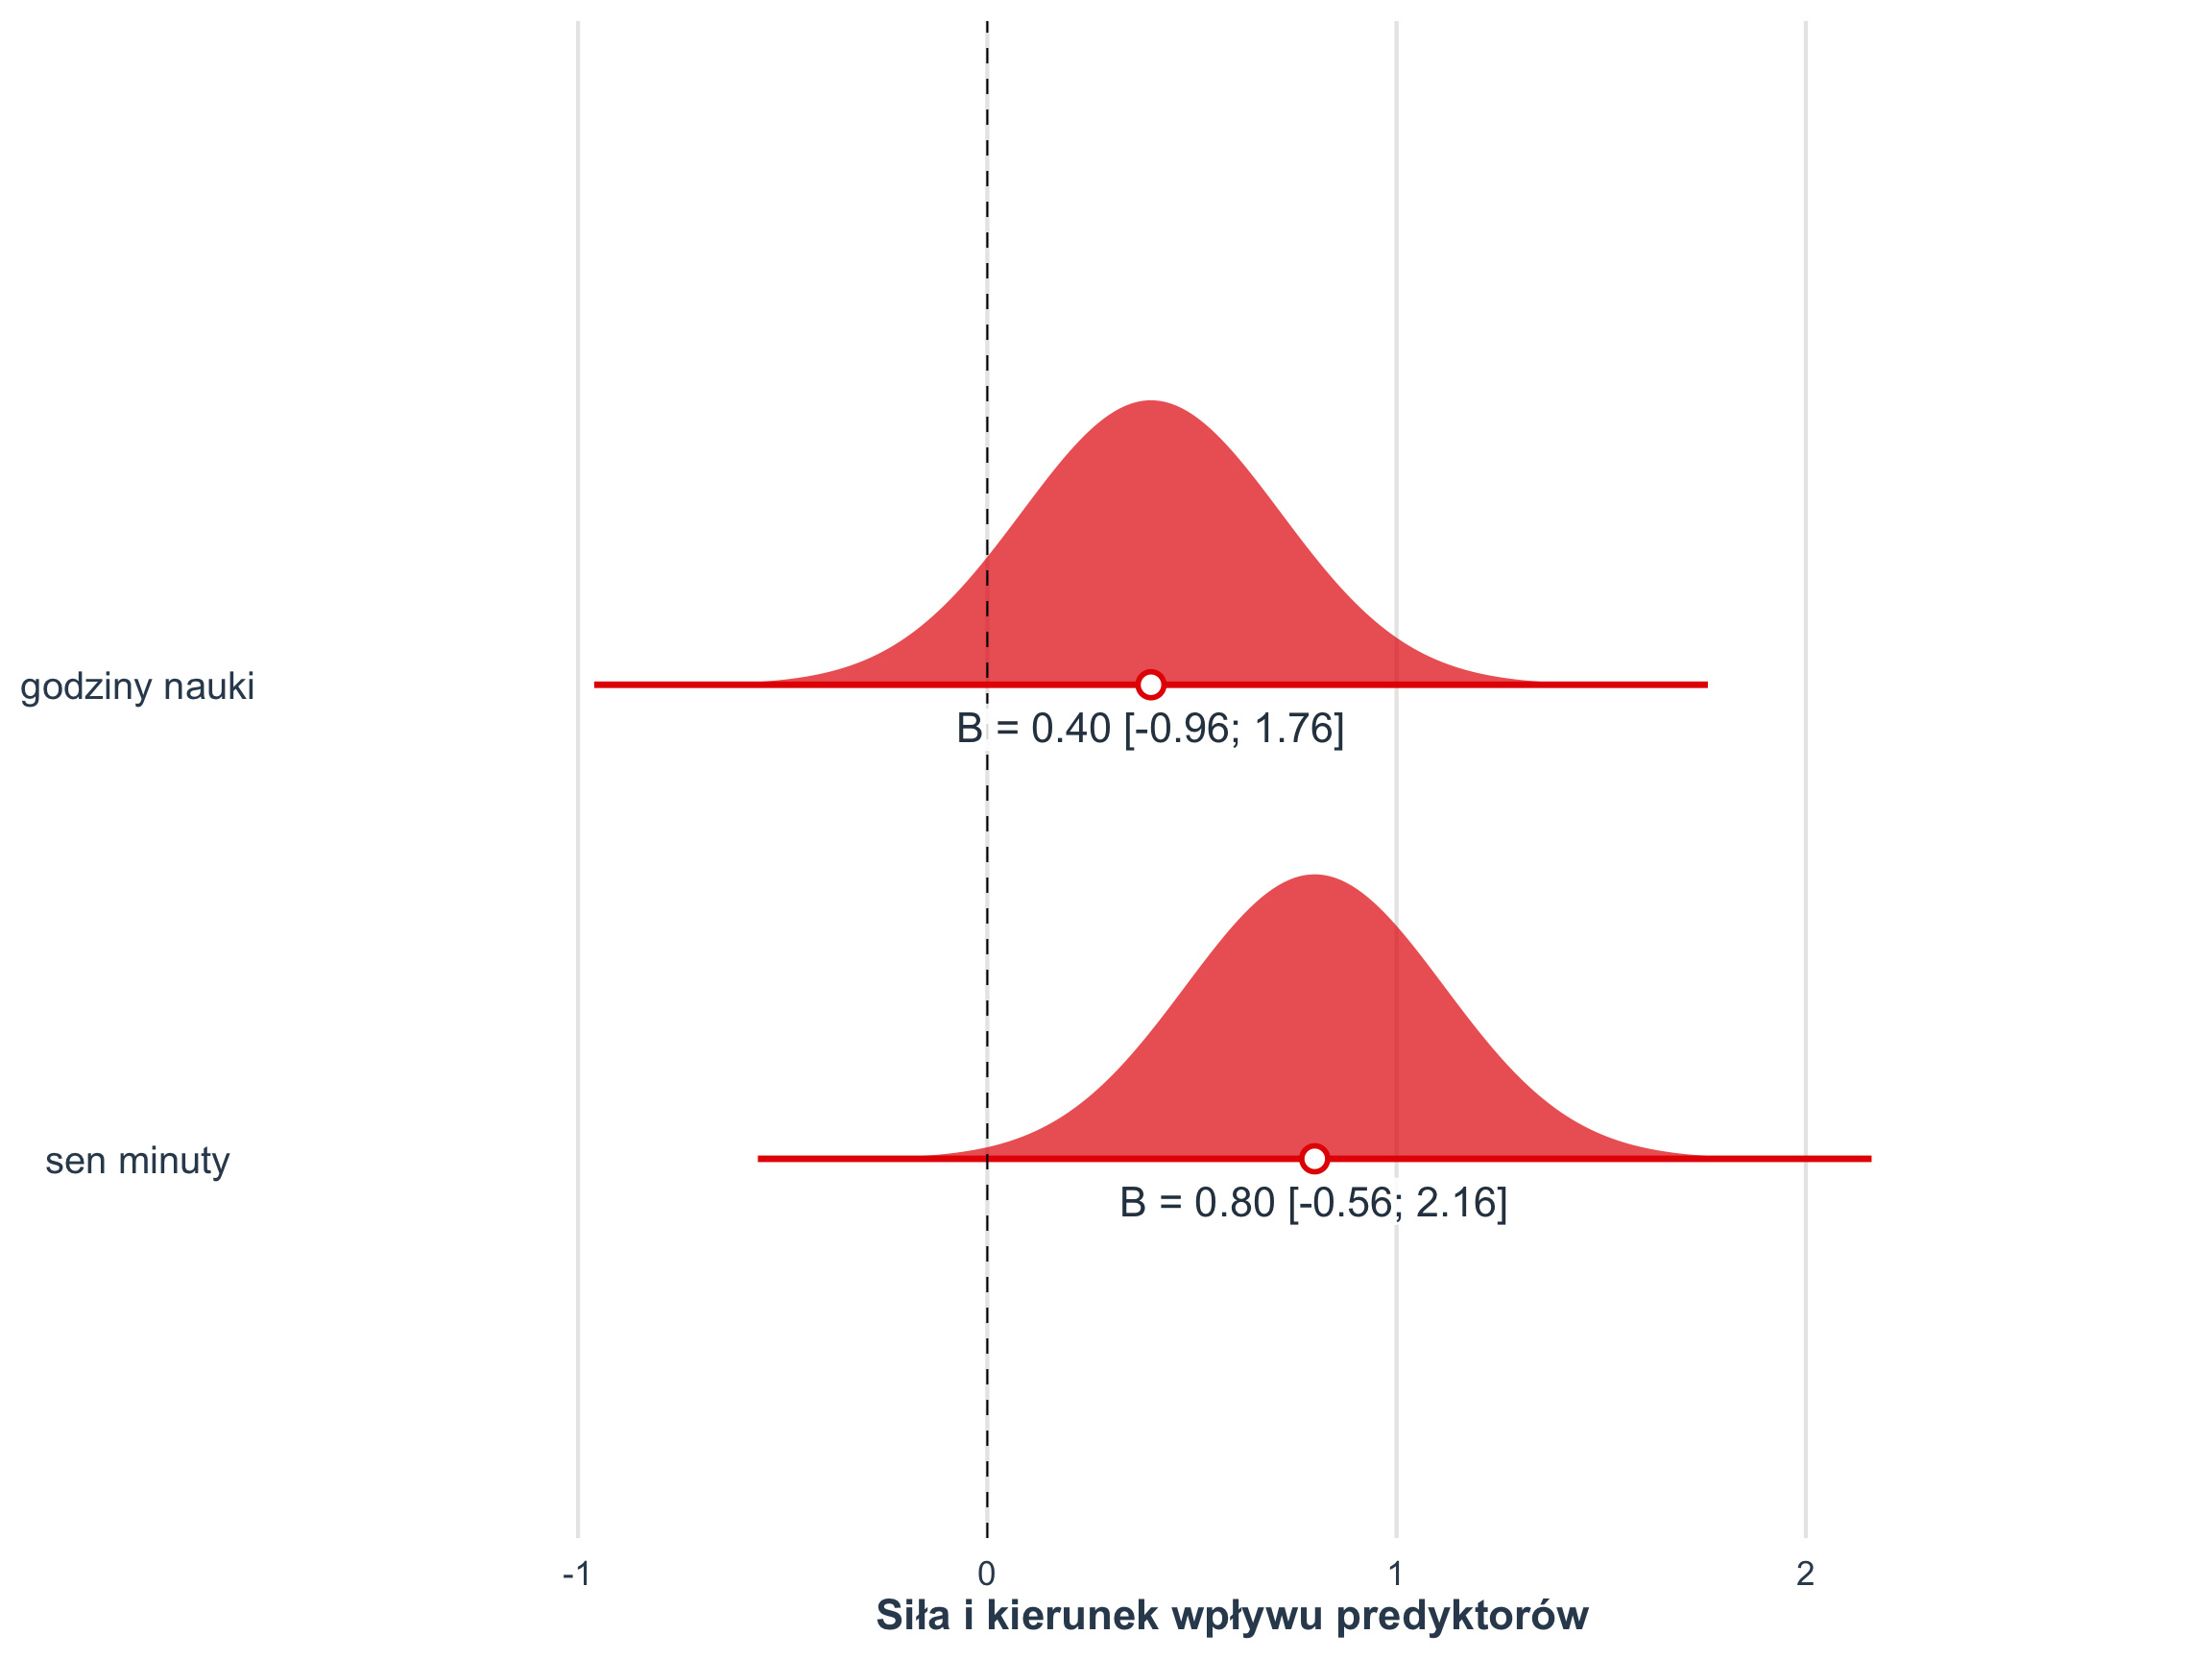
- β dla godzin. β₁ = 1,0 · 2 / 5 = 2 / 5 = 0,40.
- β dla snu. β₂ = 0,10 · 40 / 5 = 4 / 5 = 0,80.
- Wniosek. Kolejność się odwróciła: przy tej samej „miarce” sen przewiduje wynik dwa razy silniej niż nauka. Wzrost snu o jedno odchylenie standardowe (40 minut) wiąże się ze wzrostem o 0,80 odchylenia punktów, czyli o 0,80 · 5 = 4 punkty. Wzrost nauki o 2 godziny daje 0,40 · 5 = 2 punkty.
W tych danych godziny i sen nie są ze sobą skorelowane (r = 0), dlatego każda β równa się zwykłej korelacji z wynikiem. Gdy predyktory są skorelowane, β to wkład „po odjęciu” drugiego predyktora i nie musi równać się r.
Jak zinterpretować i opisać wynik?
β czytasz w odchyleniach standardowych: β = 0,80 znaczy, że osoby wyższe o jedno odchylenie standardowe na predyktorze mają przewidywany wynik wyższy o 0,80 odchylenia standardowego, przy stałym drugim predyktorze. Znak mówi o kierunku. Porównuj wartości bezwzględne β tylko w obrębie jednego modelu i jednej próby, bo zależą od rozrzutu zmiennych w tej próbie. Model z naszego przykładu wyjaśniał R² = 0,80 zmienności punktów, ale przy n = 5 nie był istotny: F(2, 2) = 4,00; p = 0,200.
Zapis w stylu APA: Większy udział w przewidywaniu wyniku z kolokwium miał czas snu, b = 0,10; β = 0,80; t(2) = 2,53; p = 0,127, niż czas nauki, b = 1,00; β = 0,40; t(2) = 1,26; p = 0,333. Żaden z predyktorów nie był istotny statystycznie.
Jak policzyć β w R?
godziny <- c(1, 1, 3, 5, 5)
sen     <- c(380, 460, 420, 380, 460)   # minuty snu
punkty  <- c(3, 11, 4, 7, 15)

# 1) „ręcznie”: β = b · s_x / s_y
model <- lm(punkty ~ godziny + sen)
b <- coef(model)[-1]                              # 1.0 i 0.1
beta <- b * c(sd(godziny), sd(sen)) / sd(punkty)  # 1.0·2/5 i 0.1·40/5
round(beta, 2)

# 2) to samo: regresja na wynikach z (scale)
coef(lm(scale(punkty) ~ scale(godziny) + scale(sen)))[-1]

# 3) gotowa funkcja z przedziałami ufności
parameters::standardize_parameters(model)
Wynik w konsoli R:
godziny     sen
    0.4     0.8
scale(godziny)     scale(sen)
           0.4            0.8
# Standardization method: refit

Parameter   | Std. Coef. |        95% CI
----------------------------------------
(Intercept) |   6.71e-18 | [-1.22, 1.22]
godziny     |       0.40 | [-0.96, 1.76]
sen         |       0.80 | [-0.56, 2.16]
Trzy sposoby dają te same liczby: 0,40 i 0,80. Funkcja standardize_parameters() dodaje przedziały ufności – takie same jak na Rys. 3. Wyraz wolny po standaryzacji wynosi 0 (R pokazuje go jako bardzo małą liczbę typu 6.71e-18).
b czy β – co podać w pracy?
Podaj oba. Współczynnik b ma sens praktyczny: „każda dodatkowa godzina nauki to średnio 1 punkt więcej”. Współczynnik β pozwala porównać predyktory między sobą. Jeśli predyktor jest zmienną zero-jedynkową (np. płeć), β trudno zinterpretować, bo „jedno odchylenie standardowe płci” nic nie znaczy – wtedy opisuj b. Pamiętaj też, że β nie jest miarą „ważności” w sensie przyczynowym. Mówi tylko, jak silnie predyktor wiąże się z wynikiem w tej próbie.
Najczęstsze błędy
- Porównywanie predyktorów na podstawie zwykłych b, gdy mają różne jednostki – jak minuty i godziny w naszym przykładzie.
- Mylenie β ze współczynnikiem β błędu II rodzaju – to zupełnie inne pojęcia, które przypadkiem mają tę samą literę.
- Porównywanie β między badaniami o bardzo różnym rozrzucie zmiennych – ta sama zależność da inne β w grupie jednorodnej i zróżnicowanej.
- Interpretowanie β powyżej 1 jako błędu – przy silnie skorelowanych predyktorach β może przekroczyć 1. To sygnał, żeby sprawdzić współliniowość.
- Podawanie β bez istotności i przedziału ufności – przy małej próbie nawet β = 0,80 może być przypadkiem.
Bibliografia
- Bring, J. (1994). How to standardize regression coefficients. The American Statistician, 48(3), 209–213.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówWynik standaryzowany z
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówWspółczynnik determinacji R²
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.