

Test chi-kwadrat zgodności – wzór, przykład krok po kroku i R
Test chi-kwadrat zgodności sprawdza, czy liczebności w kategoriach jednej zmiennej różnią się od liczebności, których oczekujesz – np. czy wszystkie odpowiedzi są wybierane równie często. Typowe pytanie z pracy dyplomowej: czy studenci wyraźnie preferują którąś formę zajęć, czy wybory rozkładają się po równo?
W prostych słowachNajpierw zapisujesz, ile osób wybrało każdą odpowiedź (to liczebności obserwowane). Potem liczysz, ile osób powinno ją wybrać, gdyby prawdziwa była hipoteza zerowa (liczebności oczekiwane). Test sumuje kwadraty różnic między jednymi a drugimi, każdą ważąc wielkością oczekiwaną. Duża suma oznacza, że rzeczywistość mocno odbiega od założenia „po równo”.
Kiedy stosować test chi-kwadrat zgodności?
- masz jedną zmienną jakościową z co najmniej dwiema kategoriami (forma zajęć, ulubiony przedmiot, odpowiedź „tak/nie/nie wiem”);
- chcesz sprawdzić, czy kategorie są wybierane równie często albo zgodnie z zadanymi proporcjami (np. 50% / 30% / 20% z wcześniejszych badań, struktura płci w populacji);
- każda osoba trafia do dokładnie jednej kategorii, a obserwacje są niezależne;
- liczebności oczekiwane wynoszą co najmniej 5 w każdej kategorii (Cochran, 1954) – jeśli nie, użyj testu dokładnego albo wartości p z metody Monte Carlo.
Gdy kategorie są tylko dwie, równoważny jest test dwumianowy (przy małych próbach – dokładniejszy). Gdy masz dwie zmienne jakościowe i pytasz o ich związek, potrzebujesz testu chi-kwadrat niezależności. Same liczebności i procenty opiszesz wcześniej w analizie częstości.
Wzór na test chi-kwadrat zgodności
- \(O_i\)
- liczebność obserwowana – ile osób naprawdę wybrało kategorię i
- \(E_i\)
- liczebność oczekiwana – ile osób powinno ją wybrać, gdyby prawdziwa była hipoteza zerowa
- \(p_i\)
- proporcja z hipotezy zerowej; przy założeniu „po równo” każda kategoria ma 1/k
- \(N\)
- liczba wszystkich osób
- \(k\)
- liczba kategorii
- \(df = k - 1\)
- stopnie swobody: gdy znasz N i k − 1 liczebności, ostatnia jest już wyznaczona
- \(\sum\)
- znak sumy – dodajesz wkłady wszystkich kategorii
Na głos czytamy: „chi-kwadrat to suma po wszystkich kategoriach: obserwowane minus oczekiwane, do kwadratu, podzielone przez oczekiwane”. Wynik porównujesz z rozkładem chi-kwadrat o k − 1 stopniach swobody.
Przykład krok po kroku
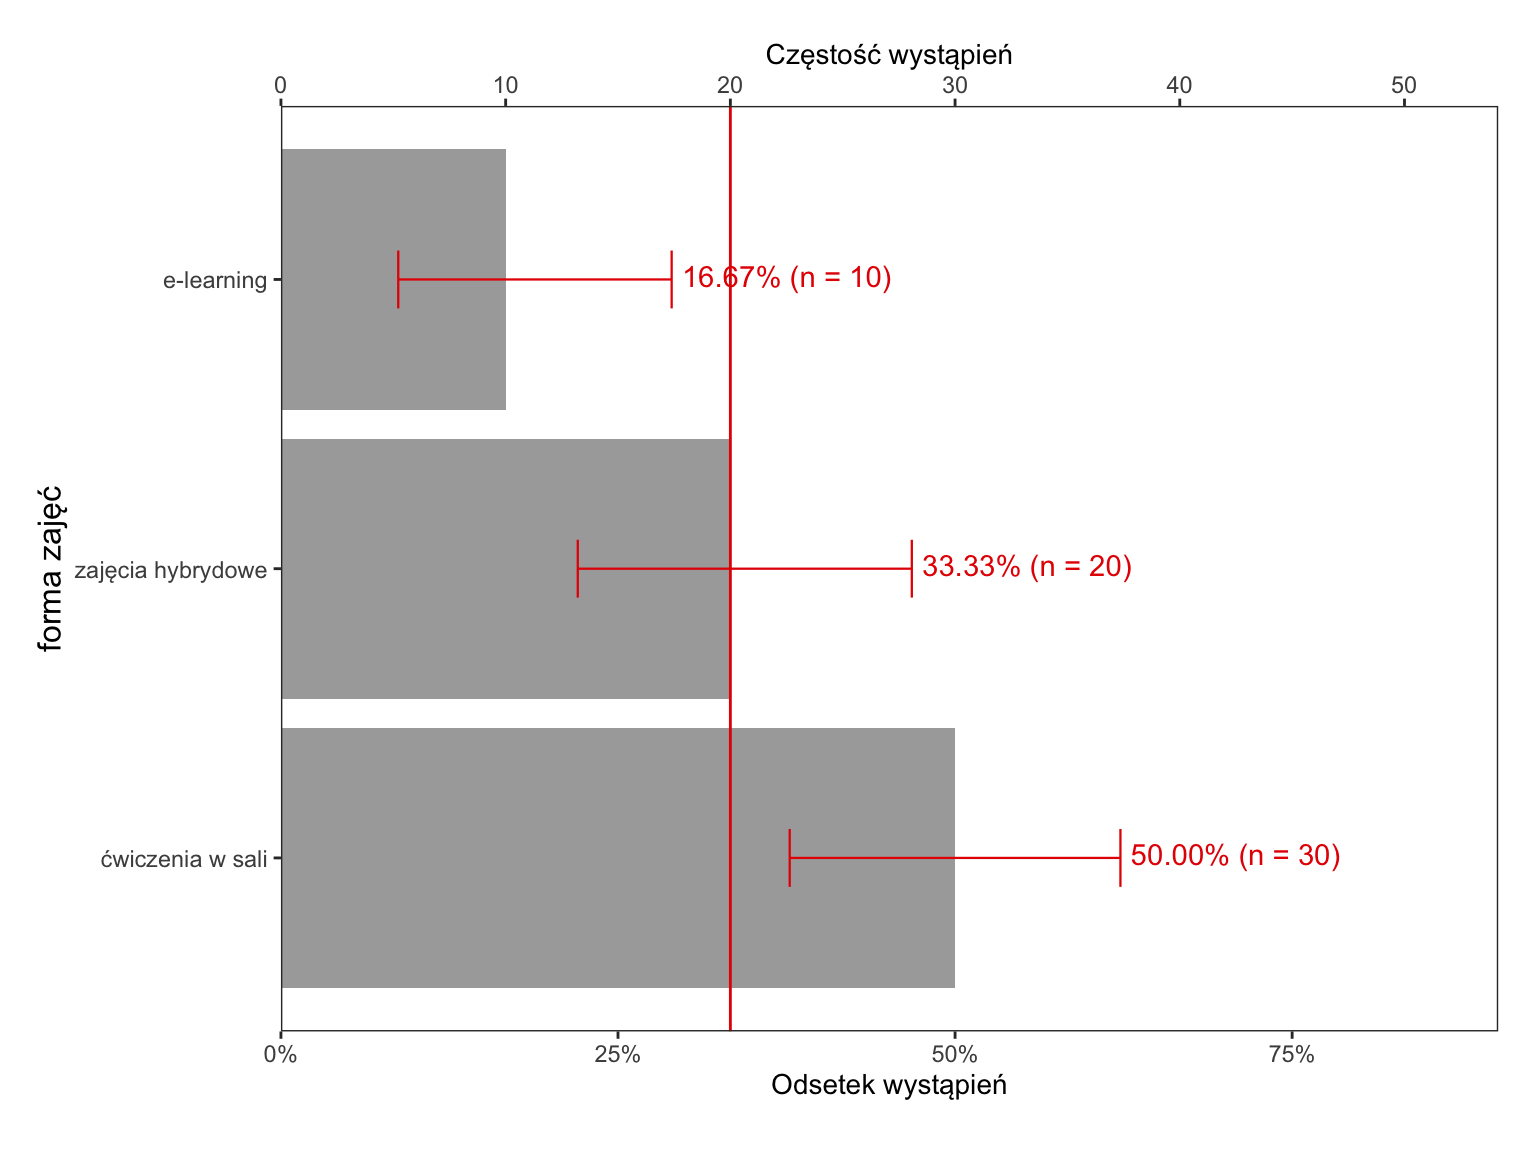
Zapytaliśmy 60 studentów, jaką formę zajęć wolą. Ćwiczenia w sali wybrało 30 osób, zajęcia hybrydowe – 20, a e-learning – 10. Hipoteza zerowa: wszystkie trzy formy są wybierane równie często.
| Forma zajęć | O | E = 60 · 1/3 | O − E | (O − E)² | (O − E)² / E | Reszta (O − E) / √E |
|---|---|---|---|---|---|---|
| ćwiczenia w sali | 30 | 20 | 30 − 20 = 10 | 10² = 100 | 100 / 20 = 5 | 10 / 4,47 = 2,24 |
| zajęcia hybrydowe | 20 | 20 | 20 − 20 = 0 | 0² = 0 | 0 / 20 = 0 | 0,00 |
| e-learning | 10 | 20 | 10 − 20 = −10 | (−10)² = 100 | 100 / 20 = 5 | −10 / 4,47 = −2,24 |
| Σ | 60 | 60 | 0 | 200 | χ² = 10 | – |
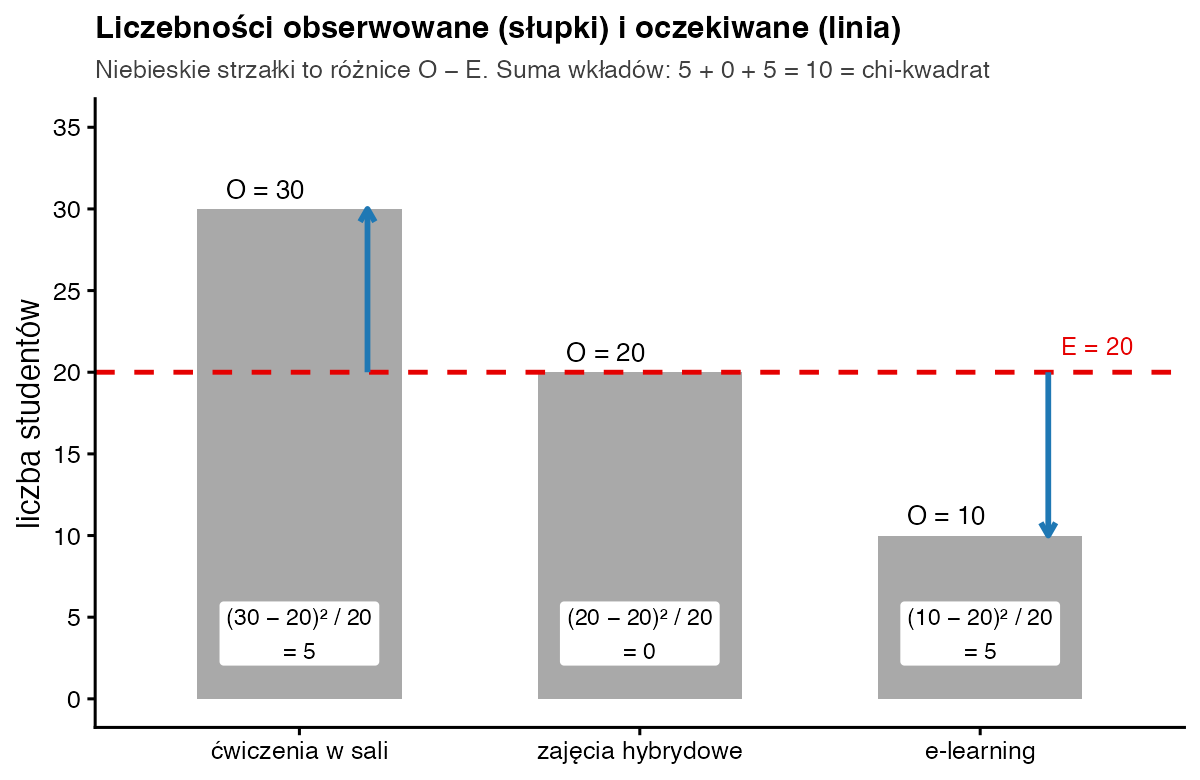
- Liczebności oczekiwane. Przy założeniu „po równo” każda forma ma proporcję 1/3. E = 60 · 1/3 = 20 osób w każdej kategorii. Wszystkie E są większe od 5, więc test można stosować.
- Różnice O − E. 30 − 20 = 10; 20 − 20 = 0; 10 − 20 = −10. Suma różnic zawsze wynosi 0 – dlatego podnosimy je do kwadratu.
- Kwadraty różnic. 10² = 100; 0² = 0; (−10)² = 100.
- Wkłady. Każdy kwadrat dzielimy przez E: 100 / 20 = 5; 0 / 20 = 0; 100 / 20 = 5. Dzielenie przez E sprawia, że różnica 10 osób „waży” więcej, gdy oczekiwaliśmy 20 osób, niż gdybyśmy oczekiwali 200.
- Statystyka. χ² = 5 + 0 + 5 = 10,00.
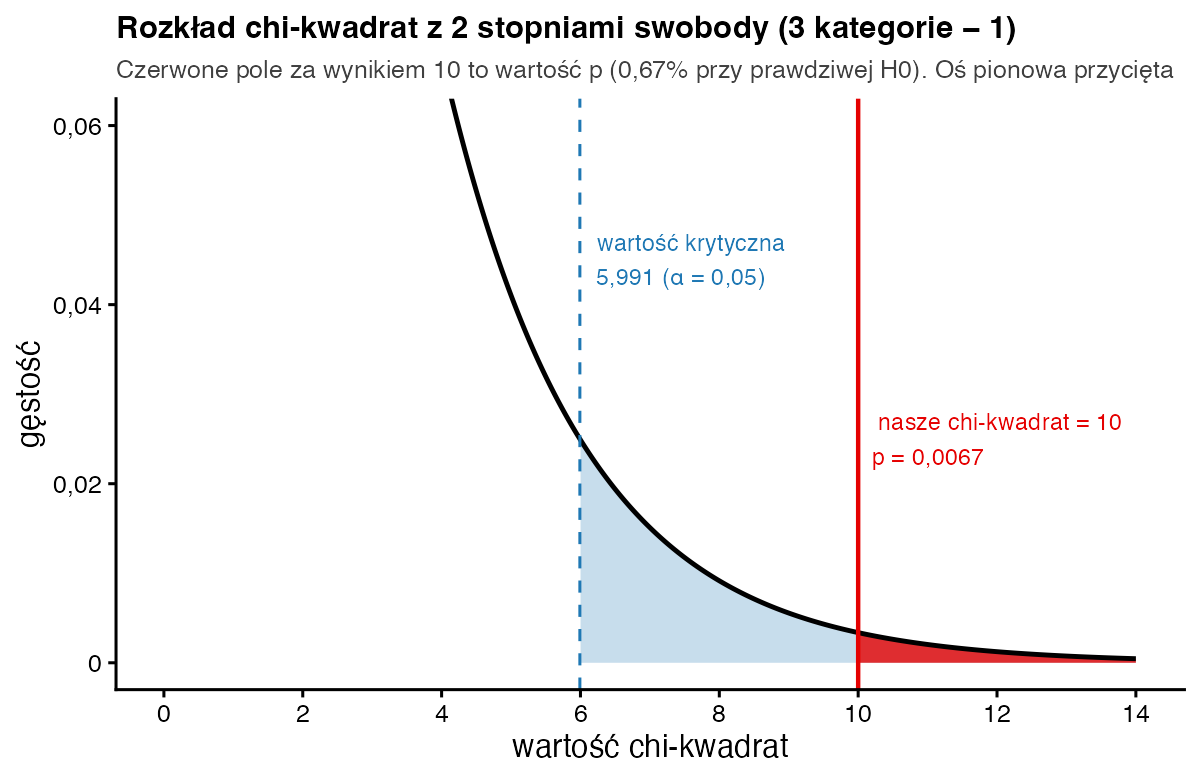
- Stopnie swobody. df = k − 1 = 3 − 1 = 2.
- Odczyt z tablic. Wartość krytyczna χ² dla df = 2 i α = 0,05 wynosi 5,991 (w R:
qchisq(0.95, 2)). 10 > 5,991, więc odrzucamy hipotezę zerową. Dokładnie: p =pchisq(10, 2, lower.tail = FALSE)= 0,0067, w zaokrągleniu 0,007. - Które kategorie „ciągną” wynik? Reszty standaryzowane (O − E) / √E: √20 = 4,47, więc 10 / 4,47 = 2,24 i −10 / 4,47 = −2,24. Wartości powyżej 1,96 co do modułu wskazują kategorie wyraźnie odbiegające od oczekiwań: ćwiczeń w sali jest za dużo, e-learningu za mało.
- Wielkość efektu. w Cohena = √(χ² / N) = √(10 / 60) = √0,167 = 0,41 – efekt średni według progów 0,1 / 0,3 / 0,5 (Cohen, 1988). Aplikacja SZTOS podaje V Craméra = √(χ² / (N · (k − 1))) = √(10 / 120) = 0,29.
Hipoteza zerowa nie musi zakładać równych proporcji. Gdyby wcześniejsze badania mówiły o 50% / 30% / 20%, to E = 30, 18 i 12, a χ² = 0 + 4/18 + 4/12 ≈ 0 + 0,222 + 0,333 ≈ 0,56; p = 0,76. Te same dane są wtedy zgodne z oczekiwaniami.
Jak zinterpretować i opisać wynik?
Gdyby studenci w populacji wybierali wszystkie formy zajęć równie często, tak duże lub większe odchylenia od rozkładu 20 / 20 / 20 pojawiałyby się tylko w około 0,7% podobnych badań. Dlatego uznajemy, że preferencje nie rozkładają się po równo. Sam test nie mówi jednak, która kategoria różni się od której – tę informację dają reszty standaryzowane. Podaj też procenty, bo czytelnik lepiej rozumie „50% wolało ćwiczenia w sali” niż samo χ². Gotowy opis znajdziesz w przykładzie testu chi-kwadrat.
Zapis w stylu APA: Preferencje form zajęć różniły się istotnie od rozkładu równomiernego, χ²(2, N = 60) = 10,00; p = 0,007; w = 0,41. Najczęściej wybierano ćwiczenia w sali (50,0%), następnie zajęcia hybrydowe (33,3%) i e-learning (16,7%).
Jak policzyć test chi-kwadrat zgodności w R?
O <- c(sala = 30, hybryda = 20, e_learning = 10)   # liczebności obserwowane

# 1) „ręcznie”
E  <- sum(O) * c(1/3, 1/3, 1/3)        # oczekiwane: 20, 20, 20
wk <- (O - E)^2 / E; wk                # wkłady: 5, 0, 5
chi2 <- sum(wk); chi2                  # 10
df <- length(O) - 1                    # 2
pchisq(chi2, df, lower.tail = FALSE)   # p
qchisq(0.95, df)                       # wartość krytyczna
sqrt(chi2 / sum(O))                    # w Cohena

# 2) gotowa funkcja (domyślnie: równe proporcje)
test <- chisq.test(O); test
test$residuals                         # (O − E) / √E

# 3) inne proporcje oczekiwane: 50% / 30% / 20%
chisq.test(O, p = c(0.5, 0.3, 0.2))
Wynik w konsoli R:
> wk
      sala    hybryda e_learning
         5          0          5
> chi2
[1] 10
> pchisq(chi2, df, lower.tail = FALSE)
[1] 0.006737947
> qchisq(0.95, df)
[1] 5.991465
> sqrt(chi2/sum(O))
[1] 0.4082483
> test

	Chi-squared test for given probabilities

data:  O
X-squared = 10, df = 2, p-value = 0.006738
> test$residuals
      sala    hybryda e_learning
  2.236068   0.000000  -2.236068
> chisq.test(O, p = c(0.5, 0.3, 0.2))

	Chi-squared test for given probabilities

data:  O
X-squared = 0.55556, df = 2, p-value = 0.7575
Funkcja chisq.test() z jednym wektorem liczebności domyślnie zakłada równe proporcje. Inne proporcje podajesz argumentem p – muszą sumować się do 1.
Test zgodności czy test niezależności – czym się różnią?
Wzór jest prawie ten sam, ale pytanie inne. Test zgodności dotyczy jednej zmiennej i porównuje ją z rozkładem zadanym z góry (po równo albo z literatury), więc df = k − 1. Test niezależności dotyczy tabeli dwóch zmiennych, a liczebności oczekiwane wylicza się z sum wierszy i kolumn tej tabeli, więc df = (w − 1)(k − 1). Jeśli pytasz „czy studenci wolą któryś wariant?”, wybierz test zgodności. Jeśli pytasz „czy preferencje zależą od kierunku studiów?” – test niezależności.
Najczęstsze błędy
- Wpisywanie do testu procentów zamiast liczebności – χ² zależy od liczby osób, więc z procentami wychodzi zły wynik.
- Stosowanie testu, gdy liczebności oczekiwane są mniejsze niż 5 – połącz kategorie albo użyj metody Monte Carlo lub testu dokładnego.
- Liczenie jednej osoby w kilku kategoriach (pytania wielokrotnego wyboru) – obserwacje przestają być niezależne.
- Wniosek „rozkład jest równomierny”, gdy p > 0,05. Poprawnie: brak podstaw do odrzucenia hipotezy o równych proporcjach.
- Podawanie samego p bez liczebności, procentów i wielkości efektu.
Bibliografia
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówRozkład chi-kwadrat
- Słownik wzorówTest dwumianowy
- Słownik wzorówCzęstości i procenty
- PoradnikTest chi-kwadrat – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.