

Rozkład chi-kwadrat – wzór, tablice, przykład i R
Rozkład chi-kwadrat (χ²) to rozkład sumy kwadratów niezależnych wyników z. Na nim opierają się testy chi-kwadrat dla tabel krzyżowych i test zgodności. Typowe pytanie z pracy dyplomowej: skąd program wziął wartość p dla χ²(2) = 10,00 i co oznaczają stopnie swobody w nawiasie?
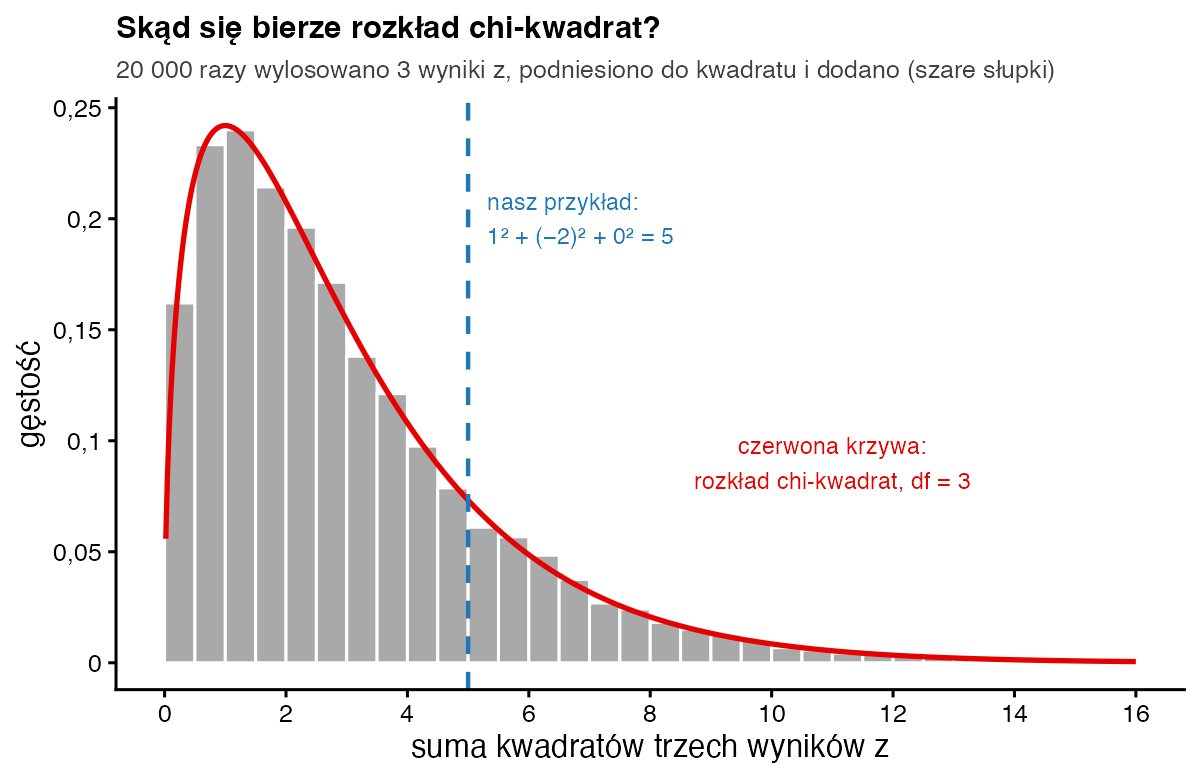
W prostych słowachWeź kilka losowych wyników z rozkładu normalnego, podnieś każdy do kwadratu i dodaj. Wynik nigdy nie jest ujemny, zwykle jest mały, a czasem – rzadko – duży. Jeśli powtórzysz to tysiące razy, dostaniesz rozkład chi-kwadrat. Liczba dodawanych kwadratów to stopnie swobody. Test chi-kwadrat pyta po prostu: czy nasza suma kwadratów rozbieżności jest „za duża” jak na przypadek?
Kiedy korzystasz z rozkładu chi-kwadrat?
- wykonujesz test chi-kwadrat niezależności dla tabeli krzyżowej – np. płeć a wybór kierunku;
- sprawdzasz test chi-kwadrat zgodności – czy rozkład odpowiedzi zgadza się z oczekiwanym;
- liczysz test McNemary, Kruskala-Wallisa albo Friedmana – ich statystyki przy większych próbach porównuje się właśnie z rozkładem χ²;
- oceniasz dopasowanie modelu, np. test χ² w analizie czynnikowej, test Bartletta czy porównanie modeli regresji logistycznej.
Rozkład χ² jest „krewnym” innych rozkładów. Pierwiastek z χ² przy 1 stopniu swobody to wartość bezwzględna z. Iloraz dwóch zmiennych χ² podzielonych przez swoje df daje rozkład F, a z rozkładu χ² wywodzi się też rozkład t Studenta.
Wzór na zmienną chi-kwadrat
- \(z_1, z_2, \dots\)
- niezależne wyniki z rozkładu normalnego standardowego (średnia 0, SD 1) – zobacz wynik standaryzowany z
- \(z^2\)
- kwadrat wyniku z – zawsze dodatni, dlatego χ² nie może być ujemne
- \(df\)
- stopnie swobody: liczba niezależnych składników sumy. W testach odejmuje się od liczby składników tyle, ile „więzów” narzucają dane, np. k − 1 w teście zgodności i (w − 1)(k − 1) w tabeli krzyżowej
- \(\chi^2_{kryt}\)
- wartość krytyczna: punkt, od którego na prawo zostaje α (np. 5%) pola pod krzywą
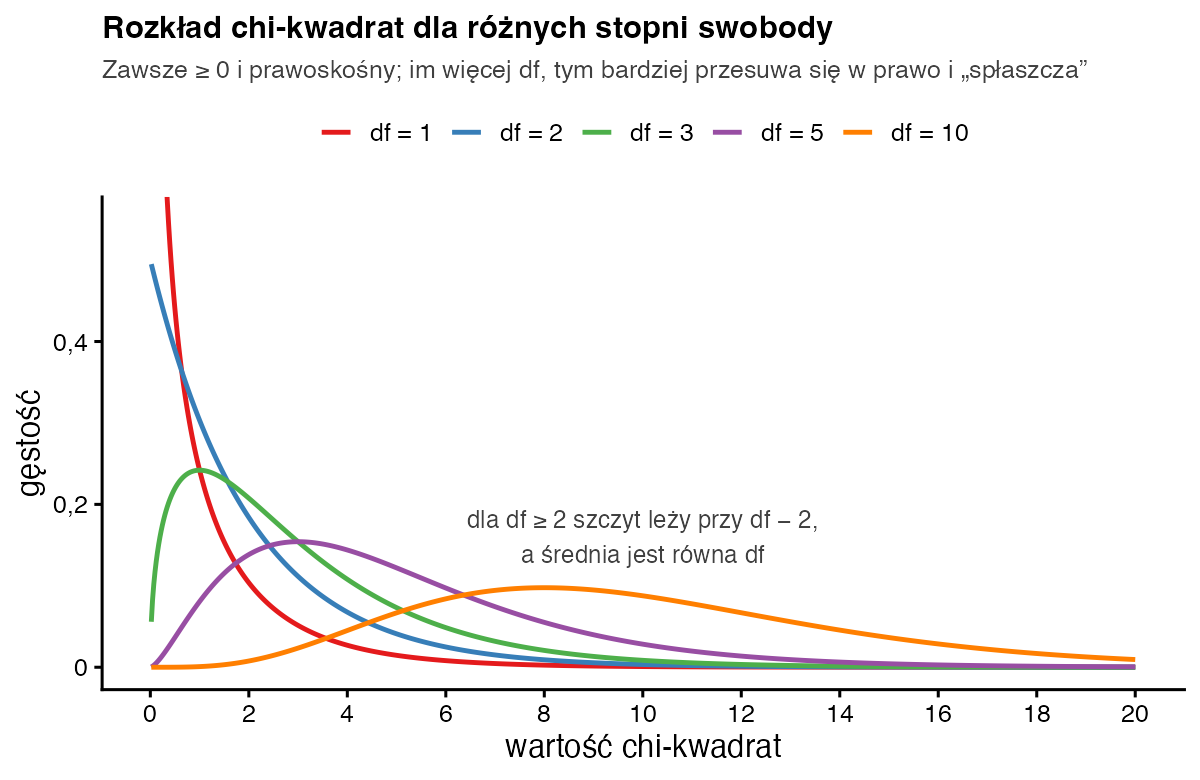
Na głos czytamy: „chi-kwadrat z df stopniami swobody to suma df kwadratów niezależnych wyników z; jego średnia równa się df, a wariancja dwóm df”.
Przykład krok po kroku
Najpierw zobaczmy, skąd bierze się jedna wartość χ². Wylosowaliśmy trzy wyniki z rozkładu normalnego standardowego: 1, −2 i 0.
| Składnik | Wynik z | Kwadrat z² |
|---|---|---|
| 1 | 1 | 1² = 1 |
| 2 | −2 | (−2)² = 4 |
| 3 | 0 | 0² = 0 |
| Σ | – | 1 + 4 + 0 = 5 |
- Suma kwadratów. 1 + 4 + 0 = 5. To jedna wartość z rozkładu χ² z 3 stopniami swobody (bo dodaliśmy 3 kwadraty).
- Czy to dużo? Średnia rozkładu χ²(3) wynosi 3, więc 5 to wynik nieco powyżej przeciętnej. Pole na prawo od 5 wynosi 0,172 (w R:
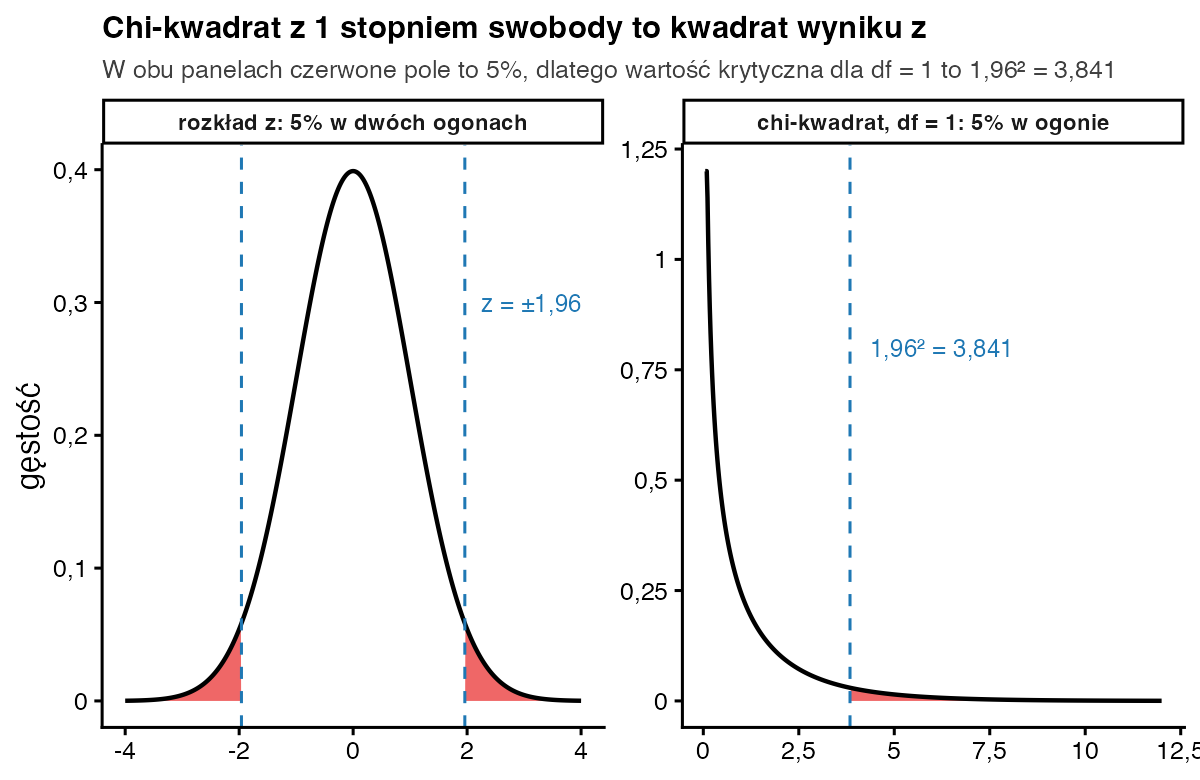
pchisq(5, 3, lower.tail = FALSE)) – mniej więcej co szósta taka suma jest jeszcze większa. - Df = 1 i liczba 3,841. Przy jednym składniku χ² = z². W rozkładzie z 5% wyników leży poza ±1,96. Po podniesieniu do kwadratu: 1,96 · 1,96 = 3,8416 ≈ 3,841. Dlatego wartość krytyczna χ² dla df = 1 i α = 0,05 to 3,841 (w R:
qchisq(0.95, 1)). - Odczyt z tablic dla prawdziwego testu. W teście zgodności 60 studentów wybierało jedną z 3 form zajęć i otrzymaliśmy χ² = 10,00 przy df = 3 − 1 = 2. W tablicy (Tabela 2) w wierszu df = 2 wartość krytyczna dla α = 0,05 to 5,991. Nasze 10 jest większe, więc p < 0,05.
- Dokładniej z tablic. W tym samym wierszu dla α = 0,01 jest 9,210, a dla α = 0,005 – 10,597. Wynik 10 leży między nimi, więc 0,005 < p < 0,01.
- Dokładna wartość z R.
pchisq(10, 2, lower.tail = FALSE)= 0,0067. Dla porównania: gdyby to samo χ² = 10 miało df = 1, p wyniosłoby 0,0016 – im więcej stopni swobody, tym większej sumy potrzeba, by uznać ją za nietypową.
| df | 1 | 2 | 3 | 4 | 5 | 10 |
|---|---|---|---|---|---|---|
| α = 0,05 | 3,841 | 5,991 | 7,815 | 9,488 | 11,070 | 18,307 |
| α = 0,01 | 6,635 | 9,210 | 11,345 | 13,277 | 15,086 | 23,209 |
Jak zinterpretować i opisać wynik?
Wartość p z rozkładu χ² to prawdopodobieństwo otrzymania sumy rozbieżności co najmniej tak dużej jak nasza, gdyby hipoteza zerowa była prawdziwa (np. gdyby wszystkie formy zajęć były wybierane równie często). Mała wartość p każe wątpić w H0, ale nie mówi, jak duży jest efekt – do tego służą V Craméra albo φ. W zapisie zawsze podawaj df w nawiasie, bo ta sama wartość χ² ma zupełnie inne p przy różnych stopniach swobody. Pełny opis testu znajdziesz w przykładowym raporcie chi-kwadrat.
Zapis w stylu APA: Rozkład wyboru form zajęć istotnie odbiegał od równomiernego, χ²(2, N = 60) = 10,00; p = 0,007. Wartość krytyczna dla α = 0,05 i 2 stopni swobody wynosi 5,991.
Jak odczytać rozkład chi-kwadrat w R?
# 1) „ręcznie”: chi-kwadrat to suma kwadratów wyników z
z <- c(1, -2, 0)
sum(z^2)                               # 1 + 4 + 0 = 5, df = 3
pchisq(5, df = 3, lower.tail = FALSE)  # pole na prawo od 5

# 2) wartości krytyczne zamiast tablic (alfa = 0,05)
qchisq(0.95, df = c(1, 2, 3, 4, 5, 10))
1.96^2                                 # df = 1: kwadrat z = 1,96

# 3) wartość p dla chi-kwadrat = 10 przy df = 2 i df = 1
pchisq(10, df = 2, lower.tail = FALSE)
pchisq(10, df = 1, lower.tail = FALSE)
2 * pnorm(-sqrt(10))                   # to samo co df = 1 przez z

# 4) symulacja: średnia ≈ df, wariancja ≈ 2 · df
set.seed(2026)
s <- replicate(20000, sum(rnorm(3)^2))
c(srednia = mean(s), wariancja = var(s))
Wynik w konsoli R:
> sum(z^2)
[1] 5
> pchisq(5, df = 3, lower.tail = FALSE)
[1] 0.1717971
> qchisq(0.95, df = c(1, 2, 3, 4, 5, 10))
[1]  3.841459  5.991465  7.814728  9.487729 11.070498 18.307038
> 1.96^2
[1] 3.8416
> pchisq(10, df = 2, lower.tail = FALSE)
[1] 0.006737947
> pchisq(10, df = 1, lower.tail = FALSE)
[1] 0.001565402
> 2 * pnorm(-sqrt(10))
[1] 0.001565402
> c(srednia = mean(s), wariancja = var(s))
  srednia wariancja
 3.016769  6.089020
Funkcja qchisq() zastępuje tablice (podajesz 1 − α i df, dostajesz wartość krytyczną), a pchisq(..., lower.tail = FALSE) zwraca pole w prawym ogonie, czyli wartość p.
Najczęstsze błędy
- Podawanie liczby osób zamiast df w nawiasie, np. χ²(60) zamiast χ²(2).
- Dzielenie p z testu χ² na pół „bo test jest jednostronny” – oba kierunki odchyleń są już w jednym ogonie.
- Odczyt z tablic złego wiersza (df) albo kolumny (α) – sprawdzaj wynik w R funkcją
pchisq(). - Stosowanie przybliżenia χ², gdy liczebności oczekiwane są bardzo małe (poniżej 5) – wtedy lepszy jest test dokładny, np. test Fishera.
- Traktowanie dużej wartości χ² jako dowodu silnego związku – χ² rośnie razem z liczebnością próby.
Bibliografia
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówTest chi-kwadrat zgodności
- Słownik wzorówRozkład normalny
- Słownik wzorówRozkład F
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.