

Korelacja pozycja–całość – wzór i przykład
Korelacja pozycja–całość (ang. item-rest correlation, w R: r.drop) pokazuje, na ile jedno pytanie skali idzie w parze z resztą pytań. Przykładowe pytanie z pracy dyplomowej: które stwierdzenie w mojej skali zaangażowania na zajęciach psuje rzetelność i czy warto je usunąć?
W prostych słowachKażde pytanie skali powinno mierzyć to samo co pozostałe. Sprawdzasz to tak: dla każdej osoby dodajesz odpowiedzi na wszystkie inne pytania i liczysz zwykłą korelację tego pytania z tą sumą. Wysoka korelacja znaczy, że pytanie „gra w drużynie”. Korelacja bliska zera albo ujemna to sygnał, że pytanie mierzy coś innego albo trzeba je odwrócić.
Kiedy liczyć korelację pozycja–całość?
- budujesz lub sprawdzasz skalę z kilku pytań (np. Likerta 1–5), których wyniki chcesz zsumować lub uśrednić;
- liczysz alfę Cronbacha i chcesz wiedzieć, które pytanie ją obniża;
- szukasz pytań do odwrócenia (zapomniane rekodowanie daje korelację ujemną).
Korelacja pozycja–całość to po prostu korelacja Pearsona między pytaniem a sumą pozostałych pytań. Gdy chcesz ocenić strukturę skali dokładniej, sięgnij po ładunki czynnikowe i omegę McDonalda. Stabilność wyników w czasie to inne pytanie – odpowiada na nie rzetelność test–retest.
Wzór na korelację pozycja–całość
Na głos: „korelacja pozycji i z resztą to korelacja Pearsona między odpowiedziami na pozycję i a sumą odpowiedzi na wszystkie pozostałe pozycje”.
- \(x_i\)
- odpowiedzi wszystkich osób na pozycję (pytanie) numer i
- \(T\)
- wynik ogólny osoby: suma odpowiedzi na wszystkie pozycje skali
- \(R_i\)
- „reszta”: suma odpowiedzi na wszystkie pozycje oprócz i, czyli wynik ogólny minus ta jedna pozycja
- \(j \ne i\)
- „każda pozycja j inna niż i”
- \(r(\cdot,\cdot)\)
- zwykły współczynnik korelacji Pearsona
- \(r_{i,\,R}\)
- wynik: skorygowana korelacja pozycji z całością (w
psych::alphakolumnar.drop)
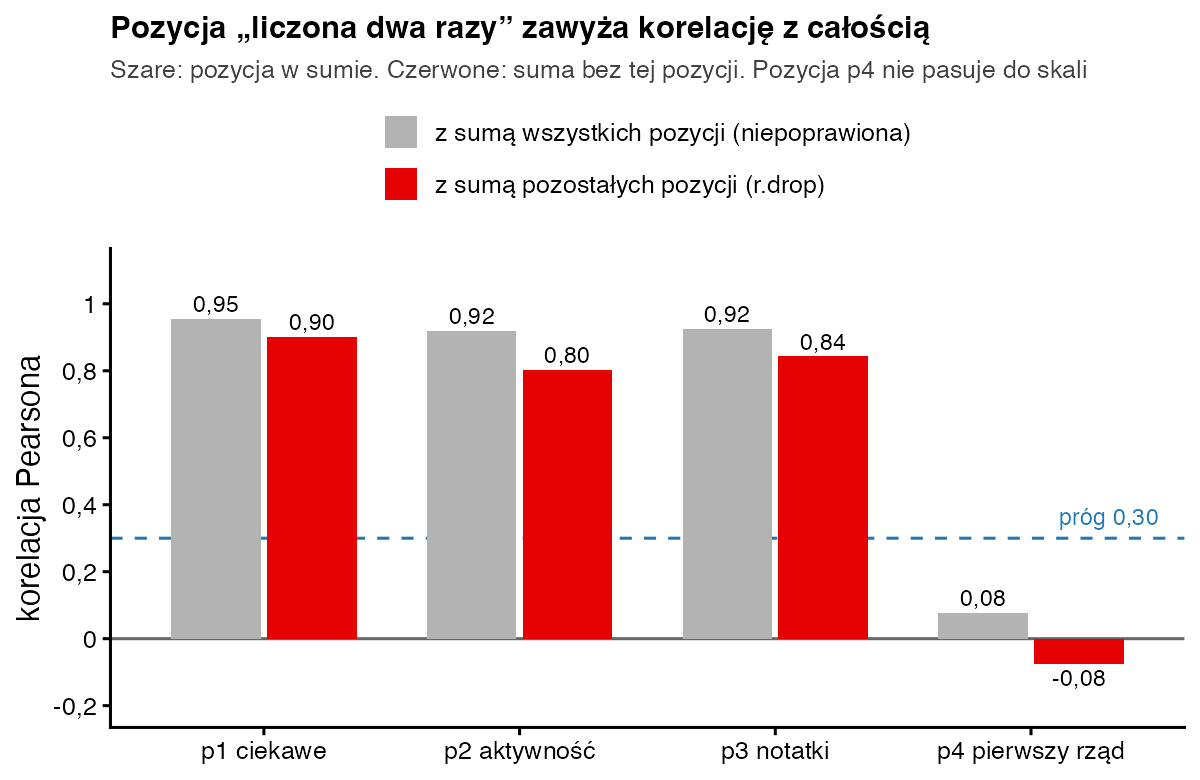
Dlaczego bez tej pozycji? Gdy pytanie zostaje w sumie, koreluje częściowo samo ze sobą. Taka niepoprawiona korelacja (raw.r) jest zawsze zawyżona, zwłaszcza w krótkich skalach.
Przykład krok po kroku
Pięcioro studentów odpowiedziało na 4 pytania skali zaangażowania (1 – zdecydowanie nie, 5 – zdecydowanie tak): p1 „Zajęcia są dla mnie ciekawe”, p2 „Zabieram głos na zajęciach”, p3 „Robię notatki”, p4 „Siadam w pierwszym rzędzie”. Liczymy korelację dla p1. Średnia p1 to 15 / 5 = 3, a średnia reszty to 45 / 5 = 9.
| osoba | p1 | p2 | p3 | p4 | suma T | reszta R = T − p1 | p1 − 3 | R − 9 | (p1 − 3)(R − 9) | (p1 − 3)² | (R − 9)² |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 1 | 1 | 1 | 3 | 6 | 6 − 1 = 5 | −2 | −4 | 8 | 4 | 16 |
| 2 | 2 | 1 | 3 | 3 | 9 | 9 − 2 = 7 | −1 | −2 | 2 | 1 | 4 |
| 3 | 3 | 2 | 4 | 3 | 12 | 12 − 3 = 9 | 0 | 0 | 0 | 0 | 0 |
| 4 | 4 | 4 | 5 | 4 | 17 | 17 − 4 = 13 | 1 | 4 | 4 | 1 | 16 |
| 5 | 5 | 5 | 4 | 2 | 16 | 16 − 5 = 11 | 2 | 2 | 4 | 4 | 4 |
| suma | 15 | 13 | 17 | 15 | 60 | 45 | 0 | 0 | 18 | 10 | 40 |
- Reszta. Od sumy każdej osoby odejmujemy jej odpowiedź na p1, np. dla osoby 4: 17 − 4 = 13. Tak usuwamy p1 z wyniku ogólnego.
- Odchylenia od średnich. p1 − 3 daje −2, −1, 0, 1, 2. R − 9 daje −4, −2, 0, 4, 2.
- Iloczyny i ich suma. (−2)(−4) = 8, (−1)(−2) = 2, 0 · 0 = 0, 1 · 4 = 4, 2 · 2 = 4; razem 18. Suma jest dodatnia, bo osoby wysoko na p1 mają też wysoką resztę.
- Sumy kwadratów. Dla p1: 4 + 1 + 0 + 1 + 4 = 10. Dla reszty: 16 + 4 + 0 + 16 + 4 = 40.
- Korelacja. \(r = 18 / \sqrt{10 \cdot 40} = 18 / \sqrt{400} = 18 / 20 = 0{,}90\). Pozycja p1 bardzo dobrze pasuje do reszty skali.
- Dla porównania – bez korekty. Suma T ma średnią 60 / 5 = 12 i odchylenia −6, −3, 0, 5, 4. Iloczyny z odchyleniami p1: 12 + 3 + 0 + 5 + 8 = 28. Suma kwadratów T: 36 + 9 + 0 + 25 + 16 = 86. Zatem \(r = 28 / \sqrt{10 \cdot 86} = 28 / 29{,}33 = 0{,}95\) – więcej niż 0,90, bo p1 „siedzi” w sumie.
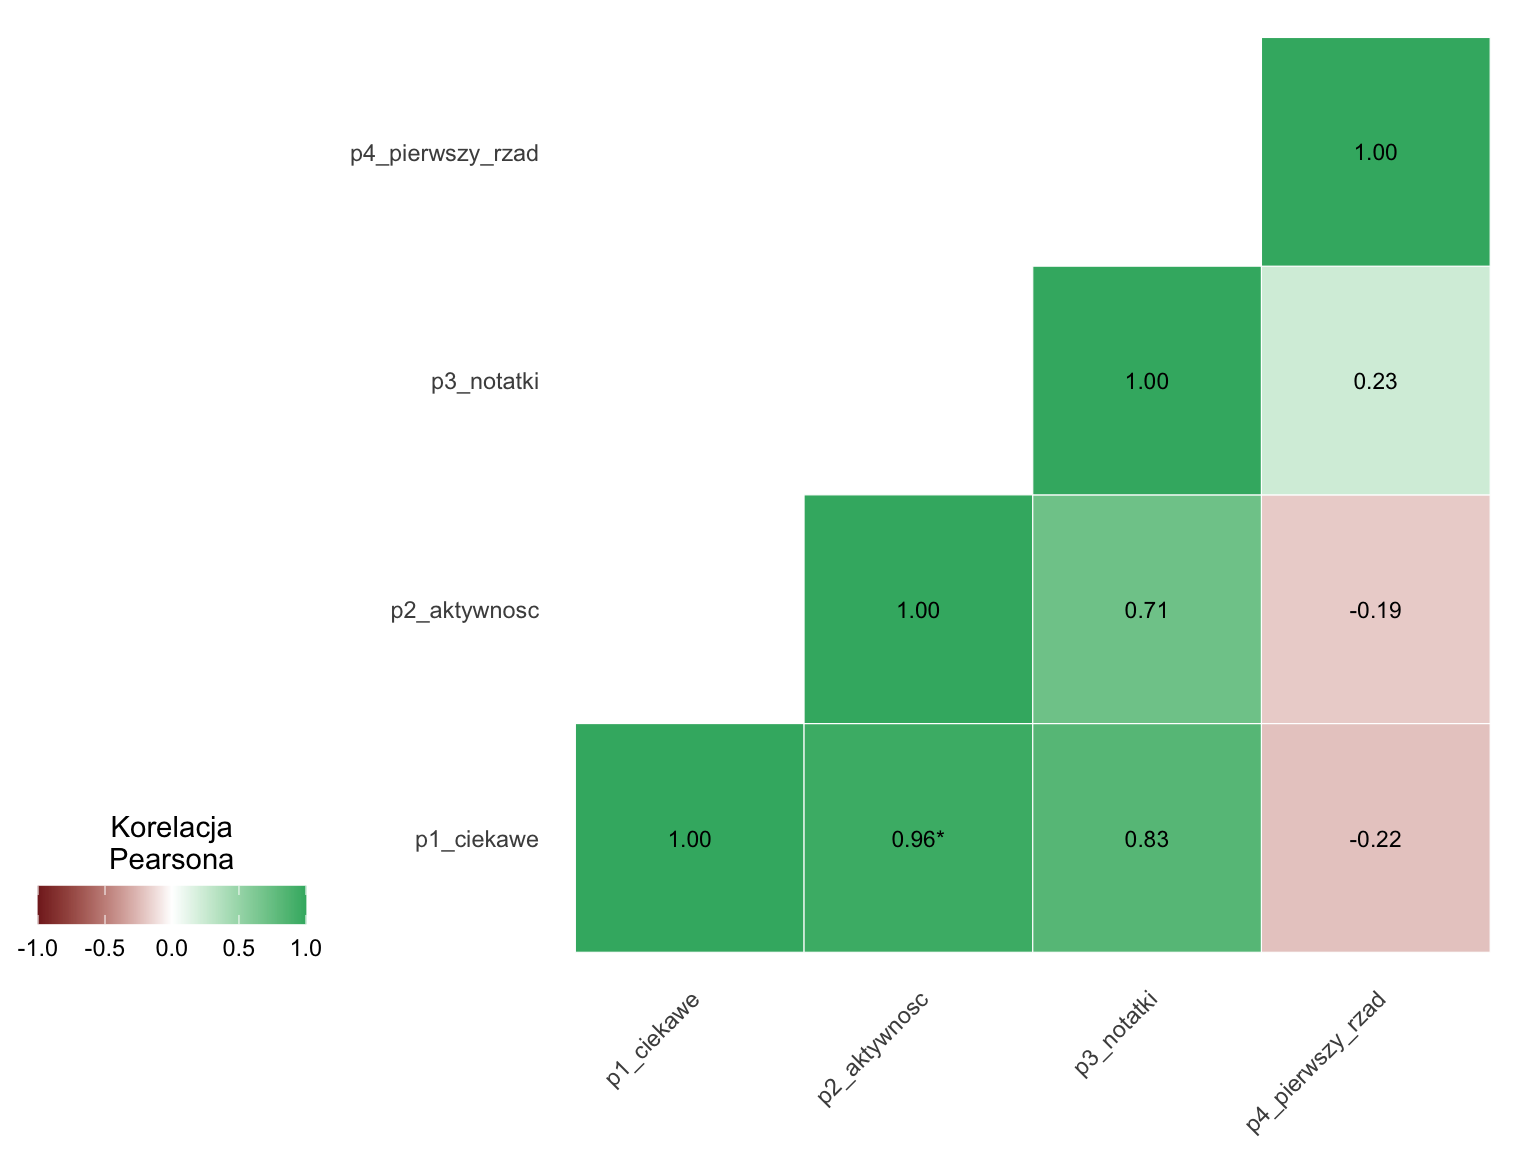
- Ta sama procedura dla p4. Reszta to p1 + p2 + p3: 3, 6, 9, 13, 14 (średnia 9, odchylenia −6, −3, 0, 4, 5). Odchylenia p4 od 3: 0, 0, 0, 1, −1. Iloczyny: 0, 0, 0, 4, −5; suma −1. Sumy kwadratów: 2 i 86. \(r = −1 / \sqrt{172} = −1 / 13{,}11 = −0{,}08\). Pozycja p4 nie pasuje do skali.
- Alfa Cronbacha całej skali. Wariancje pozycji: 2,5; 3,3; 2,3; 0,5 – razem 8,6. Wariancja sumy T: 86 / 4 = 21,5. \(\alpha = \frac{4}{3} \cdot (1 − 8{,}6 / 21{,}5) = \frac{4}{3} \cdot 0{,}6 = 0{,}80\).
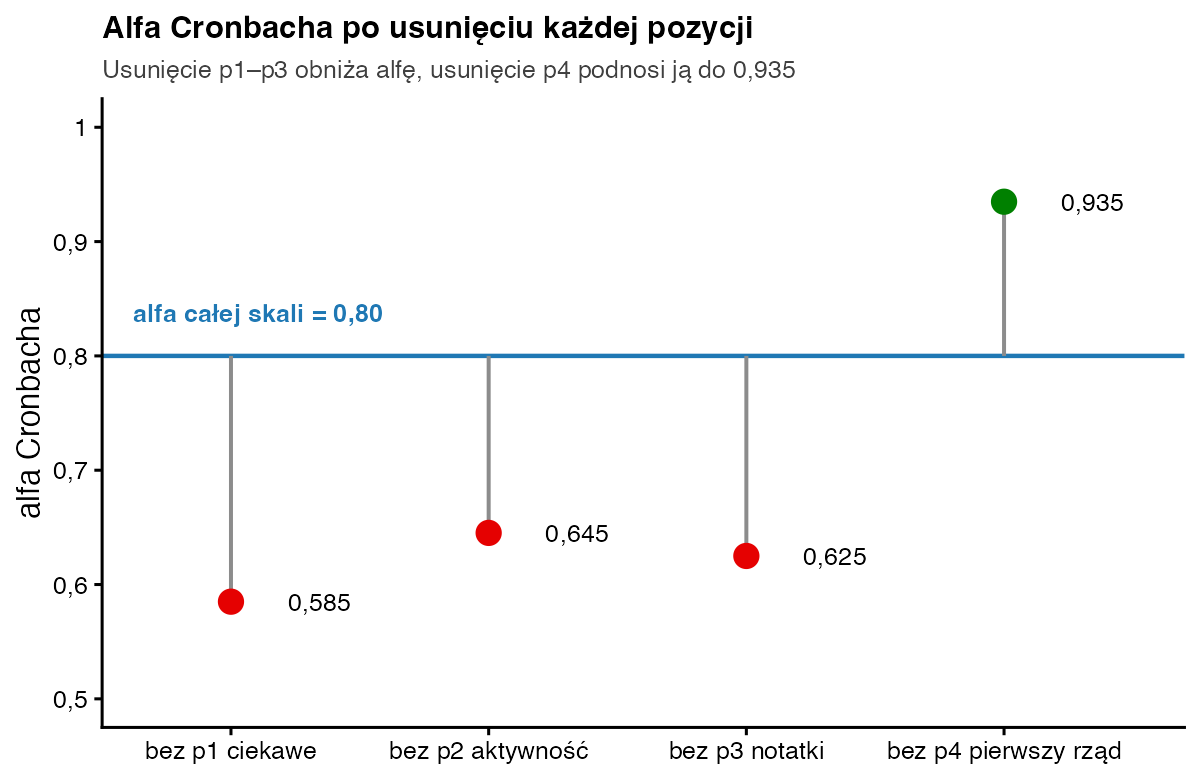
- Alfa bez p4. Wariancje p1–p3: 2,5 + 3,3 + 2,3 = 8,1. Suma bez p4 to reszta z kroku 7, jej wariancja to 86 / 4 = 21,5. \(\alpha = \frac{3}{2} \cdot (1 − 8{,}1 / 21{,}5) = 1{,}5 \cdot 0{,}623 = 0{,}935\).
| pozycja | korelacja z sumą (bez korekty) | korelacja z resztą (r.drop) | alfa po usunięciu pozycji |
|---|---|---|---|
| p1 ciekawe | 0,95 | 0,90 | 0,585 |
| p2 aktywność | 0,92 | 0,80 | 0,645 |
| p3 notatki | 0,92 | 0,84 | 0,625 |
| p4 pierwszy rząd | 0,08 | −0,08 | 0,935 |
Jak zinterpretować i opisać wynik?
Często przyjmuje się, że korelacja pozycji z resztą skali poniżej około 0,30 to sygnał problemu (Field, Miles i Field, 2012). Korelacja ujemna najczęściej oznacza, że pozycja jest sformułowana odwrotnie i zapomniano ją przekodować. Nie usuwaj jednak pytania automatycznie. Sprawdź jego treść, a decyzję uzasadnij teoretycznie. Przy 5 osobach te liczby są bardzo niepewne – w prawdziwym badaniu potrzebujesz dużo większej próby.
Zapis w stylu APA: Rzetelność skali zaangażowania (4 pozycje) oszacowano alfą Cronbacha, α = 0,80. Skorygowane korelacje pozycji z sumą pozostałych pozycji wynosiły od 0,80 do 0,90 dla pozycji 1–3 i −0,08 dla pozycji 4 („Siadam w pierwszym rzędzie”). Po usunięciu pozycji 4 alfa wzrosła do 0,93, dlatego w dalszych analizach użyto skali trzypozycyjnej.
Jak policzyć korelację pozycja–całość w R?
skala <- data.frame(p1_ciekawe    = c(1, 2, 3, 4, 5),   # „Zajęcia są dla mnie ciekawe”
                    p2_aktywnosc  = c(1, 1, 2, 4, 5),   # „Zabieram głos na zajęciach”
                    p3_notatki    = c(1, 3, 4, 5, 4),   # „Robię notatki”
                    p4_pierwszy_rzad = c(3, 3, 3, 4, 2)) # „Siadam w pierwszym rzędzie”

# 1) „ręcznie”: korelacja pozycji z sumą POZOSTAŁYCH pozycji
suma <- rowSums(skala)                                   # 6, 9, 12, 17, 16
r_drop <- sapply(skala, function(p) cor(p, suma - p))
round(r_drop, 3)                                         # 0,900  0,803  0,843  -0,076

# alfa Cronbacha dla całej skali: 4/3 * (1 - 8,6 / 21,5) = 0,80
k <- ncol(skala); k / (k - 1) * (1 - sum(sapply(skala, var)) / var(suma))

# 2) gotową funkcją z pakietu psych
a <- suppressWarnings(suppressMessages(psych::alpha(skala, warnings = FALSE)))
data.frame(r_drop = round(a$item.stats$r.drop, 3),
           alfa_bez_pozycji = round(a$alpha.drop$raw_alpha, 3), row.names = names(skala))
Wynik w konsoli R:
      p1_ciekawe     p2_aktywnosc       p3_notatki p4_pierwszy_rzad
           0.900            0.803            0.843           -0.076
[1] 0.8
                 r_drop alfa_bez_pozycji
p1_ciekawe        0.900            0.585
p2_aktywnosc      0.803            0.645
p3_notatki        0.843            0.625
p4_pierwszy_rzad -0.076            0.935
Kolumna r.drop z psych::alpha() daje dokładnie te same liczby co ręczne cor(p, suma - p). Kolumna raw_alpha w tabeli alpha.drop to alfa po usunięciu danej pozycji. Gdy masz pytania odwrócone, przekoduj je wcześniej albo użyj argumentu keys.
Co lepsze: r.drop czy alfa po usunięciu pozycji?
Patrz na oba wskaźniki razem – zwykle prowadzą do tego samego wniosku. Korelacja z resztą mówi, jak dobrze pozycja pasuje do pozostałych. Alfa po usunięciu mówi, co stanie się z całą skalą bez niej. Gdy pozycje mają różną wagę dla mierzonej cechy, lepszym narzędziem jest analiza czynnikowa. Przy pytaniach Likerta warto wtedy oprzeć ją na korelacji polichorycznej. Więcej praktycznych wskazówek znajdziesz w tekście o analizie skali Likerta.
Najczęstsze błędy
- Raportowanie korelacji z sumą zawierającą pozycję – jest zawyżona.
- Usuwanie pozycji tylko dlatego, że alfa wzrośnie o 0,01, bez zastanowienia nad treścią pytania.
- Brak przekodowania pytań odwróconych przed analizą – stąd korelacje ujemne.
- Liczenie jednej alfy dla kilku różnych skal naraz zamiast osobno dla każdej.
- Usuwanie wielu pozycji po kolei „aż alfa będzie wysoka” – skala traci wtedy sens treściowy.
Bibliografia
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5). Northwestern University. https://CRAN.R-project.org/package=psych
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówŁadunek czynnikowy
- Słownik wzorówKorelacja Pearsona
- PoradnikAlfa Cronbacha – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportPrzykład SZTOS: analiza rzetelności skal
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.