

Margines błędu i liczebność próby – wzór i przykład
Margines błędu mówi, o ile w górę i w dół może się mylić odsetek z ankiety, a wzór na liczebność próby – ile osób musisz zbadać, żeby ten margines był wystarczająco mały. Typowe pytanie z pracy dyplomowej: ilu studentów muszę przebadać, żeby wynik ankiety był „reprezentatywny”?
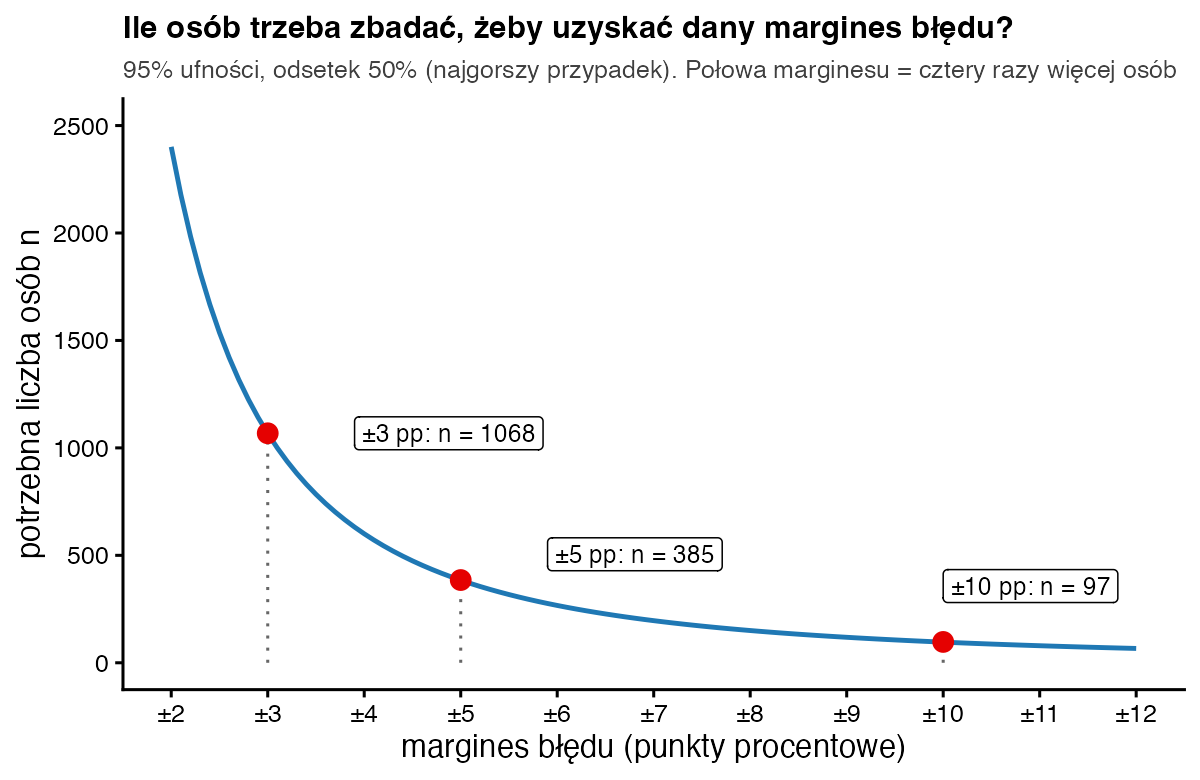
W prostych słowachNajpierw decydujesz, jak dokładny ma być wynik, np. „najwyżej 5 punktów procentowych w jedną lub drugą stronę”. Wzór przelicza to na liczbę osób. Im dokładniej chcesz, tym więcej osób – i to szybko: dwa razy mniejszy margines wymaga czterech razy większej próby. Liczba z wzoru ma sens tylko wtedy, gdy osoby są wybrane losowo.
Kiedy liczyć margines błędu i liczebność próby?
- planujesz ankietę i chcesz uzasadnić w metodologii, dlaczego badasz właśnie tyle osób;
- głównym wynikiem będzie odsetek (np. ilu studentów korzysta z korepetycji);
- masz już dane i chcesz podać, jak precyzyjny jest odsetek – wtedy liczysz margines dla znanego n (to połowa szerokości przedziału ufności dla proporcji);
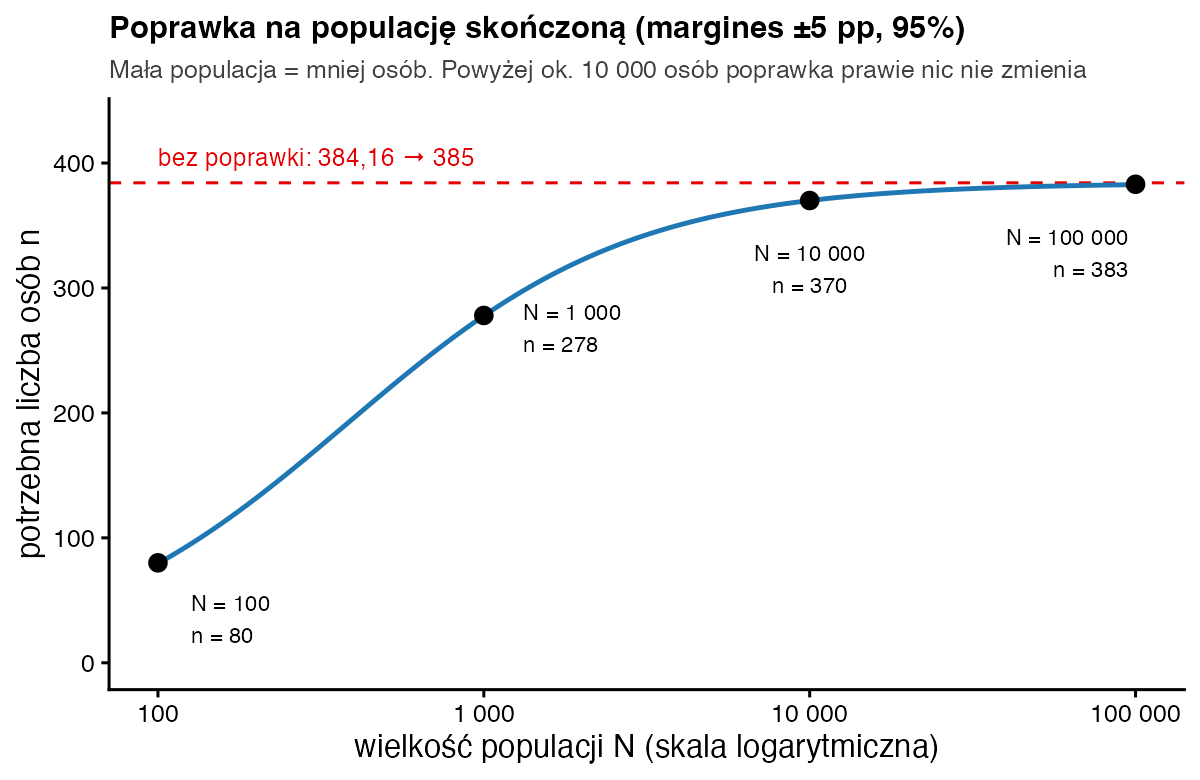
- badasz zamkniętą grupę (np. 1000 studentów jednego wydziału) i chcesz uwzględnić, że populacja jest mała.
Ten wzór dotyczy dokładności oszacowania jednego odsetka. Jeśli Twoje hipotezy dotyczą porównań (np. czy kobiety i mężczyźni różnią się wynikiem), potrzebujesz analizy mocy testu – zobacz błąd drugiego rodzaju i moc testu. Dlaczego w ogóle możemy korzystać z rozkładu normalnego, wyjaśnia centralne twierdzenie graniczne.
Wzór na margines błędu i liczebność próby
- \(E\)
- margines błędu zapisany jako ułamek: ±5 punktów procentowych to 0,05
- \(z\)
- wartość z rozkładu normalnego dla poziomu ufności: 1,96 dla 95%, 2,576 dla 99%
- \(p\)
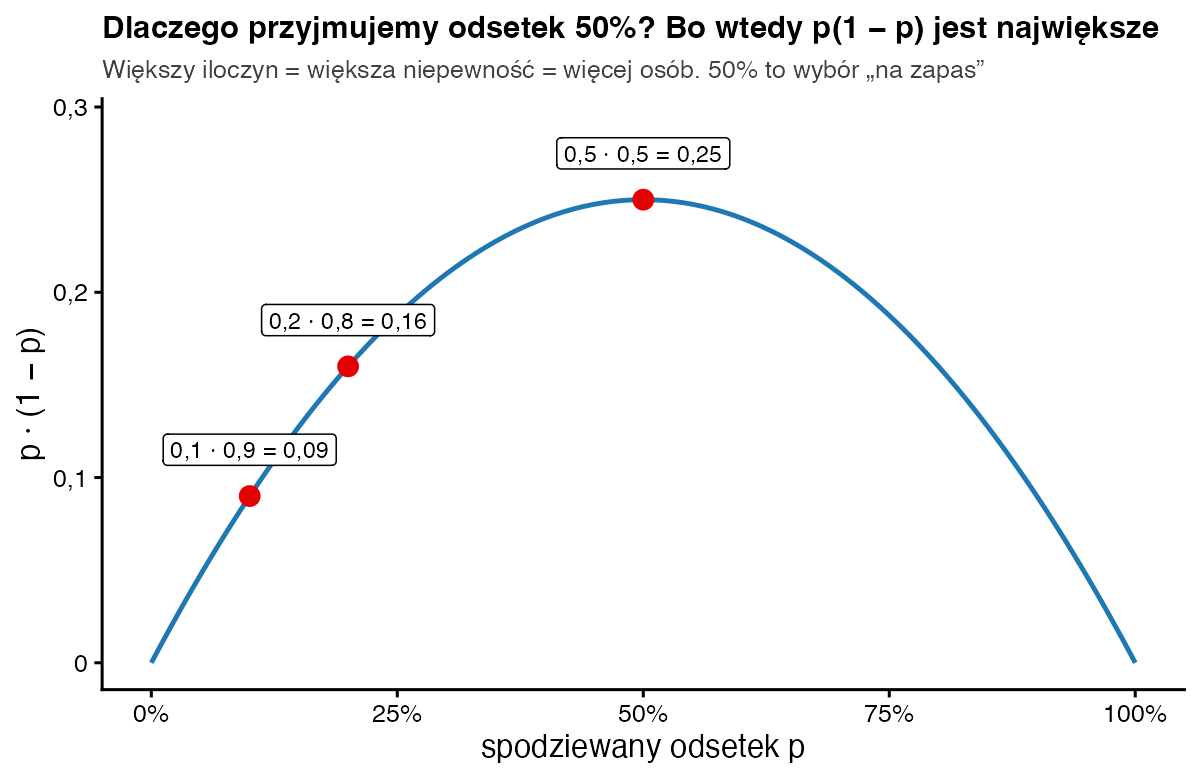
- spodziewany odsetek odpowiedzi „tak”; gdy go nie znasz, wstaw 0,5 – to wariant najbezpieczniejszy
- \(\sqrt{p(1-p)/n}\)
- błąd standardowy odsetka
- \(n_0\)
- potrzebna liczba osób, gdy populacja jest bardzo duża
- \(N\)
- wielkość całej populacji, z której losujesz (np. 1000 studentów wydziału)
- \(n\)
- potrzebna liczba osób po poprawce na populację skończoną; zawsze zaokrąglasz w górę
Środkowy wzór przeczytasz na głos tak: „liczba osób to kwadrat wartości z razy p razy jeden minus p, podzielone przez kwadrat marginesu błędu”. Margines jest w mianowniku i do tego w kwadracie – dlatego zmniejszanie go tak szybko „kosztuje” osoby.
Przykład krok po kroku
Chcesz oszacować, jaki odsetek studentów korzysta z korepetycji. Wynik ma mieć margines ±5 punktów procentowych przy 95% ufności. Nie wiesz, jakiego odsetka się spodziewać, więc przyjmujesz p = 0,5. Tabela pokazuje też warianty ±10 i ±3 punkty:
| Margines E | E² | z² · p · (1 − p) | n₀ = licznik / E² | n₀ w górę | po poprawce (N = 1000) |
|---|---|---|---|---|---|
| ±10 pp = 0,10 | 0,01 | 0,9604 | 96,04 | 97 | 87,70 → 88 |
| ±5 pp = 0,05 | 0,0025 | 0,9604 | 384,16 | 385 | 277,74 → 278 |
| ±3 pp = 0,03 | 0,0009 | 0,9604 | 1067,11 | 1068 | 516,48 → 517 |
- Wartość z. Dla 95% ufności z = 1,96 (w tablicy rozkładu normalnego: wartość, poniżej której leży 97,5% pola; w R:
qnorm(0.975)). Do kwadratu: 1,96 · 1,96 = 3,8416. - Iloczyn p(1 − p). 0,5 · 0,5 = 0,25. Licznik: 3,8416 · 0,25 = 0,9604.
- Kwadrat marginesu. 0,05 · 0,05 = 0,0025.
- Dzielenie. n₀ = 0,9604 / 0,0025 = 384,16. Nie da się zbadać 0,16 osoby, a zaokrąglenie w dół dałoby margines nieco większy niż 5 punktów, więc zaokrąglasz w górę: 385 osób.
- Poprawka na populację skończoną. Jeśli cały wydział liczy N = 1000 studentów, to 384,16 − 1 = 383,16; 383,16 / 1000 = 0,38316; 1 + 0,38316 = 1,38316; 384,16 / 1,38316 = 277,74. W górę: 278 osób. Jeśli najpierw zaokrąglisz n₀ do 385, a dopiero potem zastosujesz poprawkę, wyjdzie 278,18, czyli 279 – taką wersję podają niektóre kalkulatory. Różnica jednej osoby nie ma znaczenia; 278 już wystarcza (sprawdzenie w R niżej).
- Inne marginesy. Dla ±10 punktów: 0,9604 / 0,01 = 96,04 → 97 osób. Dla ±3 punktów: 0,9604 / 0,0009 = 1067,11 → 1068 osób. Z ±5 na ±3 punkty to niecałe dwa razy dokładniej, ale prawie trzy razy więcej osób.
Jeśli z wcześniejszych badań wiesz, że odsetek wynosi około 20%, wstaw p = 0,2: 3,8416 · 0,16 / 0,0025 = 245,86 → 246 osób. Odsetek 50% to „najgorszy przypadek” (Rys. 3), więc przyjmując go, nigdy nie zbadasz za mało osób.
Jak zinterpretować i opisać wynik?
W rozdziale metodologicznym podaj wszystkie założenia: poziom ufności, margines błędu, przyjęty odsetek i wielkość populacji. Po zebraniu danych licz margines dla faktycznej liczby osób – jeśli zamiast 278 odpowiedziało 200 studentów, margines będzie większy niż 5 punktów. Bądź uczciwy: wzór zakłada losowy dobór próby. Ankieta rozesłana po znajomych albo na grupie wydziałowej nie staje się reprezentatywna dlatego, że wypełniło ją 385 osób. Margines błędu opisuje tylko przypadkowe wahania losowania, a nie to, że do badania trafiły głównie osoby aktywne w mediach społecznościowych. Przy próbie dostępności napisz to wprost w ograniczeniach badania (zobacz też: opracowanie wyników ankiety).
Zapis w stylu APA: Minimalną liczebność próby wyznaczono dla oszacowania odsetka przy poziomie ufności 95%, marginesie błędu ±5 punktów procentowych i najbardziej zachowawczym założeniu p = 0,50. Po uwzględnieniu poprawki na populację skończoną (N = 1000) wymagana liczebność wyniosła n = 278 osób.
Jak policzyć liczebność próby w R?
z <- 1.96      # 95% ufności (dokładnie: qnorm(0.975))
p <- 0.5       # spodziewany odsetek; 0,5 = wariant „na zapas”
E <- 0.05      # margines błędu: ±5 punktów procentowych
N <- 1000      # wielkość populacji (np. studenci jednego wydziału)

# 1) liczebność próby „ręcznie”
n0 <- z^2 * p * (1 - p) / E^2
n0; ceiling(n0)                       # 384,16 -> 385

# 2) poprawka na populację skończoną
n_N <- n0 / (1 + (n0 - 1) / N)
n_N; ceiling(n_N)                     # 277,74 -> 278

# 3) ±3, ±5 i ±10 punktów procentowych
ceiling(z^2 * p * (1 - p) / c(0.03, 0.05, 0.10)^2)

# 4) sprawdzenie odwrotne: jaki margines daje dana liczba osób?
margines <- function(n, N = Inf) {
  fpc <- if (is.finite(N)) (N - n) / (N - 1) else 1   # poprawka tylko dla skończonej N
  z * sqrt(p * (1 - p) / n * fpc)
}
round(100 * margines(c(384, 385)), 3)                 # bez poprawki
round(100 * margines(c(277, 278), N = 1000), 3)       # populacja 1000
Wynik w konsoli R:
[1] 384.16
[1] 385
[1] 277.7408
[1] 278
[1] 1068  385   97
[1] 5.001 4.995
[1] 5.009 4.997
Sprawdzenie odwrotne pokazuje, dlaczego zaokrąglamy w górę: przy 384 osobach margines wynosi 5,001 punktu (ciut za dużo), a przy 385 – 4,995. W populacji 1000 osób 277 osób daje 5,009, a 278 osób – 4,997 punktu.
Czy 385 osób to zawsze „reprezentatywna próba”?
Nie. Liczba 385 krąży po internecie jak magiczna stała, ale to tylko wynik jednego zestawu założeń: 95%, ±5 punktów, p = 0,5. Reprezentatywność zależy od sposobu doboru osób, a nie od ich liczby. Losowa próba 278 studentów z listy wydziału powie więcej niż 2000 odpowiedzi z otwartego linku. Jeśli zamierzasz porównywać podgrupy (np. kierunki studiów), margines liczysz dla każdej podgrupy osobno – a wtedy potrzebnych osób szybko przybywa.
Najczęstsze błędy
- Zaokrąglanie liczebności w dół (384 zamiast 385) – margines wychodzi wtedy odrobinę większy niż zakładany.
- Wpisywanie marginesu w procentach (5) zamiast jako ułamka (0,05) – wynik wychodzi absurdalnie mały.
- Traktowanie wzoru jako dowodu reprezentatywności ankiety zebranej „po znajomych”.
- Używanie wzoru dla jednego odsetka do planowania porównań grup – do tego służy analiza mocy testu.
- Liczenie marginesu dla całej próby i przenoszenie go na małe podgrupy (np. 40 osób z jednego kierunku).
Bibliografia
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Lohr, S. L. (2010). Sampling: Design and analysis (2nd ed.). Brooks/Cole.
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówPrzedział ufności dla proporcji
- Słownik wzorówBłąd II rodzaju (β) i moc testu
- Słownik wzorówCentralne twierdzenie graniczne
- Słownik wzorówBłąd standardowy średniej
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.