

Przedział ufności dla proporcji – wzór i przykład
Przedział ufności dla proporcji pokazuje, w jakim zakresie prawdopodobnie leży prawdziwy odsetek w populacji, skoro znasz tylko odsetek z próby. Typowe pytanie z pracy dyplomowej: 60% ankietowanych studentów pije kawę przed kolokwium – ale ile może to być wśród wszystkich studentów uczelni?
W prostych słowachOdsetek z próby prawie nigdy nie jest równy odsetkowi w całej populacji. Gdybyś zapytał inne 100 osób, wyszłoby może 55% albo 64%. Przedział ufności mówi, jak daleko w obie strony może „uciec” Twój wynik. Im więcej osób zbadasz, tym przedział jest węższy.
Kiedy stosować przedział ufności dla proporcji?
- zmienna ma dwie wartości: tak/nie, zdał/nie zdał, pije kawę/nie pije;
- chcesz podać odsetek „tak” razem z jego niepewnością, a nie jako gołą liczbę;
- osoby badane są od siebie niezależne i zostały wybrane losowo (albo przynajmniej w sposób, który nie faworyzuje żadnej odpowiedzi);
- opisujesz wyniki ankiety, np. w tabeli częstości – przedział możesz dopisać do każdego odsetka.
Dla średniej wyników ilościowych potrzebujesz przedziału ufności dla średniej. Gdy chcesz sprawdzić, czy odsetek różni się od konkretnej wartości (np. 50%), użyj testu dwumianowego, a gdy porównujesz odsetki w dwóch grupach – testu z dla dwóch proporcji. Jeśli dopiero planujesz badanie i chcesz wiedzieć, ile osób zapytać, zajrzyj do hasła margines błędu i liczebność próby.
Wzór na przedział ufności dla proporcji
Najprostsza wersja to przedział Walda. Lepiej działa przedział Wilsona – podają go m.in. R i wiele kalkulatorów.
- \(\hat{p}\)
- odsetek w próbie zapisany jako ułamek: liczba odpowiedzi „tak” podzielona przez liczbę wszystkich osób (60 / 100 = 0,6)
- \(n\)
- liczba osób w próbie
- \(1-\hat{p}\)
- odsetek odpowiedzi „nie” (1 − 0,6 = 0,4)
- \(\sqrt{\hat{p}(1-\hat{p})/n}\)
- błąd standardowy odsetka – o ile typowo odsetek z próby różni się od prawdziwego
- \(z\)
- wartość z rozkładu normalnego dla wybranego poziomu ufności; dla 95% wynosi 1,96
- \(\pm\)
- „plus minus”: odejmując dostajesz dolną granicę, dodając – górną
Wzór Walda przeczytasz na głos tak: „odsetek z próby plus minus 1,96 razy błąd standardowy tego odsetka”. Wzór Wilsona robi to samo, ale lekko przesuwa środek przedziału w stronę 50% i poprawia jego szerokość. Przy dużej próbie oba wzory dają prawie to samo.
Przykład krok po kroku
Zapytałeś 100 losowo wybranych studentów, czy piją kawę przed kolokwium. Tak odpowiedziało 60 osób:
| Odpowiedź | Liczba osób | Odsetek (ułamek) | Odsetek |
|---|---|---|---|
| tak, piję kawę | 60 | 60 / 100 = 0,6 | 60% |
| nie piję kawy | 40 | 40 / 100 = 0,4 | 40% |
| Razem | 100 | 1,0 | 100% |
- Odsetek w próbie. \(\hat{p}\) = 60 / 100 = 0,6. To nasz najlepszy pojedynczy „strzał”.
- Iloczyn w liczniku. 0,6 · 0,4 = 0,24. Ten iloczyn jest największy (0,25), gdy odsetek wynosi 50% – wtedy niepewność jest największa.
- Dzielimy przez n. 0,24 / 100 = 0,0024.
- Błąd standardowy. SE = √0,0024 ≈ 0,049, czyli około 4,9 punktu procentowego.
- Wartość z. Dla 95% ufności bierzemy z = 1,96. W tablicy rozkładu normalnego szukasz wartości, poniżej której leży 97,5% pola (po 2,5% zostaje w każdym ogonie). W R:
qnorm(0.975). - Margines błędu. 1,96 · 0,049 ≈ 0,096, czyli 9,6 punktu procentowego.
- Przedział Walda. Dolna granica: 0,6 − 0,096 = 0,504. Górna: 0,6 + 0,096 = 0,696. Wynik: [50,4%; 69,6%].
- Przedział Wilsona. Najpierw z² = 1,96 · 1,96 = 3,8416. Środek: (0,6 + 3,8416 / 200) / (1 + 3,8416 / 100) = (0,6 + 0,0192) / 1,0384 = 0,6192 / 1,0384 ≈ 0,5963. Pod pierwiastkiem: 0,0024 + 3,8416 / 40 000 = 0,0024 + 0,000096 = 0,002496; √0,002496 ≈ 0,04996. Połowa szerokości: 1,96 · 0,04996 / 1,0384 ≈ 0,0943. Granice: 0,5963 − 0,0943 = 0,502 oraz 0,5963 + 0,0943 = 0,691. Wynik: [50,2%; 69,1%].
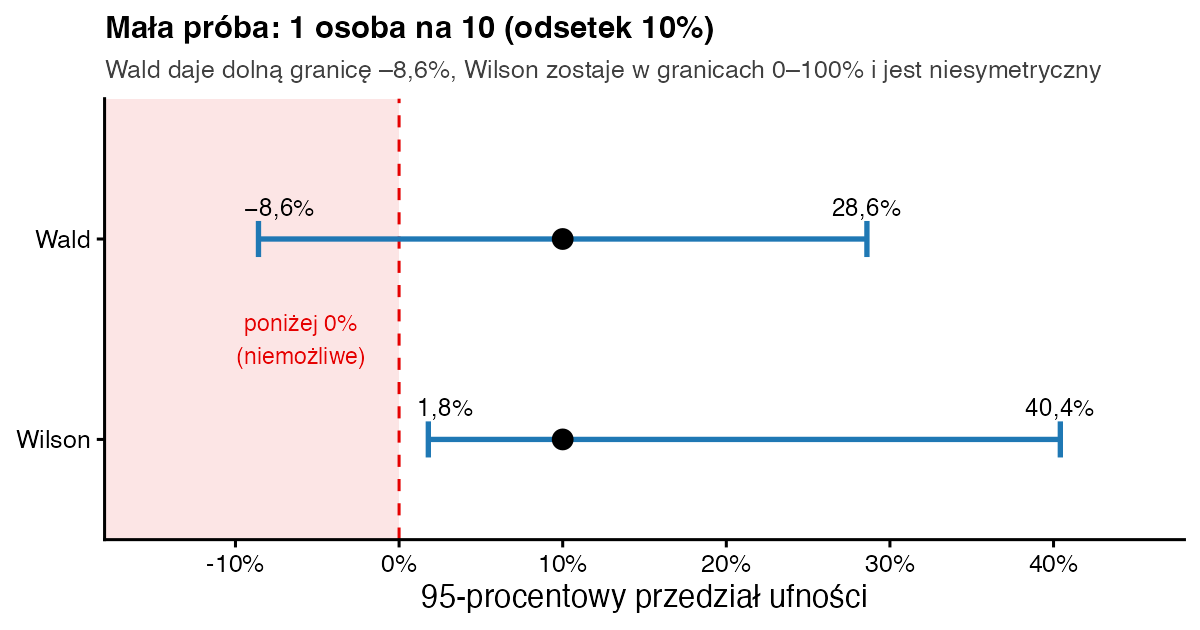
Przy 100 osobach i odsetku 60% oba przedziały prawie się pokrywają. Różnica wychodzi przy małych próbach. Gdy 1 osoba na 10 pije kawę (10%), Wald daje 0,1 ± 1,96 · √(0,1 · 0,9 / 10) = 0,1 ± 0,186, czyli [−8,6%; 28,6%] – dolna granica jest ujemna, a to niemożliwe. Wilson daje [1,8%; 40,4%]. Gdy w próbie nikt nie odpowie „tak” (0 na 20), Wald daje przedział [0%; 0%] o zerowej szerokości, co sugeruje absolutną pewność – a przecież zbadałeś tylko 20 osób.
Jak zinterpretować i opisać wynik?
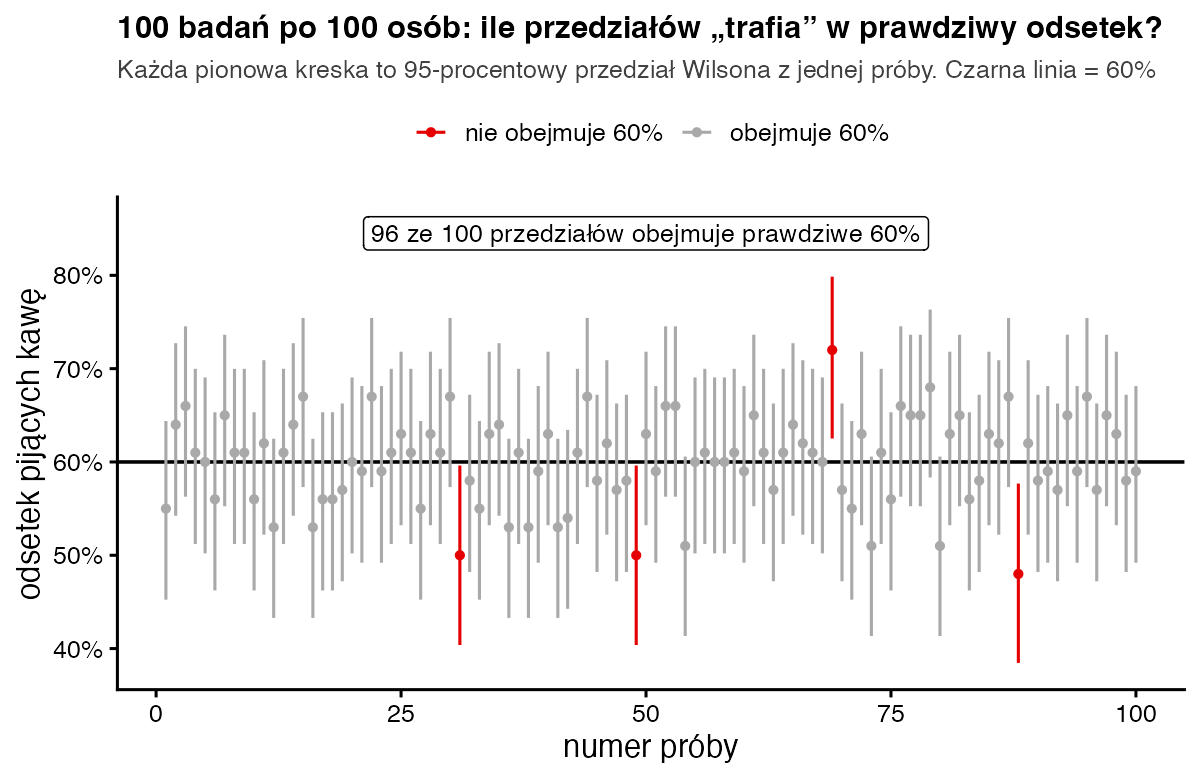
Najprościej: „na podstawie próby szacujemy, że kawę przed kolokwium pije od około 50% do 69% studentów”. Poprawna interpretacja 95% dotyczy metody: jeśli wiele razy powtórzysz badanie i za każdym razem policzysz przedział, około 95 na 100 przedziałów obejmie prawdziwy odsetek (Rys. 1). Nie pisz „z prawdopodobieństwem 95% prawdziwy odsetek leży w tym przedziale” – w tym konkretnym przedziale albo leży, albo nie. Pamiętaj też, że przedział opisuje tylko błąd losowania. Jeśli ankietę wypełnili głównie Twoi znajomi, żaden wzór nie naprawi tego, że próba nie przypomina populacji.
Zapis w stylu APA: Kawę przed kolokwium deklarowało 60 ze 100 badanych studentów (60%; 95% CI [50,2%; 69,1%], przedział Wilsona).
Jak policzyć przedział ufności dla proporcji w R?
x <- 60; n <- 100          # 60 ze 100 studentów pije kawę przed kolokwium
z <- qnorm(0.975)          # 1,96 – wartość z dla 95% ufności
p <- x / n                 # odsetek w próbie: 0,6

# 1) przedział Walda „ręcznie”
se <- sqrt(p * (1 - p) / n)
round(c(p = p, SE = se, dolna = p - z * se, gorna = p + z * se), 3)

# 2) przedział Wilsona „ręcznie”
srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
pol    <- z / (1 + z^2 / n) * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
round(c(srodek = srodek, dolna = srodek - pol, gorna = srodek + pol), 3)

# 3) gotowa funkcja: prop.test() bez poprawki na ciągłość = Wilson
prop.test(x, n, correct = FALSE)$conf.int

# 4) mała próba: 1 osoba na 10
round(0.1 + c(-1, 1) * z * sqrt(0.1 * 0.9 / 10), 3)   # Wald
round(prop.test(1, 10, correct = FALSE)$conf.int, 3)  # Wilson
Wynik w konsoli R:
    p    SE dolna gorna
0.600 0.049 0.504 0.696
srodek  dolna  gorna
 0.596  0.502  0.691
[1] 0.5020026 0.6905987
attr(,"conf.level")
[1] 0.95
[1] -0.086  0.286
[1] 0.018 0.404
attr(,"conf.level")
[1] 0.95
Funkcja prop.test() z argumentem correct = FALSE zwraca dokładnie przedział Wilsona – te same liczby, które policzyłeś ręcznie. Domyślnie (bez tego argumentu) R dodaje poprawkę na ciągłość i przedział wychodzi nieco szerszy.
Wald czy Wilson – który przedział wybrać?
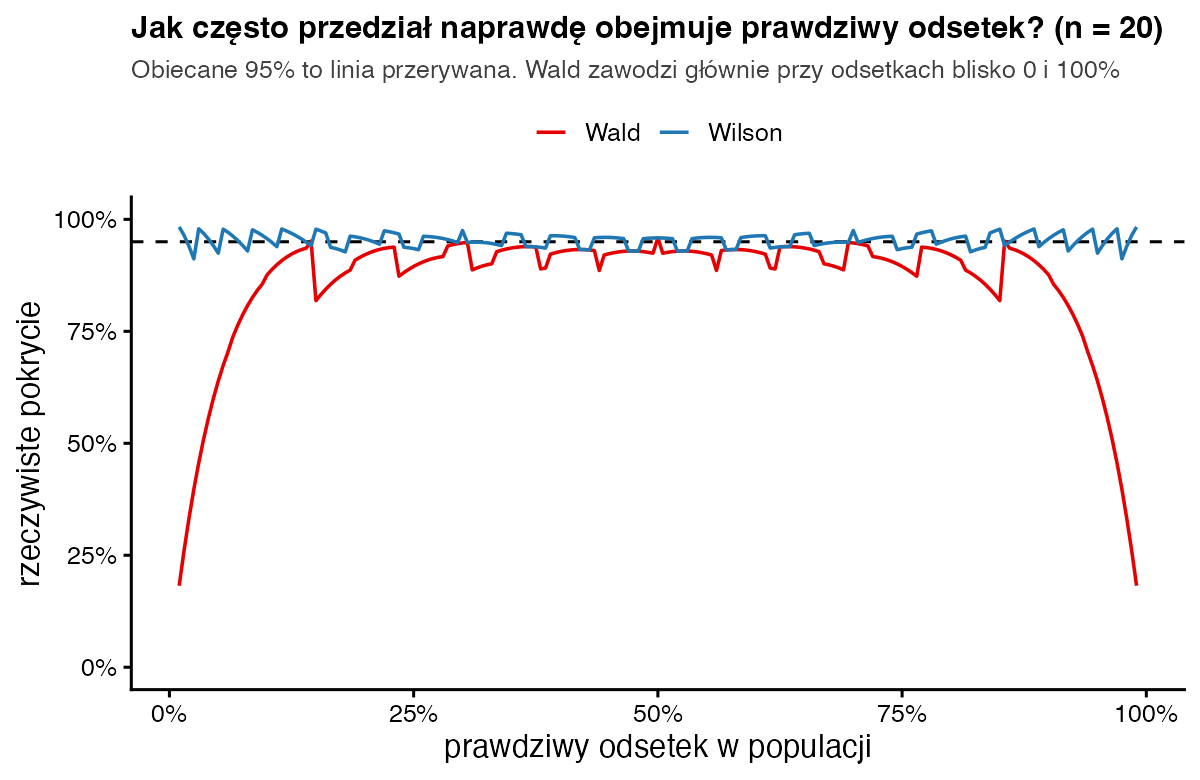
Wybierz Wilsona. Brown, Cai i DasGupta (2001) pokazali, że przedział Walda ma za małe pokrycie nie tylko w małych próbach, ale „nieprzewidywalnie” także przy kilkudziesięciu osobach (Rys. 3 – ząbki na czerwonej linii). Wald jest w porządku, gdy w próbie masz co najmniej kilkadziesiąt odpowiedzi „tak” i kilkadziesiąt „nie”. Zawodzi, gdy próba jest mała albo odsetek jest blisko 0 lub 100%. Inną dobrą opcją jest przedział Agrestiego-Coulla (1998): dodajesz po 2 odpowiedzi „tak” i „nie”, a potem liczysz zwykły wzór Walda. Istnieje też przedział „dokładny” Cloppera-Pearsona (w R: binom.test()), ale jest zwykle szerszy niż trzeba.
Najczęstsze błędy
- Podawanie samego odsetka („60% studentów pije kawę”) bez liczby osób i bez przedziału ufności.
- Liczenie przedziału Walda przy 10–20 osobach albo przy odsetku bliskim 0 lub 100% – wychodzą wtedy granice ujemne, powyżej 100% albo przedział o zerowej szerokości.
- Mylenie procentów z punktami procentowymi: margines 9,6 punktu procentowego to nie to samo co 9,6% wyniku.
- Interpretowanie 95% jako prawdopodobieństwa, że prawdziwy odsetek leży w tym jednym przedziale.
- Liczenie przedziału dla ankiety „po znajomych” i traktowanie go jak wyniku dla całej populacji.
Bibliografia
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953
- Agresti, A., & Coull, B. A. (1998). Approximate is better than “exact” for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówMargines błędu i liczebność próby
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówCzęstości i procenty
- Słownik wzorówTest dwumianowy
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.