

Rozkład F Fishera-Snedecora – wzór, przykład i R
Rozkład F opisuje iloraz dwóch wariancji i jest podstawą analizy wariancji (ANOVA), testu Levene’a i testu całego modelu regresji. Typowe pytanie z pracy dyplomowej: co oznacza zapis F(2, 6) = 7,00 i skąd wiadomo, że taki wynik jest istotny?
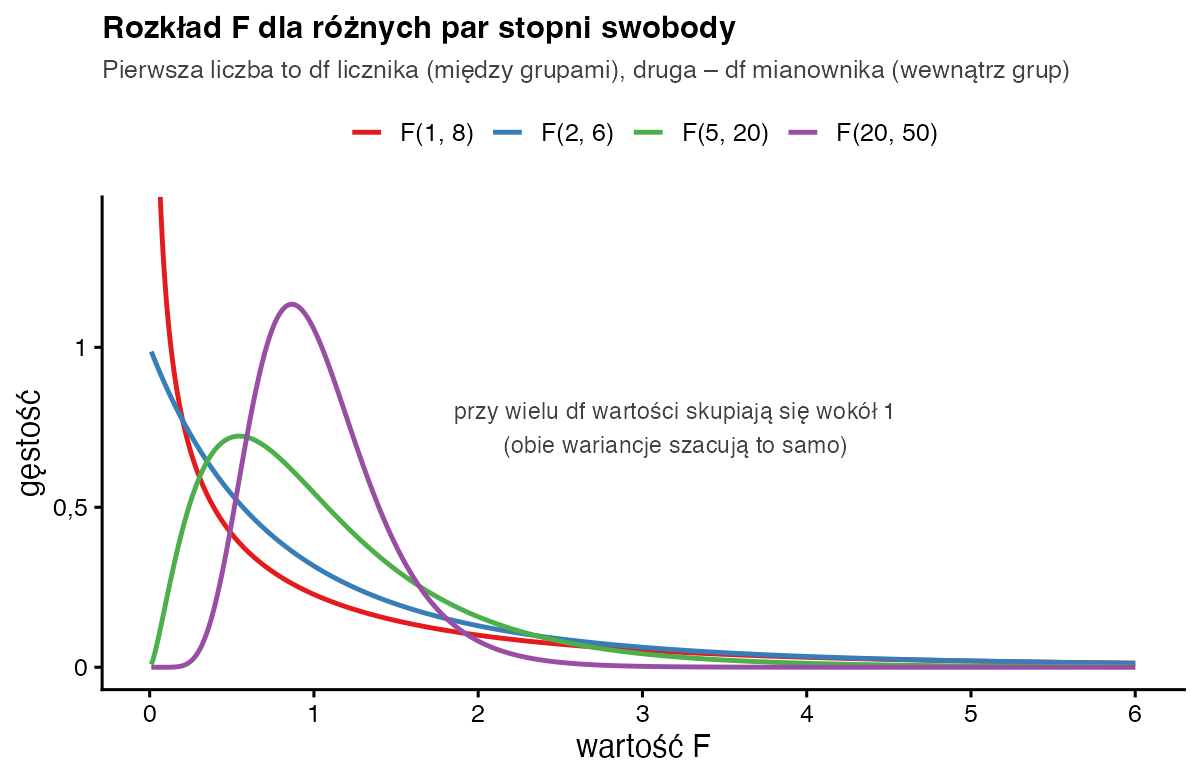
W prostych słowachF to jeden rozrzut podzielony przez drugi. W ANOVA w liczniku jest rozrzut średnich grup (jak bardzo grupy różnią się od siebie), a w mianowniku – rozrzut wyników wewnątrz grup (zwykły „szum”). Gdy grupy w populacji się nie różnią, oba rozrzuty szacują to samo i F wychodzi w okolicach 1. Im bardziej F przekracza 1, tym trudniej uznać różnice między grupami za przypadek.
Kiedy korzystasz z rozkładu F?
- wykonujesz jednoczynnikową analizę wariancji albo ANOVA dla pomiarów powtarzanych;
- sprawdzasz, czy cały model regresji wyjaśnia coś więcej niż przypadek (test F dla R²);
- porównujesz wariancje dwóch grup (test F, w R
var.test()) albo stosujesz test Levene’a, którego statystyka też ma rozkład F; - porównujesz modele zagnieżdżone, np. w regresji hierarchicznej (test zmiany R²).
Rozkład F jest ilorazem dwóch zmiennych chi-kwadrat, z których każdą podzielono przez jej stopnie swobody. Przy dwóch grupach F jest po prostu kwadratem statystyki t Studenta – więcej o tym niżej.
Wzór na statystykę F
- \(s_1^2,\ s_2^2\)
- dwie wariancje; w zwykłym teście F dla dwóch grup – wariancje tych grup
- \(SS_B\)
- suma kwadratów między grupami: jak daleko średnie grup leżą od średniej ogólnej (każda odległość do kwadratu, razy liczba osób w grupie)
- \(SS_W\)
- suma kwadratów wewnątrz grup: jak daleko wyniki leżą od średniej własnej grupy
- \(MS_B,\ MS_W\)
- średnie kwadraty, czyli sumy kwadratów podzielone przez swoje df – to są dwie wariancje, które dzielimy
- \(k - 1\)
- stopnie swobody licznika (liczba grup minus 1) – pierwsza liczba w nawiasie F(…, …)
- \(N - k\)
- stopnie swobody mianownika (liczba wszystkich osób minus liczba grup) – druga liczba w nawiasie
Na głos czytamy: „F to wariancja między grupami podzielona przez wariancję wewnątrz grup; ma k minus jeden i N minus k stopni swobody”.
Przykład krok po kroku
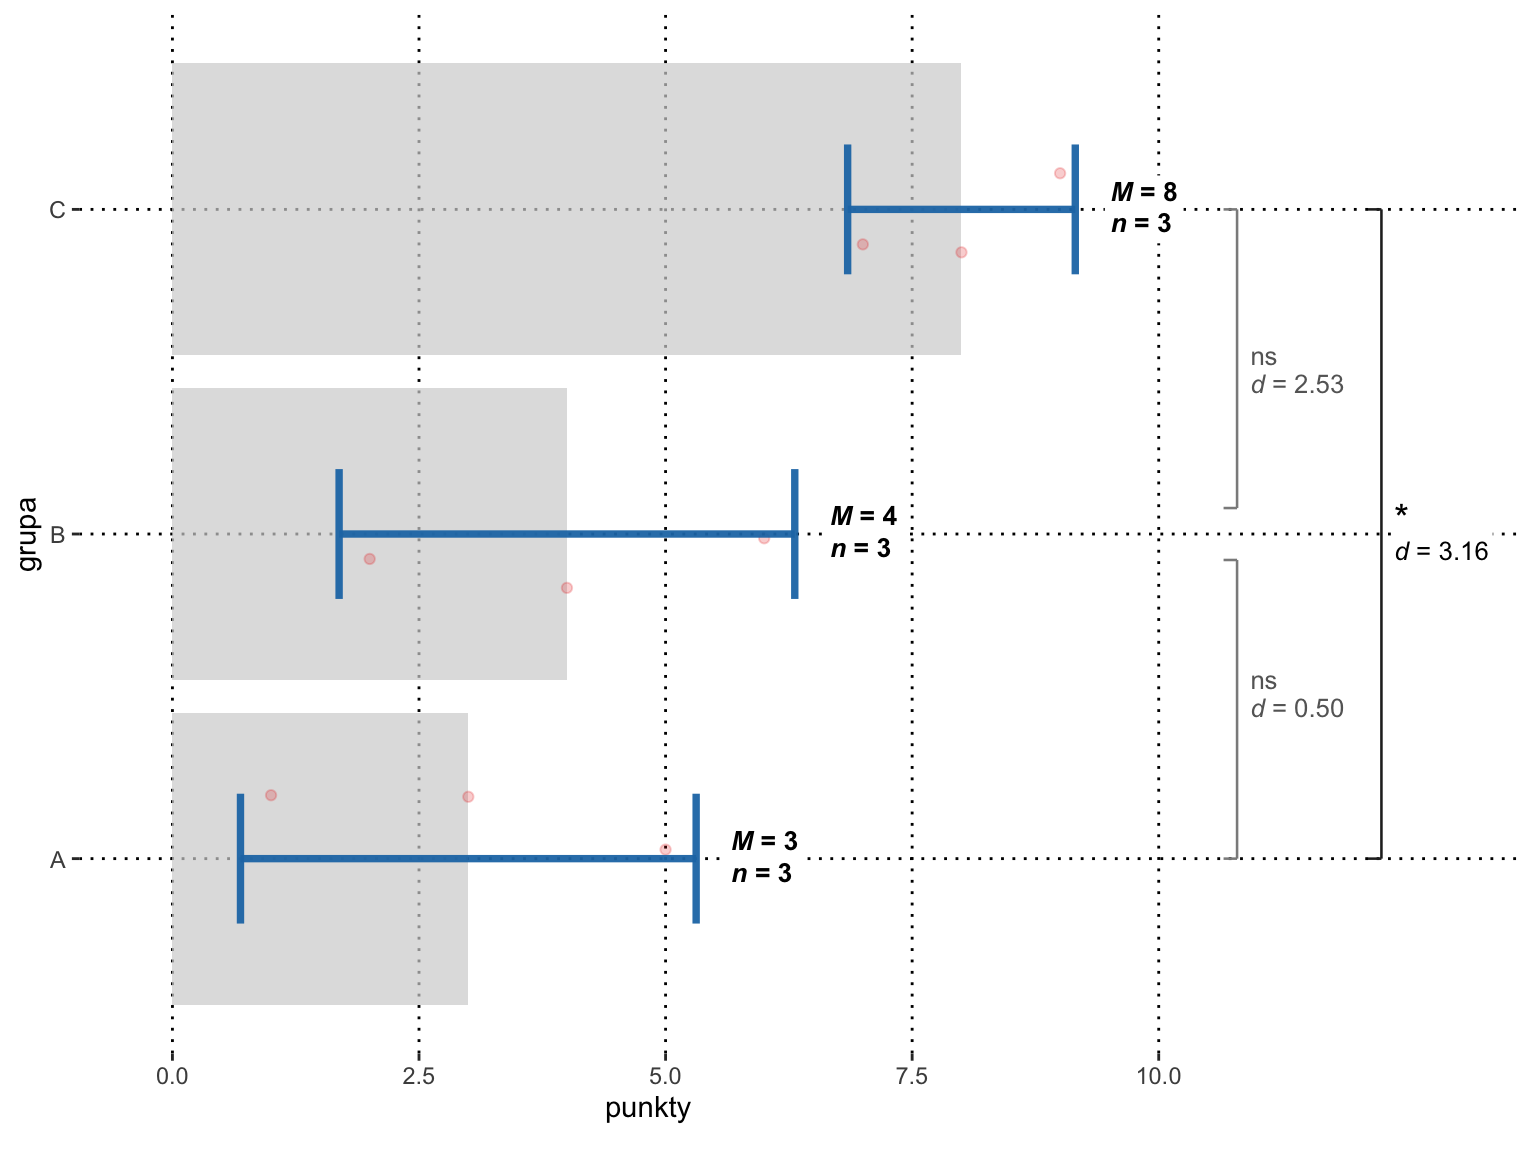
Trzy grupy ćwiczeniowe po 3 osoby napisały kolokwium. Punkty: A = 1, 3, 5; B = 2, 4, 6; C = 7, 8, 9. Średnia ogólna: (9 + 12 + 24) / 9 = 45 / 9 = 5.
| Grupa | Wyniki | Średnia M | M − 5 | 3 · (M − 5)² | Odchylenia x − M | Σ(x − M)² |
|---|---|---|---|---|---|---|
| A | 1, 3, 5 | 9 / 3 = 3 | −2 | 3 · 4 = 12 | −2, 0, 2 | 4 + 0 + 4 = 8 |
| B | 2, 4, 6 | 12 / 3 = 4 | −1 | 3 · 1 = 3 | −2, 0, 2 | 4 + 0 + 4 = 8 |
| C | 7, 8, 9 | 24 / 3 = 8 | 3 | 3 · 9 = 27 | −1, 0, 1 | 1 + 0 + 1 = 2 |
| Σ | 45 | – | – | SSB = 42 | – | SSW = 18 |
- Suma kwadratów między grupami. 12 + 3 + 27 = 42. Mówi, jak bardzo średnie grup (3, 4, 8) rozjeżdżają się wokół 5.
- Suma kwadratów wewnątrz grup. 8 + 8 + 2 = 18. Mówi, jak bardzo osoby różnią się w obrębie swojej grupy.
- Stopnie swobody. Licznik: k − 1 = 3 − 1 = 2. Mianownik: N − k = 9 − 3 = 6.
- Wariancje (średnie kwadraty). MSB = 42 / 2 = 21. MSW = 18 / 6 = 3.
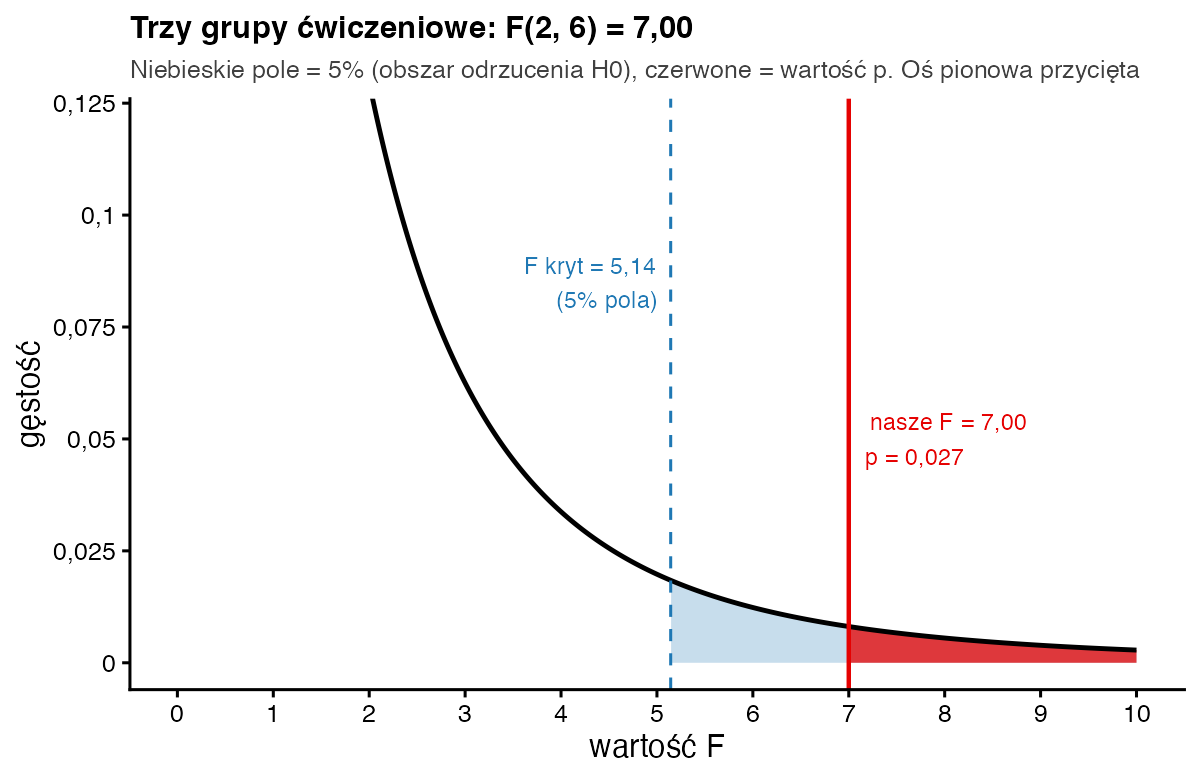
- Iloraz F. F = 21 / 3 = 7,00. Rozrzut między grupami jest 7 razy większy niż „szum”.
- Odczyt z tablic. W tablicy F dla α = 0,05 znajdź kolumnę df licznika = 2 i wiersz df mianownika = 6. Odczytasz 5,14 (w R:
qf(0.95, 2, 6)= 5,143). Nasze 7,00 > 5,14, więc p < 0,05. - Dokładna wartość p.
pf(7, 2, 6, lower.tail = FALSE)= 0,027. Wielkość efektu: η² = 42 / (42 + 18) = 42 / 60 = 0,70. - Dwie grupy: F = t². W przykładzie Notatki vs Quizy test t dał t(8) = 3,00. ANOVA na tych samych danych dałaby F(1, 8) = 3² = 9,00 i to samo p = 0,017. Również wartości krytyczne się zgadzają: 2,306² = 5,32 =
qf(0.95, 1, 8).
Prosty test F dla dwóch wariancji działa tak samo. Dla grup A i C wariancje wynoszą 8 / 2 = 4 oraz 2 / 2 = 1, więc F = 4 / 1 = 4 przy df (2, 2). Przy tak małych grupach to za mało, by mówić o różnicy (dwustronne p = 0,40).
Jak zinterpretować i opisać wynik?
Istotne F mówi tylko, że co najmniej jedna średnia różni się od pozostałych. Nie mówi, które grupy się różnią – do tego służą porównania post hoc, np. test Tukeya. Wartość p = 0,027 oznacza, że przy braku różnic w populacji F równe 7 lub większe pojawiałoby się w około 2,7% podobnych badań. Siłę efektu opisuje eta kwadrat. Pełny opis ANOVA znajdziesz w przykładowym raporcie analizy wariancji.
Zapis w stylu APA: Grupy ćwiczeniowe różniły się istotnie liczbą punktów z kolokwium, F(2, 6) = 7,00; p = 0,027; η² = 0,70. Wartość krytyczna dla α = 0,05 wynosiła Fkryt(2, 6) = 5,14.
Jak policzyć F i odczytać rozkład F w R?
punkty <- c(1, 3, 5,  2, 4, 6,  7, 8, 9)
grupa  <- factor(rep(c("A", "B", "C"), each = 3))

# 1) „ręcznie”: F = wariancja między grupami / wariancja wewnątrz grup
M  <- tapply(punkty, grupa, mean)                  # 3, 4, 8
SSb <- sum(3 * (M - mean(punkty))^2)               # 42
SSw <- sum((punkty - M[grupa])^2)                  # 18
F  <- (SSb / 2) / (SSw / 6); F                     # 21 / 3 = 7
pf(F, 2, 6, lower.tail = FALSE)                    # p
qf(0.95, 2, 6)                                     # F krytyczne

# 2) gotowa funkcja
summary(aov(punkty ~ grupa))

# 3) dwie grupy: F = t do kwadratu (Notatki vs Quizy)
qt(0.975, 8)^2; qf(0.95, 1, 8)
var.test(c(1, 3, 5), c(7, 8, 9))$statistic         # 4 / 1 = 4
Wynik w konsoli R:
> F
[1] 7
> pf(F, 2, 6, lower.tail = FALSE)
[1] 0.027
> qf(0.95, 2, 6)
[1] 5.143253
> summary(aov(punkty ~ grupa))
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        2     42      21       7  0.027 *
Residuals    6     18       3
> qt(0.975, 8)^2
[1] 5.317655
> qf(0.95, 1, 8)
[1] 5.317655
> var.test(c(1, 3, 5), c(7, 8, 9))$statistic
F
4
qf() zastępuje tablice (podajesz 1 − α oraz df licznika i mianownika), a pf(..., lower.tail = FALSE) zwraca wartość p. Kolejność df ma znaczenie: F(2, 6) to inny rozkład niż F(6, 2).
Najczęstsze błędy
- Zamiana kolejności stopni swobody – pierwsza liczba to zawsze df licznika (efektu), druga – mianownika (błędu).
- Odczyt z tablicy dla złego α albo z tablicy „dwustronnej” – w ANOVA F jest jednostronne.
- Wniosek „wszystkie grupy się różnią” z samego istotnego F, bez porównań post hoc.
- Pisanie „przyjęto H0”, gdy F jest małe. Poprawnie: brak podstaw do odrzucenia H0 – przy 3 osobach w grupie test ma bardzo małą moc.
- Używanie zwykłego testu F do porównania wariancji przy danych dalekich od normalnego – jest na to bardzo wrażliwy; bezpieczniejszy jest test Levene’a lub Browna-Forsythe’a.
Bibliografia
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Snedecor, G. W. (1934). Calculation and interpretation of analysis of variance and covariance. Collegiate Press.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówJednoczynnikowa ANOVA
- Słownik wzorówRozkład chi-kwadrat
- Słownik wzorówRozkład t Studenta i stopnie swobody
- Słownik wzorówTest Levene’a
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.