

Test Dunna – wzór i przykład krok po kroku
Test Dunna to porównania post hoc po teście Kruskala-Wallisa: sprawdza, które pary grup różnią się między sobą. Typowe pytanie z pracy dyplomowej: Kruskal-Wallis pokazał różnice między trzema grupami ćwiczeniowymi – ale między którymi dokładnie?
W prostych słowachNajpierw ustawiasz wyniki wszystkich osób w jednym szeregu i nadajesz im rangi, tak jak w teście Kruskala-Wallisa. Potem dla każdej pary grup sprawdzasz, jak daleko od siebie leżą ich średnie rangi. Tę odległość dzielisz przez jej typowy rozrzut i dostajesz wynik z. Na koniec poprawiasz wartości p, bo robisz kilka porównań naraz.
Kiedy stosować test Dunna?
- porównujesz trzy lub więcej grup różnych osób i użyłeś testu Kruskala-Wallisa;
- wynik Kruskala-Wallisa jest istotny i chcesz wiedzieć, które pary grup się różnią;
- zmienna jest porządkowa (np. ocena zajęć 1–5) albo rozkłady są skośne – czyli z tych samych powodów, dla których wybrałeś test rangowy zamiast ANOVA.
Po klasycznej ANOVA odpowiednikiem jest test Tukeya. Przy dwóch grupach nie potrzebujesz testu post hoc – wystarczy test U Manna-Whitneya. Jak poprawiać p przy wielu porównaniach, wyjaśniają hasła o poprawkach Holma i FDR oraz o poprawce Bonferroniego.
Wzór na statystykę z w teście Dunna
- \(\bar{R}_i,\ \bar{R}_j\)
- średnie rangi grup \(i\) oraz \(j\); rangi nadajesz wszystkim osobom razem, a nie osobno w każdej parze
- \(N\)
- liczba wszystkich osób we wszystkich grupach
- \(n_i,\ n_j\)
- liczba osób w porównywanych grupach
- \(\tfrac{N(N+1)}{12}\)
- wariancja rang od 1 do N; gdy są remisy, odejmuje się od niej małą poprawkę (programy robią to same)
- mianownik
- błąd standardowy różnicy średnich rang: typowa różnica, jaka wychodzi przypadkiem, gdy grupy się nie różnią
- \(\Phi\)
- dystrybuanta rozkładu normalnego; w R:
pnorm() - \(p_{ij}\)
- wartość p dla pary przed poprawką na wielokrotne porównania
Jak przeczytać ten wzór na głos: „z to różnica średnich rang dwóch grup podzielona przez jej błąd standardowy”. Potem p z każdej pary poprawiasz, np. metodą Holma: najmniejsze p mnożysz przez liczbę porównań, drugie – przez liczbę porównań minus jeden, i tak dalej.
Przykład krok po kroku
Trzy grupy ćwiczeniowe po 3 osoby napisały kolokwium. Punkty: A = 1, 3, 5; B = 2, 4, 6; C = 7, 8, 9. To ten sam zbiór, co w hasłach o ANOVA i teście Kruskala-Wallisa, gdzie wyszło H(2) = 5,60; p = 0,061.
| Para | Różnica średnich rang | SE | z = różnica / SE | p bez poprawki | p Holma | p Bonferroniego |
|---|---|---|---|---|---|---|
| B – A | 4 − 3 = 1 | 2,236 | 1 / 2,236 = 0,447 | 0,655 | 0,655 | 1,000 |
| C – A | 8 − 3 = 5 | 2,236 | 5 / 2,236 = 2,236 | 0,025 | 0,076 | 0,076 |
| C – B | 8 − 4 = 4 | 2,236 | 4 / 2,236 = 1,789 | 0,074 | 0,147 | 0,221 |
| Liczba porównań: 3 | 1 para < 0,05 | 0 par < 0,05 | 0 par < 0,05 | |||
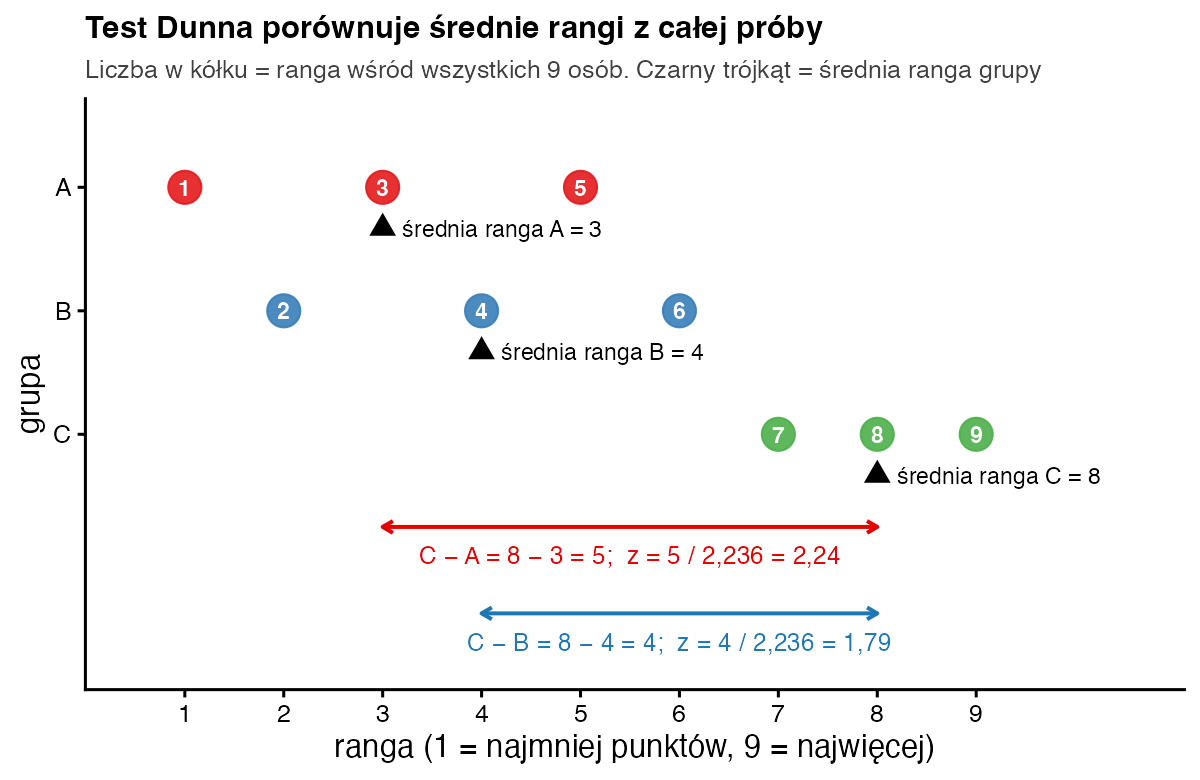
- Rangi. Ustawiasz wszystkie 9 wyników w jednym szeregu. Wyniki to liczby od 1 do 9 bez powtórzeń, więc ranga każdej osoby równa się jej wynikowi.
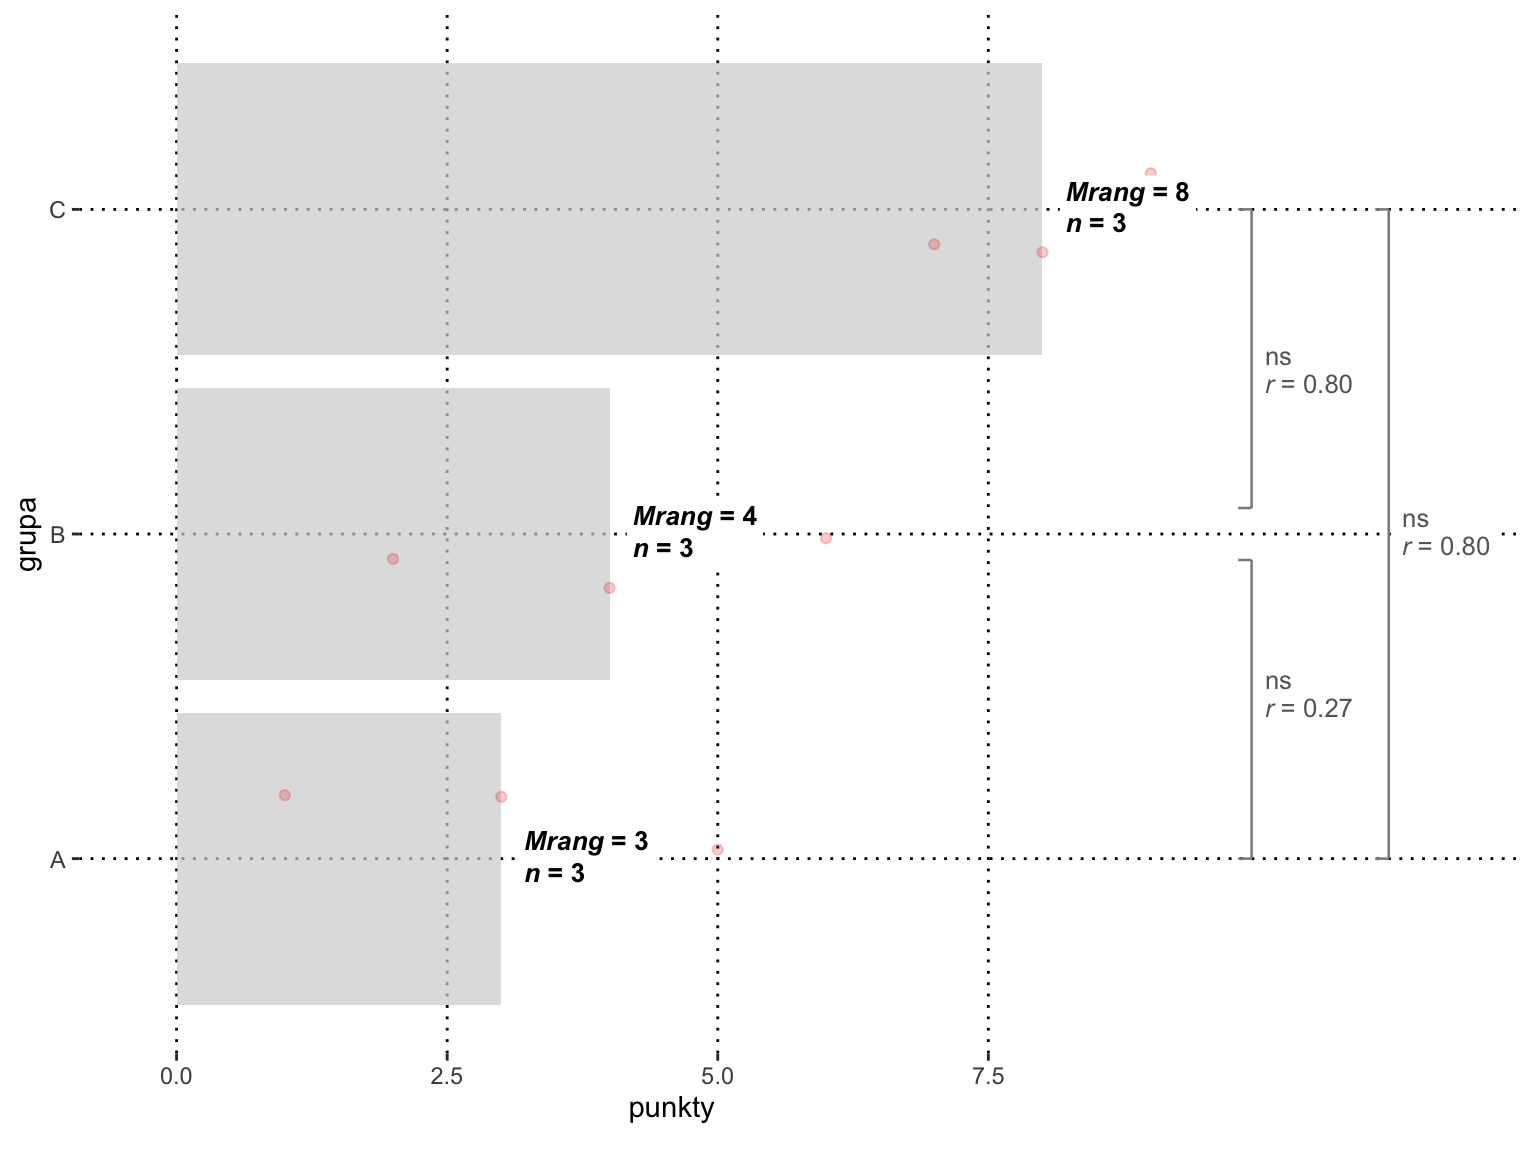
- Średnie rangi. A: (1 + 3 + 5) / 3 = 9 / 3 = 3. B: (2 + 4 + 6) / 3 = 12 / 3 = 4. C: (7 + 8 + 9) / 3 = 24 / 3 = 8. Kontrola: 9 + 12 + 24 = 45, czyli suma liczb od 1 do 9.
- Błąd standardowy. N(N + 1) / 12 = 9 · 10 / 12 = 90 / 12 = 7,5. Grupy mają po 3 osoby: 1/3 + 1/3 = 2/3. Iloczyn: 7,5 · 2/3 = 5. Pierwiastek: √5 = 2,236. Wszystkie grupy są równe, więc SE jest takie samo dla każdej pary.
- Statystyka z. Dzielisz różnice średnich rang przez 2,236: 1 / 2,236 = 0,447; 5 / 2,236 = 2,236; 4 / 2,236 = 1,789.
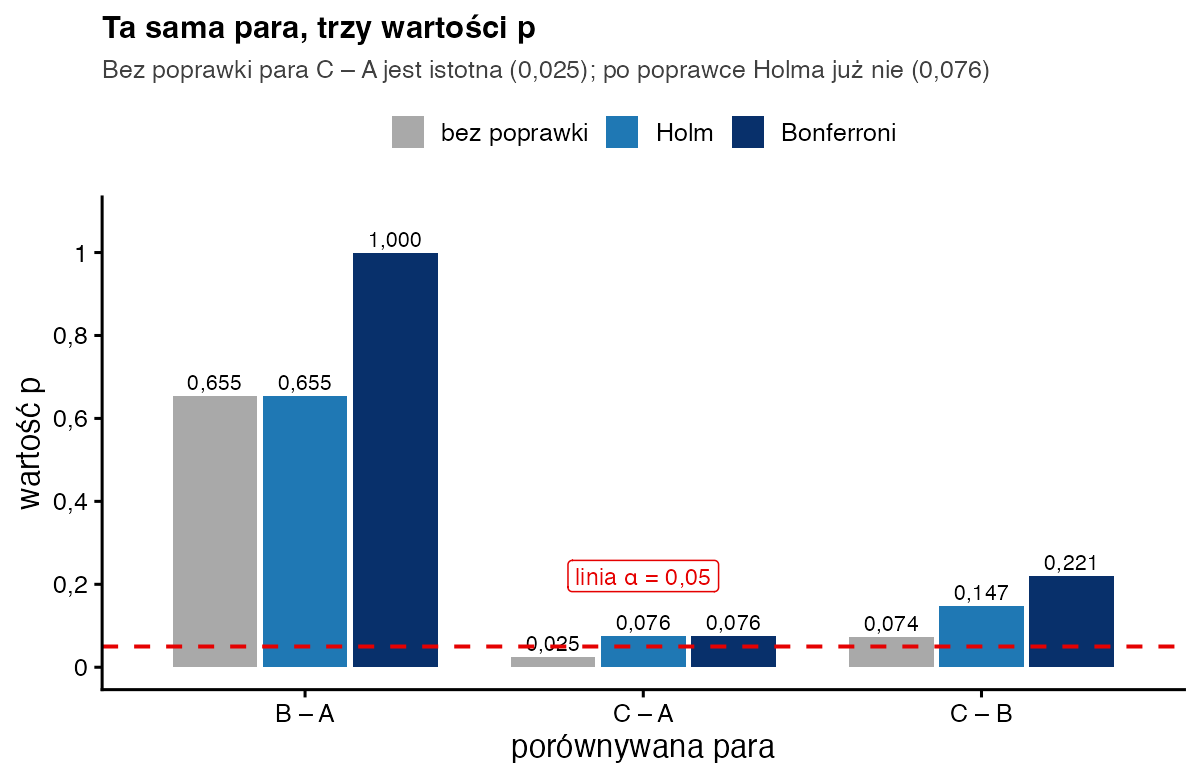
- Wartość p. Z tablic rozkładu normalnego: Φ(2,236) = 0,98732, więc p = 2 · (1 − 0,98732) = 2 · 0,01268 = 0,025 (w R:
2 * pnorm(-2.236), dokładnie 0,02535). Tak samo dla pozostałych par: 0,655 i 0,074. - Poprawka Holma. Ustawiasz p od najmniejszego: 0,02535 · 3 = 0,076; 0,07364 · 2 = 0,147; 0,65472 · 1 = 0,655. Żadne nie jest mniejsze niż 0,05.
- Poprawka Bonferroniego. Każde p mnożysz przez 3: 0,076; 0,221; a 0,65472 · 3 = 1,96 obcinasz do 1. Równoważnie: wartość krytyczna z rośnie z 1,96 do 2,394 (w R:
qnorm(1 - 0.05/6)), a nasze największe z = 2,236 jej nie przekracza.
Jak zinterpretować i opisać wynik?
W tym przykładzie test Kruskala-Wallisa nie był istotny (p = 0,061). Zwykle nie przechodzi się wtedy do testów post hoc. Pokazujemy je tylko po to, żeby było widać, jak działa poprawka. Wynik jest spójny: żadna para nie różni się istotnie po poprawce. Grupa C ma wyraźnie wyższe rangi, ale przy trzech osobach w grupie test rangowy ma za małą moc. Ta sama różnica w ANOVA z testem Tukeya była istotna (C – A: p = 0,028). Brak istotności nie oznacza więc, że grupy są takie same. W opisie podaj średnie rangi lub mediany, z, p po poprawce i nazwę poprawki.
Zapis w stylu APA: Test Kruskala-Wallisa nie wykazał istotnych różnic między grupami, H(2) = 5,60; p = 0,061. W porównaniach post hoc testem Dunna z poprawką Holma żadna para grup nie różniła się istotnie. Największą różnicę uzyskano między grupami C i A (Mrang = 8 i 3), z = 2,24; pHolm = 0,076.
Jak policzyć test Dunna w R?
# Trzy grupy ćwiczeniowe (punkty z kolokwium)
dane <- data.frame(grupa  = rep(c("A", "B", "C"), each = 3),
                   punkty = c(1, 3, 5,  2, 4, 6,  7, 8, 9))

# 1) „ręcznie”: rangi z całej próby, średnie rangi, z dla każdej pary
dane$ranga <- rank(dane$punkty)
R <- tapply(dane$ranga, dane$grupa, mean)       # A = 3, B = 4, C = 8
N <- nrow(dane); n <- 3
SE <- sqrt(N * (N + 1) / 12 * (1/n + 1/n))      # sqrt(5) = 2,236
z <- c(AB = R[["B"]] - R[["A"]], AC = R[["C"]] - R[["A"]],
       BC = R[["C"]] - R[["B"]]) / SE
p <- 2 * pnorm(-abs(z))
round(cbind(z, p, p_holm = p.adjust(p, "holm"),
            p_bonf = p.adjust(p, "bonferroni")), 3)

# 2) gotowe funkcje
kruskal.test(punkty ~ grupa, data = dane)
rstatix::dunn_test(dane, punkty ~ grupa, p.adjust.method = "holm")[, c(2, 3, 6:8)]
Wynik w konsoli R:
       z     p p_holm p_bonf
AB 0.447 0.655  0.655  1.000
AC 2.236 0.025  0.076  0.076
BC 1.789 0.074  0.147  0.221

	Kruskal-Wallis rank sum test

data:  punkty by grupa
Kruskal-Wallis chi-squared = 5.6, df = 2, p-value = 0.06081

# A tibble: 3 × 5
  group1 group2 statistic      p  p.adj
  <chr>  <chr>      <dbl>  <dbl>  <dbl>
1 A      B          0.447 0.655  0.655
2 A      C          2.24  0.0253 0.0760
3 B      C          1.79  0.0736 0.147
Rachunek ręczny i rstatix::dunn_test dają te same z i te same p po poprawce Holma. Ten sam wynik zwraca też PMCMRplus::kwAllPairsDunnTest.
Test Dunna czy seria testów U Manna-Whitneya?
Seria testów U porównuje każdą parę osobno i za każdym razem nadaje rangi od nowa, tylko w tej parze. Test Dunna korzysta z rang nadanych całej próbie, czyli z tych samych, które wykorzystał test Kruskala-Wallisa (Dunn, 1964). Dzięki temu porównania post hoc pasują do testu ogólnego. W obu podejściach i tak musisz poprawić p na wielokrotne porównania. Dinno (2015) opisuje, jak łączyć test Dunna z różnymi poprawkami, m.in. Holma i Benjaminiego-Hochberga. Poprawka Holma zawsze daje p nie większe niż Bonferroni, a równie dobrze chroni przed błędem I rodzaju, dlatego jest dobrym wyborem domyślnym.
Najczęstsze błędy
- Podawanie p bez poprawki na wielokrotne porównania albo nienapisanie, której poprawki użyto.
- Nadawanie rang osobno w każdej parze – to już nie jest test Dunna.
- Szukanie „istotnych par” po nieistotnym teście Kruskala-Wallisa i opisywanie ich jako odkrycia.
- Opisywanie wyniku jako różnicy median – test porównuje rangi, a nie mediany.
- Pisanie „grupy są takie same”, gdy p > 0,05 – poprawnie: nie wykazano istotnej różnicy.
Bibliografia
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Dinno, A. (2015). Nonparametric pairwise multiple comparisons in independent groups using Dunn’s test. The Stata Journal, 15(1), 292–300.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Kruskala-Wallisa
- Słownik wzorówPoprawki Holma i FDR
- Słownik wzorówPoprawka Bonferroniego
- Słownik wzorówWielkość efektu r w testach nieparametrycznych
- PoradnikANOVA – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza wariancji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.