

Jak sprawdzić normalność rozkładu – Q-Q, Shapiro-Wilk i co napisać w pracy
Ten wpis pokazuje na jednym małym zbiorze (12 wyników), jak sprawdzić założenie o rozkładzie normalnym czterema sposobami: histogramem, wykresem kwantyl-kwantyl, skośnością i kurtozą oraz testami Shapiro-Wilka i Kołmogorowa-Smirnowa z poprawką Lillieforsa. Typowe pytanie promotora: „Czy sprawdził Pan założenie normalności przed testem t?”.
W skrócieNormalność sprawdzasz nie dla „całej zmiennej”, tylko dla reszt modelu albo osobno w każdej grupie. Patrzysz na wykresy, liczysz skośność i kurtozę, a test Shapiro-Wilka traktujesz jako uzupełnienie, bo przy małej próbie ma małą moc, a przy dużej wykrywa nawet nieistotne odchylenia. Wzory znajdziesz w słowniku, tu skupiamy się na tym, jak to zrobić i opisać.
Krok 1. Dane i to, co naprawdę sprawdzamy
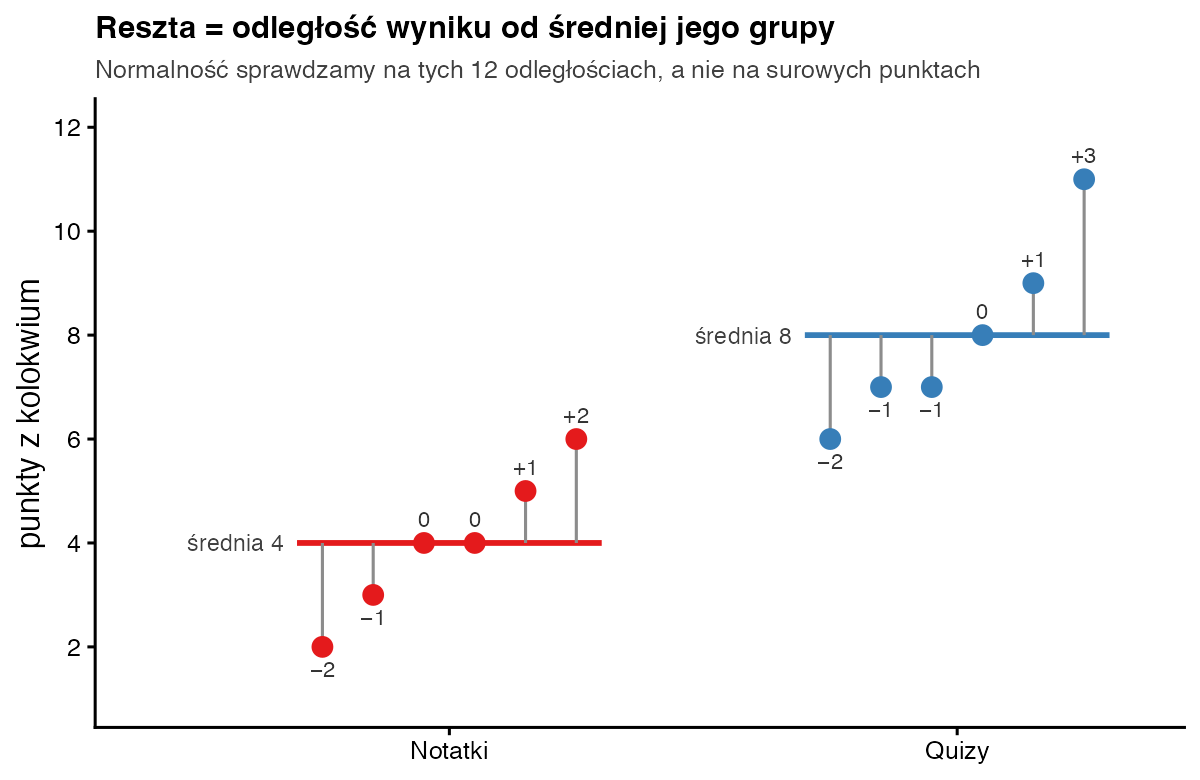
Dwunastu studentów podzielono na dwie grupy po 6 osób. Grupa „Notatki” powtarzała materiał z notatek, grupa „Quizy” rozwiązywała quizy. Chcemy porównać punkty z kolokwium testem t. Test t zakłada, że w każdej grupie wyniki pochodzą z rozkładu zbliżonego do normalnego. Inaczej mówiąc: normalne mają być reszty, czyli odległości każdego wyniku od średniej jego grupy.
| Grupa | Punkty 6 osób | Średnia grupy | Reszty |
|---|---|---|---|
| Notatki | 2, 3, 4, 4, 5, 6 | 4 | −2, −1, 0, 0, 1, 2 |
| Quizy | 6, 7, 7, 8, 9, 11 | 8 | −2, −1, −1, 0, 1, 3 |
Gdybyś wrzucił do jednego worka wszystkie 12 surowych wyników, mieszałbyś dwa rozkłady o różnych średnich. Przy dużej różnicy między grupami taki „worek” może wyglądać na dwugarbny, choć w każdej grupie wszystko jest w porządku. Bywa też odwrotnie: „worek” wygląda dobrze, a jedna z grup ma długi ogon. Dlatego w regresji i ANOVA sprawdza się reszty modelu, a przy dwóch grupach – każdą grupę osobno. Rysunek 1 pokazuje, czym są reszty w naszym przykładzie.
Krok 2. Histogram
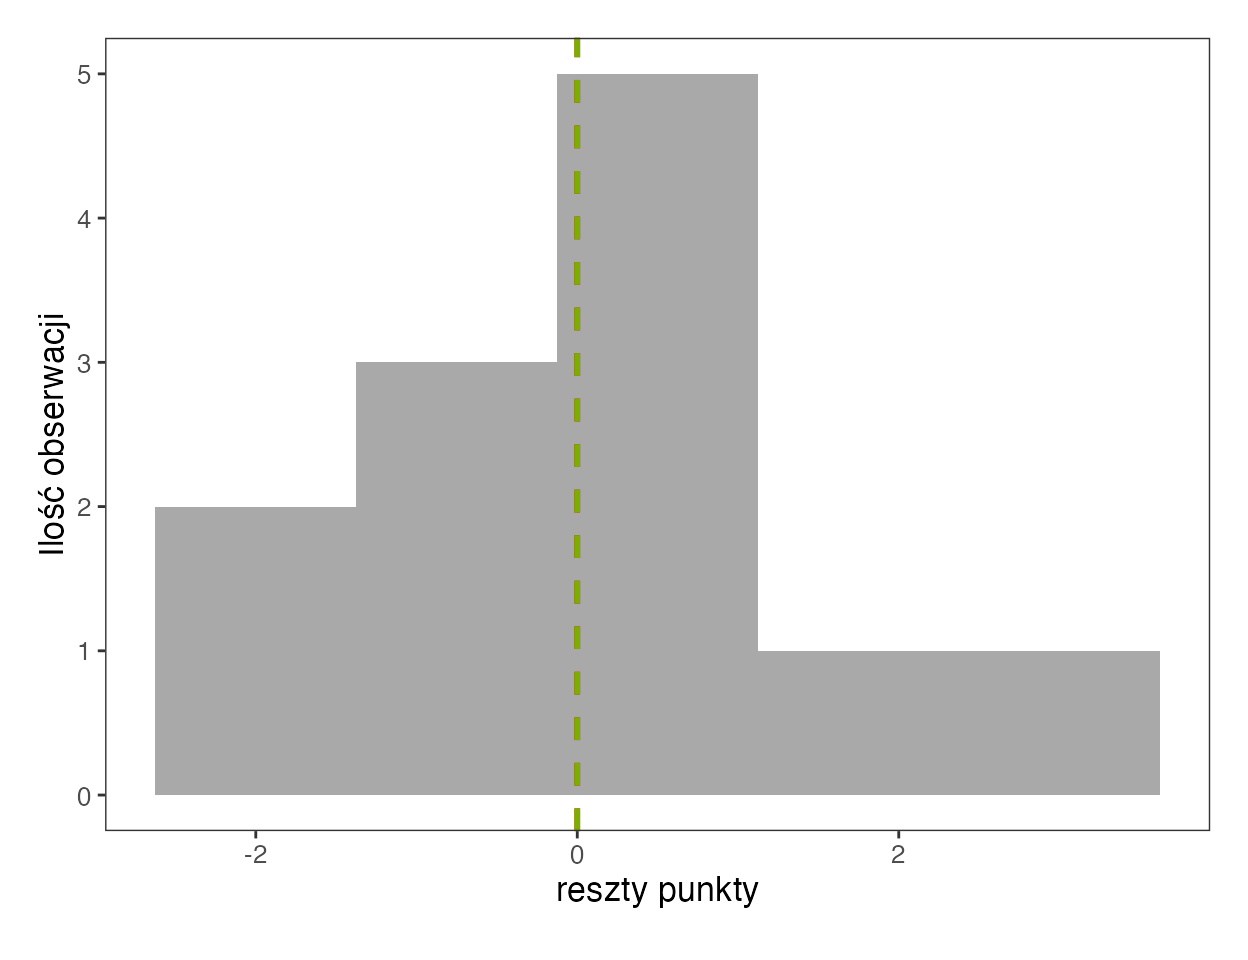
Histogram to pierwsze spojrzenie: czy rozkład ma jeden szczyt, czy jest mniej więcej symetryczny i czy nie ma pojedynczych wyników daleko od reszty. Przy 12 obserwacjach słupków jest mało, więc histogram jest „kanciasty” i nie oczekuj idealnego dzwonu. U nas średnia i mediana reszt wynoszą 0, najwięcej wyników leży blisko zera, a prawy ogon jest odrobinę dłuższy (jedna osoba ma +3).
Krok 3. Wykres kwantyl-kwantyl
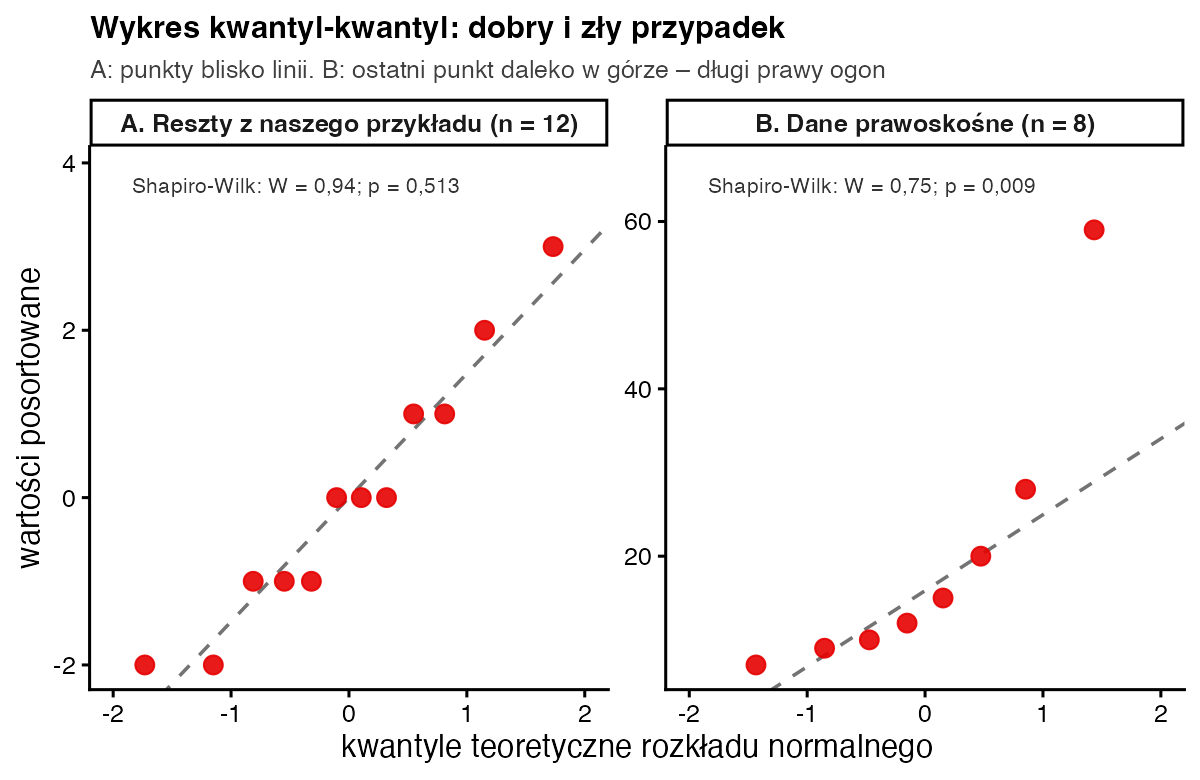
Na wykresie kwantyl-kwantyl każdy punkt to jedna obserwacja. Na osi poziomej jest wartość, jakiej spodziewalibyśmy się w rozkładzie normalnym, a na pionowej – wartość z danych. Jeśli rozkład jest zbliżony do normalnego, punkty układają się wzdłuż linii. To najlepsze pojedyncze narzędzie do oceny normalności, bo pokazuje też, gdzie jest problem: w ogonach, w środku czy w jednym skrajnym wyniku.
Krok 4. Skośność i kurtoza
Skośność reszt wynosi 0,54, a kurtoza −0,25 (wzory takie jak w SPSS). W rozkładzie normalnym obie są równe 0. Przy małych próbach można podzielić każdą z nich przez jej błąd standardowy. Kim (2013) proponuje, by przy próbach poniżej 50 osób za wyraźne odchylenie uznawać wartość bezwzględną tego ilorazu powyżej 1,96. Błędy standardowe wynoszą u nas 0,64 i 1,23, a ilorazy (liczone z niezaokrąglonych wartości) z = 0,85 dla skośności i z = −0,21 dla kurtozy, więc nic nie budzi niepokoju. Przy dużych próbach stosuje się progi „surowe”: skośność powyżej 2 lub kurtoza powyżej 7 co do wartości bezwzględnej oznaczają poważne odchylenie (West i in., 1995).
Krok 5. Testy Shapiro-Wilka i Kołmogorowa-Smirnowa
- Hipotezy. H0: reszty pochodzą z rozkładu normalnego. H1: nie pochodzą. Uwaga na odwrotną logikę: tutaj „dobry” wynik to p > 0,05.
- Test Shapiro-Wilka: W = 0,94; p = 0,513. Brak podstaw do odrzucenia H0.
- Test Kołmogorowa-Smirnowa z poprawką Lillieforsa: D = 0,17; p = 0,472. Wniosek ten sam. Zwykłego testu K-S bez poprawki nie używaj, gdy średnią i odchylenie liczysz z tych samych danych, bo daje zawyżone p.
- Dla porównania – każda grupa osobno: Notatki W = 0,98; p = 0,960, Quizy W = 0,93; p = 0,607. Gdybyś (niepoprawnie) zbadał wszystkie surowe punkty razem, dostałbyś W = 0,98; p = 0,989 – tu przypadkiem też „w porządku”, ale z innego powodu.
- Decyzja: wykresy, skośność, kurtoza i testy mówią to samo, więc test t jest uzasadniony. Shapiro-Wilk ma zwykle większą moc niż K-S (Razali i Wah, 2011), dlatego to jego wynik podaj w pracy.
| Sposób | Wynik | Co oznacza |
|---|---|---|
| Histogram | jeden szczyt, średnia = mediana = 0 | brak wyraźnej asymetrii |
| Wykres Q-Q | punkty blisko linii | brak odstających ogonów |
| Skośność (z) | 0,54 (0,85) | |z| < 1,96 |
| Kurtoza (z) | −0,25 (−0,21) | |z| < 1,96 |
| Shapiro-Wilk | W = 0,94; p = 0,513 | brak podstaw do odrzucenia H0 |
| K-S (Lilliefors) | D = 0,17; p = 0,472 | brak podstaw do odrzucenia H0 |
Krok 6. Co napisać w pracy?
Zapis w stylu APA: Założenie o normalności rozkładu sprawdzono na resztach modelu (n = 12) za pomocą wykresu kwantyl-kwantyl, współczynników skośności i kurtozy oraz testu Shapiro-Wilka. Punkty na wykresie leżały blisko linii, skośność wyniosła 0,54, a kurtoza −0,25. Test Shapiro-Wilka nie wykazał istotnego odchylenia od rozkładu normalnego, W = 0,94; p = 0,513.
W metodzie wystarczy jedno takie zdanie, a wykres Q-Q możesz przenieść do aneksu. Nie pisz „rozkład jest normalny” – nieistotny wynik testu oznacza tylko brak podstaw do odrzucenia H0. Jak wygląda pełna eksploracja w raporcie, zobaczysz w przykładowym raporcie eksploracji danych, a dalszy ciąg tej analizy – we wpisie test t Studenta – przykład.
Cała analiza w R
# Punkty z kolokwium (0–12): 12 studentów w dwóch grupach po 6 osób
notatki <- c(2, 3, 4, 4, 5, 6)
quizy   <- c(6, 7, 7, 8, 9, 11)
punkty  <- c(notatki, quizy)
grupa   <- factor(rep(c("Notatki", "Quizy"), each = 6))

# Reszty = wynik minus średnia własnej grupy (tak samo liczy je model)
model  <- lm(punkty ~ grupa)
reszty <- residuals(model)
round(reszty, 2)

# 1) ocena wzrokowa: histogram i wykres kwantyl-kwantyl
hist(reszty, main = "Reszty", xlab = "punkty")
qqnorm(reszty); qqline(reszty, lty = 2)

# 2) skośność i kurtoza (wzory jak w SPSS)
sk <- e1071::skewness(reszty, type = 2); ku <- e1071::kurtosis(reszty, type = 2)
n  <- length(reszty)
se_sk <- sqrt(6 * n * (n - 1) / ((n - 2) * (n + 1) * (n + 3)))
se_ku <- 2 * se_sk * sqrt((n^2 - 1) / ((n - 3) * (n + 5)))
round(c(skosnosc = sk, z_sk = sk / se_sk, kurtoza = ku, z_ku = ku / se_ku), 2)

# 3) testy normalności reszt
shapiro.test(reszty)
nortest::lillie.test(reszty)

# 4) dla porównania: każda grupa osobno (p Shapiro-Wilka)
sapply(split(punkty, grupa), function(x) round(shapiro.test(x)$p.value, 3))
Wynik w konsoli R:
 1  2  3  4  5  6  7  8  9 10 11 12
-2 -1  0  0  1  2 -2 -1 -1  0  1  3
skosnosc     z_sk  kurtoza     z_ku
    0.54     0.85    -0.25    -0.21

	Shapiro-Wilk normality test

data:  reszty
W = 0.94115, p-value = 0.513


	Lilliefors (Kolmogorov-Smirnov) normality test

data:  reszty
D = 0.16667, p-value = 0.4724

Notatki   Quizy
  0.960   0.607
Checklista przed oddaniem rozdziału
- Normalność sprawdzona na resztach albo w każdej grupie osobno, nie na całej zmiennej.
- Jest wykres (Q-Q lub histogram), a nie tylko p testu.
- Podana skośność i kurtoza; przy małej próbie także ich wartości z.
- Wynik testu Shapiro-Wilka zapisany jako W i p, bez słów „rozkład jest normalny”.
- Wiesz, co zrobisz, jeśli założenie nie jest spełnione – opisaliśmy to we wpisie brak normalności rozkładu – co robić?
Pytania, które studenci wpisują w Google
Shapiro-Wilk czy Kołmogorow-Smirnow – który test wybrać?
Shapiro-Wilka. Przy tej samej liczbie osób częściej wykrywa odchylenia od normalności. Test K-S podawaj tylko w wersji z poprawką Lillieforsa i najlepiej jako uzupełnienie.
Mam 300 osób i Shapiro-Wilk zawsze wychodzi istotny. Co teraz?
Przy dużej próbie test wykrywa nawet drobne odchylenia, które nie szkodzą testowi t (Ghasemi i Zahediasl, 2012). Wtedy decyduj na podstawie wykresu Q-Q i skośności. Przy kilkudziesięciu osobach w grupie średnie mają rozkład zbliżony do normalnego dzięki centralnemu twierdzeniu granicznemu, o ile nie ma skrajnych wyników.
Czy sprawdzać normalność w korelacji i regresji?
W regresji – tak, na resztach modelu. Krok po kroku pokazujemy to we wpisie diagnostyka regresji na wykresach.
Bibliografia
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52
- West, S. G., Finch, J. F., & Curran, P. J. (1995). Structural equation models with nonnormal variables: Problems and remedies. W R. H. Hoyle (Red.), Structural equation modeling: Concepts, issues, and applications (s. 56–75). Sage.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówWykres Q-Q
- Słownik wzorówTest Shapiro-Wilka
- Słownik wzorówTest Kołmogorowa-Smirnowa (Lilliefors)
- PoradnikBrak normalności rozkładu – co robić?
- PoradnikTesty parametryczne
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.