

Opis wyników w stylu APA 7 – gotowe zdania i tabele
Styl APA 7 to zestaw zasad, jak zapisywać statystyki, tabele i rysunki w pracy naukowej. Typowe pytanie z pracy dyplomowej: jak poprawnie zapisać wynik testu t, ANOVA czy korelacji, żeby promotor nie odesłał rozdziału do poprawki?
W prostych słowachKażdy wynik opisujesz według tego samego schematu: co porównano, w którą stronę wyszła różnica lub związek, potem nazwa statystyki, stopnie swobody, wartość, dokładne p i wielkość efektu. Symbole łacińskie piszesz kursywą, liczby z przecinkiem dziesiętnym. Tabela pokazuje szczegóły, a zdanie mówi, co z nich wynika.
Zasady zapisu statystyk w APA 7
- Kursywa dla symboli łacińskich: M, SD, n, N, t, F, p, r, d, b, R². Litery greckie (χ², η², φ, α, β) piszesz prosto.
- Stopnie swobody w nawiasie zaraz po symbolu: t(8), F(2, 6), χ²(1, N = 40).
- Dokładne p do dwóch lub trzech miejsc po przecinku, także dla wyników nieistotnych. Gdy p jest mniejsze niż 0,001, piszesz p < 0,001, nigdy „p = 0,000”.
- Zaokrąglenie: większość statystyk podajesz z dwoma miejscami po przecinku.
- Wielkość efektu i przedział ufności przy każdym teście, np. d, η², φ, 95% CI [dolna; górna]. Jak je liczyć i interpretować, opisuje wpis wielkość efektu – jak liczyć i raportować.
- Zero przed przecinkiem: APA pomija je przy wartościach, które nie mogą przekroczyć 1 (p, r, η²). W polskich pracach częściej spotkasz zapis p = 0,017, bo „,017” łatwo przeoczyć. Ważne, żeby zapis był jednolity w całej pracy i zgodny z wytycznymi uczelni.
- Polski przecinek dziesiętny i średnik: skoro przecinek oddziela część dziesiętną, kolejne statystyki i granice przedziału oddzielasz średnikiem.
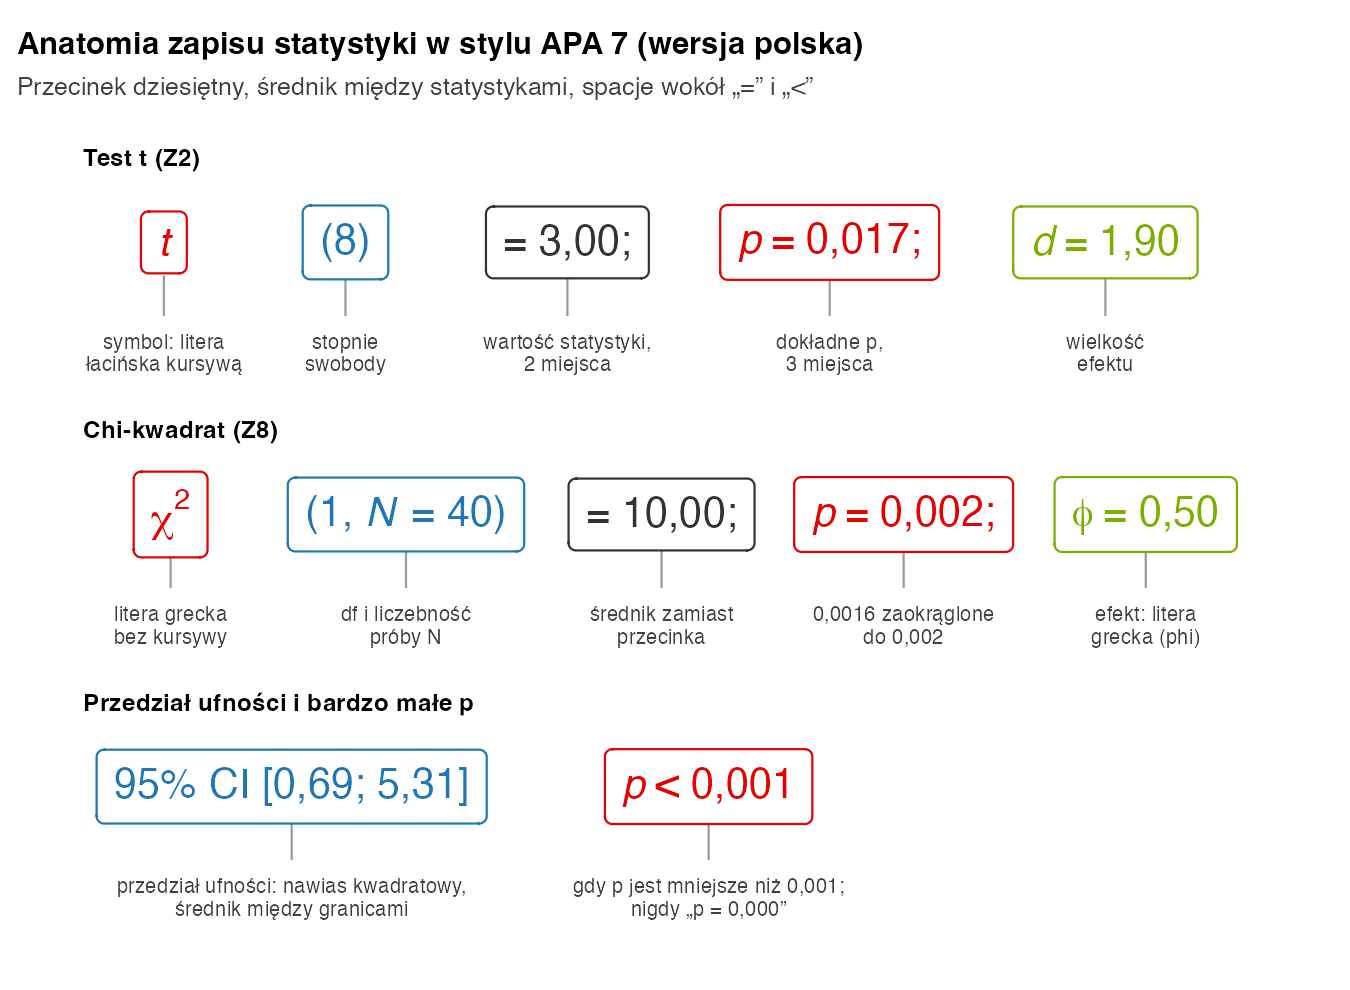
Poniżej gotowe zdania na prostych danych z naszego słownika wzorów. Liczby są takie same jak w hasłach, więc każdy wynik możesz przeliczyć krok po kroku.
Test t – zdanie i tabela
Dane Z2: punkty z kolokwium 5 osób uczących się z notatek i 5 osób uczących się z quizów. Rachunek pokazujemy w haśle test t dla prób niezależnych.
Zapis w stylu APA: Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali istotnie więcej punktów niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; d = 1,90. Różnica wyniosła 3 punkty, 95% CI [0,69; 5,31].
| Metoda nauki | n | M | SD | t(8) | p | d |
|---|---|---|---|---|---|---|
| Notatki | 5 | 3,00 | 1,58 | 3,00 | 0,017 | 1,90 |
| Quizy | 5 | 6,00 | 1,58 |
ANOVA – zdanie i tabela
Dane Z6: trzy grupy ćwiczeniowe po 3 osoby. Wzory znajdziesz w haśle jednoczynnikowa ANOVA.
Zapis w stylu APA: Grupy ćwiczeniowe różniły się istotnie liczbą punktów z kolokwium, F(2, 6) = 7,00; p = 0,027; η² = 0,70. Test post hoc Tukeya wykazał, że grupa C uzyskała więcej punktów niż grupa A (p = 0,028). Pozostałe pary nie różniły się istotnie (C–B: p = 0,067; B–A: p = 0,768).
| Grupa | n | M | SD |
|---|---|---|---|
| A | 3 | 3,00 | 2,00 |
| B | 3 | 4,00 | 2,00 |
| C | 3 | 8,00 | 1,00 |
| Nota. F(2, 6) = 7,00; p = 0,027; η² = 0,70. Test Tukeya: C > A, p = 0,028. | |||
Chi-kwadrat – zdanie i tabela
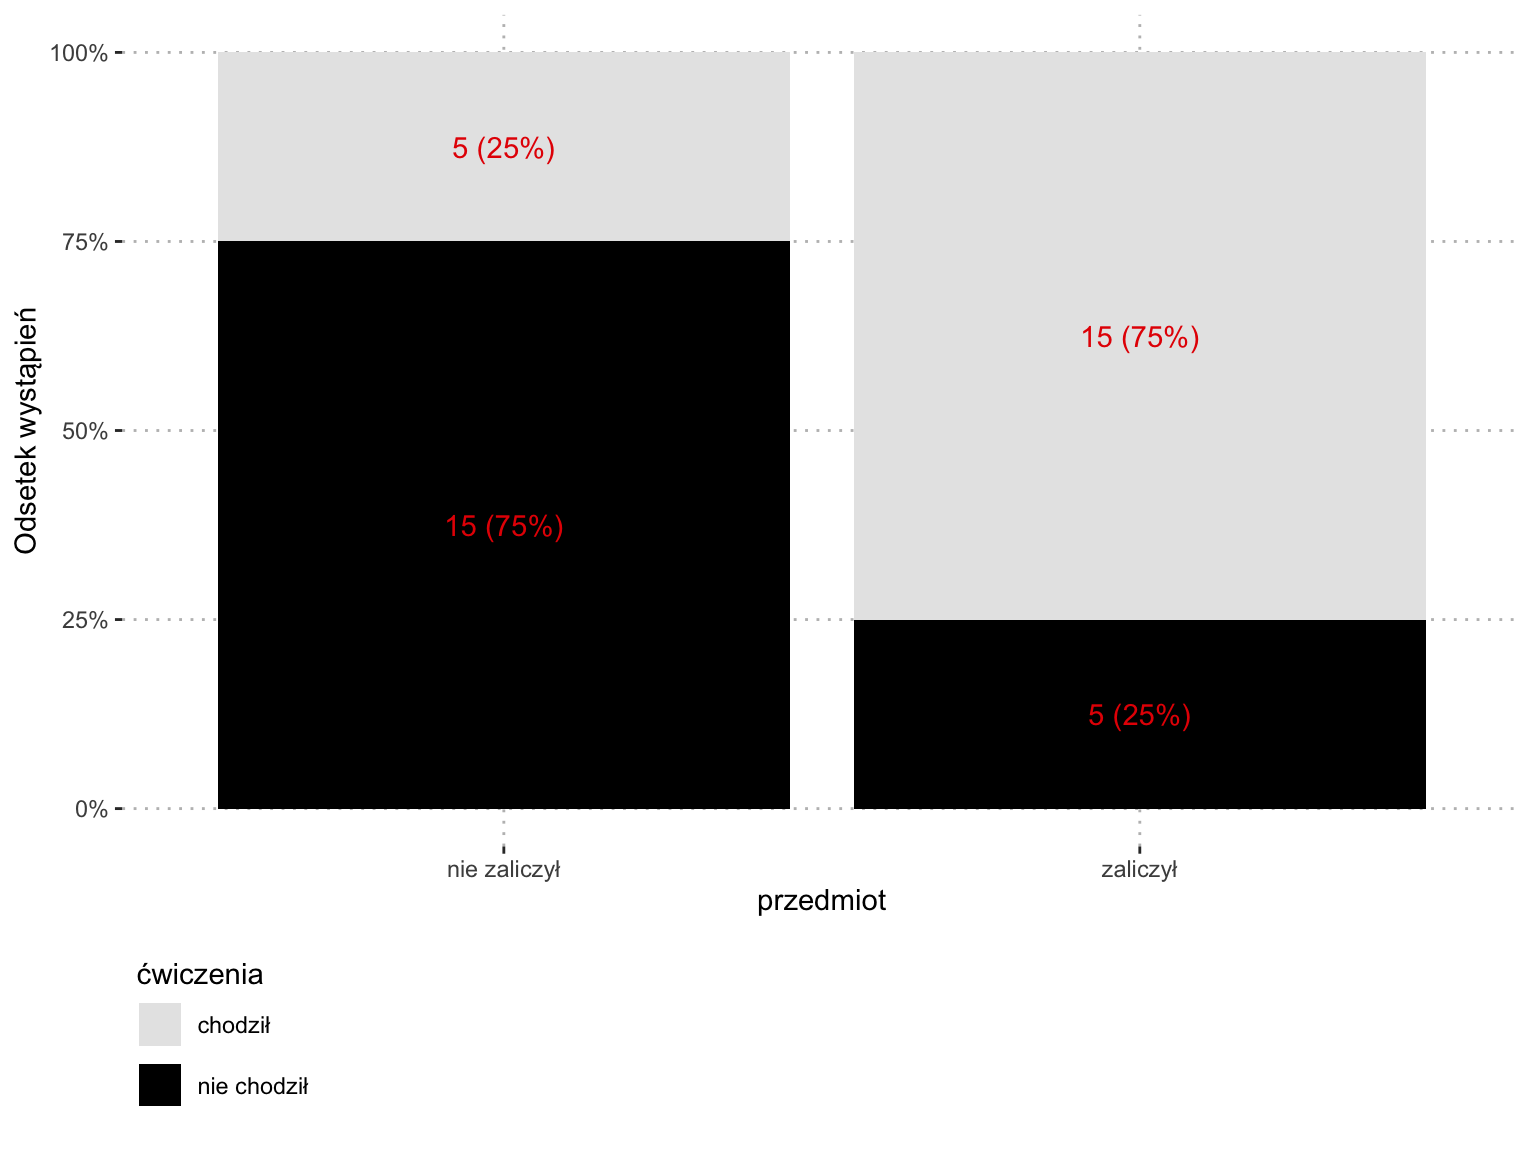
Dane Z8: 40 studentów, z czego połowa chodziła na ćwiczenia. Rachunek: test chi-kwadrat.
Zapis w stylu APA: Zaliczenie przedmiotu było istotnie związane z chodzeniem na ćwiczenia, χ²(1, N = 40) = 10,00; p = 0,002; φ = 0,50. Przedmiot zaliczyło 75% osób chodzących na ćwiczenia i 25% osób niechodzących.
| Ćwiczenia | Zaliczył | Nie zaliczył | Razem |
|---|---|---|---|
| Chodził | 15 (75) | 5 (25) | 20 |
| Nie chodził | 5 (25) | 15 (75) | 20 |
| Razem | 20 | 20 | 40 |
Korelacja i regresja – zdania i tabela
Dane Z4: godziny nauki i punkty 5 studentów. Szczegóły w hasłach korelacja Pearsona i regresja liniowa.
Korelacja: Liczba godzin nauki była dodatnio skorelowana z liczbą punktów z kolokwium, r(3) = 0,80; 95% CI [−0,28; 0,99]; p = 0,104. Przy tak małej próbie związek nie okazał się istotny statystycznie.
Regresja: Liczba godzin nauki wyjaśniała 64% zmienności punktów z kolokwium, R² = 0,64; F(1, 3) = 5,33; p = 0,104. Każda dodatkowa godzina wiązała się ze średnio o 1,6 punktu wyższym wynikiem, b = 1,60; 95% CI [−0,60; 3,80]; t(3) = 2,31; p = 0,104, jednak efekt nie był istotny statystycznie.
| Predyktor | b | SE | 95% CI | β | t(3) | p |
|---|---|---|---|---|---|---|
| Stała | 1,20 | 2,30 | [−6,11; 8,51] | – | 0,52 | 0,638 |
| Godziny nauki | 1,60 | 0,69 | [−0,60; 3,80] | 0,80 | 2,31 | 0,104 |
| Nota. R² = 0,64; F(1, 3) = 5,33; p = 0,104; N = 5. | ||||||
Brak istotności nie oznacza, że związku nie ma, a istotna korelacja nie dowodzi, że jedna zmienna wpływa na drugą. Przy nieistotnym wyniku pisz „brak podstaw do odrzucenia hipotezy zerowej”, a nie „przyjęto H0”. Jak to ująć w rozdziale, pokazujemy we wpisie hipotezy się nie potwierdziły.
Tabele i rysunki w APA 7 – krótko
Tabela ma numer (pogrubiony), pod nim tytuł kursywą, tylko poziome linie i notę pod spodem. Rysunek ma ten sam układ: numer, tytuł nad grafiką, nota pod nią (American Psychological Association, 2020). W tekście nie przepisuj całej tabeli. Wskaż najważniejszy wynik i odeślij do niej. Tabelę z opisem próby pokazujemy we wpisie opis próby badawczej – Tabela 1, a kolejność opisu ankiety – w poradniku jak opisać wyniki ankiety.
Jak wygenerować zdania APA w R?
Dwie małe funkcje zamieniają kropkę na przecinek i formatują p. Dzięki temu liczby w zdaniach zawsze zgadzają się z wynikiem testu.
# Zdania w stylu APA 7 generowane w R (przecinek dziesiętny, dokładne p)
f  <- function(x, d = 2) sub("^-", "−", formatC(x, format = "f", digits = d, decimal.mark = ","))
fp <- function(p) if (p < 0.001) "p < 0,001" else paste0("p = ", f(p, 3))
ci <- function(a, b) paste0("95% CI [", f(a), "; ", f(b), "]")

# 1) Test t (Z2): Notatki vs Quizy
notatki <- c(1, 2, 3, 4, 5); quizy <- c(4, 5, 6, 7, 8)
tt <- t.test(quizy, notatki, var.equal = TRUE)
d  <- effectsize::cohens_d(quizy, notatki)$Cohens_d
cat("t(", tt$parameter, ") = ", f(tt$statistic), "; ", fp(tt$p.value), "; d = ", f(d),
    "; ", ci(tt$conf.int[1], tt$conf.int[2]), "\n", sep = "")

# 2) ANOVA (Z6) i eta kwadrat
punkty <- c(1, 3, 5, 2, 4, 6, 7, 8, 9); grupa <- factor(rep(c("A", "B", "C"), each = 3))
m6 <- aov(punkty ~ grupa); a <- summary(m6)[[1]]
cat("F(", a$Df[1], ", ", a$Df[2], ") = ", f(a$`F value`[1]), "; ", fp(a$`Pr(>F)`[1]),
    "; η² = ", f(a$`Sum Sq`[1] / sum(a$`Sum Sq`)), "\n", sep = "")
round(TukeyHSD(m6)$grupa[, "p adj"], 3)

# 3) Chi-kwadrat (Z8): ćwiczenia × zaliczenie
tab <- matrix(c(15, 5, 5, 15), 2, byrow = TRUE)
ch  <- chisq.test(tab, correct = FALSE)
cat("χ²(", ch$parameter, ", N = ", sum(tab), ") = ", f(ch$statistic), "; ", fp(ch$p.value),
    "; φ = ", f(sqrt(ch$statistic / sum(tab))), "\n", sep = "")

# 4) Korelacja i regresja (Z4): godziny nauki i punkty
x <- c(1, 2, 3, 4, 5); y <- c(4, 2, 8, 6, 10)
r <- cor.test(x, y)
cat("r(", r$parameter, ") = ", f(r$estimate), "; ", ci(r$conf.int[1], r$conf.int[2]), "; ", fp(r$p.value), "\n", sep = "")
s <- summary(lm(y ~ x)); k <- confint(lm(y ~ x))["x", ]
cat("R² = ", f(s$r.squared), "; F(", s$fstatistic[2], ", ", s$fstatistic[3], ") = ", f(s$fstatistic[1]),
    "; b = ", f(coef(s)["x", 1]), "; ", ci(k[1], k[2]), "; t(", s$df[2], ") = ", f(coef(s)["x", 3]),
    "; ", fp(coef(s)["x", 4]), "\n", sep = "")
Wynik w konsoli R:
t(8) = 3,00; p = 0,017; d = 1,90; 95% CI [0,69; 5,31]
F(2, 6) = 7,00; p = 0,027; η² = 0,70
  B-A   C-A   C-B
0.768 0.028 0.067
χ²(1, N = 40) = 10,00; p = 0,002; φ = 0,50
r(3) = 0,80; 95% CI [−0,28; 0,99]; p = 0,104
R² = 0,64; F(1, 3) = 5,33; b = 1,60; 95% CI [−0,60; 3,80]; t(3) = 2,31; p = 0,104
Checklista przed oddaniem rozdziału
- Każdy test ma statystykę, stopnie swobody, dokładne p i wielkość efektu.
- Symbole łacińskie są kursywą, greckie – nie.
- Wszędzie jest przecinek dziesiętny i ta sama liczba miejsc po przecinku.
- Nigdzie nie ma „p = 0,000” ani samego „p < 0,05” zamiast dokładnej wartości.
- Tabele i rysunki mają numery, tytuły i noty, a tekst do nich odsyła.
- Wnioski nie sugerują przyczynowości tam, gdzie badanie było korelacyjne.
Najczęstsze pytania
Jak zapisać wartość p w pracy magisterskiej?
Podaj dokładną wartość z dwoma lub trzema miejscami po przecinku, np. p = 0,027. Wyjątek to bardzo małe wartości: p < 0,001. Pamiętaj, że p to prawdopodobieństwo wyniku co najmniej tak skrajnego przy prawdziwej hipotezie zerowej, a nie prawdopodobieństwo, że hipoteza zerowa jest prawdziwa (Wasserstein i Lazar, 2016). Więcej w haśle istotność statystyczna.
Czy podawać wyniki nieistotne?
Tak, w tym samym formacie co istotne: statystyka, p i wielkość efektu. Zalecenia JARS mówią wprost, że raportuje się wszystkie wykonane analizy (Appelbaum i in., 2018).
Programy pokazują kropkę dziesiętną – co z tym zrobić?
SPSS, R i jamovi zwykle wyświetlają wyniki z kropką, np. 0.017. W polskim tekście zamień ją na przecinek, także w tabelach i na osiach wykresów. Najprościej robić to od razu w R, tak jak w kodzie powyżej. Nie przepisuj ręcznie długich kolumn liczb, bo wtedy najłatwiej o pomyłkę.
Czy w tekście pisać „95% CI”, czy „95% PU”?
Oba zapisy spotkasz w polskich pracach. Wybierz jeden i stosuj go konsekwentnie; przy pierwszym użyciu rozwiń skrót: „przedział ufności”.
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikJak opisać wyniki ankiety w pracy magisterskiej
- PoradnikWielkość efektu – jak liczyć i raportować
- Słownik wzorówIstotność statystyczna i wartość p
- PoradnikOpis próby badawczej – Tabela 1 krok po kroku
- PoradnikAnaliza statystyczna w pracy magisterskiej krok po kroku
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.