

Korelacja polichoryczna – wzór i przykład
Korelacja polichoryczna szacuje związek między dwiema uporządkowanymi odpowiedziami (np. na skali Likerta) tak, jakby za każdą z nich stała ciągła, normalnie rozłożona cecha. Przykładowe pytanie z pracy dyplomowej: na jakiej macierzy korelacji oprzeć analizę czynnikową pytań ankiety ocenianych od 1 do 5?
W prostych słowachGdy student zaznacza „2” na skali 1–3, jego prawdziwa postawa nie jest okrągłą liczbą – to punkt na ciągłej skali, który ankieta „przycięła” do jednej z trzech kratek. Korelacja polichoryczna próbuje odtworzyć związek tych ukrytych, ciągłych postaw. Zwykle wychodzi wyższa niż Pearson, bo nie traci informacji na grubym zaokrąglaniu odpowiedzi.
Kiedy stosować korelację polichoryczną?
- obie zmienne są porządkowe i mają niewiele kategorii (2–5), np. pytania Likerta;
- masz powód sądzić, że za odpowiedziami kryje się ciągła cecha o rozkładzie zbliżonym do normalnego;
- chcesz policzyć analizę czynnikową pytań – tu polichoryczna macierz korelacji jest zwykle lepsza od Pearsona.
Gdy obie zmienne mają tylko dwie kategorie (tak/nie), ta sama metoda nazywa się korelacją tetrachoryczną. Jeśli nie chcesz zakładać ukrytej cechy, opisz związek korelacją Spearmana albo tau Kendalla. Dla wyników mierzonych na skali ilościowej zostań przy korelacji Pearsona.
Wzór na korelację polichoryczną
Na głos: „najpierw ustal progi, które tną ukrytą cechę na kategorie, a potem znajdź taką korelację ukrytych cech, przy której obserwowana tabela jest najbardziej prawdopodobna”.
- \(X^*, Y^*\)
- ukryte, ciągłe cechy (np. prawdziwa sympatia do statystyki), których nie widzimy
- \(X = c\)
- widoczna odpowiedź: kategoria c, np. 1, 2 lub 3
- \(\tau_c\)
- próg: punkt na skali ukrytej cechy, w którym odpowiedź zmienia się z c na c + 1
- \(n_1 + \dots + n_c\)
- liczba osób, które wybrały kategorię c lub niższą
- \(\Phi^{-1}\)
- odwrotna dystrybuanta rozkładu normalnego: zamienia odsetek na wynik z (w R:
qnorm) - \(n_{ij}\)
- liczba osób w komórce tabeli: odpowiedź i na pierwsze pytanie i j na drugie
- \(\pi_{ij}(\rho)\)
- prawdopodobieństwo trafienia do tej komórki, gdy ukryte cechy mają dwuwymiarowy rozkład normalny z korelacją ρ
- \(\ln L(\rho)\)
- logarytm wiarygodności: im wyższy, tym lepiej dana ρ tłumaczy tabelę
Przykład krok po kroku
Dwadzieścioro studentów odpowiedziało na dwa pytania na skali 1–3 (1 – nie, 2 – trudno powiedzieć, 3 – tak): „Lubię statystykę” (wiersze) i „Chętnie chodzę na ćwiczenia ze statystyki” (kolumny).
| „Lubię statystykę” | ćwiczenia: 1 | ćwiczenia: 2 | ćwiczenia: 3 | razem | łączny odsetek | próg z = qnorm(odsetek) |
|---|---|---|---|---|---|---|
| 1 | 3 | 2 | 0 | 5 | 5 / 20 = 0,25 | −0,674 |
| 2 | 2 | 6 | 2 | 10 | 15 / 20 = 0,75 | 0,674 |
| 3 | 0 | 2 | 3 | 5 | 20 / 20 = 1 | — |
| razem | 5 | 10 | 5 | 20 |
- Pearson dla porównania. Średnia obu pytań to 2, więc odchylenia to −1, 0 lub 1. Iloczyn odchyleń jest różny od zera tylko w rogach tabeli: 3 osoby z (1, 1) dają 3 · (−1)(−1) = 3, 3 osoby z (3, 3) dają 3 · 1 · 1 = 3, rogi (1, 3) i (3, 1) są puste. Suma iloczynów: 6. Suma kwadratów odchyleń w każdym pytaniu: 5 · 1 + 10 · 0 + 5 · 1 = 10. Zatem \(r = 6 / \sqrt{10 \cdot 10} = 0{,}60\).
- Spearman. Rangi wiązane to 3 (dla odpowiedzi 1), 10,5 (dla 2) i 18 (dla 3). Są równo rozstawione (co 7,5), tak jak 1, 2, 3, więc Spearman też wynosi 0,60.
- Progi. W pierwszym pytaniu 5 z 20 osób (25%) wybrało „1”. Szukamy wyniku z, poniżej którego leży 25% rozkładu normalnego: z tablic rozkładu normalnego to −0,674 (w R:
qnorm(0.25)). Odpowiedzi „1” lub „2” to 15 / 20 = 75%, więc drugi próg to 0,674 (qnorm(0.75)). Drugie pytanie ma te same liczebności (5, 10, 5), więc te same progi. - Sprawdzenie przy ρ = 0. Gdy ukryte cechy nie są związane, prawdopodobieństwo komórki to iloczyn odsetków. Róg (1, 1): 0,25 · 0,25 = 0,0625, czyli oczekujemy 20 · 0,0625 = 1,25 osoby. Środek (2, 2): 0,5 · 0,5 = 0,25, czyli 5 osób. Brzegi: 0,25 · 0,5 = 0,125, czyli 2,5 osoby.
- Logarytm wiarygodności przy ρ = 0. ln 0,0625 = −2,773 (6 osób w rogach), ln 0,125 = −2,079 (8 osób na brzegach), ln 0,25 = −1,386 (6 osób w środku). Razem: 6 · (−2,773) + 8 · (−2,079) + 6 · (−1,386) = −41,59.
- Szukanie najlepszej ρ. Dla ρ ≠ 0 prawdopodobieństwa komórek to pola pod dwuwymiarowym rozkładem normalnym – liczy je komputer. Sprawdzamy kolejne wartości ρ i wybieramy tę z najwyższym ln L. Przy ρ = 0,60 wychodzi −37,52, a przy ρ = 0,73 maksimum: −37,25.
- Wynik. \(\hat\rho = 0{,}73\). To więcej niż Pearson i Spearman (0,60), bo uwzględnia, że odpowiedzi 1–2–3 są grubo zaokrągloną wersją ciągłych postaw.
| typ komórki | obserwowane | ρ = 0 | ρ = 0,60 | ρ = 0,73 |
|---|---|---|---|---|
| róg zgodny: (1, 1) lub (3, 3) | 3 | 1,25 | 2,69 | 3,11 |
| róg sprzeczny: (1, 3) lub (3, 1) | 0 | 1,25 | 0,22 | 0,08 |
| brzeg: np. (1, 2) | 2 | 2,5 | 2,09 | 1,81 |
| środek: (2, 2) | 6 | 5 | 5,82 | 6,38 |
| ln L(ρ) | −41,59 | −37,52 | −37,25 |
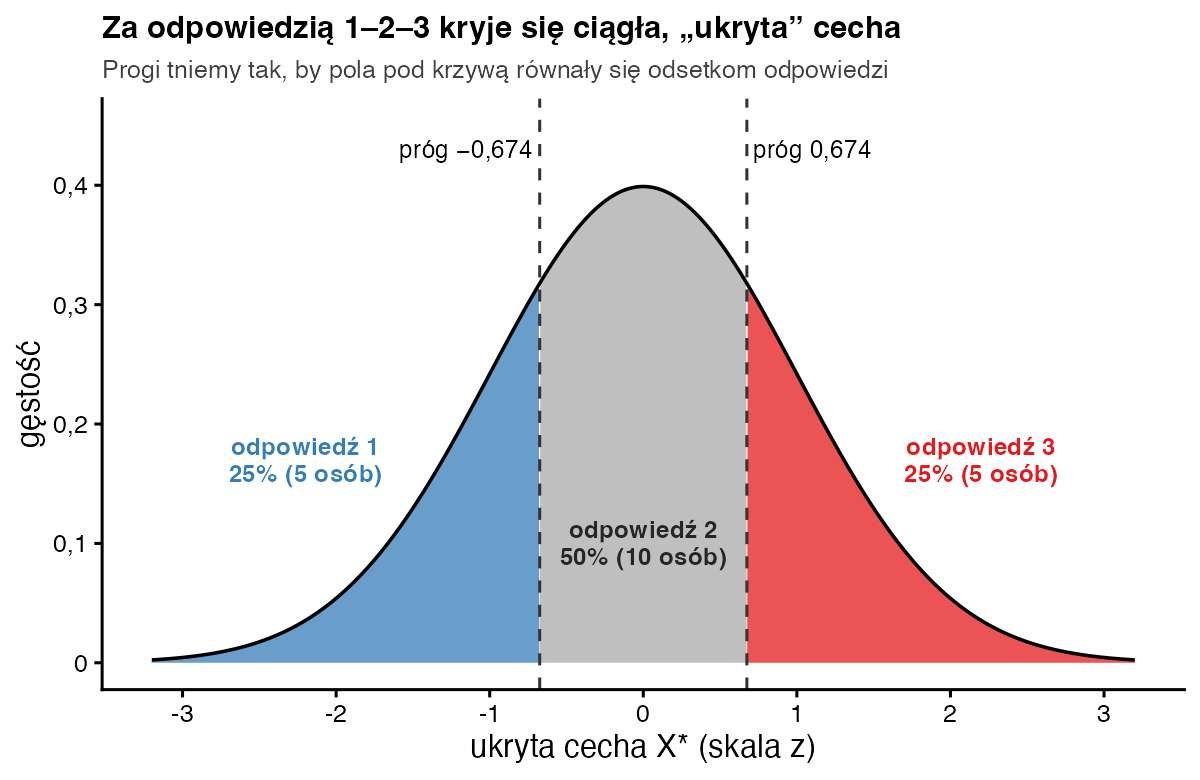
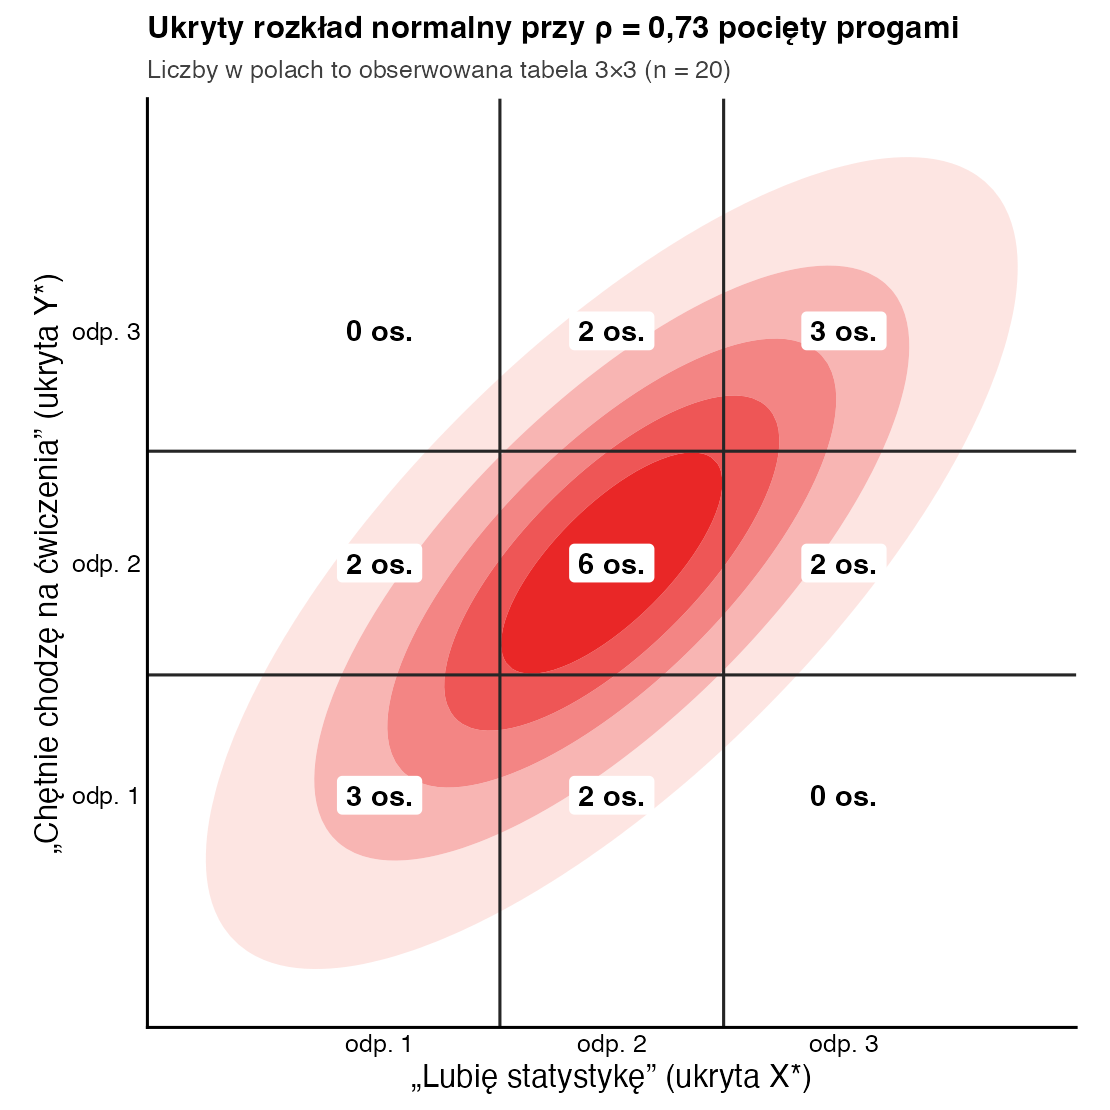
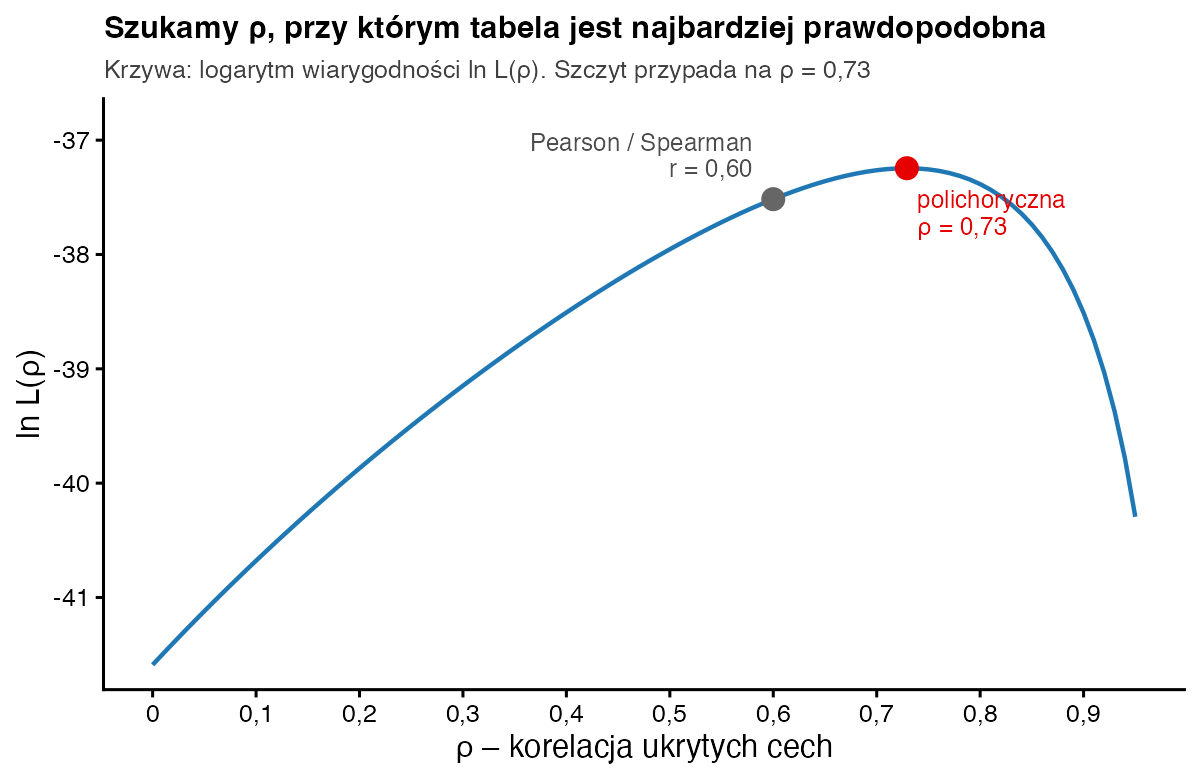
Aplikacja SZTOS nie ma osobnego modułu dla korelacji polichorycznej, dlatego rysunki są dydaktyczne.
Jak zinterpretować i opisać wynik?
Korelację polichoryczną czytasz jak Pearsona: znak to kierunek, a wartość to siła związku – ale ukrytych cech, nie samych odpowiedzi. Przy 20 osobach oszacowanie jest niepewne: błąd standardowy wynosi około 0,15. Założenie normalności ukrytych cech można sprawdzić testem w pakiecie polycor; tu nie ma podstaw do jego odrzucenia (χ²(3) = 0,44; p = 0,93).
Zapis w stylu APA: Związek między sympatią do statystyki a chęcią udziału w ćwiczeniach oszacowano korelacją polichoryczną (dwustopniowa metoda największej wiarygodności). Był on silny i dodatni, ρpoli = 0,73 (n = 20). Dla porównania korelacja Pearsona i Spearmana wynosiła r = 0,60.
Jak policzyć korelację polichoryczną w R?
tab <- matrix(c(3, 2, 0,      # wiersze: „Lubię statystykę” 1–3
                2, 6, 2,      # kolumny: „Chętnie chodzę na ćwiczenia” 1–3
                0, 2, 3), 3, byrow = TRUE)
X <- rep(rep(1:3, each = 3), c(t(tab))); Y <- rep(rep(1:3, 3), c(t(tab)))   # 20 osób
c(pearson = cor(X, Y), spearman = cor(X, Y, method = "spearman"))           # 0,60 i 0,60

# 1) „ręcznie”: progi z łącznych proporcji, potem rho z największą wiarygodnością
progi <- qnorm(cumsum(rowSums(tab))[1:2] / 20); progi      # -0,674 i 0,674
b <- c(-Inf, progi, Inf)
pi_ij <- function(rho) outer(1:3, 1:3, Vectorize(function(i, j)
  mvtnorm::pmvnorm(c(b[i], b[j]), c(b[i + 1], b[j + 1]), corr = matrix(c(1, rho, rho, 1), 2))))
lnL <- function(rho) sum(tab * log(pi_ij(rho)))
optimize(lnL, c(-0.99, 0.99), maximum = TRUE)$maximum     # 0,729

# 2) gotową funkcją z pakietu psych
pc <- psych::polychoric(data.frame(X, Y))
round(pc$rho[1, 2], 3); round(pc$tau, 3)
Wynik w konsoli R:
 pearson spearman
     0.6      0.6
[1] -0.6744898  0.6744898
[1] 0.7292308
[1] 0.729
       1     2
X -0.674 0.674
Y -0.674 0.674
Ręczne szukanie maksimum (optimize) i psych::polychoric() dają tę samą wartość 0,729. Dla całego kwestionariusza wpisz do polychoric() ramkę z wszystkimi pytaniami – dostaniesz macierz, którą przekażesz np. do psych::fa().
Polichoryczna czy Pearson w analizie czynnikowej skali Likerta?
Gdy pytania mają 2–4 kategorie albo rozkłady odpowiedzi są mocno skośne, wybierz polichoryczną. Pearson zaniża wtedy korelacje, a w efekcie także ładunki czynnikowe (Holgado-Tello i in., 2010). Przy 5–7 i więcej kategoriach i rozkładach zbliżonych do symetrycznych różnice są zwykle niewielkie. Pamiętaj, że macierz polichoryczna wymaga większej próby i czasem trzeba ją „wygładzić”. Na niej licz też KMO i analizę równoległą. Przy ocenie pojedynczych pytań przyda się też korelacja pozycja–całość, a ogólne zasady opisuje tekst o analizie skali Likerta.
Najczęstsze błędy
- Liczenie korelacji polichorycznej dla zmiennych bez naturalnego porządku (np. kierunek studiów).
- Stosowanie jej przy bardzo małej próbie i pustych komórkach bez komentarza o niepewności.
- Interpretowanie ρ jako związku samych odpowiedzi, a nie ukrytych cech.
- Mieszanie w jednej analizie czynnikowej macierzy Pearsona i polichorycznej bez zaznaczenia tego w opisie.
- Brak informacji, jaką metodą (dwustopniową czy pełną największej wiarygodności) policzono korelację.
Bibliografia
- Olsson, U. (1979). Maximum likelihood estimation of the polychoric correlation coefficient. Psychometrika, 44(4), 443–460.
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491.
- Holgado-Tello, F. P., Chacón-Moscoso, S., Barbero-García, I., & Vila-Abad, E. (2010). Polychoric versus Pearson correlations in exploratory and confirmatory factor analysis of ordinal variables. Quality & Quantity, 44(1), 153–166.
- Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5). Northwestern University. https://CRAN.R-project.org/package=psych
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Spearmana
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówŁadunek czynnikowy
- PoradnikKorelacja Pearsona – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza korelacji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.