

Przedział ufności dla różnicy średnich – wzór i przykład
Przedział ufności dla różnicy średnich pokazuje, o ile punktów mogą się naprawdę różnić dwie grupy – nie tylko czy w ogóle się różnią. Typowe pytanie z pracy dyplomowej: studenci uczący się z quizów zdobyli średnio o 3 punkty więcej – ale jak duża może być ta przewaga w całej populacji?
W prostych słowachRóżnica średnich z próby to jedna liczba, a przy innych osobach wyszłaby trochę inna. Przedział ufności podaje zakres różnic, które są zgodne z Twoimi danymi. Jeśli w tym zakresie nie ma zera, różnica jest istotna statystycznie. Do tego od razu widzisz, czy przewaga może być mała, czy raczej duża.
Kiedy stosować przedział ufności dla różnicy średnich?
- porównujesz dwie niezależne grupy (różne osoby) pod względem wyniku ilościowego: punktów, czasu, wyniku skali;
- robisz test t dla prób niezależnych – przedział jest jego naturalnym uzupełnieniem i R wypisuje go automatycznie;
- chcesz pokazać wielkość różnicy w jednostkach pomiaru, np. „od 0,7 do 5,3 punktu”, a nie tylko wartość p;
- wyniki w grupach mają rozkład zbliżony do normalnego albo grupy są na tyle duże, że to nie ma dużego znaczenia.
Dla jednej średniej użyj przedziału ufności dla średniej. Gdy wariancje w grupach wyraźnie się różnią, licz wersję Welcha (opisaną niżej i w haśle test t Welcha). Gdy chcesz podać różnicę w jednostkach odchylenia standardowego, sięgnij po d Cohena.
Wzór na przedział ufności dla różnicy średnich
- \(\bar{x}_1 - \bar{x}_2\)
- różnica średnich z próby – środek przedziału
- \(s_1^2,\ s_2^2\)
- wariancje w grupach (kwadraty odchyleń standardowych)
- \(s_p^2\)
- wariancja połączona – „uśredniony” rozrzut obu grup, ważony liczbą osób
- \(n_1,\ n_2\)
- liczba osób w grupach
- \(\sqrt{\dots}\)
- błąd standardowy różnicy (SE) – o ile typowo różnica z próby odbiega od prawdziwej
- \(t_{0{,}975;\ df}\)
- wartość krytyczna z rozkładu t Studenta dla 95% ufności; w wersji klasycznej \(df = n_1 + n_2 - 2\)
- \(df_W\)
- stopnie swobody Welcha, liczone z wariancji i liczebności grup; zwykle nie są liczbą całkowitą
Wzór przeczytasz na głos tak: „różnica średnich plus minus wartość krytyczna t razy błąd standardowy tej różnicy”. To ta sama konstrukcja co w każdym przedziale ufności: oszacowanie ± margines.
Przykład krok po kroku
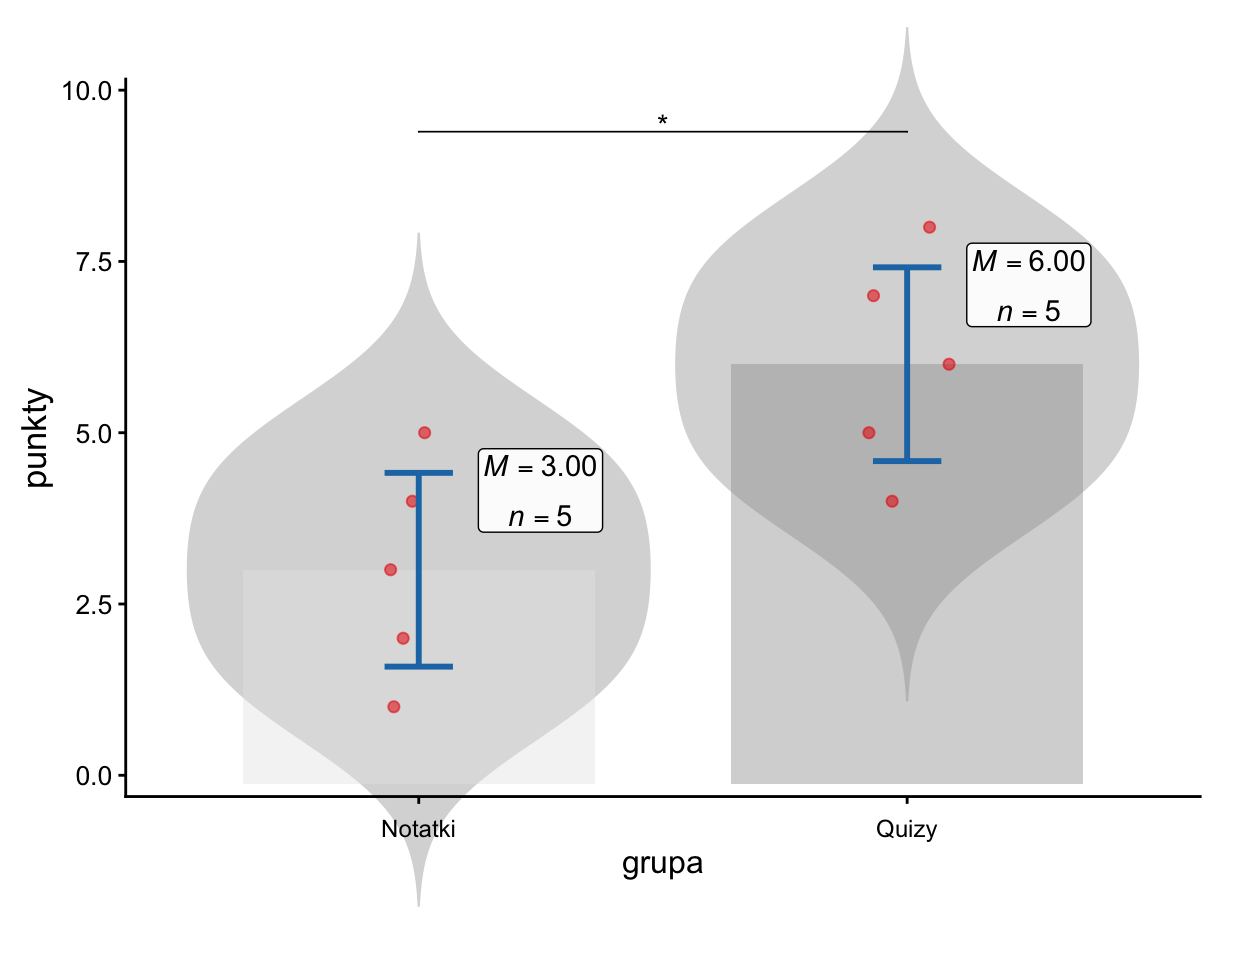
Pięcioro studentów uczyło się z notatek, a pięcioro z quizów. To te same dane co w haśle o teście t, dlatego wyniki się zgadzają:
| Notatki x | x − 3 | (x − 3)² | Quizy x | x − 6 | (x − 6)² |
|---|---|---|---|---|---|
| 1 | 1 − 3 = −2 | 4 | 4 | 4 − 6 = −2 | 4 |
| 2 | 2 − 3 = −1 | 1 | 5 | 5 − 6 = −1 | 1 |
| 3 | 3 − 3 = 0 | 0 | 6 | 6 − 6 = 0 | 0 |
| 4 | 4 − 3 = 1 | 1 | 7 | 7 − 6 = 1 | 1 |
| 5 | 5 − 3 = 2 | 4 | 8 | 8 − 6 = 2 | 4 |
| Σ = 15 | 0 | 10 | Σ = 30 | 0 | 10 |
- Średnie i różnica. Notatki: 15 / 5 = 3. Quizy: 30 / 5 = 6. Różnica: 6 − 3 = 3 punkty – to środek przedziału.
- Wariancje. W obu grupach suma kwadratów odchyleń wynosi 10, więc wariancja = 10 / (5 − 1) = 10 / 4 = 2,5.
- Wariancja połączona. \(s_p^2\) = (4 · 2,5 + 4 · 2,5) / (5 + 5 − 2) = (10 + 10) / 8 = 2,5.
- Błąd standardowy różnicy. 1/5 + 1/5 = 0,4; 2,5 · 0,4 = 1; √1 = 1. SE = 1 punkt.
- Wartość krytyczna t. Stopnie swobody: df = 5 + 5 − 2 = 8. W tablicy rozkładu t, w wierszu df = 8 i kolumnie „0,05 dwustronnie” (czyli 0,025 w każdym ogonie), znajdziesz 2,306. W R:
qt(0.975, 8). - Margines błędu. 2,306 · 1 = 2,306 punktu.
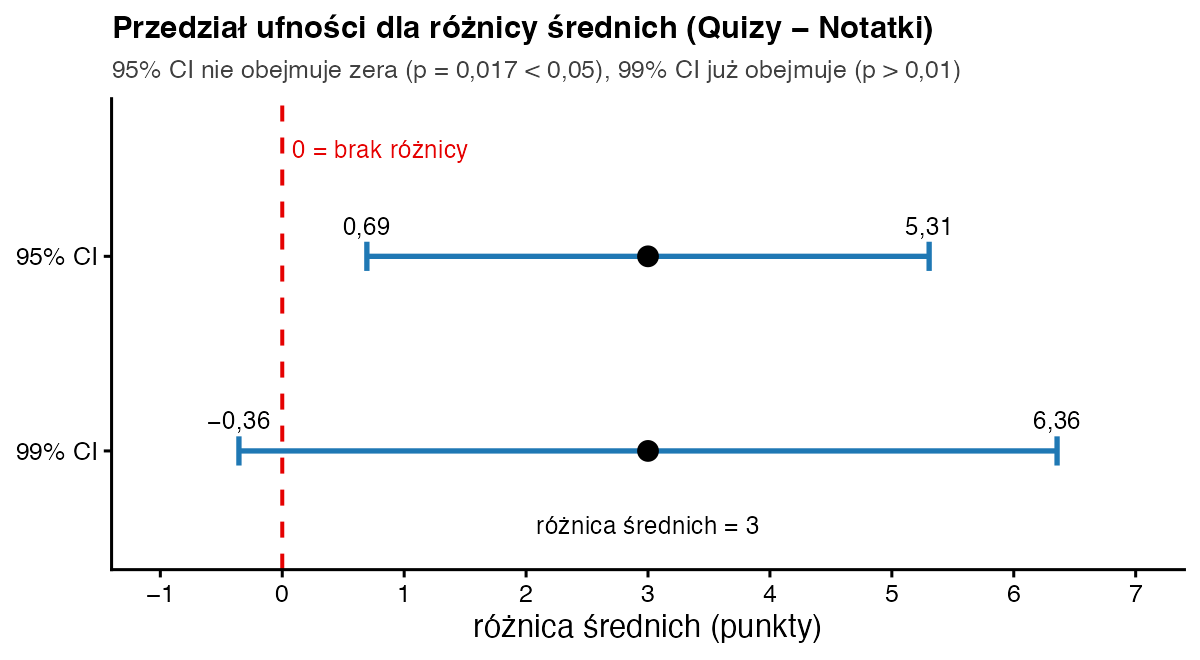
- Granice. Dolna: 3 − 2,306 = 0,694. Górna: 3 + 2,306 = 5,306. Po zaokrągleniu: 95% CI [0,69; 5,31].
- Wersja Welcha. SE = √(2,5/5 + 2,5/5) = √(0,5 + 0,5) = √1 = 1. Stopnie swobody Welcha: 1⁴ / (0,5² / 4 + 0,5² / 4) = 1 / (0,0625 + 0,0625) = 1 / 0,125 = 8. Wychodzi dokładnie to samo, bo grupy są równe i mają równe wariancje. Przy różnych wariancjach i liczebnościach obie wersje się rozjadą.
Jak zinterpretować i opisać wynik?
Różnica 3 punkty to najlepsze pojedyncze oszacowanie. Przedział [0,69; 5,31] mówi, że dane są zgodne zarówno z niewielką przewagą quizów (około 0,7 punktu), jak i z dużą (ponad 5 punktów). Szeroki przedział to uczciwa informacja: przy pięciu osobach w grupie wiemy niewiele o tym, jak duża jest przewaga. Przedział nie obejmuje zera, więc różnica jest istotna na poziomie 0,05 – to ta sama informacja co p = 0,017 z testu t. Obowiązuje zasada: 95% CI nie obejmuje zera wtedy i tylko wtedy, gdy dwustronne p < 0,05 (przy tej samej wersji testu). Pamiętaj, że 95% dotyczy metody: w długiej serii badań około 95 na 100 tak policzonych przedziałów obejmie prawdziwą różnicę.
Zapis w stylu APA: Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali średnio o 3 punkty więcej niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; różnica średnich = 3,00; 95% CI [0,69; 5,31].
Jak policzyć przedział ufności dla różnicy średnich w R?
notatki <- c(1, 2, 3, 4, 5)
quizy   <- c(4, 5, 6, 7, 8)
n1 <- length(quizy); n2 <- length(notatki)

# 1) „ręcznie”: wersja klasyczna (wariancja połączona)
roznica <- mean(quizy) - mean(notatki)                       # 3
s2_p <- ((n1 - 1) * var(quizy) + (n2 - 1) * var(notatki)) / (n1 + n2 - 2)
se   <- sqrt(s2_p * (1/n1 + 1/n2))                           # 1
t_kr <- qt(0.975, df = n1 + n2 - 2)                          # 2,306
round(c(roznica = roznica, SE = se, t_kr = t_kr,
        dolna = roznica - t_kr * se, gorna = roznica + t_kr * se), 3)

# 2) „ręcznie”: wersja Welcha (osobne wariancje, df Welcha)
se_w <- sqrt(var(quizy)/n1 + var(notatki)/n2)
df_w <- se_w^4 / ((var(quizy)/n1)^2/(n1 - 1) + (var(notatki)/n2)^2/(n2 - 1))
round(c(SE = se_w, df = df_w), 3)

# 3) gotowe funkcje
t.test(quizy, notatki, var.equal = TRUE)$conf.int            # klasyczny
t.test(quizy, notatki)$conf.int                              # Welch (domyślny)
Wynik w konsoli R:
roznica      SE    t_kr   dolna   gorna
  3.000   1.000   2.306   0.694   5.306
SE df
 1  8
[1] 0.6939959 5.3060041
attr(,"conf.level")
[1] 0.95
[1] 0.6939959 5.3060041
attr(,"conf.level")
[1] 0.95
Funkcja t.test() bez var.equal = TRUE liczy wersję Welcha. Tutaj obie wersje dają ten sam przedział, ale w pracy napisz, którą podajesz. Kolejność grup w t.test(quizy, notatki) decyduje o znaku: przy odwrotnej kolejności dostaniesz [−5,31; −0,69].
Czy wystarczy, że przedziały ufności grup nie nachodzą na siebie?
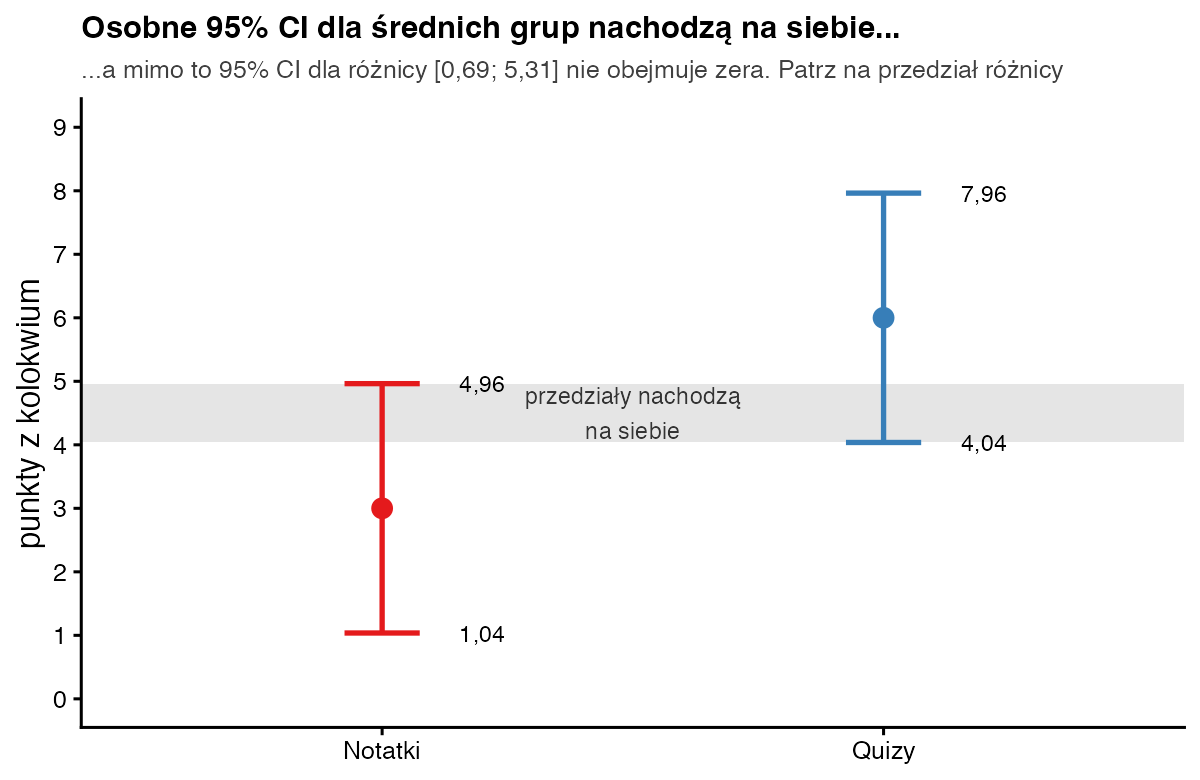
To jedna z najczęstszych pomyłek – popełniają ją nawet doświadczeni badacze (Cumming i Finch, 2005). Jeśli osobne 95% CI dla dwóch grup nie nachodzą na siebie, różnica na pewno jest istotna. Jeśli jednak nachodzą, to jeszcze nic nie wiadomo – jak w naszym przykładzie (Rys. 3). Dzieje się tak, bo błąd standardowy różnicy (1) jest mniejszy niż suma błędów obu średnich (0,71 + 0,71 = 1,41). Dlatego zawsze licz przedział dla samej różnicy. Przy grupach podobnej wielkości (co najmniej kilkanaście osób) różnica jest zwykle istotna, gdy przedziały nachodzą na siebie najwyżej na około połowę długości ramienia.
Najczęstsze błędy
- Wnioskowanie o braku różnicy z tego, że osobne przedziały grup nachodzą na siebie.
- Liczenie przedziału z wartością 1,96 zamiast z wartością krytyczną t – przy małych grupach przedział wychodzi wtedy za wąski.
- Używanie tego wzoru, gdy te same osoby zmierzono dwa razy (przed i po) – wtedy liczysz przedział dla średniej różnic par, jak w teście t dla prób zależnych.
- Pomijanie znaku: z samego zapisu [0,69; 5,31] czytelnik musi wiedzieć, którą grupę odjęto od której.
- Interpretacja „z prawdopodobieństwem 95% prawdziwa różnica leży w tym przedziale” – 95% dotyczy metody, nie jednego przedziału.
Bibliografia
- Welch, B. L. (1947). The generalization of “Student’s” problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówd Cohena – wielkość efektu
- Słownik wzorówTest t Welcha
- Słownik wzorówg Hedgesa i Δ Glassa
- PoradnikWeryfikacja hipotez w pracy magisterskiej
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.