

Rozkład t Studenta i stopnie swobody – wzór, tablice i przykład
Rozkład t Studenta to „ostrożniejsza” wersja rozkładu normalnego, której używasz, gdy odchylenie standardowe szacujesz z małej próby. Przykładowe pytanie z pracy dyplomowej: jaki jest 95% przedział ufności dla średniej długości snu, skoro zbadałeś tylko kilka osób?
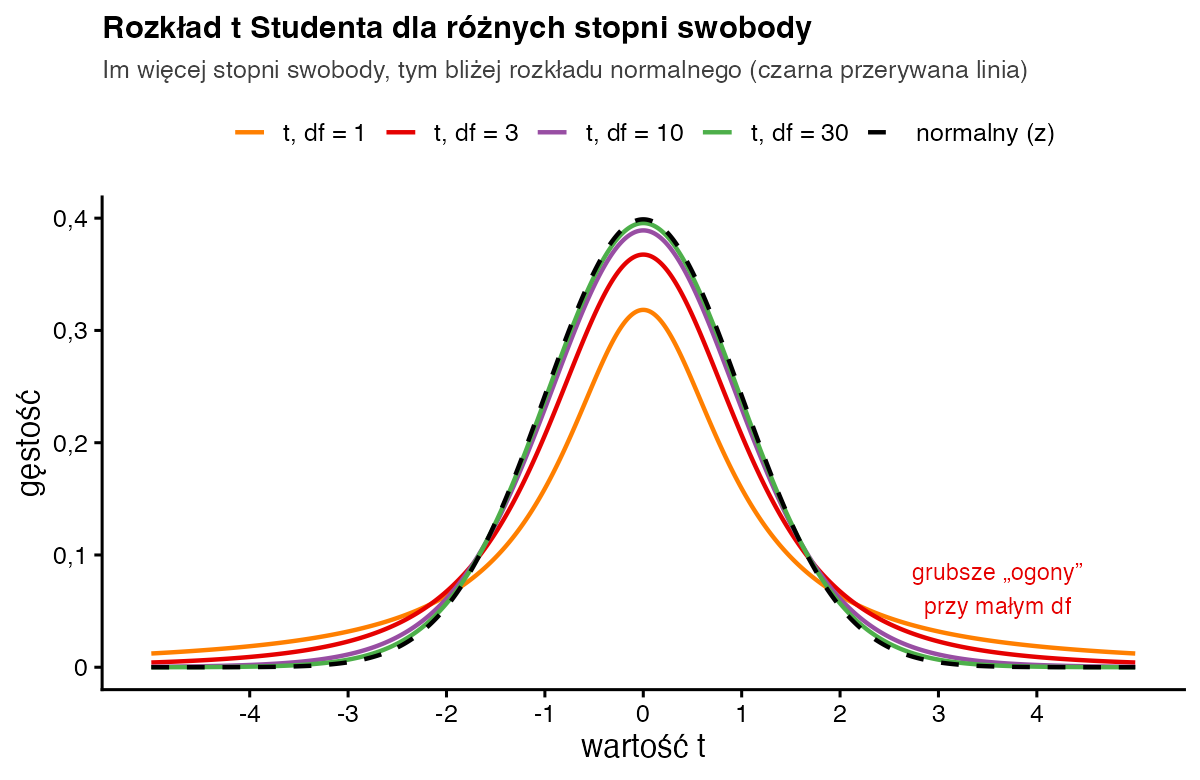
W prostych słowachGdy masz mało danych, nie wiesz dokładnie, jak bardzo wyniki się rozrzucają. Rozkład t uwzględnia tę dodatkową niepewność: ma niższy szczyt i grubsze „ogony” niż rozkład normalny. Jego kształt zależy od stopni swobody, czyli w uproszczeniu od liczby osób minus jeden. Im więcej danych, tym bardziej rozkład t upodabnia się do normalnego, a przy kilkudziesięciu osobach różnica jest już niewielka.
Kiedy korzystasz z rozkładu t?
- liczysz przedział ufności dla średniej, a odchylenie standardowe populacji jest nieznane (prawie zawsze);
- wykonujesz test t dla jednej próby, test t dla prób niezależnych lub dla prób zależnych;
- sprawdzasz istotność współczynników regresji i korelacji Pearsona;
- dane w populacji mają rozkład zbliżony do normalnego albo próba jest na tyle duża, że działa centralne twierdzenie graniczne.
Rozkład normalny (wartość 1,96) wolno stosować wtedy, gdy znasz prawdziwe odchylenie standardowe populacji albo próba jest bardzo duża. W pracach dyplomowych bezpieczniej zawsze używać rozkładu t – przy dużej próbie i tak da prawie ten sam wynik.
Wzór na statystykę t i stopnie swobody
- \(t\)
- statystyka t: o ile błędów standardowych średnia z próby odbiega od wartości porównawczej
- \(\bar{x}\)
- średnia z próby, np. średnia godzin snu
- \(\mu_0\)
- wartość z hipotezy zerowej, z którą porównujesz średnią (np. zalecane 7 godzin snu)
- \(s\)
- odchylenie standardowe z próby – właśnie to, że je szacujesz, sprawia, że potrzebny jest rozkład t
- \(s / \sqrt{n}\)
- błąd standardowy średniej (SE)
- \(df\)
- stopnie swobody (ang. degrees of freedom) – liczba wyników, które mogą się zmieniać „swobodnie”
- \(t_{0{,}975;\ df}\)
- wartość krytyczna z tablic t: punkt, od którego po prawej zostaje 2,5% rozkładu
Na głos czytamy: „t to średnia minus wartość porównawcza, podzielone przez błąd standardowy; liczba stopni swobody to n minus jeden”.
Czym są stopnie swobody?
Wyobraź sobie czterech studentów, o których wiesz, że średnio spali 5 godzin, czyli razem 20 godzin. Pierwszy mógł spać dowolnie długo – powiedzmy 6 godzin. Drugi też – 2 godziny. Trzeci – 6 godzin. Ale czwarty nie ma już wyboru: 20 − 6 − 2 − 6 = 6 godzin. Gdy średnia jest ustalona, swobodnie mogą się zmieniać tylko trzy wyniki z czterech. Stąd df = n − 1 = 3. Ta sama „strata” jednego stopnia swobody tłumaczy, dlaczego we wzorze na wariancję dzielimy przez n − 1. W innych testach df liczy się inaczej, np. n₁ + n₂ − 2 w teście t dla dwóch grup.
Przykład krok po kroku
Czterech studentów spało przed kolokwium 6, 2, 6 i 6 godzin. Policzmy 95% przedział ufności dla średniej.
| Osoba | Sen x (h) | Odchylenie x − 5 | Kwadrat (x − 5)² |
|---|---|---|---|
| 1 | 6 | 6 − 5 = 1 | 1² = 1 |
| 2 | 2 | 2 − 5 = −3 | (−3)² = 9 |
| 3 | 6 | 6 − 5 = 1 | 1² = 1 |
| 4 | 6 | 6 − 5 = 1 | 1² = 1 |
| Σ | 20 | 0 | 12 |
- Średnia. 6 + 2 + 6 + 6 = 20, a 20 / 4 = 5 godzin.
- Odchylenie standardowe. Suma kwadratów: 1 + 9 + 1 + 1 = 12. Wariancja: 12 / (4 − 1) = 12 / 3 = 4. Odchylenie: \(\sqrt{4} = 2\) godziny.
- Błąd standardowy. SE = 2 / \(\sqrt{4}\) = 2 / 2 = 1 godzina.
- Stopnie swobody. df = 4 − 1 = 3.
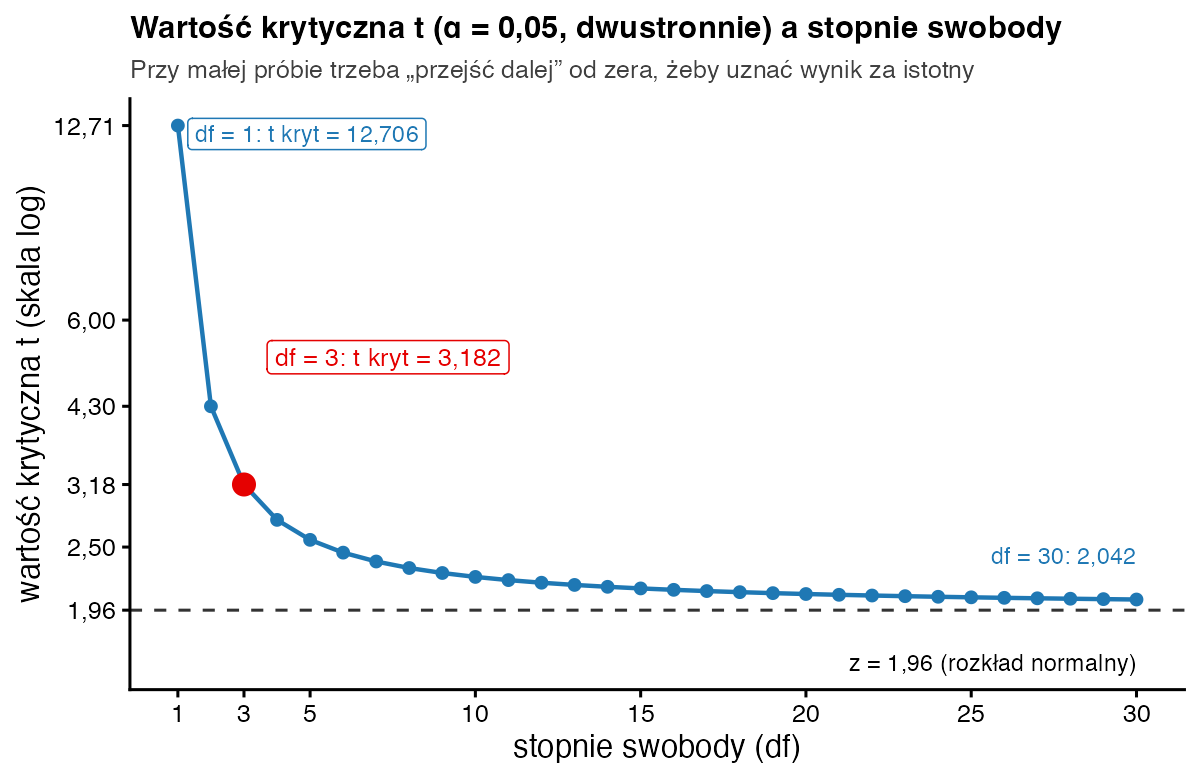
- Wartość krytyczna z tablic. W tablicy rozkładu t znajdź wiersz df = 3 i kolumnę „0,05 dwustronnie” (albo 0,025 jednostronnie). Odczytasz 3,182. W R:
qt(0.975, 3). - Margines błędu. 3,182 · 1 = 3,182 godziny.
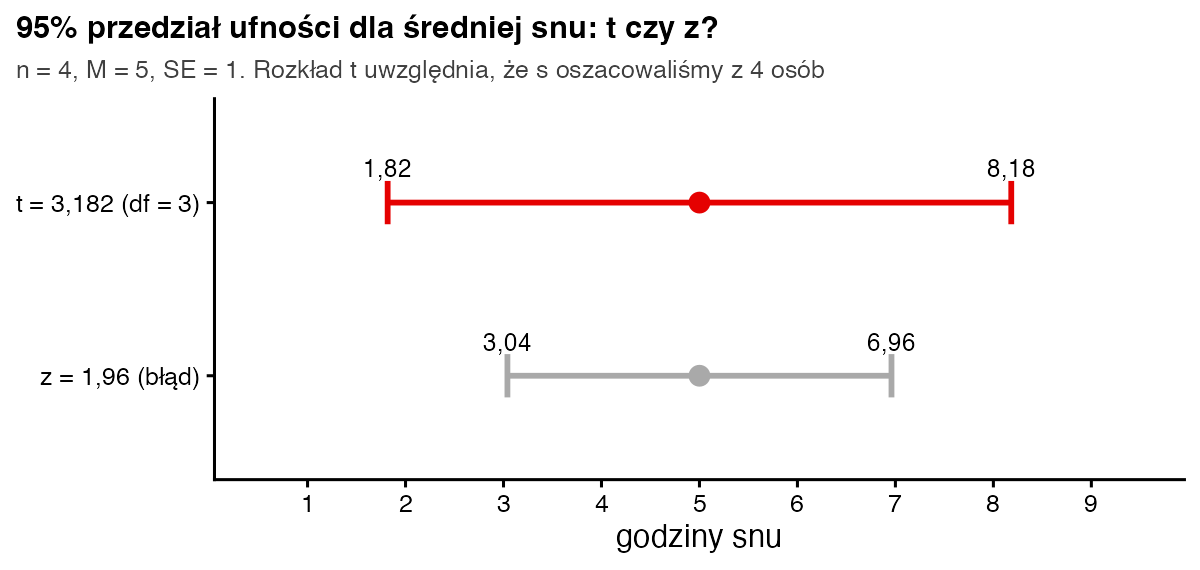
- Przedział. 5 − 3,182 = 1,82 oraz 5 + 3,182 = 8,18. Wynik: 95% CI [1,82; 8,18] godziny.
- Dla porównania – błędnie z rozkładu normalnego. 5 ± 1,96 · 1 daje [3,04; 6,96]. Taki przedział jest za wąski. Przy df = 3 wartość 1,96 odcina nie 5%, ale aż 14,5% rozkładu t (w R:
2 * pt(-1.96, 3)).
| df | 1 | 2 | 3 | 4 | 10 | 30 | 100 | ∞ (rozkład normalny) |
|---|---|---|---|---|---|---|---|---|
| t kryt. | 12,706 | 4,303 | 3,182 | 2,776 | 2,228 | 2,042 | 1,984 | 1,960 |
Jak zinterpretować i opisać wynik?
Szeroki przedział [1,82; 8,18] mówi, że przy czterech osobach średnia długość snu w populacji jest oszacowana bardzo nieprecyzyjnie. To nie błąd obliczeń, tylko uczciwa informacja o małej próbie. W opisie zawsze podawaj stopnie swobody w nawiasie przy statystyce t, bo bez nich czytelnik nie sprawdzi wartości p. Rozkład t działa „pod maską” testów t, przedziałów ufności i regresji – jak wygląda to w gotowym opisie, zobaczysz w przykładowym raporcie testu t Studenta.
Zapis w stylu APA: Średni czas snu przed kolokwium wyniósł M = 5,00 h (SD = 2,00; n = 4); 95% CI [1,82; 8,18]. Przedział obliczono z rozkładu t z 3 stopniami swobody (tkryt = 3,182).
Jak odczytać rozkład t w R?
sen <- c(6, 2, 6, 6)                  # godziny snu 4 studentów
n  <- length(sen)
df <- n - 1                           # stopnie swobody: 3

# 1) „ręcznie”: przedział ufności 95% z rozkładu t
M  <- mean(sen)                       # 5
SE <- sd(sen) / sqrt(n)               # 2 / 2 = 1
t_kryt <- qt(0.975, df)               # wartość z tablic t: 3.182
t_kryt
M + c(-1, 1) * t_kryt * SE            # 1.82 do 8.18

# 2) gotowa funkcja – ten sam przedział
t.test(sen)$conf.int

# 3) porównanie z rozkładem normalnym
qnorm(0.975)                          # 1.96
qt(0.975, c(1, 3, 10, 30, 100))       # t kryt. maleje do 1.96
2 * pt(-1.96, df)                     # ryzyko błędu przy 1.96 i df = 3
Wynik w konsoli R:
> t_kryt
[1] 3.182446
> M + c(-1, 1) * t_kryt * SE
[1] 1.817554 8.182446
> t.test(sen)$conf.int
[1] 1.817554 8.182446
attr(,"conf.level")
[1] 0.95
> qnorm(0.975)
[1] 1.959964
> qt(0.975, c(1, 3, 10, 30, 100))
[1] 12.706205  3.182446  2.228139  2.042272  1.983972
> 2 * pt(-1.96, df)
[1] 0.1448522
Funkcja qt() zastępuje tablice (podajesz prawdopodobieństwo, dostajesz wartość t), a pt() działa odwrotnie i daje pole pod krzywą, z którego liczy się wartość p.
Najczęstsze błędy
- Używanie 1,96 przy małej próbie zamiast wartości krytycznej t – przedział wychodzi za wąski, a wyniki za często „istotne”.
- Odczytywanie z tablic kolumny jednostronnej, gdy test jest dwustronny (0,05 dwustronnie to 0,025 w każdym ogonie).
- Podawanie n zamiast df w zapisie wyniku, np. t(4) zamiast t(3) dla czterech osób.
- Przekonanie, że rozkład t „naprawia” dowolnie skośne dane – przy małych próbach nadal ważny jest kształt rozkładu.
- Liczenie df zawsze jako n − 1 – w teście dla dwóch grup jest to n₁ + n₂ − 2, a w teście Welcha wartość ułamkowa.
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Walker, H. M. (1940). Degrees of freedom. Journal of Educational Psychology, 31(4), 253–269.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówRozkład normalny
- Słownik wzorówCentralne twierdzenie graniczne
- Słownik wzorówRozkład F
- PoradnikWeryfikacja hipotez w pracy magisterskiej
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.