

Test Little’a (MCAR) – braki danych, wzór i przykład
Test Little’a sprawdza, czy braki danych są całkowicie przypadkowe (MCAR), czyli czy osoby, które nie odpowiedziały na jakieś pytanie, nie różnią się od pozostałych w tym, co o nich wiadomo. Typowe pytanie z pracy dyplomowej: część osób pominęła pytanie w ankiecie – czy mogę je po prostu usunąć z analizy?
W prostych słowachDzielisz osoby na grupy według tego, na które pytania odpowiedziały. Jeśli braki są czysto przypadkowe, średnie w tych grupach powinny być podobne do średnich w całej próbie. Test Little’a mierzy, jak bardzo się różnią, i zamienia to na jedną liczbę chi-kwadrat. Duża wartość oznacza, że braki „coś mówią” o osobach – i usuwanie ich może zafałszować wyniki.
MCAR, MAR i MNAR – trzy rodzaje braków
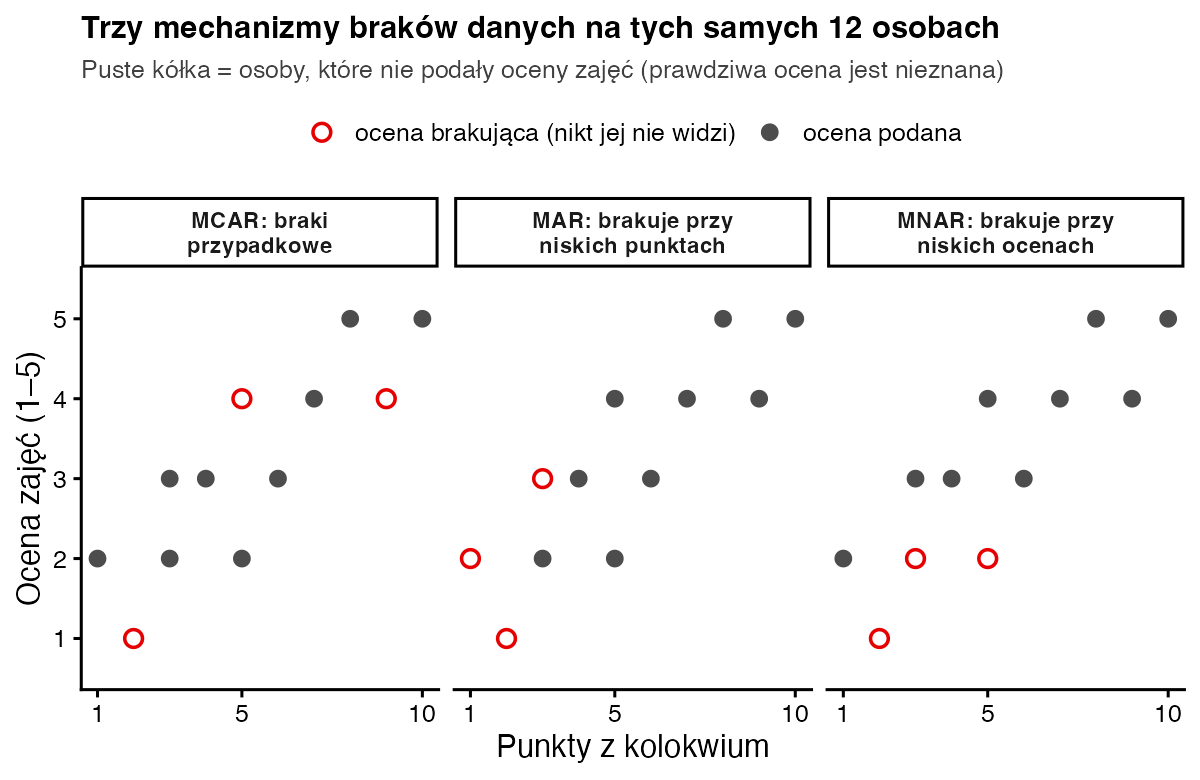
- MCAR (braki całkowicie losowe): brak nie zależy od niczego – ktoś przypadkiem przeskoczył stronę, ankieta urwała się przez awarię internetu. Usunięcie takich osób zmniejsza próbę, ale nie wypacza wyników.
- MAR (braki losowe warunkowo): brak zależy od innych zmiennych, które widzisz – np. słabsi studenci częściej pomijają ocenę zajęć. Usunięcie osób wypacza wyniki, ale metody takie jak imputacja wielokrotna potrafią to naprawić.
- MNAR (braki nielosowe): brak zależy od samej brakującej wartości – np. najbardziej niezadowoleni nie chcą wystawić oceny. Żaden test na danych tego nie wykryje; pomaga tylko wiedza o badaniu i analiza wrażliwości.
- Test Little’a odróżnia wyłącznie MCAR od „nie-MCAR”. Nie powie Ci, czy masz MAR, czy MNAR.
O tym, co zrobić z brakami, gdy MCAR nie jest spełnione, piszemy we wpisie braki danych i imputacja wielokrotna. Jeśli dane pochodzą z ankiety internetowej, zajrzyj też do wpisu dane z Formularzy Google do analizy.
Wzór na test Little’a
- \(j\)
- wzorzec braków – grupa osób, które odpowiedziały na ten sam zestaw pytań (np. „wszystko”, „wszystko poza oceną”)
- \(J\)
- liczba różnych wzorców braków
- \(n_j\)
- liczba osób z wzorcem j
- \(\bar{\mathbf{y}}_j\)
- średnie zmiennych, które osoby z wzorca j podały
- \(\hat{\boldsymbol{\mu}}_j\)
- średnie tych samych zmiennych oszacowane na całej próbie metodą największej wiarygodności (algorytmem EM), z uwzględnieniem braków
- \(\hat{\boldsymbol{\Sigma}}_j\)
- macierz kowariancji tych zmiennych z tego samego oszacowania; jej odwrotność „przelicza” różnice na jednostki odchylenia standardowego
- \(p_j,\ p\)
- liczba zmiennych obserwowanych we wzorcu j i liczba wszystkich zmiennych
- \(d^2\)
- statystyka testu; przy MCAR ma w przybliżeniu rozkład chi-kwadrat z df stopniami swobody
Na głos: „dla każdego wzorca braków liczymy, jak daleko jego średnie leżą od średnich całej próby, w jednostkach rozrzutu, mnożymy przez liczbę osób i sumujemy”.
Przykład krok po kroku
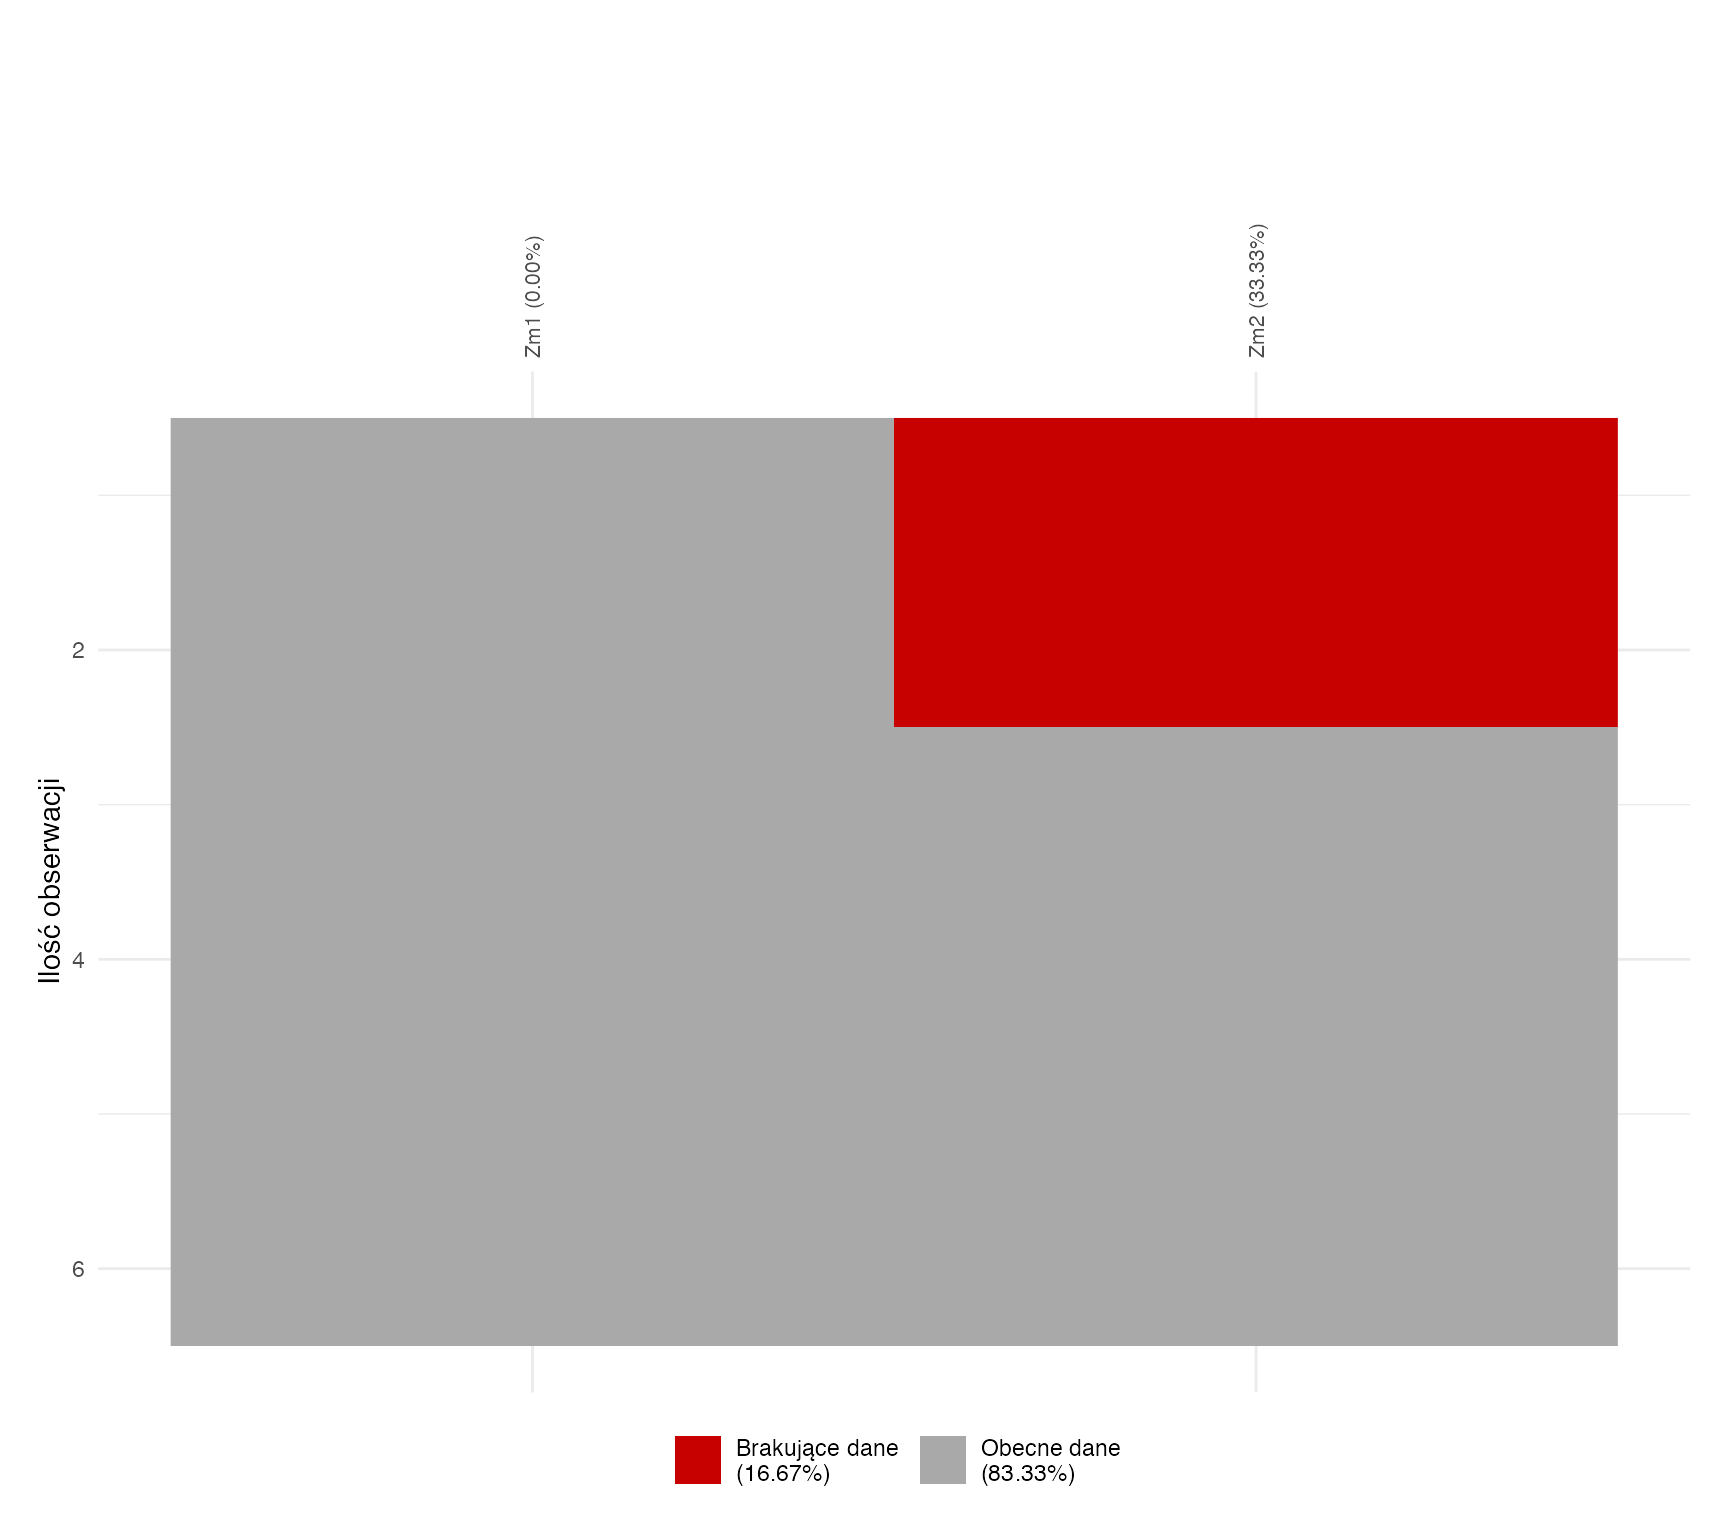
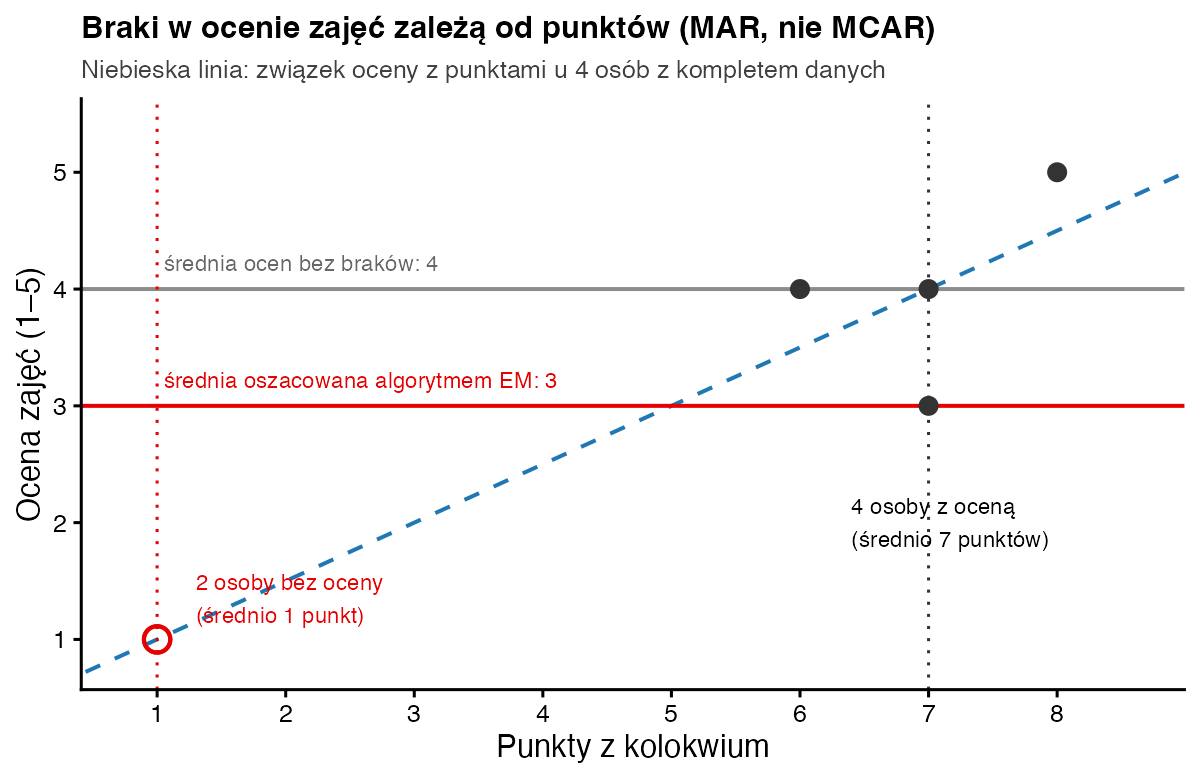
Sześcioro studentów podało punkty z kolokwium: 1, 1, 6, 7, 7, 8. Ocenę zajęć (1–5) podały tylko cztery osoby – te z 6, 7, 7 i 8 punktami wystawiły 4, 4, 3 i 5. Dwie osoby z 1 punktem nie oceniły zajęć. Mamy więc dwa wzorce: A – komplet danych (4 osoby), B – tylko punkty (2 osoby).
| Wzorzec | n | Średnie obserwowane | Średnie z całej próby | Różnice | Forma kwadratowa | n · forma |
|---|---|---|---|---|---|---|
| A: punkty i ocena | 4 | 28 / 4 = 7; 16 / 4 = 4 | 5; 3 | 7 − 5 = 2; 4 − 3 = 1 | 1,5 / 3,125 = 0,48 | 4 · 0,48 = 1,92 |
| B: tylko punkty | 2 | 2 / 2 = 1 | 5 | 1 − 5 = −4 | (−4)² / 8,333 = 16 / 8,333 = 1,92 | 2 · 1,92 = 3,84 |
| Σ | 6 | d² = 5,76 |
- Średnia i wariancja punktów. Punkty zna każdy, więc ich średnia to 30 / 6 = 5. Odchylenia od 5: −4, −4, 1, 2, 2, 3; kwadraty 16, 16, 1, 4, 4, 9; suma 50. Wariancja największej wiarygodności dzieli przez n, a nie n − 1: 50 / 6 = 8,333.
- Związek oceny z punktami u osób z kompletem. Średnie: punkty 28 / 4 = 7, ocena 16 / 4 = 4. Iloczyny odchyleń: (−1) · 0 + 0 · 0 + 0 · (−1) + 1 · 1 = 1. Kwadraty odchyleń punktów: 1 + 0 + 0 + 1 = 2. Nachylenie b = 1 / 2 = 0,5 – każdy punkt więcej to średnio pół oceny wyżej.
- Oszacowana średnia oceny. Algorytm EM „dopowiada”, że osoby z niższymi punktami oceniałyby niżej: 4 + 0,5 · (5 − 7) = 4 − 1 = 3. Średnia z samych odpowiedzi (4) jest więc zawyżona.
- Kowariancje. Kowariancja punktów i oceny: 0,5 · 8,333 = 4,167. Reszty oceny wokół linii u czterech osób: 0,5; 0; −1; 0,5; suma kwadratów 1,5; podzielona przez 4: 0,375. Wariancja oceny: 0,375 + 0,5² · 8,333 = 0,375 + 2,083 = 2,458.
- Wzorzec B. Osoby bez oceny mają średnio 1 punkt. Różnica 1 − 5 = −4; do kwadratu 16; dzielona przez wariancję 8,333 daje 1,92; razy 2 osoby: 3,84.
- Wzorzec A. Różnice (2; 1). Dla dwóch zmiennych forma kwadratowa to (wariancja oceny · 2² − 2 · kowariancja · 2 · 1 + wariancja punktów · 1²) / (wariancja punktów · wariancja oceny − kowariancja²) = (2,458 · 4 − 2 · 4,167 · 2 + 8,333) / (8,333 · 2,458 − 4,167²) = (9,833 − 16,667 + 8,333) / (20,486 − 17,361) = 1,5 / 3,125 = 0,48. Razy 4 osoby: 1,92.
- Statystyka i stopnie swobody. d² = 3,84 + 1,92 = 5,76. We wzorcu A obserwujemy 2 zmienne, w B – 1, wszystkich zmiennych jest 2: df = (2 + 1) − 2 = 1.
- Wartość p. W tablicy rozkładu chi-kwadrat dla df = 1 wartość krytyczna (α = 0,05) wynosi 3,841 (w R:
qchisq(0.95, 1)). Nasze 5,76 ją przekracza. Dokładnie: p = 0,016 (pchisq(5.76, 1, lower.tail = FALSE)).
Jak zinterpretować i opisać wynik?
Gdyby braki były całkowicie przypadkowe, tak duże lub większe d² zdarzałoby się tylko w około 1,6% podobnych badań. Odrzucamy więc hipotezę MCAR: osoby bez oceny różnią się od pozostałych punktami. Usunięcie ich z analizy zawyżyłoby średnią ocenę zajęć. Wynik nieistotny nie dowodziłby z kolei, że braki są MCAR – przy małej próbie test ma małą moc, a MNAR jest dla niego niewidoczny.
Zapis w stylu APA: Test Little’a wykazał, że braki danych nie są całkowicie losowe, χ²(1) = 5,76; p = 0,016. Osoby, które nie oceniły zajęć, uzyskały mniej punktów z kolokwium (M = 1,00) niż osoby, które je oceniły (M = 7,00), dlatego zamiast usuwania obserwacji z brakami zastosowano imputację wielokrotną.
Jak policzyć test Little’a w R?
dane <- data.frame(punkty = c(1, 1, 6, 7, 7, 8),
                   ocena  = c(NA, NA, 4, 4, 3, 5))      # ocena zajęć 1–5, dwie osoby nie odpowiedziały

# 1) „ręcznie”: oszacowania ML (jak w algorytmie EM) i statystyka d² Little’a
x <- dane$punkty; kc <- complete.cases(dane); n <- nrow(dane)
b <- unname(coef(lm(ocena ~ punkty, dane[kc, ]))[2])            # nachylenie u osób z kompletem
mu <- c(mean(x), mean(dane$ocena[kc]) + b * (mean(x) - mean(x[kc])))
sxx <- sum((x - mean(x))^2) / n                            # wariancja ML (dzielona przez n)
res <- sum(resid(lm(ocena ~ punkty, dane[kc, ]))^2) / sum(kc)
S <- matrix(c(sxx, b * sxx, b * sxx, res + b^2 * sxx), 2)  # macierz kowariancji ML
dA <- colMeans(dane[kc, ]) - mu                            # wzorzec A: komplet danych
dB <- mean(x[!kc]) - mu[1]                                 # wzorzec B: tylko punkty
d2 <- sum(kc) * t(dA) %*% solve(S) %*% dA + sum(!kc) * dB^2 / S[1, 1]
round(c(mu_punkty = mu[1], mu_ocena = mu[2], d2 = d2, df = (2 + 1) - 2, p = pchisq(d2, 1, lower.tail = FALSE)), 3)

# 2) gotowa funkcja (pakiet naniar)
naniar::mcar_test(dane)
Wynik w konsoli R:
mu_punkty  mu_ocena        d2        df         p
    5.000     3.000     5.760     1.000     0.016
# A tibble: 1 × 4
  statistic    df p.value missing.patterns
      <dbl> <dbl>   <dbl>            <int>
1      5.76     1  0.0164                2
Rachunek „ręczny” i funkcja mcar_test() z pakietu naniar dają to samo: d² = 5,76; df = 1; p = 0,016. Funkcja sama szacuje średnie i kowariancje algorytmem EM, więc działa przy dowolnej liczbie zmiennych i wzorców.
Braki danych w ankiecie – kiedy w ogóle liczyć test Little’a?
Gdy braków jest bardzo mało (np. pojedyncze komórki na kilkaset osób), sposób ich potraktowania zwykle nie zmienia wniosków. Test warto policzyć, gdy w którejś zmiennej brakuje kilku procent odpowiedzi lub więcej i zastanawiasz się, czy usunąć te osoby. W pracy podaj najpierw procent braków w każdej zmiennej, potem wynik testu Little’a, a na końcu to, co z brakami zrobiłeś. Pamiętaj, że test zakłada w przybliżeniu normalny rozkład zmiennych ilościowych, a przy wielu wzorcach z pojedynczymi osobami jego przybliżenie chi-kwadrat jest słabe. Więcej o porządkowaniu danych z ankiet znajdziesz we wpisie opracowanie wyników ankiety.
Najczęstsze błędy
- Pisanie „braki są MCAR”, bo p > 0,05. Poprawnie: „brak podstaw do odrzucenia hipotezy, że braki są całkowicie losowe”.
- Traktowanie testu jako sposobu na wykrycie MNAR. Test porównuje tylko to, co zaobserwowano.
- Automatyczne usuwanie osób z brakami po istotnym wyniku testu – to właśnie wtedy usuwanie jest najgroźniejsze.
- Liczenie testu na zmiennych tekstowych lub kodach odpowiedzi „nie wiem” traktowanych jak liczby.
- Podawanie samego p bez informacji, ile było braków i w których zmiennych.
Bibliografia
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Enders, C. K. (2010). Applied missing data analysis. Guilford Press.
- van Buuren, S. (2018). Flexible imputation of missing data (2nd ed.). CRC Press.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówCzęstości i procenty
- Słownik wzorówBootstrap
- Słownik wzorówRozkład chi-kwadrat
- PoradnikTesty parametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.