

Braki danych i imputacja wielokrotna – poradnik z przykładem w R
Prawie każdy zbiór danych z badania ma luki: ktoś pominął pytanie, nie przyszedł na drugi pomiar albo przerwał ankietę. Pokazujemy, jak rozpoznać mechanizm braków (MCAR, MAR, MNAR), czym grozi usuwanie wierszy i wstawianie średniej, jak działa imputacja wielokrotna w pakiecie mice i jak połączyć wyniki regułami Rubina krok po kroku. Na końcu dostajesz gotowy akapit do sekcji metod.
W skrócieOpisz, ile i gdzie brakuje danych → sprawdź, z czym braki się wiążą → nie wstawiaj średniej → przy brakach typu MAR zrób imputację wielokrotną (m zbiorów), tę samą analizę w każdym zbiorze i połącz wyniki regułami Rubina → w metodach podaj program, model imputacji, m i ziarno losowania.
Krok 1. Opisz braki i zastanów się nad ich mechanizmem
Rubin (1976) wyróżnił trzy mechanizmy braków. Nie da się ich w pełni rozstrzygnąć testem – to przede wszystkim argument merytoryczny o tym, dlaczego ktoś nie odpowiedział.
| Mechanizm | Co oznacza | Przykład | Usuwanie listwise | Imputacja wielokrotna |
|---|---|---|---|---|
| MCAR – całkowicie losowe | brak nie zależy od niczego w danych | ankieta zgubiona przy skanowaniu | bez obciążenia, ale mniejsza moc | bez obciążenia, lepsza moc |
| MAR – losowe warunkowo | brak zależy od zmiennych, które masz | osoby z wysokim stresem częściej pomijają skalę wypalenia | zwykle obciążone wyniki | właściwa metoda, jeśli te zmienne są w modelu imputacji |
| MNAR – nielosowe | brak zależy od samej brakującej wartości | najbardziej wypaleni nie odpowiadają, bo są wypaleni | obciążone | też może być obciążona – potrzebna analiza wrażliwości |
Nasz przykład to te same dane 12 pracowników co we wpisie o moderacji i prostych nachyleniach, ale w wypaleniu brakuje 3 wyników (25%). Mapę braków z modułu eksploracji SZTOS pokazuje rysunek 1, a cały raport takiego modułu – przykładowy raport z eksploracji danych.
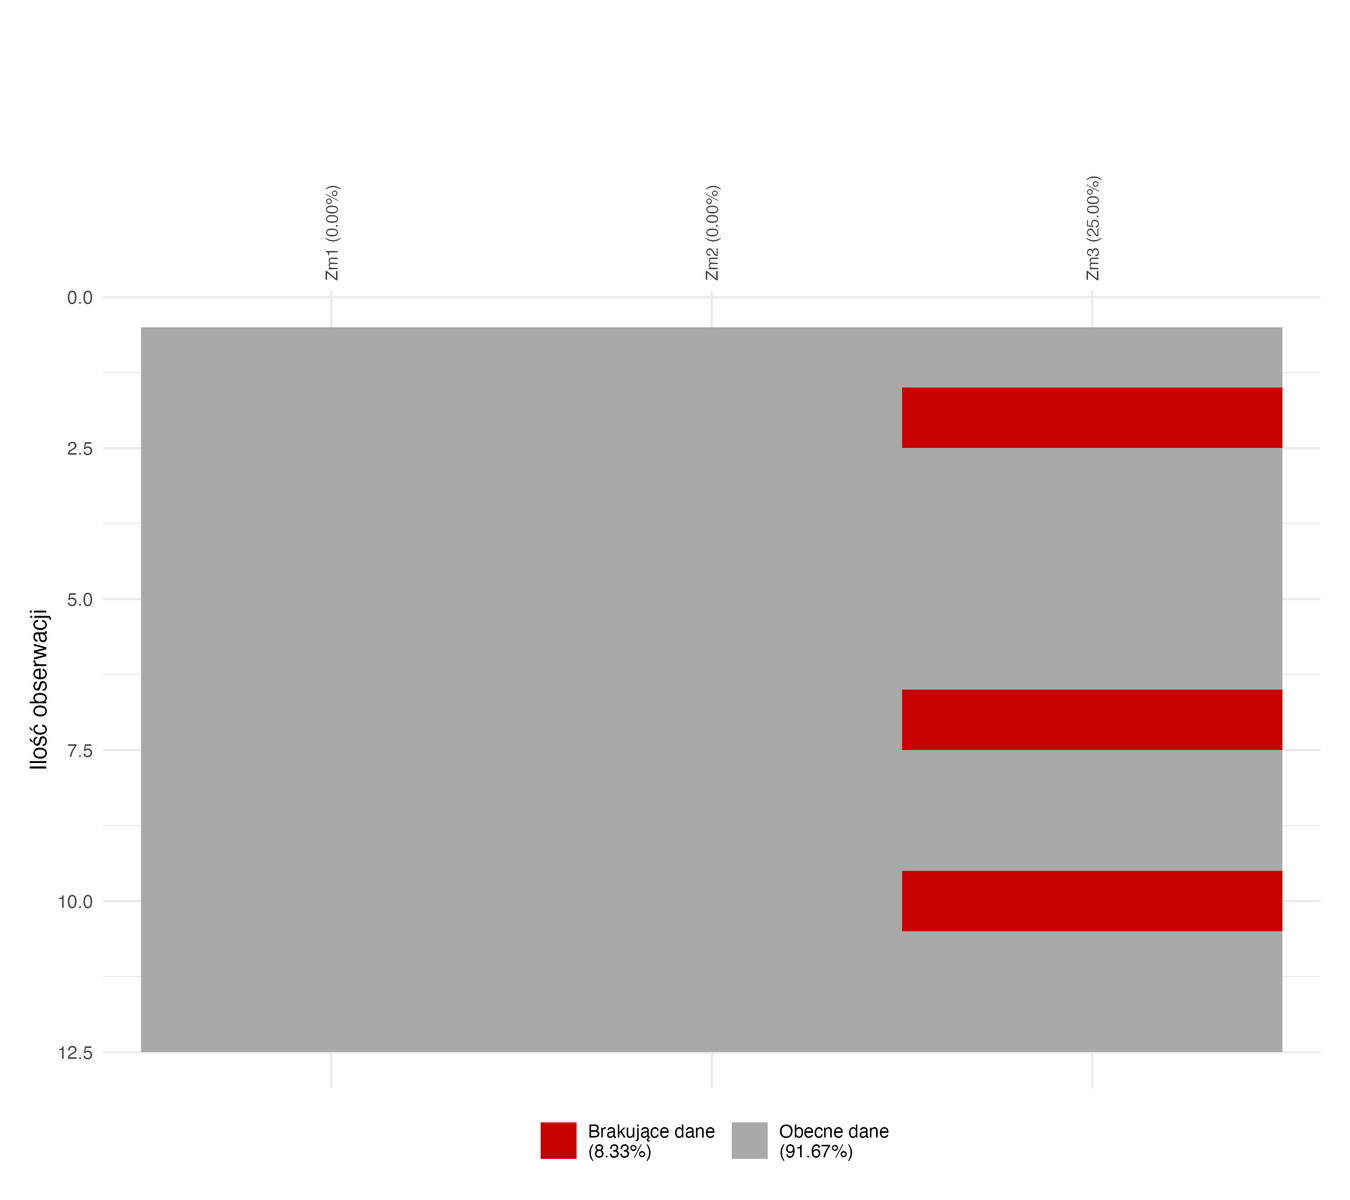
Teraz sprawdź, z czym braki się wiążą. Osoby bez wyniku wypalenia mają średnio 6,33 punktu stresu, a pozostałe 3,22. Test MCAR Little'a daje χ²(2) = 5,94; p = 0,051 – brak podstaw do odrzucenia hipotezy MCAR, ale przy 12 osobach test ma bardzo małą moc (więcej w haśle test MCAR Little'a). Różnica w stresie jest duża, więc rozsądniej przyjąć MAR: braki zależą od stresu, który mamy w danych.
Krok 2. Porównaj trzy podejścia na tych samych danych
W tym przykładzie znamy prawdziwe wyniki osób 2, 7 i 10 (19, 18 i 9 punktów), bo braki usunęliśmy celowo. Dzięki temu widać, które podejście jest bliżej prawdy.
| Podejście | n | M wypalenia | SD | b dla stresu (SE) | Co się dzieje |
|---|---|---|---|---|---|
| pełne dane (punkt odniesienia) | 12 | 12,00 | 4,24 | 1,45 (0,49) | w praktyce nieznane |
| usuwanie listwise | 9 | 10,89 | 3,41 | 1,40 (0,58) | średnia zaniżona, mniej osób i większy SE |
| imputacja średnią | 12 | 10,89 | 2,91 | 0,69 (0,40) | zaniżone SD i b, sztucznie mały SE |
| imputacja wielokrotna (m = 3) | 12 | 12,03 | – | 1,41 (0,49) | średnia bliska prawdy, uczciwy SE |
- Usuwanie listwise zaniżyło średnią, bo zniknęły osoby z wysokim stresem, a więc i z wysokim wypaleniem. Współczynnik b wyszedł bliski prawdy – to typowe, gdy braki zależą tylko od predyktora – ale jest mniej precyzyjny.
- Imputacja średnią to najgorszy wybór: wstawia trzy razy 10,89, więc odchylenie standardowe spada, związek ze stresem słabnie o połowę, a błąd standardowy udaje, że mamy 12 pełnych obserwacji.
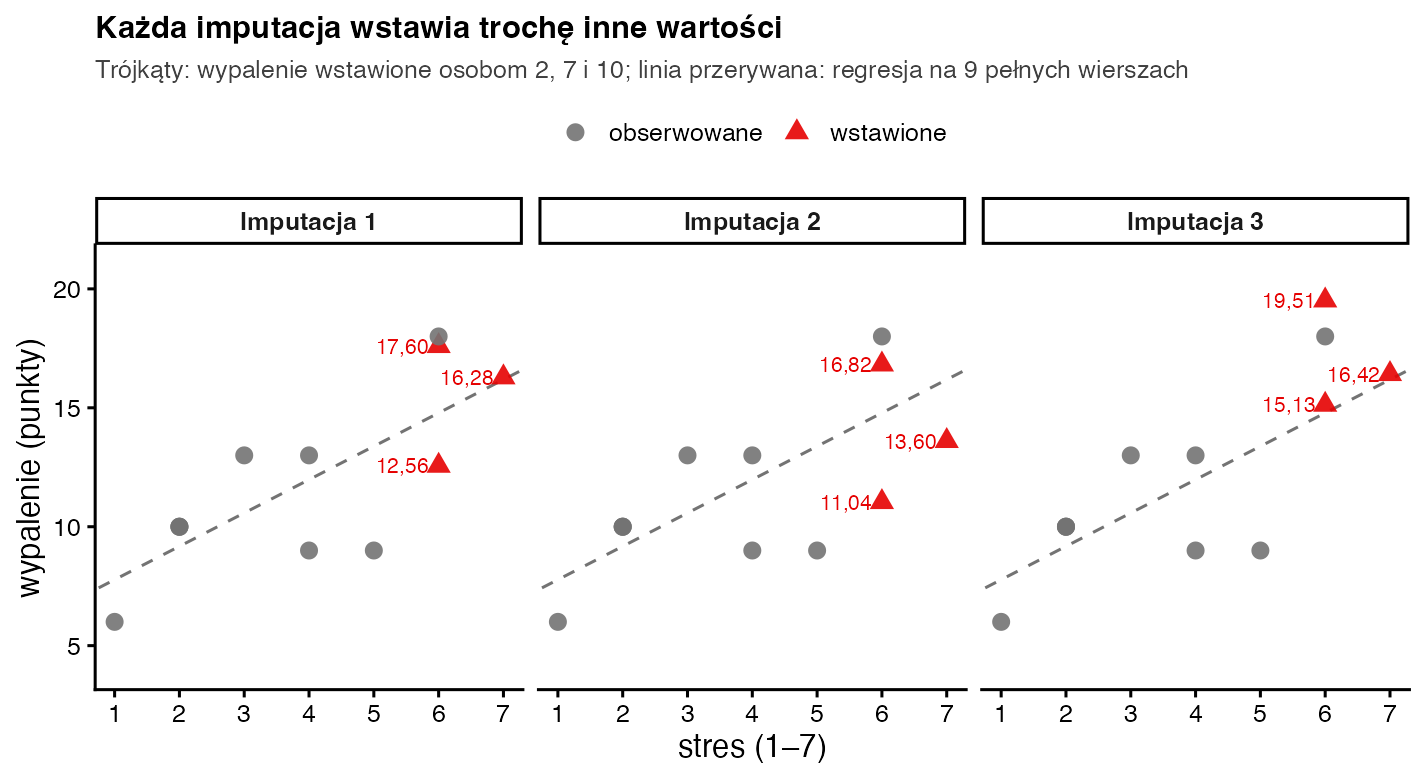
- Imputacja wielokrotna przewiduje braki z innych zmiennych (stresu i wsparcia), dodaje losowy szum i robi to kilka razy, więc niepewność zostaje w wyniku.
Krok 3. Imputacja wielokrotna w mice
Pakiet mice (van Buuren i Groothuis-Oudshoorn, 2011) tworzy m kompletnych zbiorów. Do nauki wystarczą 3, w badaniu stosuj co najmniej tyle imputacji, ile wynosi odsetek niepełnych przypadków (White i in., 2011), tu więc m ≥ 25. Użyliśmy metody „norm” (bayesowska regresja liniowa), bo przy 12 osobach domyślne dopasowanie średniej predykcyjnej (pmm) ma za mało dawców. W modelu imputacji umieść wszystkie zmienne z analizy, także zmienną zależną, oraz zmienne pomocnicze związane z brakami.
Krok 4. Reguły Rubina krok po kroku
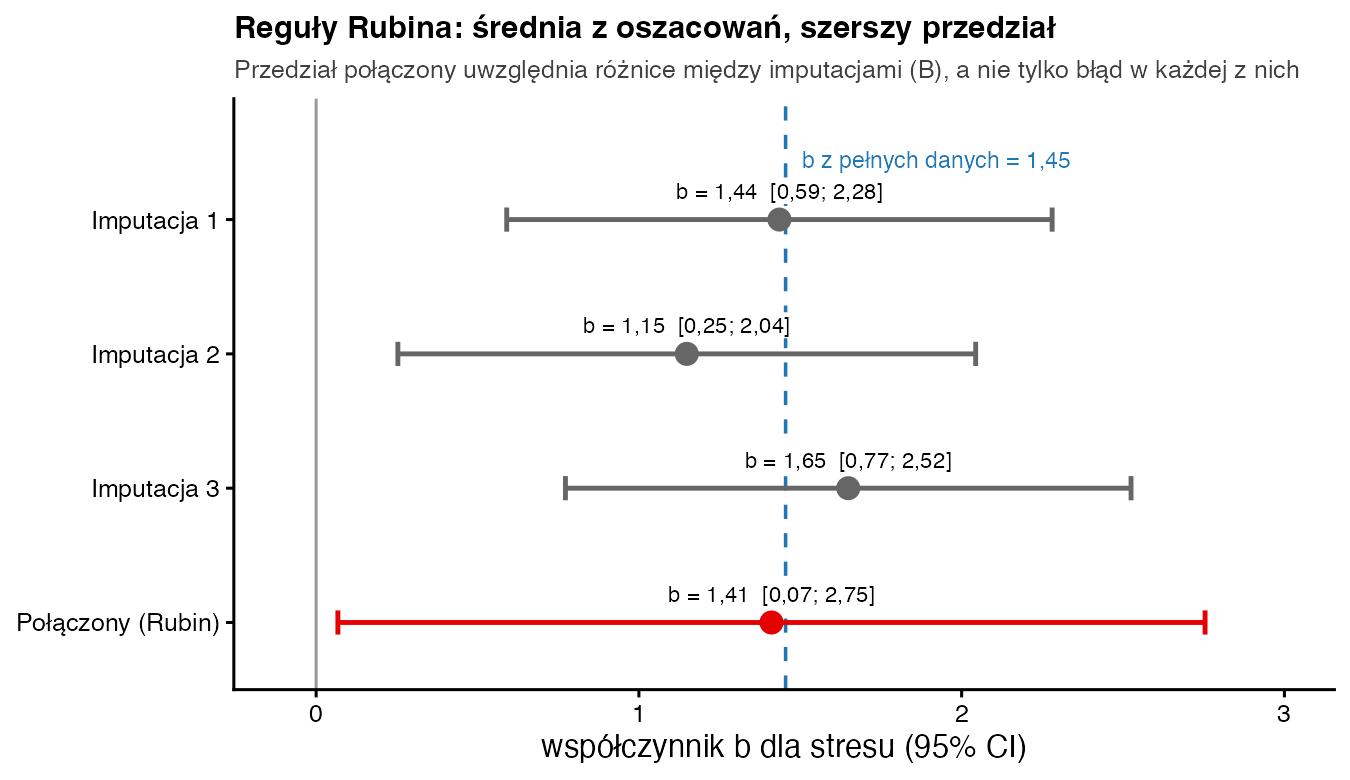
W każdym z trzech zbiorów liczysz tę samą regresję wypalenia na stres. Dostajesz trzy oszacowania b i trzy błędy standardowe. Reguły Rubina (1987) łączą je w jeden wynik. Kwadraty i ich sumy liczymy na wartościach niezaokrąglonych, dlatego podajemy je z czterema miejscami po przecinku.
| Imputacja | b (Q) | SE | U = SE² | (Q − Q̄)² |
|---|---|---|---|---|
| 1 | 1,435 | 0,379 | 0,1438 | 0,0006 |
| 2 | 1,148 | 0,402 | 0,1614 | 0,0689 |
| 3 | 1,649 | 0,393 | 0,1546 | 0,0566 |
| Σ | 4,232 | – | 0,4598 | 0,1261 |
- Wynik połączony to średnia oszacowań: Q̄ = 4,232 / 3 = 1,411.
- Wariancja wewnątrz imputacji to średnia kwadratów SE: Ū = 0,4598 / 3 = 0,1533.
- Wariancja między imputacjami to zwykła wariancja z próby trzech oszacowań: B = 0,1261 / (3 − 1) = 0,063.
- Wariancja całkowita: T = Ū + (1 + 1/m) · B = 0,1533 + 1,3333 · 0,063 = 0,1533 + 0,0840 = 0,2373. Czynnik 1 + 1/m karze za to, że imputacji jest skończenie wiele.
- Błąd standardowy: SE = √0,2373 = 0,487, a statystyka t = 1,411 / 0,487 = 2,90.
- Stopnie swobody: mice stosuje poprawkę dla małych prób (Barnard i Rubin, 1999) i daje df = 4,07, więc p = 0,043 i 95% CI [0,07; 2,75]. Część wariancji wynikająca z braków to λ = 0,0840 / 0,2373 = 0,35.
Tak samo połączona średnia wypalenia wynosi 12,03, wobec 12,00 w pełnych danych i 10,89 po usunięciu braków. Jeden wzór działa dla każdego parametru, który ma oszacowanie i SE: średniej, b w regresji, różnicy średnich. Korelacje łączy się po transformacji Fishera.
Cała analiza w R
suppressPackageStartupMessages(library(mice))
# 12 pracowników; w wypaleniu brakuje 3 wyników (osoby 2, 7 i 10)
dane <- data.frame(stres     = c(2, 6, 2, 6, 3, 4, 7, 1, 5, 6, 4, 2),
                   wsparcie  = c(1, 2, 2, 2, 3, 4, 4, 5, 6, 6, 6, 7),
                   wypalenie = c(10, NA, 10, 18, 13, 13, NA, 6, 9, NA, 9, 10))

# 1) ile braków i czy wiążą się z innymi zmiennymi
colSums(is.na(dane))
tapply(dane$stres, is.na(dane$wypalenie), mean)   # FALSE = jest wynik, TRUE = brak
naniar::mcar_test(dane)                             # test MCAR Little'a

# 2) usuwanie listwise (domyślne w lm) i imputacja średnią
round(coef(summary(lm(wypalenie ~ stres, data = dane)))[2, 1:2], 3)
d_sr <- dane
d_sr$wypalenie[is.na(d_sr$wypalenie)] <- mean(dane$wypalenie, na.rm = TRUE)
round(c(SD = sd(d_sr$wypalenie), coef(summary(lm(wypalenie ~ stres, data = d_sr)))[2, 1:2]), 3)

# 3) imputacja wielokrotna: 3 zbiory (do nauki; w badaniu m = 20 lub więcej)
imp <- mice(dane, m = 3, method = "norm", seed = 29, printFlag = FALSE)
round(imp$imp$wypalenie, 2)                         # wstawione wartości w 3 zbiorach
fit <- with(imp, lm(wypalenie ~ stres))             # ta sama analiza w każdym zbiorze

# 4) reguły Rubina ręcznie dla współczynnika b stresu
Q <- sapply(fit$analyses, function(m) coef(m)[2])         # 3 oszacowania b
U <- sapply(fit$analyses, function(m) vcov(m)[2, 2])      # 3 wariancje (SE²)
m <- 3; Qbar <- mean(Q); Ubar <- mean(U); B <- var(Q)
Tv <- Ubar + (1 + 1 / m) * B                              # wariancja całkowita
round(c(Q, Qbar = Qbar, Ubar = Ubar, B = B, T = Tv, SE = sqrt(Tv)), 3)

# 5) to samo funkcją pool() (df z poprawką Barnarda-Rubina) i średnia wypalenia
summary(pool(fit), conf.int = TRUE)[2, ]
summary(pool(with(imp, lm(wypalenie ~ 1))))[, 1:3]
Wynik w konsoli R:
    stres  wsparcie wypalenie
        0         0         3
   FALSE     TRUE
3.222222 6.333333
# A tibble: 1 × 4
  statistic    df p.value missing.patterns
      <dbl> <dbl>   <dbl>            <int>
1      5.94     2  0.0513                2
  Estimate Std. Error
     1.402      0.579
        SD   Estimate Std. Error
     2.906      0.687      0.405
       1     2     3
2  17.60 16.82 19.51
7  16.28 13.60 16.42
10 12.56 11.04 15.13
stres stres stres  Qbar  Ubar     B     T    SE
1.435 1.148 1.649 1.411 0.153 0.063 0.237 0.487
   term estimate std.error statistic       df    p.value      2.5 %
2 stres 1.410795 0.4871535  2.895998 4.070244 0.04337732 0.06739673
    97.5 %   conf.low conf.high
2 2.754194 0.06739673  2.754194
         term estimate std.error
1 (Intercept) 12.02671  1.183967
Krok 5. Jak opisać braki i imputację w metodach?
Gotowy akapit do sekcji metod: Braki danych dotyczyły wyłącznie skali wypalenia (3 z 12 osób, 25%). Osoby z brakami miały wyższy poziom stresu (M = 6,33 wobec M = 3,22), dlatego przyjęto założenie o brakach losowych warunkowo (MAR), mimo nieistotnego wyniku testu MCAR Little'a, χ²(2) = 5,94; p = 0,051. Zastosowano imputację wielokrotną metodą łańcuchowych równań (pakiet mice 3.19.0 w R; metoda norm; m = 3; ziarno 29), z modelem imputacji obejmującym stres, wsparcie i wypalenie. Analizy przeprowadzono w każdym zbiorze, a wyniki połączono regułami Rubina ze stopniami swobody Barnarda i Rubina. Wyższy stres wiązał się z wyższym wypaleniem, b = 1,41; SE = 0,49; 95% CI [0,07; 2,75]; t(4,07) = 2,90; p = 0,043.
W artykule dodaj tabelę liczby braków dla każdej zmiennej i porównanie wyników z analizą przypadków kompletnych jako analizę wrażliwości. Gdzie umieścić te informacje, opisuje poradnik sekcja „Analiza statystyczna” w artykule.
Checklista
- Podany odsetek braków dla każdej zmiennej i liczba osób z pełnymi danymi.
- Uzasadniony mechanizm braków: porównanie osób z brakami i bez, test Little'a jako uzupełnienie, nie dowód.
- Żadnej imputacji średnią ani „ostatniej obserwacji” bez mocnego uzasadnienia.
- Model imputacji zawiera zmienną zależną, wszystkie predyktory, interakcje z analizy i zmienne pomocnicze.
- Podane: program i wersja, metoda, m, ziarno, sposób łączenia wyników i analiza wrażliwości.
Pytania, które zadają recenzenci
Ile procent braków danych to za dużo?
Nie ma jednego progu. Ważniejszy od odsetka jest mechanizm braków i to, czy masz zmienne, które go wyjaśniają. Przy kilkudziesięciu procentach braków w kluczowej zmiennej wyniki zależą głównie od modelu imputacji – napisz to wprost i pokaż analizę wrażliwości. Jak odpowiedzieć na taką uwagę, opisuje wpis jak odpowiedzieć na recenzję statystyczną.
Czy mogę zrobić imputację tylko raz?
Pojedyncza imputacja, nawet z modelu regresji, traktuje wstawione wartości jak prawdziwe i zaniża błędy standardowe. Właśnie dlatego imputacji jest kilka, a reguły Rubina dodają wariancję między nimi.
Czy imputacja „wymyśla” dane?
Nie tworzy nowych informacji – wykorzystuje związki między zmiennymi, które już masz, i jawnie pokazuje niepewność. Przy brakach MNAR żadna standardowa metoda nie daje gwarancji, dlatego opisz założenie i jego ograniczenia.
Bibliografia
- Barnard, J., & Rubin, D. B. (1999). Small-sample degrees of freedom with multiple imputation. Biometrika, 86(4), 948–955. https://doi.org/10.1093/biomet/86.4.948
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202.
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592.
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. Wiley.
- van Buuren, S. (2018). Flexible imputation of missing data (2nd ed.). CRC Press.
- van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- White, I. R., Royston, P., & Wood, A. M. (2011). Multiple imputation using chained equations: Issues and guidance for practice. Statistics in Medicine, 30(4), 377–399. https://doi.org/10.1002/sim.4067
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Little’a (MCAR)
- Poradnikprzykladowe-raporty/eksploracja-danych.html
- Słownik wzorówBootstrap
- PoradnikSekcja „Analiza statystyczna” w artykule – jak napisać
- PoradnikJak odpowiedzieć na recenzję statystyczną
- Przykładowy raportOpis próby
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.