

Brak normalności rozkładu – co robić? Drzewko decyzji i przykład
Test Shapiro-Wilka wyszedł istotny i nie wiesz, czy wolno Ci jeszcze użyć testu t albo ANOVA? Ten poradnik pokazuje pięć rozsądnych dróg wyjścia, liczy jeden przykład ze skośnymi danymi trzema sposobami i podaje gotowe zdania do pracy.
W skrócieNajpierw sprawdź, czy problem w ogóle istnieje: normalność dotyczy reszt lub wyników w grupach, a nie całej zmiennej. Jeśli istnieje, wybierz drogę zależnie od liczby osób i rodzaju danych: duża próba i centralne twierdzenie graniczne, test nieparametryczny, logarytm, bootstrap albo test Welcha. Wybór opisz w metodzie i trzymaj się go – nie zmieniaj testu po zobaczeniu wyniku.
Krok 1. Upewnij się, że problem naprawdę jest
Zanim cokolwiek zmienisz, sprawdź trzy rzeczy. Po pierwsze, czy oceniałeś właściwy obiekt: reszty modelu albo każdą grupę osobno, a nie wszystkie wyniki wrzucone razem. Po drugie, czy wykres kwantyl-kwantyl potwierdza to, co mówi test. Po trzecie, ile masz osób. Przy kilkuset osobach test Shapiro-Wilka „łapie” drobne odchylenia, które testowi t nie szkodzą. Jak to wszystko zrobić krok po kroku, pokazujemy we wpisie jak sprawdzić normalność rozkładu.
Krok 2. Wybierz drogę – drzewko decyzji
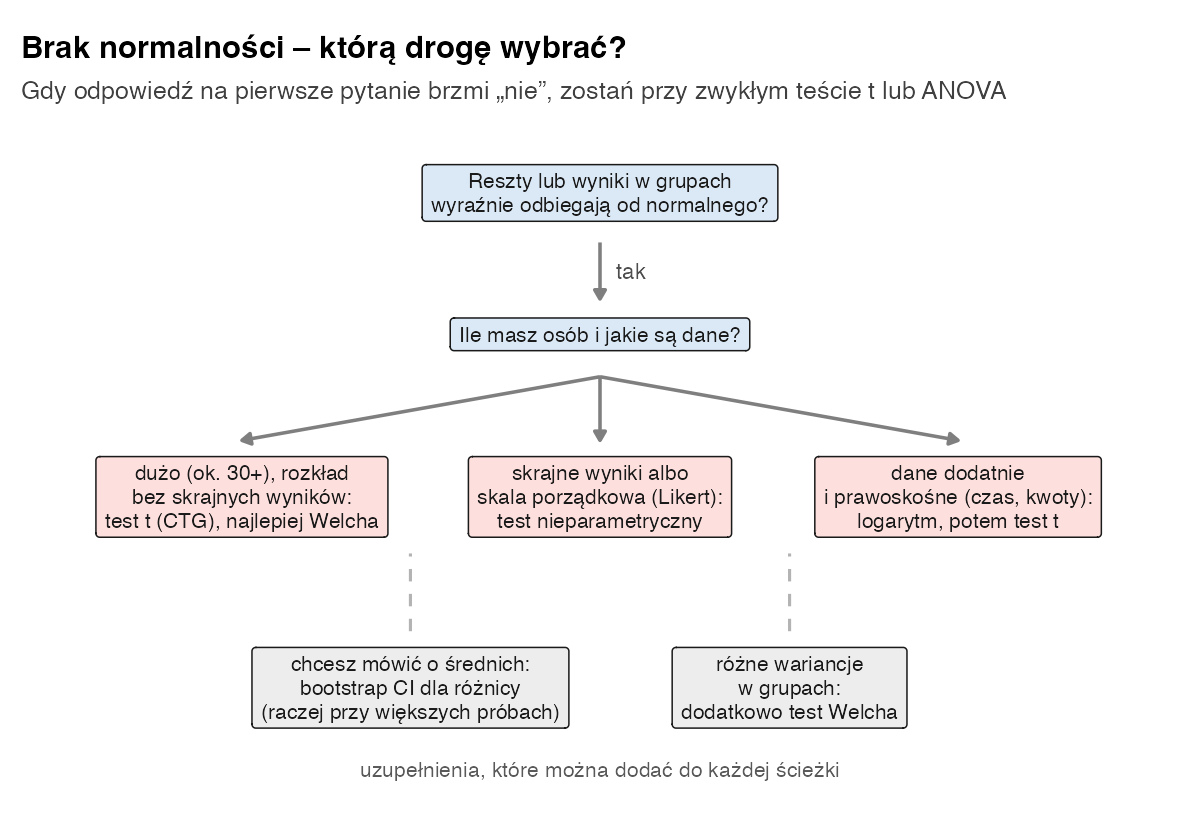
| Sytuacja | Co zrobić | Co porównujesz |
|---|---|---|
| Kilkadziesiąt osób w grupie, brak skrajnych wyników | zostań przy teście t (najlepiej Welcha) lub ANOVA; uzasadnij centralnym twierdzeniem granicznym | średnie |
| Mała próba, skrajne wyniki, skala porządkowa | test U Manna-Whitneya, Wilcoxona, Kruskala-Wallisa – przegląd w artykule testy nieparametryczne | rangi (czy wyniki jednej grupy są zwykle wyższe) |
| Dane dodatnie, długi prawy ogon (czas, dochód, liczba zdarzeń) | logarytm, potem zwykły test t | średnie geometryczne (wynik jako „ile razy więcej”) |
| Chcesz mówić o różnicy średnich, a rozkład jest nietypowy | przedział ufności z bootstrapu | średnie |
| Wariancje w grupach wyraźnie się różnią | test t Welcha lub ANOVA Welcha | średnie |
Zwróć uwagę na trzecią kolumnę. Każda droga odpowiada na trochę inne pytanie, więc wyniki mogą się różnić. Test nieparametryczny nie jest „testem median” – porównuje rangi, a o medianach mówi tylko wtedy, gdy rozkłady w grupach mają podobny kształt.
Krok 3. Przykład: skośne dane policzone trzema sposobami
Szesnastu studentów losowo podzielono na dwie grupy po 8 osób. Jedna grupa dostawała w aplikacji do nauki słówek codzienne przypomnienia, druga nie. Mierzymy liczbę minut dziennie spędzonych w aplikacji. Czas ma typowy długi prawy ogon: większość osób spędza kilka–kilkanaście minut, a pojedyncze osoby dużo więcej.
| Grupa | Wyniki 8 osób | M | SD | Me | Shapiro-Wilk |
|---|---|---|---|---|---|
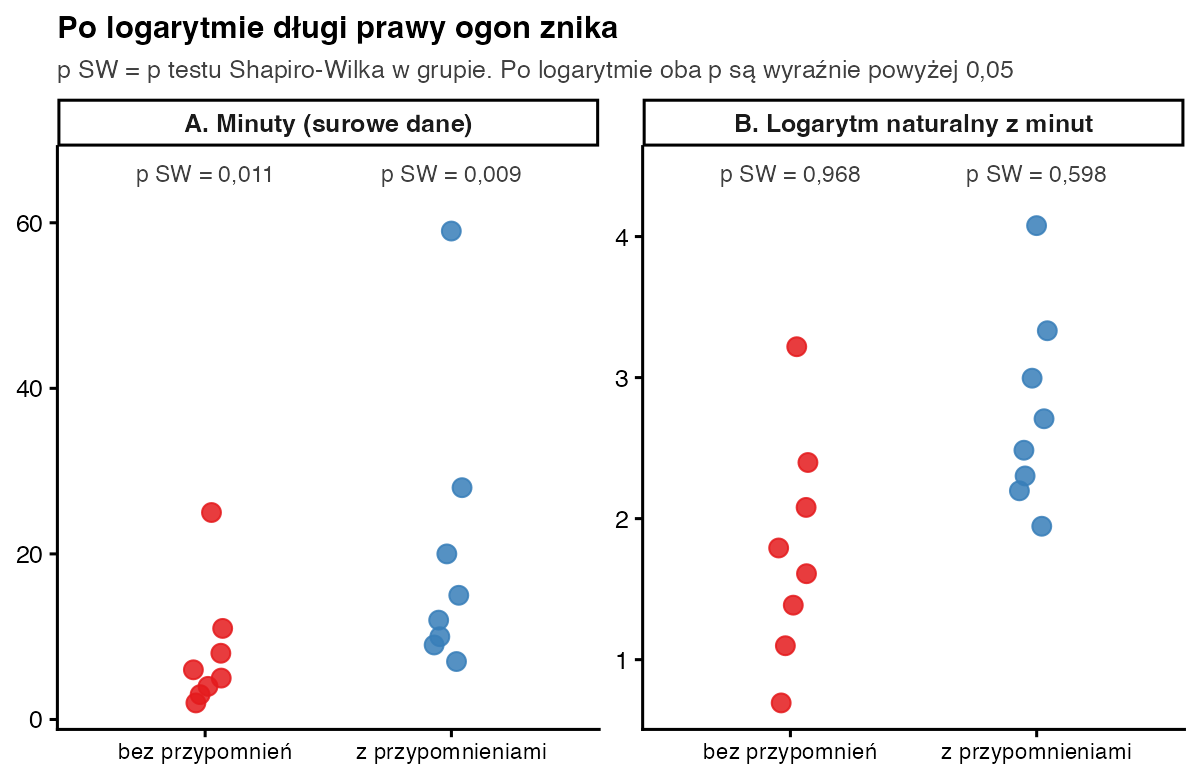
| Bez przypomnień | 2, 3, 4, 5, 6, 8, 11, 25 | 8,00 | 7,45 | 5,5 | W = 0,76; p = 0,011 |
| Z przypomnieniami | 7, 9, 10, 12, 15, 20, 28, 59 | 20,00 | 17,17 | 13,5 | W = 0,75; p = 0,009 |
Średnie są wyraźnie wyższe od median, a skośność w obu grupach przekracza 2. Przy 8 osobach w grupie nie możemy liczyć na centralne twierdzenie graniczne. Liczymy więc trzy wersje analizy.
- Test t Welcha na surowych minutach: t(9,54) = 1,81; p = 0,101. Różnica średnich to 12 minut, ale 95% CI [−2,84; 26,84] obejmuje zero. Jeden wynik 59 minut mocno zawyża odchylenie standardowe, więc test traci moc.
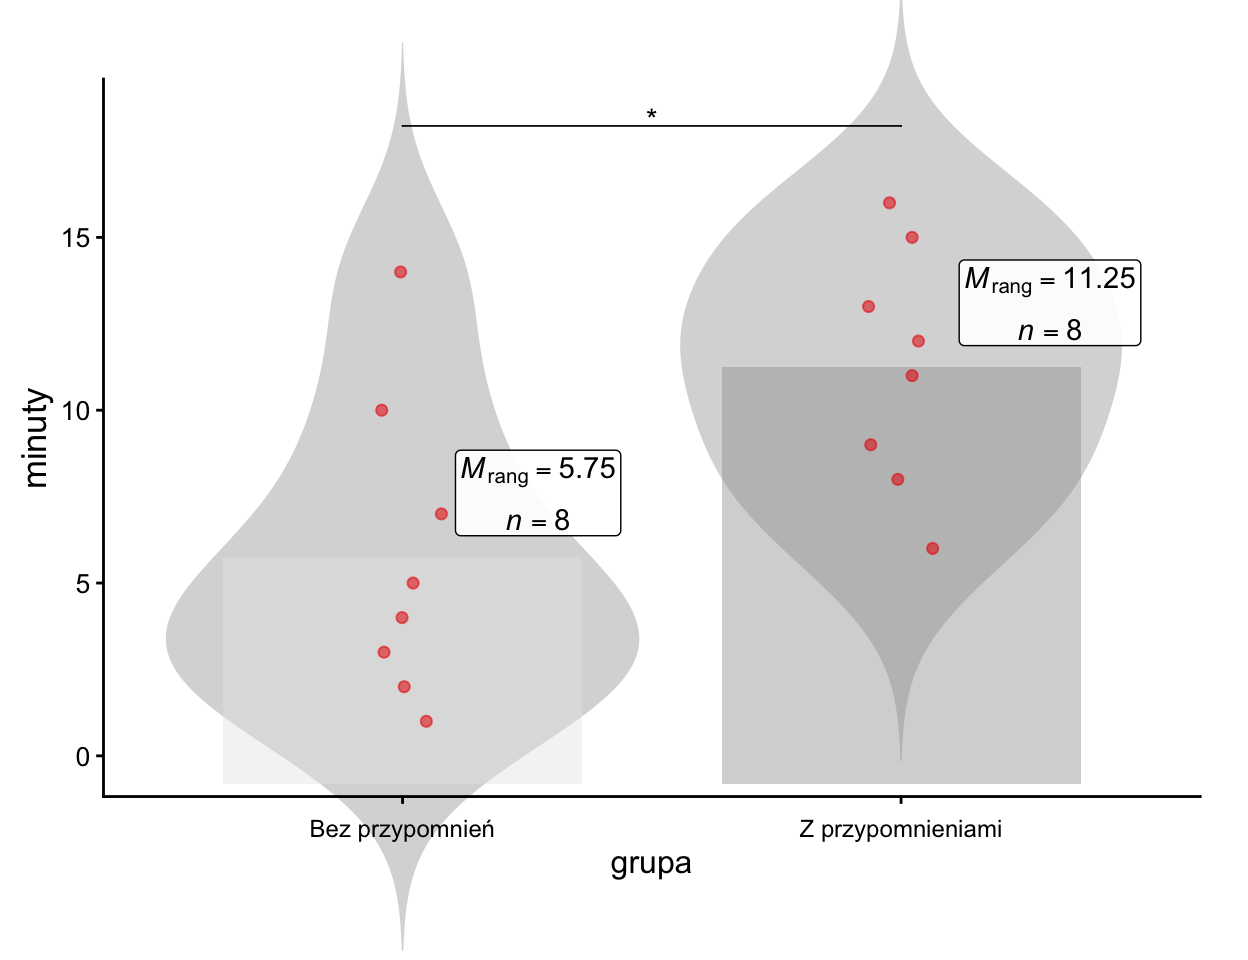
- Test U Manna-Whitneya: U = 10; p = 0,021. Średnie rangi wynoszą 5,75 i 11,25. Wielkość efektu r = 0,58, czyli efekt duży według progów Cohena (1988). Osoby z przypomnieniami zwykle spędzały w aplikacji więcej czasu.
- Logarytm, potem test t: po przekształceniu oba rozkłady są zbliżone do normalnego (Shapiro-Wilk: p = 0,968 i p = 0,598). Test t: t(14) = 2,61; p = 0,021. Po powrocie do minut (funkcja exp) średnia geometryczna w grupie z przypomnieniami jest 2,64 razy wyższa, 95% CI [1,19; 5,87]. Średnie geometryczne wynoszą 5,96 i 15,73 minuty.
- Dodatek – bootstrap: 95% CI dla różnicy średnich z 5000 losowań to [1,38; 25,00] minuty. Przy 8 osobach w grupie taki przedział bywa za wąski, więc traktuj go ostrożnie (Efron i Tibshirani, 1993). Bootstrap lepiej sprawdza się w większych próbach.
| Sposób | Wynik | Wniosek przy α = 0,05 |
|---|---|---|
| Test t Welcha (surowe minuty) | t(9,54) = 1,81; p = 0,101 | brak podstaw do odrzucenia H0 |
| Test U Manna-Whitneya | U = 10; p = 0,021; r = 0,58 | istotna różnica |
| Logarytm + test t | t(14) = 2,61; p = 0,021; iloraz 2,64 | istotna różnica |
Dlaczego wyniki się różnią? Test Welcha patrzy na średnie arytmetyczne, a te przy małej próbie są bardzo wrażliwe na jeden długi czas. Test U patrzy tylko na kolejność osób: sześć z ośmiu osób z przypomnieniami jest w górnej połowie całej próby (rangi 9–16). Logarytm „ściska” prawy ogon, więc wynik 59 minut przestaje dominować. Wszystkie trzy wersje wskazują ten sam kierunek różnicy, różnią się tylko pewnością.
Nie wybieraj tej wersji, która „wyszła”. O metodzie decyduje plan analizy i rodzaj danych. Tutaj czas jest dodatni i prawoskośny, więc rozsądny wybór to test U albo logarytm – i taki wybór warto zapisać, zanim policzysz wyniki.
Krok 4. Gotowe zdania do pracy
Zapis w stylu APA (test U): Ze względu na prawostronną skośność rozkładów czasu w obu grupach (test Shapiro-Wilka: p = 0,011 i p = 0,009) zastosowano test U Manna-Whitneya. Osoby otrzymujące przypomnienia spędzały w aplikacji istotnie więcej czasu (Me = 13,5 min) niż osoby bez przypomnień (Me = 5,5 min), U = 10; p = 0,021; r = 0,58.
Wersja z logarytmem: Ze względu na prawostronną skośność czas przekształcono logarytmem naturalnym. Średnia geometryczna czasu była 2,64 razy wyższa w grupie z przypomnieniami niż w grupie bez przypomnień, 95% CI [1,19; 5,87], t(14) = 2,61; p = 0,021.
W rozdziale o metodzie dodaj jedno zdanie: „Normalność rozkładów w grupach oceniano wykresami kwantyl-kwantyl i testem Shapiro-Wilka; przy wyraźnych odchyleniach stosowano test U Manna-Whitneya”. Gotowe wzorce dla innych testów znajdziesz w artykule opis wyników w stylu APA 7.
Cała analiza w R
# Minuty dziennie w aplikacji do nauki słówek, po 8 osób w grupie
bez <- c(2, 3, 4, 5, 6, 8, 11, 25)          # bez przypomnień
z   <- c(7, 9, 10, 12, 15, 20, 28, 59)      # z przypomnieniami

# 1) opis i normalność w każdej grupie osobno
opis <- function(x) c(M = mean(x), Me = median(x), SD = sd(x),
  skosnosc = e1071::skewness(x, type = 2), p_SW = shapiro.test(x)$p.value)
round(sapply(list(bez = bez, z = z), opis), 3)

# Sposób 1: test t Welcha na surowych minutach (porównuje średnie)
welch <- t.test(z, bez)
round(c(welch$statistic, welch$parameter, p = welch$p.value,
        CI_dolna = welch$conf.int[1], CI_gorna = welch$conf.int[2]), 3)

# Sposób 2: test U Manna-Whitneya (porównuje rangi)
u <- wilcox.test(bez, z)                     # dokładne p, brak remisów
Z <- (u$statistic - 8 * 8 / 2) / sqrt(8 * 8 * 17 / 12)   # przybliżenie normalne
r <- abs(Z) / sqrt(16)                       # wielkość efektu r = |Z| / √N
round(c(U = unname(u$statistic), p = u$p.value, Z = unname(Z), r = unname(r)), 3)

# Sposób 3: logarytm, potem test t (porównuje średnie geometryczne)
tl <- t.test(log(z), log(bez), var.equal = TRUE)
round(c(tl$statistic, tl$parameter, p = tl$p.value), 3)
round(setNames(exp(c(diff(rev(tl$estimate)), tl$conf.int)),
               c("iloraz", "CI_dolna", "CI_gorna")), 2)

# Dodatek: bootstrap 95% CI dla różnicy średnich (5000 losowań)
set.seed(2026)
roznice <- replicate(5000, mean(sample(z, replace = TRUE)) - mean(sample(bez, replace = TRUE)))
round(quantile(roznice, c(0.025, 0.975)), 2)
Wynik w konsoli R:
           bez      z
M        8.000 20.000
Me       5.500 13.500
SD       7.445 17.171
skosnosc 2.077  2.057
p_SW     0.011  0.009
       t       df        p CI_dolna CI_gorna
   1.813    9.542    0.101   -2.840   26.840
     U      p      Z      r
10.000  0.021 -2.310  0.578
     t     df      p
 2.609 14.000  0.021
  iloraz CI_dolna CI_gorna
    2.64     1.19     5.87
 2.5% 97.5%
 1.38 25.00
Checklista
- Normalność oceniona na resztach lub w grupach, z wykresem Q-Q, a nie tylko testem.
- Metoda wybrana na podstawie rodzaju danych i liczby osób, przed obliczeniem wyników.
- Przy teście nieparametrycznym podane mediany i wielkość efektu r, przy logarytmie – iloraz średnich geometrycznych.
- W metodzie jedno zdanie uzasadnienia wyboru.
Pytania, które studenci wpisują w Google
Czy mogę po prostu usunąć wyniki odstające?
Tylko wtedy, gdy są błędem (np. literówka, osoba spoza populacji), a regułę usuwania ustalisz z góry. Prawdziwego, choć nietypowego wyniku nie usuwaj tylko dlatego, że psuje normalność. Jak to sprawdzić, opisujemy we wpisie obserwacje odstające – reguła IQR i odległość Cooka.
Brak normalności w ANOVA – co wtedy?
Te same zasady: przy dużych grupach ANOVA jest odporna, przy małych i skośnych danych użyj testu Kruskala-Wallisa, a przy różnych wariancjach – ANOVA Welcha.
Czy przy dużej próbie mogę zignorować istotny test Shapiro-Wilka?
Często tak, jeśli wykres Q-Q nie pokazuje skrajnych wyników. Przy kilkuset osobach test t działa dobrze nawet przy umiarkowanej skośności (Lumley i in., 2002; Fagerland, 2012). Napisz to wprost w metodzie.
Bibliografia
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23, 151–169.
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies – a paradox of statistical practice? BMC Medical Research Methodology, 12, 78. https://doi.org/10.1186/1471-2288-12-78
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikJak sprawdzić normalność rozkładu – Q-Q, Shapiro-Wilk
- PoradnikTesty nieparametryczne
- Słownik wzorówBootstrap
- Słownik wzorówCentralne twierdzenie graniczne
- PoradnikTesty parametryczne
- Przykładowy raportTest Kruskala-Wallisa
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.