

Sekcja „Analiza statystyczna” w artykule – jak ją napisać (wzór i checklista)
Sekcja analizy statystycznej mówi recenzentowi, co dokładnie policzyłeś, w jakim programie i według jakich reguł. Typowe pytanie przy pierwszym artykule albo rozdziale doktoratu: co musi się w niej znaleźć, żeby recenzent nie odesłał tekstu z prośbą o uzupełnienie?
W prostych słowachTa sekcja to przepis, a nie wynik. Inny badacz powinien móc na jej podstawie powtórzyć Twoje analizy na Twoich danych i otrzymać te same liczby. Dlatego podajesz nazwy testów, sposób sprawdzenia założeń, poprawki na wiele testów, miarę efektu, postępowanie z brakami danych, poziom istotności oraz program z numerem wersji. Liczby z wynikami trafiają już do części „Wyniki”.
Co musi zawierać sekcja analizy statystycznej?
Standard JARS Amerykańskiego Towarzystwa Psychologicznego (Appelbaum i in., 2018) wymienia elementy, które recenzenci sprawdzają najczęściej. Zebraliśmy je w tabeli razem z przykładem z małego badania opisanego niżej. Podobne wymagania mają czasopisma medyczne i ekonomiczne, więc tabela przyda się także poza psychologią.
| Element | Co napisać | Przykład z badania |
|---|---|---|
| Preregistracja | czy plan analiz zarejestrowano, gdzie i kiedy; co było planowane, a co jest eksploracyjne | hipotezy i plan zarejestrowane przed zbieraniem danych |
| Testy | nazwa testu dla każdej hipotezy, test jednostronny czy dwustronny | test t Welcha dla prób niezależnych, dwustronny |
| Założenia | jak je sprawdzono i co zrobiono, gdy nie były spełnione | Shapiro-Wilk w grupach, Levene z medianą |
| Poprawka | liczba testów w rodzinie i metoda korekty | 3 testy, metoda Holma |
| Poziom α | próg istotności i czy dotyczy pojedynczego testu, czy rodziny testów | α = 0,05 dla rodziny trzech testów |
| Wielkość efektu | miara efektu i sposób wyznaczenia przedziału ufności | d Cohena z 95% CI |
| Braki danych | ile ich było, w których zmiennych, jak postąpiono | brak braków danych (0 w każdej zmiennej) |
| Oprogramowanie | program i pakiety z numerem wersji oraz cytowaniem | R 4.5.3, effectsize 1.0.2, car 3.1.5 |
Przykładowe badanie, na którym opieramy wzór
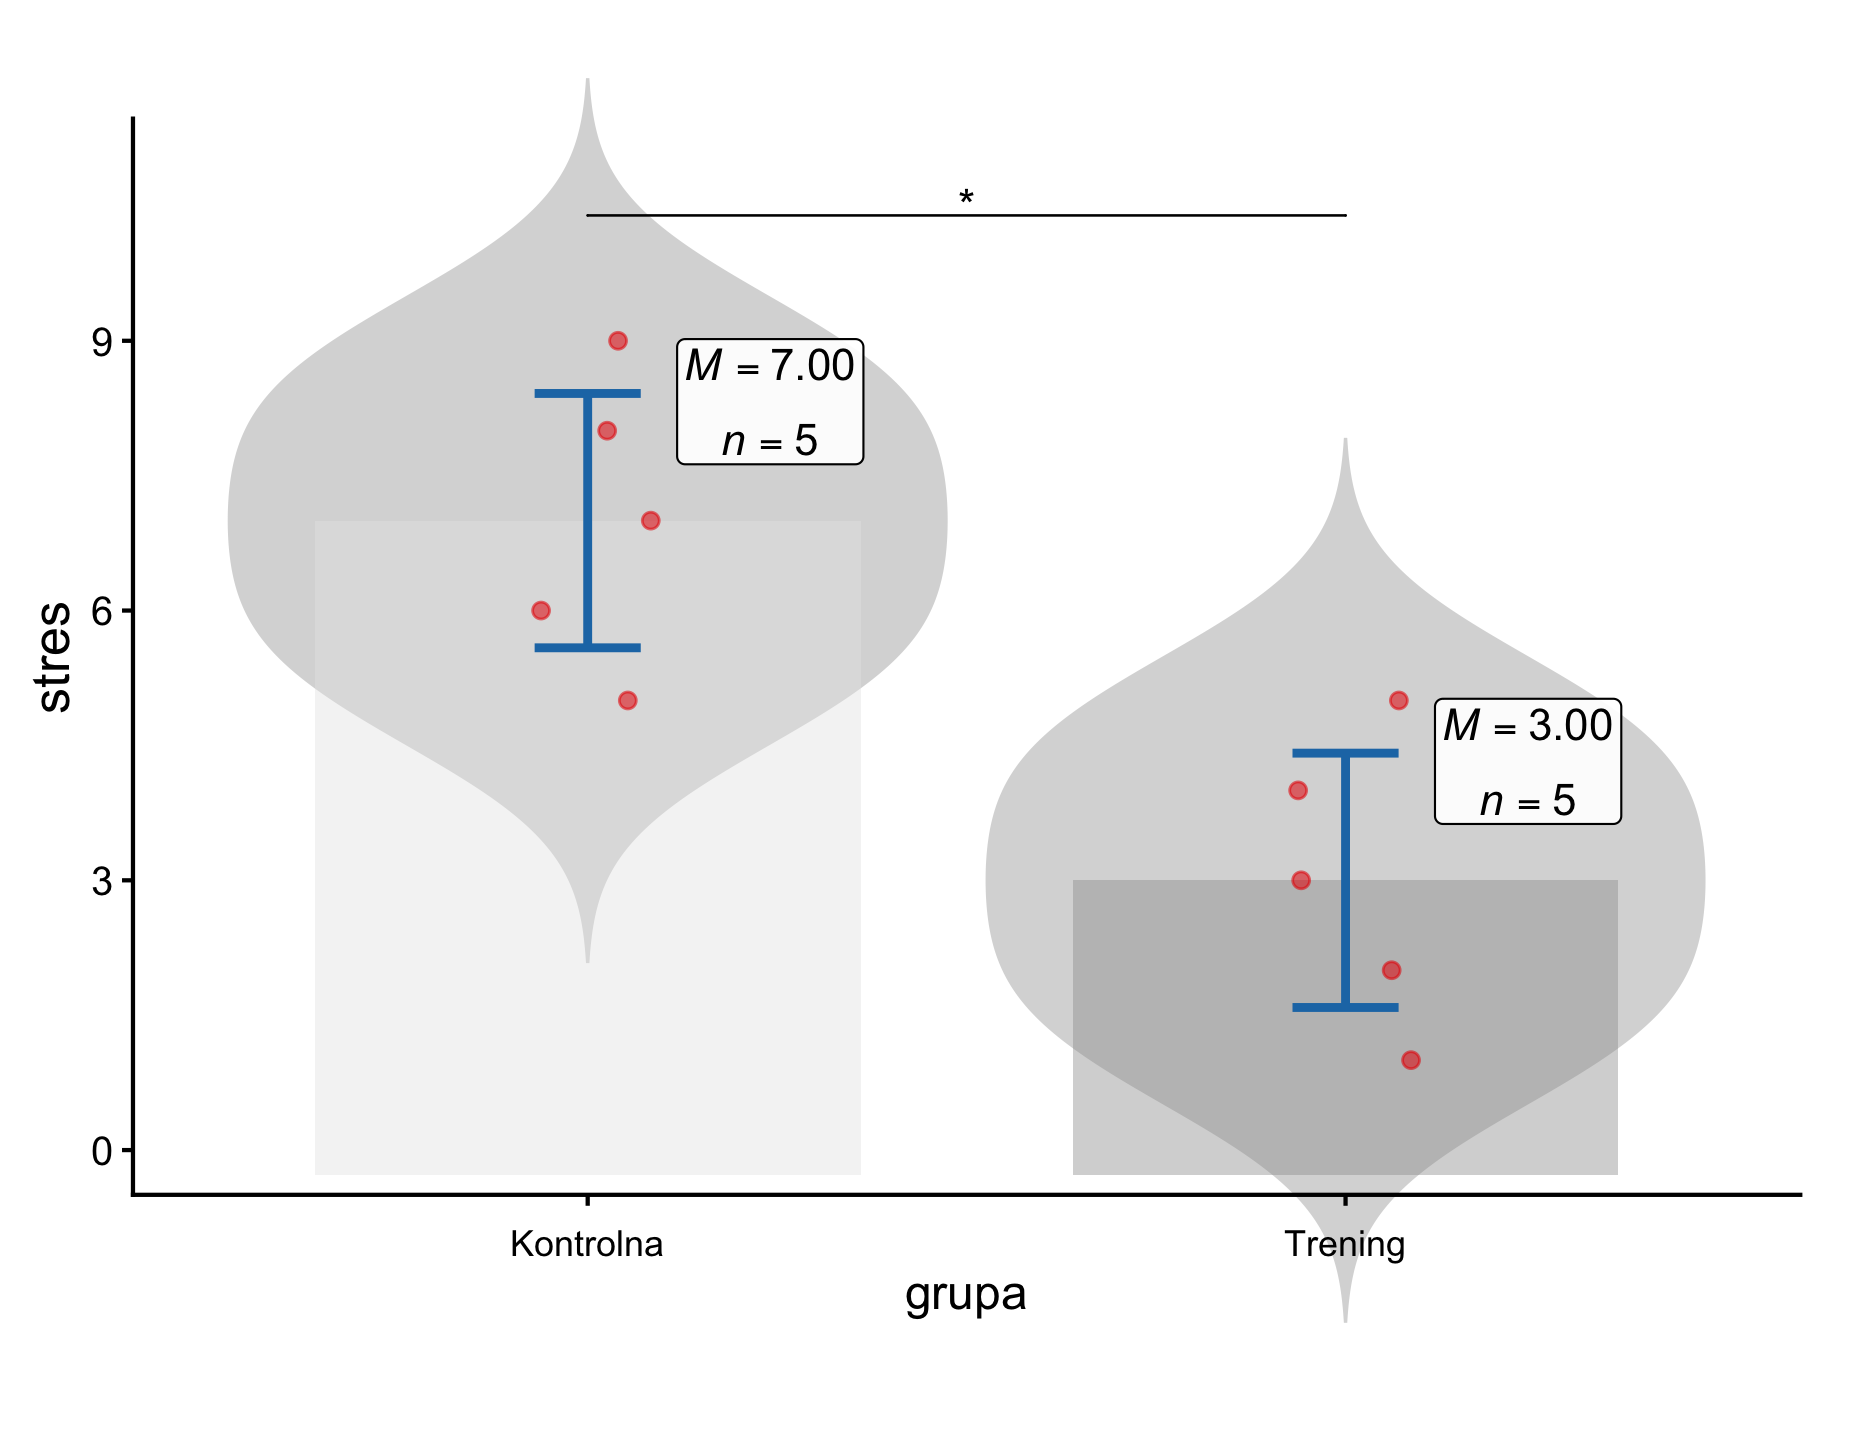
Żeby wzór był konkretny, użyjemy celowo bardzo małego badania „Trening uważności a samopoczucie”. Pięć osób trafiło do grupy trening, pięć do grupy kontrolnej. Po czterech tygodniach zmierzono trzy zmienne: stres (skala 1–10), koncentrację (punkty 0–10) i sen (godziny na dobę). Średni stres wyniósł 3 w grupie trening i 7 w grupie kontrolnej, koncentracja 7 i 5, sen 8 i 7 godzin. Przy pięciu osobach w grupie chodzi wyłącznie o ilustrację – w prawdziwym projekcie liczebność uzasadnij analizą mocy.
Wzór akapitu do zaadaptowania
Poniższy akapit możesz przepisać do własnego artykułu, zmieniając nazwy zmiennych, testy i wersje programów. Zachowaj kolejność: plan, testy, założenia, poprawka, efekt, braki, program.
Analiza statystyczna. Hipotezy i plan analiz zarejestrowano przed rozpoczęciem zbierania danych [nazwa rejestru, adres]. Grupę trening i grupę kontrolną porównano pod względem trzech zmiennych zależnych (stres, koncentracja, sen) dwustronnym testem t Welcha dla prób niezależnych, który nie wymaga równości wariancji (Delacre i in., 2017). Normalność rozkładów w każdej grupie oceniono testem Shapiro-Wilka i wykresami Q-Q, a jednorodność wariancji – testem Levene’a w wariancie z medianą. Ponieważ wykonano trzy testy, wartości p skorygowano metodą Holma (1979), utrzymując poziom błędu I rodzaju dla całej rodziny testów na poziomie α = 0,05. Wielkość efektu wyrażono jako d Cohena z 95% przedziałem ufności. W zbiorze nie było braków danych. Analizy wykonano w programie R (wersja 4.5.3; R Core Team, 2026) z pakietami effectsize (wersja 1.0.2; Ben-Shachar i in., 2020) oraz car (wersja 3.1.5; Fox i Weisberg, 2019). Dane i kod analiz udostępniono w [repozytorium].
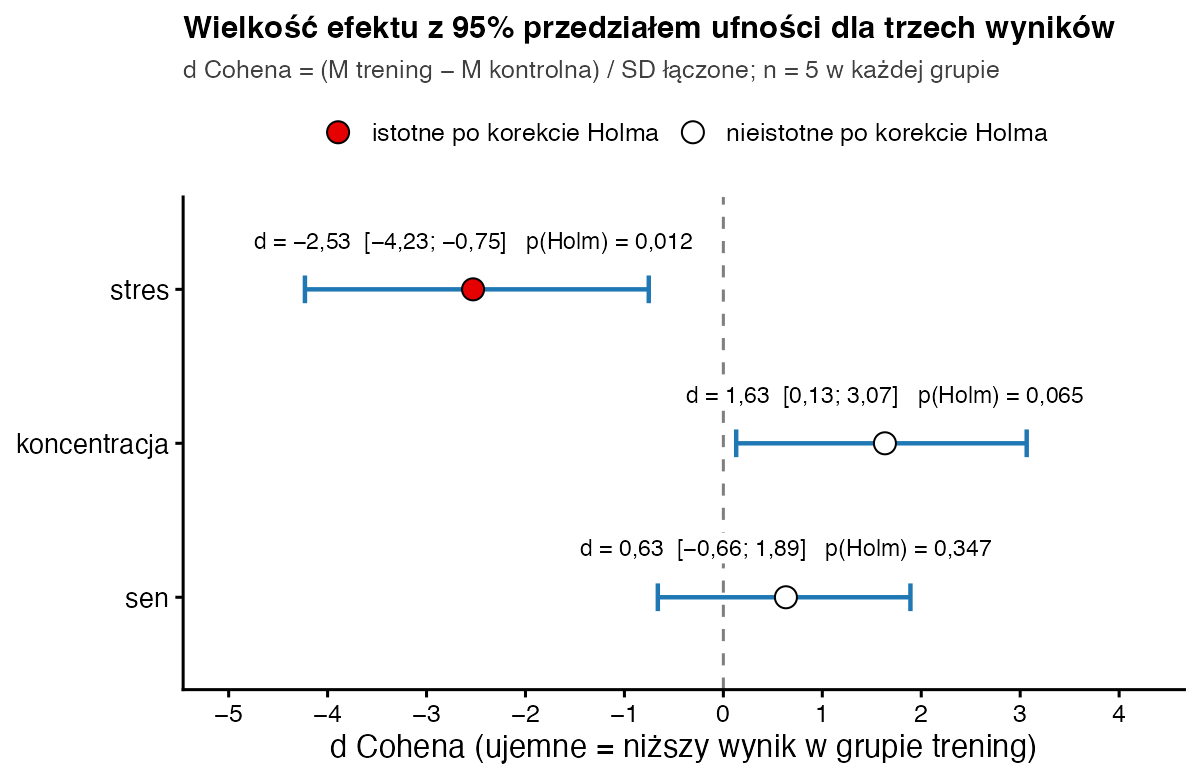
W części „Wyniki” podajesz już liczby, np.: „Osoby z grupy trening zgłaszały niższy stres niż osoby z grupy kontrolnej, t(8) = −4,00; pHolm = 0,012; d = −2,53; 95% CI [−4,23; −0,75]”. Więcej gotowych zdań znajdziesz we wpisie o opisie wyników w stylu APA 7.
Co pokazują wyniki, które opisze ta sekcja?
Test Shapiro-Wilka nie wskazał odchyleń od normalności (p = 0,967 dla stresu i snu, p = 0,146 dla koncentracji w obu grupach), a test Levene’a dał p = 1,000, bo rozrzut wyników w grupach był identyczny. Przy pięciu osobach w grupie takie testy mają jednak małą moc, dlatego w metodach warto napisać, że oceniano także wykresy. Szczegóły testów znajdziesz w hasłach o teście Shapiro-Wilka i teście Browna-Forsythe’a (to właśnie test Levene’a z medianą).
Jak podać program, wersje pakietów i cytowania w R?
Recenzenci coraz częściej proszą o numer wersji, bo wyniki potrafią się różnić między wersjami pakietów. W R nie musisz niczego zgadywać: funkcja R.version.string podaje wersję programu, packageVersion() – wersję pakietu, a citation() – gotowy wpis do bibliografii. Pełną listę pakietów zwraca sessionInfo(); jej wydruk możesz dołączyć do materiałów uzupełniających. Poniższy kod przechodzi cały przepływ: braki danych, założenia, test Welcha, poprawka Holma, d z przedziałem ufności i informacje do cytowania.
# Badanie „Trening uważności a samopoczucie”: 2 grupy po 5 osób, 3 zmienne zależne
badanie <- data.frame(
  grupa = factor(rep(c("Kontrolna", "Trening"), each = 5), levels = c("Trening", "Kontrolna")),  # różnice: Trening − Kontrolna
  stres = c(5, 6, 7, 8, 9, 1, 2, 3, 4, 5),
  koncentracja = c(3, 5, 5, 6, 6, 5, 7, 7, 8, 8),
  sen = c(5, 6, 7, 8, 9, 6, 7, 8, 9, 10))
zmienne <- c("stres", "koncentracja", "sen")
colSums(is.na(badanie[zmienne]))                       # 1. braki danych

# 2. Założenia: Shapiro-Wilk w każdej grupie, Levene (wariant z medianą)
sapply(zmienne, function(z) tapply(badanie[[z]], badanie$grupa, function(x) round(shapiro.test(x)$p.value, 3)))
sapply(zmienne, function(z) round(car::leveneTest(badanie[[z]] ~ badanie$grupa)$`Pr(>F)`[1], 3))

# 3. Test t Welcha, poprawka Holma, d Cohena z 95% CI
wyniki <- t(sapply(zmienne, function(z) {
  t <- t.test(badanie[[z]] ~ badanie$grupa)            # domyślnie Welch
  d <- effectsize::cohens_d(badanie[[z]] ~ badanie$grupa)
  c(t = unname(t$statistic), df = unname(t$parameter), p = t$p.value, d = d$Cohens_d, d_low = d$CI_low, d_high = d$CI_high)
}))
wyniki <- cbind(wyniki, p_holm = p.adjust(wyniki[, "p"], method = "holm"))
round(wyniki, 3)

# 4. Oprogramowanie: wersje i cytowania do sekcji metod
R.version.string
packageVersion("effectsize"); packageVersion("car")
print(citation(), style = "text")
Wynik w konsoli R:
       stres koncentracja          sen
           0            0            0
          stres koncentracja   sen
Trening   0.967        0.146 0.967
Kontrolna 0.967        0.146 0.967
       stres koncentracja          sen
           1            1            1
                  t df     p      d  d_low d_high p_holm
stres        -4.000  8 0.004 -2.530 -4.229 -0.754  0.012
koncentracja  2.582  8 0.033  1.633  0.130  3.066  0.065
sen           1.000  8 0.347  0.632 -0.662  1.891  0.347
[1] "R version 4.5.3 (2026-03-11)"
[1] ‘1.0.2’
[1] ‘3.1.5’
R Core Team (2026). _R: A Language and Environment for
Statistical Computing_. R Foundation for Statistical Computing,
Vienna, Austria. <https://www.R-project.org/>.
Kolumna p to wynik pojedynczego testu, a p_holm – wynik po korekcie. Wzór i ręczne obliczenie poprawki pokazujemy w haśle poprawka Holma i FDR, a sposób liczenia d – w haśle d Cohena. Taki sam zestaw tabel i rysunków zawiera przykładowy raport z testu t.
Checklista przed wysłaniem artykułu
- Każda hipoteza ma przypisany test i kierunek (jedno- lub dwustronny).
- Opisałeś, jak sprawdzono założenia i co zrobiono przy ich naruszeniu.
- Podałeś liczbę testów w rodzinie i metodę poprawki albo uzasadniłeś jej brak.
- Jest poziom α i informacja, czego dotyczy.
- Jest miara wielkości efektu z przedziałem ufności dla każdego głównego wyniku (zob. jak raportować wielkość efektu).
- Podałeś liczbę braków danych i metodę postępowania (zob. braki danych i imputacja wielokrotna).
- Program i pakiety mają numery wersji i pozycje w bibliografii.
- Analizy nieplanowane są nazwane eksploracyjnymi.
Czy zawsze trzeba stosować poprawkę na wielokrotne porównania?
Nie zawsze, ale zawsze trzeba o tym napisać. Poprawka jest potrzebna, gdy kilka testów odpowiada na jedno pytanie i wystarczy jeden istotny wynik, żeby ogłosić sukces – tak jak w naszym przykładzie z trzema miarami samopoczucia. Gdy każda hipoteza jest osobnym, z góry zaplanowanym pytaniem, część metodologów dopuszcza brak korekty, ale recenzent może o nią poprosić. Metoda Holma jest bezpieczna i zawsze ma co najmniej taką moc jak Bonferroni (Holm, 1979).
Gdzie opisać sprawdzanie założeń – w metodach czy w wynikach?
W metodach piszesz, jak sprawdzałeś założenia i jaka była reguła decyzji. W wynikach albo w materiałach uzupełniających podajesz, co wyszło. Unikaj reguły „jeśli test normalności jest istotny, to test nieparametryczny”, jeśli nie była zaplanowana – recenzenci traktują ją dziś ostrożnie, bo przy dużych próbach testy normalności są nadwrażliwe, a przy małych mają małą moc.
Najczęstsze błędy
- „Analizy wykonano w programie R” bez numeru wersji i bez cytowania programu i pakietów.
- Nazwa „test t” bez informacji, czy to wariant Studenta, czy Welcha, i czy dla prób zależnych.
- Poprawka na wielokrotne porównania stosowana tylko do części testów, bez wyjaśnienia.
- Brak informacji o brakach danych, gdy liczebność w tabelach różni się od liczby badanych.
- Samo p bez wielkości efektu i przedziału ufności.
- Język przyczynowy („trening obniża stres”) w badaniu bez losowego przydziału do grup.
Bibliografia
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE.
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114
- R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikOpis wyników w stylu APA 7 – gotowe zdania i tabele
- PoradnikAnaliza mocy do grantu i artykułu
- PoradnikJak odpowiedzieć na recenzję statystyczną
- Słownik wzorówPoprawki Holma i FDR
- PoradnikMediacja z bootstrapem – jak opisać wyniki
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.