

Jak odpowiedzieć na recenzję statystyczną – przykłady odpowiedzi
Recenzja statystyczna to lista uwag do analiz w artykule: moc, poprawki, założenia, wielkość efektu, wnioski przyczynowe. Typowe pytanie po decyzji „major revision”: jak odpowiedzieć rzeczowo, co doliczyć, a z czym można się uprzejmie nie zgodzić?
W prostych słowachRecenzent nie jest przeciwnikiem, tylko pierwszym czytelnikiem, który się pogubił albo czegoś nie znalazł. Na każdą uwagę odpowiadasz osobno: cytujesz ją, mówisz, co zrobiłeś, i wskazujesz miejsce zmiany w tekście. Jeżeli uwaga wymaga nowych obliczeń – liczysz je i pokazujesz wynik, nawet gdy jest mniej korzystny niż wcześniej.
Jak zbudować list odpowiedzi do recenzentów?
- Zacytuj uwagę. Każdą uwagę wklej w całości i ponumeruj (R1.1, R1.2, R2.1…).
- Odpowiedz krótko i konkretnie. Jedno zdanie podziękowania wystarczy, potem przejdź do rzeczy.
- Pokaż zmianę. Wklej nowy fragment tekstu i podaj stronę oraz wiersz w poprawionej wersji.
- Podaj liczby. Jeżeli policzyłeś coś nowego, wpisz wynik w odpowiedzi, a nie tylko „uzupełniono”.
- Nie zgadzaj się bez argumentu. Gdy uważasz, że uwaga jest chybiona, odpowiedz źródłem metodologicznym albo dodatkową analizą.
Najczęstsze uwagi recenzentów i co z nimi zrobić
Przykłady opieramy na małym badaniu z wpisu o sekcji „Analiza statystyczna” w artykule: grupa trening i grupa kontrolna po 5 osób, trzy zmienne zależne – stres, koncentracja i sen. W pierwszej wersji autor podał trzy testy t bez korekty i bez przedziałów ufności.
| Uwaga recenzenta | Co zrobić | Czego unikać |
|---|---|---|
| Za mała próba, zbyt mała moc | analiza wrażliwości: jaki najmniejszy efekt dało się wykryć | moc „post hoc” liczona z uzyskanego efektu |
| Wielokrotne porównania | poprawka (np. Holma) dla całej rodziny testów | korekta tylko tam, gdzie wynik się utrzyma |
| Założenia testów | wykresy reszt, test odporny lub nieparametryczny jako analiza wrażliwości | „założenia zostały spełnione” bez szczegółów |
| Brak wielkości efektu | miara efektu z 95% przedziałem ufności | sama etykieta „duży efekt” |
| Wnioski przyczynowe | zmiana języka na „związek” albo uzasadnienie schematem badania | pozostawienie słów „wpływa”, „powoduje” |
| Wspólna metoda pomiaru (CMB) | opis zabezpieczeń proceduralnych i test statystyczny | sam test jednego czynnika Harmana jako dowód |
Przykładowe odpowiedzi do zaadaptowania
Moc (R1.1): Dziękujemy za tę uwagę. Zamiast mocy obliczonej z uzyskanego efektu, która jest prostą funkcją wartości p (Hoenig i Heisey, 2001), dodaliśmy analizę wrażliwości. Przy 5 osobach w grupie, α = 0,05 i teście dwustronnym badanie miało moc 80% dla efektów d ≥ 2,02. Mniejszych efektów nie można było wiarygodnie wykryć, co dopisaliśmy w ograniczeniach (s. 14, w. 5–9).
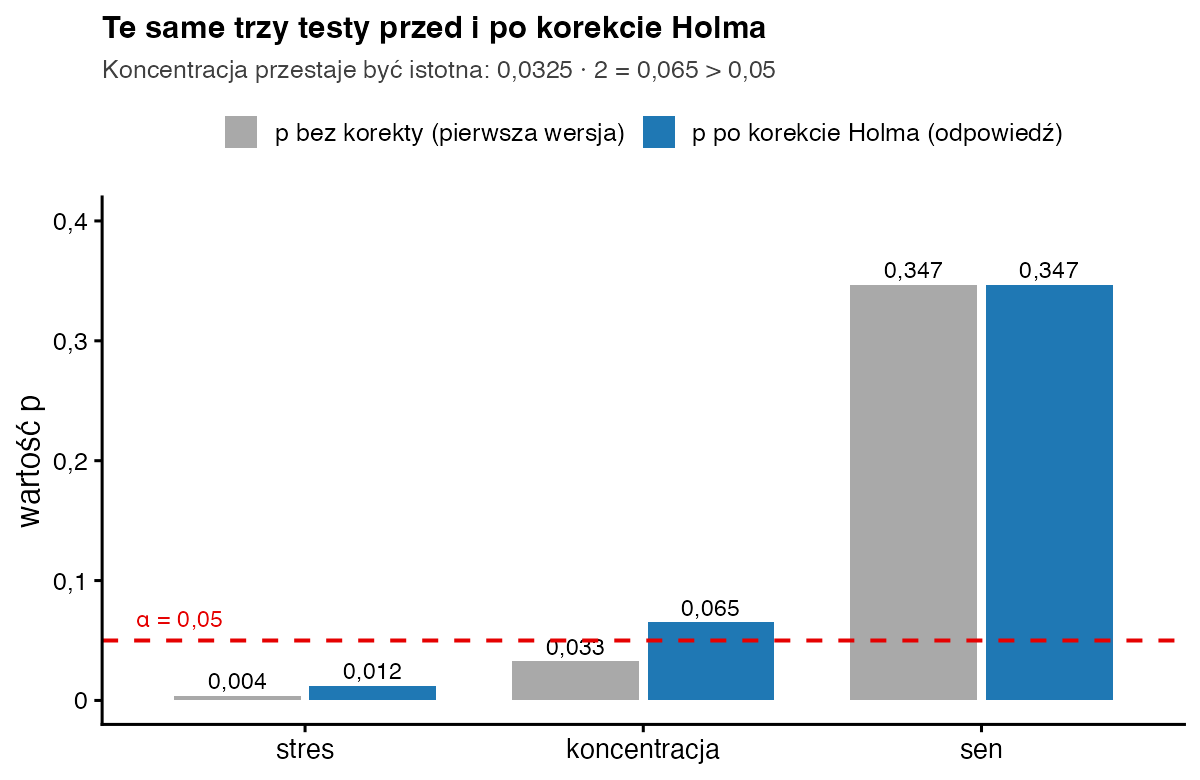
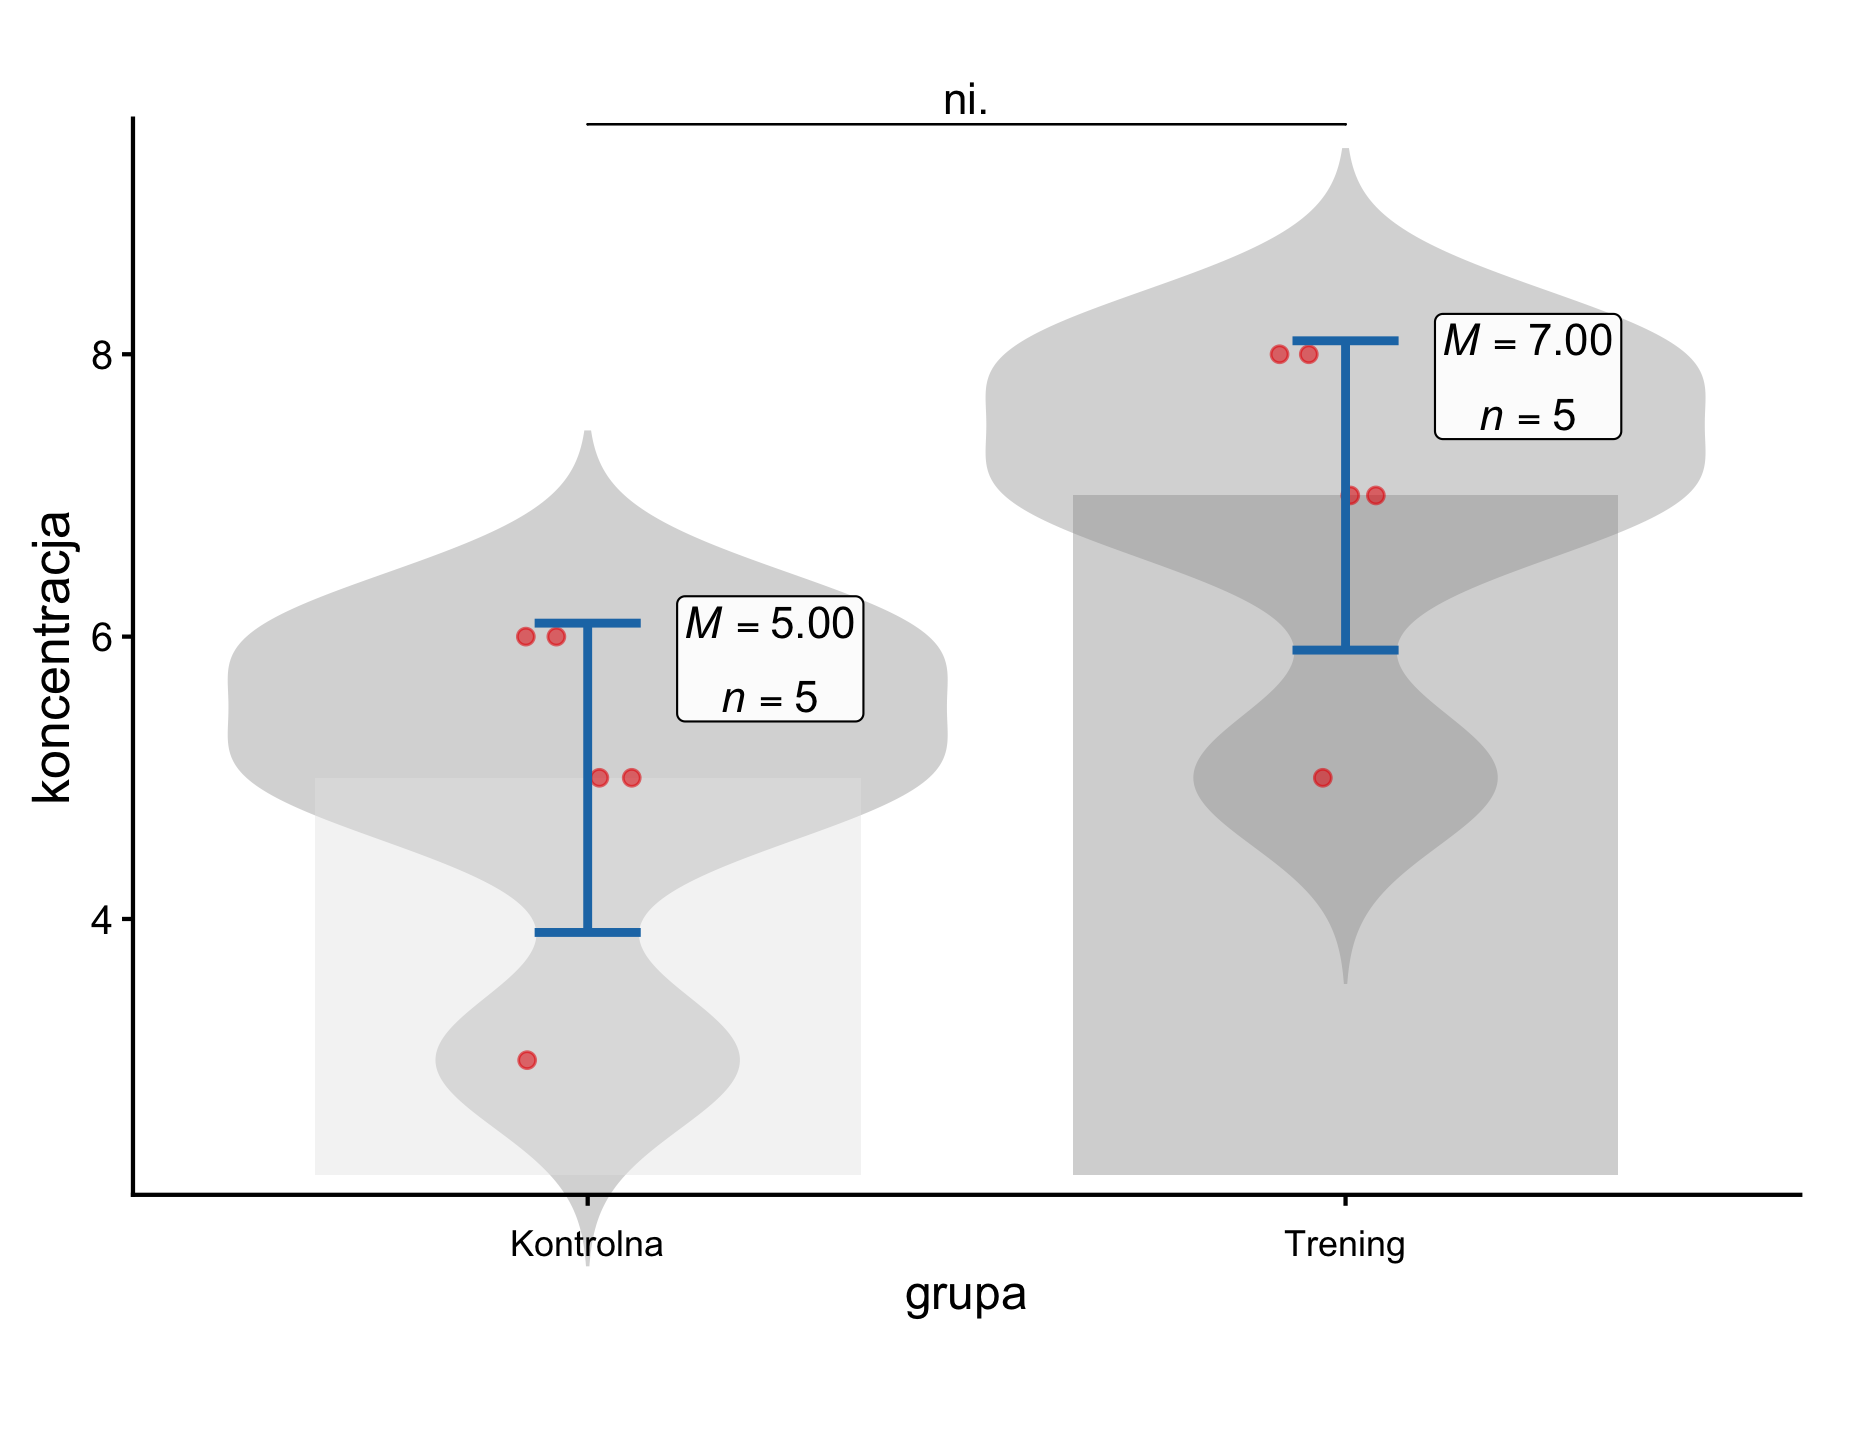
Wielokrotne porównania (R1.2): Zgadzamy się. Trzy zmienne zależne tworzą jedną rodzinę testów, dlatego zastosowaliśmy poprawkę Holma (1979). Różnica w stresie pozostała istotna (pHolm = 0,012), natomiast różnica w koncentracji przestała być istotna (p = 0,033 przed korektą, pHolm = 0,065). Zmieniliśmy odpowiednio abstrakt, wyniki i dyskusję.
Założenia (R2.1): Normalność oceniono testem Shapiro-Wilka i wykresami Q-Q w każdej grupie, a w metodach zastąpiliśmy test t Studenta testem Welcha, który nie wymaga równych wariancji. Wyniki nie zmieniły się, ponieważ wariancje w grupach były identyczne.
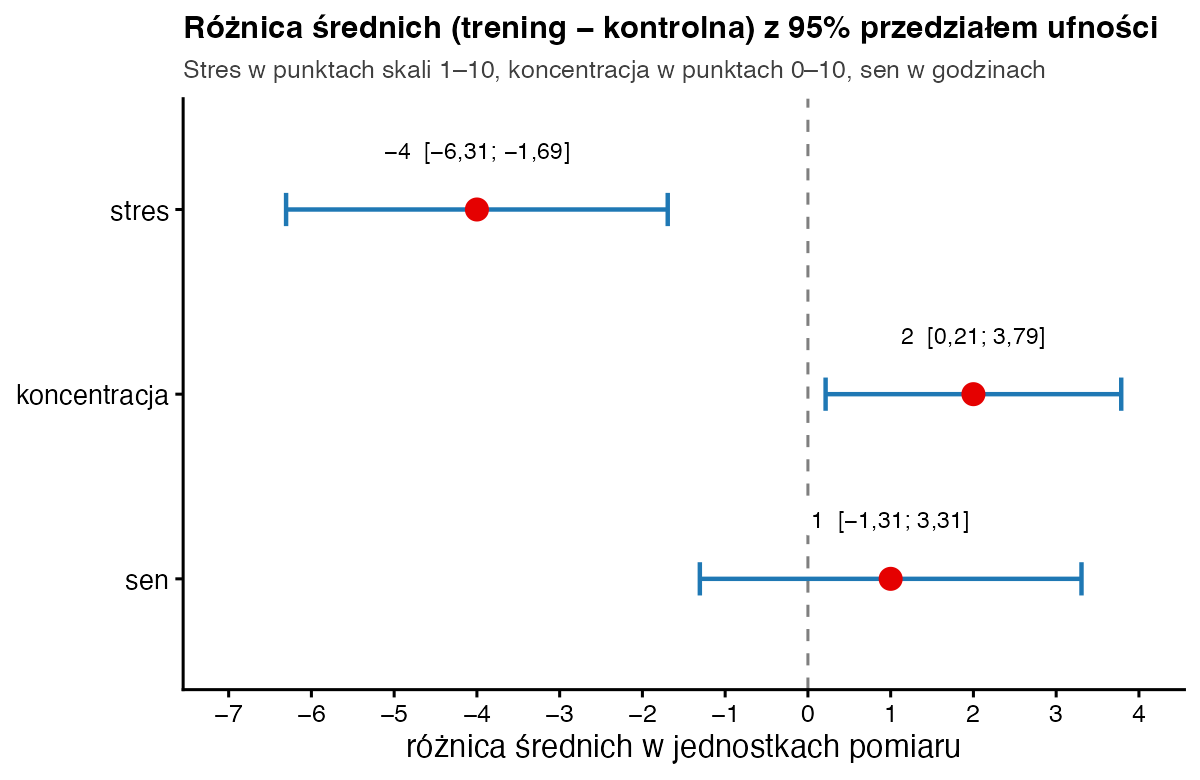
Wielkość efektu (R2.2): Do Tabeli 2 dodaliśmy różnice średnich z 95% przedziałami ufności oraz d Cohena z przedziałami. Dla stresu różnica wyniosła −4 punkty, 95% CI [−6,31; −1,69]; d = −2,53; 95% CI [−4,23; −0,75]. Szerokie przedziały opisujemy jako ograniczenie wynikające z małej próby (Cumming, 2014).
Przyczynowość (R2.3): W badaniu przekrojowym zastąpiliśmy sformułowania przyczynowe („wpływa”) opisem związku („wiąże się z”). Jeśli badanie miało losowy przydział do grup, napisz to wyraźnie – wtedy wniosek przyczynowy jest uprawniony (Rohrer, 2018).
Wspólna metoda pomiaru (R3.1): Opisaliśmy zabezpieczenia proceduralne – anonimowość, rozdzielenie skal w kwestionariuszu i różne formaty odpowiedzi – zgodnie z zaleceniami Podsakoffa i in. (2003). Szczegóły i testy opisujemy we wpisie o common method bias.
Przykład w R: poprawka Holma i przedziały ufności do istniejących wyników
Najczęstsza prośba to „dodaj korektę i przedziały ufności” – tego wymaga też standard JARS (Appelbaum i in., 2018). Nie musisz zmieniać całej analizy – wystarczy kilka linii. Funkcja p.adjust() poprawia wartości p, t.test() zwraca przedział ufności dla różnicy średnich, a pakiet effectsize – d z przedziałem. Ostatnia linia to analiza wrażliwości z funkcji power.t.test(). Jak wygląda pełny opis porównania dwóch grup z tabelą i rysunkiem, zobaczysz w przykładowym raporcie z testu t.
# Dane z artykułu: grupa kontrolna vs trening uważności (n = 5 + 5), trzy zmienne zależne
badanie <- data.frame(
  grupa = factor(rep(c("Kontrolna", "Trening"), each = 5), levels = c("Kontrolna", "Trening")),
  stres = c(5, 6, 7, 8, 9, 1, 2, 3, 4, 5),
  koncentracja = c(3, 5, 5, 6, 6, 5, 7, 7, 8, 8),
  sen = c(5, 6, 7, 8, 9, 6, 7, 8, 9, 10))
zmienne <- c("stres", "koncentracja", "sen")

# Recenzent: „brak korekty wielokrotnych porównań i przedziałów ufności”
wyniki <- t(sapply(zmienne, function(z) {
  tt <- t.test(badanie[[z]][badanie$grupa == "Trening"],
               badanie[[z]][badanie$grupa == "Kontrolna"])   # różnica: Trening − Kontrolna
  d <- effectsize::cohens_d(badanie[[z]][badanie$grupa == "Trening"],
                            badanie[[z]][badanie$grupa == "Kontrolna"])
  c(roznica = unname(diff(rev(tt$estimate))), ci_low = tt$conf.int[1], ci_high = tt$conf.int[2],
    t = unname(tt$statistic), p = tt$p.value, d = d$Cohens_d, d_low = d$CI_low, d_high = d$CI_high)
}))
wyniki <- cbind(wyniki, p_holm = p.adjust(wyniki[, "p"], method = "holm"))  # poprawka Holma
round(wyniki[, c("t", "p", "p_holm")], 3)
round(wyniki[, c("roznica", "ci_low", "ci_high", "d", "d_low", "d_high")], 2)

# Recenzent: „za mała próba” – analiza wrażliwości zamiast mocy post hoc
power.t.test(n = 5, sig.level = 0.05, power = 0.80)$delta          # najmniejsze d wykrywalne z mocą 80%
Wynik w konsoli R:
                  t     p p_holm
stres        -4.000 0.004  0.012
koncentracja  2.582 0.033  0.065
sen           1.000 0.347  0.347
             roznica ci_low ci_high     d d_low d_high
stres             -4  -6.31   -1.69 -2.53 -4.23  -0.75
koncentracja       2   0.21    3.79  1.63  0.13   3.07
sen                1  -1.31    3.31  0.63 -0.66   1.89
[1] 2.024438
Pierwsza tabela pokazuje, co zmienia poprawka: najmniejsze p mnożymy przez 3, drugie przez 2, a trzecie zostaje bez zmian, z zachowaniem kolejności (0,0039 · 3 = 0,012; 0,0325 · 2 = 0,065). Wzór krok po kroku znajdziesz w haśle poprawka Holma i FDR, a obliczenie przedziału – w haśle przedział ufności dla różnicy średnich.
Co zrobić, gdy po poprawce wynik przestał być istotny?
Napisz to wprost i zmień wnioski. Brak istotności po korekcie nie oznacza, że trening nie działa na koncentrację – oznacza, że te dane nie dają podstaw do odrzucenia hipotezy zerowej przy kontroli błędu dla trzech testów. Podaj różnicę z przedziałem ufności i wskaż, że potrzebne jest większe badanie. Jak opisać taki wynik bez tłumaczenia się, pokazujemy we wpisie hipotezy się nie potwierdziły. Jak liczyć i opisywać efekty, pokazujemy we wpisie wielkość efektu – jak liczyć i raportować.
Czy można nie zgodzić się z recenzentem?
Tak, jeśli masz argument. Przykład: recenzent prosi o moc obliczoną z uzyskanego efektu. Możesz grzecznie wyjaśnić, że taka moc nic nowego nie mówi, bo wynika z wartości p (Hoenig i Heisey, 2001), i w zamian podać analizę wrażliwości albo uzasadnienie liczebności (Lakens, 2022). Redaktor zwykle przyjmuje taką odpowiedź, gdy widzi, że problem potraktowano poważnie. Jak zaplanować liczebność od początku, opisujemy w poradniku o analizie mocy do grantu i artykułu.
Najczęstsze błędy w odpowiedziach na recenzję
- Odpowiedź „poprawiono” bez wskazania miejsca zmiany i bez nowego wyniku.
- Poprawka tylko dla części testów albo zmiana metody korekty, aż wynik się utrzyma.
- Moc post hoc jako argument, że „badanie miało wystarczającą moc”.
- Dopisanie wielkości efektu bez przedziału ufności.
- Pozostawienie języka przyczynowego w abstrakcie, choć poprawiono go w wynikach.
Bibliografia
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), 33267. https://doi.org/10.1525/collabra.33267
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikSekcja „Analiza statystyczna” w artykule – jak napisać
- PoradnikCommon method bias – jak sprawdzić i ograniczyć
- PoradnikWielkość efektu – jak liczyć i raportować
- Słownik wzorówPoprawki Holma i FDR
- PoradnikAnaliza mocy do grantu i artykułu
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.