

Analiza mocy do grantu i artykułu – przykład krok po kroku w R
Analiza mocy a priori odpowiada na pytanie, ile osób trzeba przebadać, żeby z dużym prawdopodobieństwem wykryć efekt, który naprawdę Cię interesuje. Ten wpis pokazuje cztery gotowe przykłady (test t, ANOVA, korelacja i regresja), podpowiada, skąd wziąć wielkość efektu, i daje akapit do wniosku grantowego.
W skrócieAnaliza mocy łączy cztery liczby: poziom istotności α, moc, wielkość efektu i liczebność. Trzy z nich ustalasz, czwartą liczysz. Najtrudniejsze jest uzasadnienie wielkości efektu: najlepiej oprzeć je na metaanalizie albo na najmniejszym efekcie, który ma znaczenie praktyczne. Proste plany liczysz wzorem, złożone – symulacją. Do wniosku dolicz zapas na osoby, które zrezygnują.
Krok 1. Cztery liczby analizy mocy
Moc to prawdopodobieństwo, że test odrzuci H0, gdy efekt o założonej wielkości naprawdę istnieje. Jest równa 1 − β, gdzie β to prawdopodobieństwo błędu II rodzaju. Standardowo przyjmuje się α = 0,05 (test dwustronny) i moc 0,80, a przy drogich lub ważnych badaniach moc 0,90. Wielkość efektu podajesz w miarach standaryzowanych, np. d Cohena, f Cohena albo r. Przegląd tych miar znajdziesz we wpisie wielkość efektu – jak liczyć i raportować.
Krok 2. Skąd wziąć wielkość efektu?
| Źródło | Kiedy dobre | Pułapka |
|---|---|---|
| Metaanaliza | Gdy istnieje dla Twojego pytania i populacji | Efekty w literaturze bywają zawyżone przez publikowanie tylko wyników istotnych; weź dolną granicę przedziału |
| Najmniejszy efekt istotny praktycznie (SESOI) | Gdy umiesz powiedzieć, jaka różnica ma znaczenie, np. 3 punkty w skali objawów | Trzeba to uzasadnić merytorycznie, a nie statystycznie |
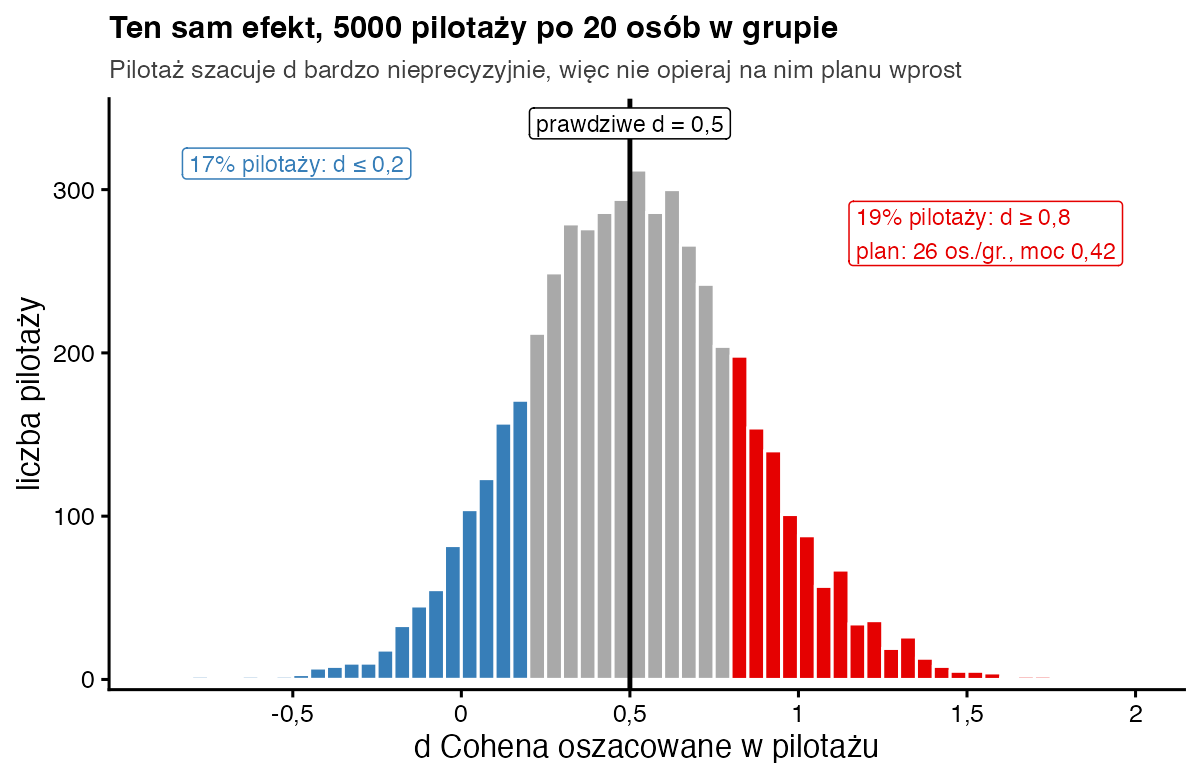
| Pilotaż | Do sprawdzenia procedury i rzetelności narzędzi | Oszacowanie efektu jest bardzo nieprecyzyjne (rys. 1) |
| Konwencja Cohena (0,2 / 0,5 / 0,8) | Tylko gdy brak innych źródeł | Recenzent zapyta, dlaczego „średni” efekt jest ważny w Twojej dziedzinie |
Problem pilotażu widać w symulacji. Prawdziwy efekt wynosi d = 0,5, a każdy pilotaż obejmuje 20 osób w grupie. W środkowych 95% pilotaży d wyszło od −0,12 do 1,20. Badacz, któremu wyszło d = 0,8, zaplanowałby 26 osób na grupę i uzyskał moc tylko 0,42. Dlatego pilotażu używaj do sprawdzenia procedury, a efekt bierz z literatury lub z SESOI (Albers i Lakens, 2018; Lakens, 2022).
Krok 3. Test t i ANOVA
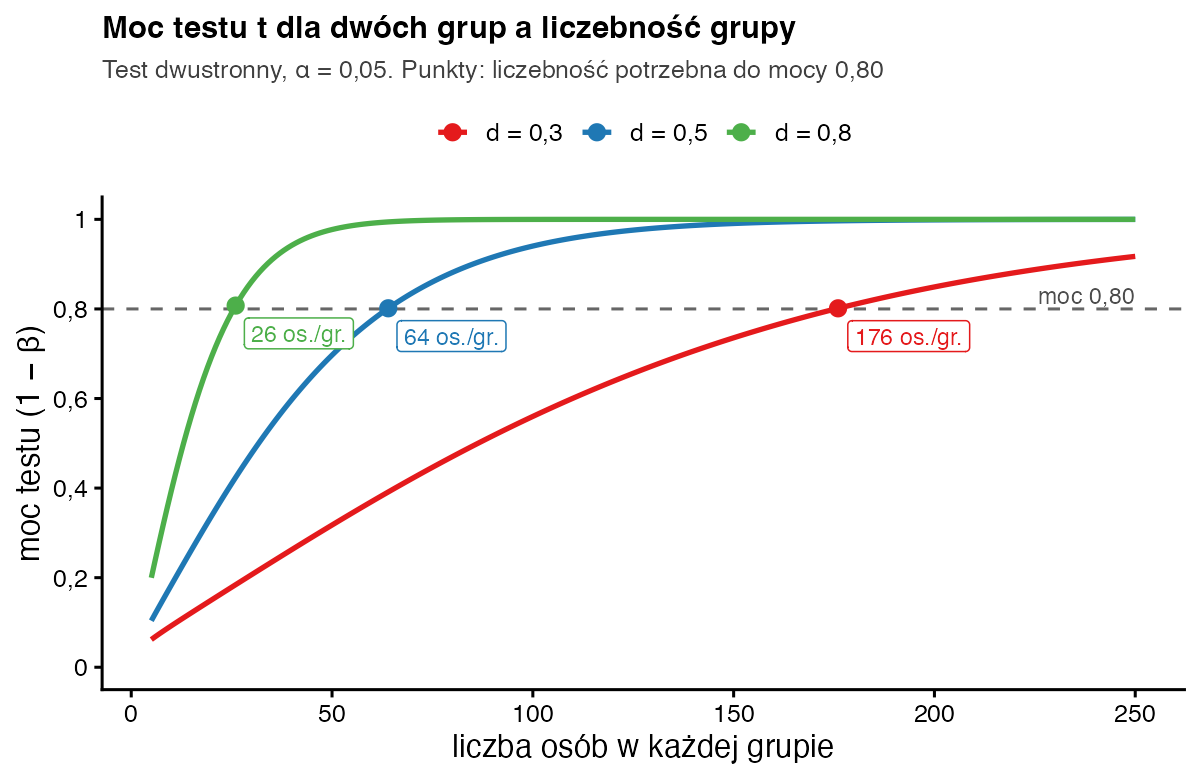
- Test t dla dwóch grup niezależnych, d = 0,5, α = 0,05, moc 0,80. Funkcja
power.t.testdaje 63,77, czyli w zaokrągleniu w górę 64 osoby na grupę (N = 128). Przebieg samego testu pokazujemy we wpisie test t Studenta – przykład. - Jednoczynnikowa ANOVA, 3 grupy, f = 0,25. Wartość f przeliczysz z η²: \( f = \sqrt{\eta^2 / (1 - \eta^2)} \), więc η² = 0,06 daje f = 0,25 (zobacz hasło cząstkowe η² i ω²). Wynik: 52,40, czyli 53 osoby na grupę (N = 159).
Krok 4. Korelacja: wzór przez z Fishera
Dla korelacji Pearsona przekształcamy r do skali z Fishera, w której rozkład jest prawie normalny (to samo przekształcenie służy do przedziału ufności dla korelacji):
Dla r = 0,3: mianownik to 0,31 (dokładniej 0,3095), licznik 1,96 + 0,84 = 2,80. Iloraz wynosi 9,05, jego kwadrat 81,9, a po dodaniu 3 otrzymujemy 84,9, czyli N = 85 osób.
Krok 5. Regresja: symulacja
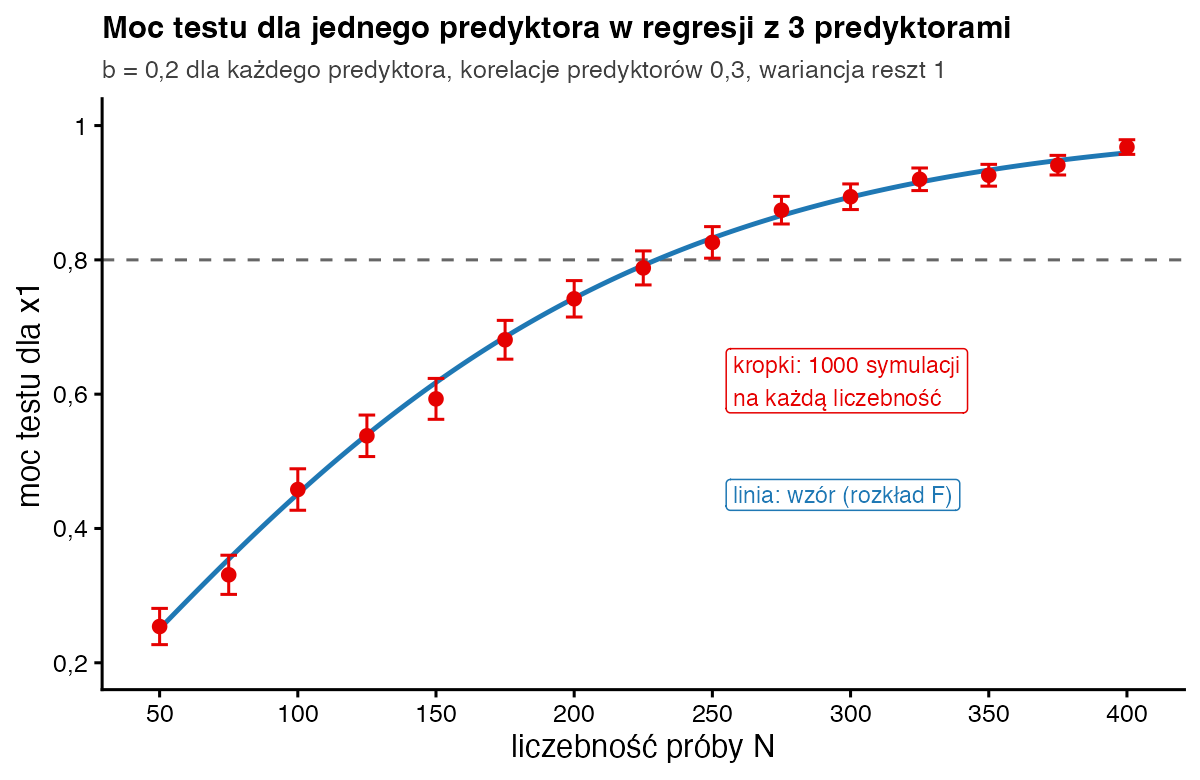
W regresji wielokrotnej moc testu dla jednego predyktora zależy od jego korelacji z pozostałymi. Najprościej ją policzyć symulacją: zakładasz model, losujesz 1000 zbiorów danych o liczebności N, w każdym liczysz regresję i sprawdzasz, jaki odsetek testów dla x1 jest istotny. Ten odsetek to moc. Założenia: trzy standaryzowane predyktory skorelowane r = 0,3, każdy ze współczynnikiem b = 0,2, wariancja reszt 1 (model wyjaśnia wtedy 16% wariancji). Przy N = 250 symulacja daje moc 0,82, a wzór oparty na rozkładzie F – 0,83. Próg 0,80 wzór przekracza przy N = 230, więc N = 250 daje niewielki zapas. Tak samo planuje się liczebność do mediacji z bootstrapem czy modeli wielopoziomowych.
Krok 6. Zapis do wniosku i do artykułu
| Analiza | Założony efekt | Wymagana liczebność | Rekrutacja |
|---|---|---|---|
| Test t, 2 grupy | d = 0,5 | 64 na grupę (N = 128) | 72 na grupę (N = 144) |
| ANOVA, 3 grupy | f = 0,25 | 53 na grupę (N = 159) | 59 na grupę (N = 177) |
| Korelacja Pearsona | r = 0,3 | N = 85 | N = 95 |
| Regresja, 3 predyktory | b = 0,2 dla x1 | N = 250 (symulacja) | N = 278 |
Gotowy akapit: Liczebność próby zaplanowano a priori dla głównej hipotezy (porównanie dwóch grup testem t). Przyjęto dwustronny poziom istotności α = 0,05 i moc 0,80. Jako najmniejszy efekt istotny praktycznie przyjęto d = 0,5, co odpowiada różnicy 5 punktów w skali o odchyleniu standardowym 10 [tu uzasadnienie merytoryczne lub dolna granica efektu z metaanalizy]. Obliczenia wykonano w R (funkcja power.t.test) i wskazały 64 osoby na grupę. Zakładając 10% utraty uczestników, planujemy rekrutację 72 osób na grupę (N = 144).
W artykule ten sam akapit trafia do opisu metody – zobacz wpis sekcja „Analiza statystyczna” w artykule. Standardy JARS wymagają, by uzasadnienie liczebności było częścią raportu (Appelbaum i in., 2018).
Cała analiza w R
# 1) test t dla dwóch grup niezależnych: d = 0,5; alfa = 0,05; moc = 0,80
c(t_n_na_grupe = power.t.test(delta = 0.5, sd = 1, sig.level = 0.05, power = 0.80)$n)

# 2) jednoczynnikowa ANOVA, 3 grupy, f Cohena = 0,25
#    between.var to wariancja średnich grup (dzielnik k - 1), stąd przeliczenie
f <- 0.25; k <- 3
c(anova_n_na_grupe = power.anova.test(groups = k, between.var = f^2 * k / (k - 1),
                                      within.var = 1, power = 0.80)$n)

# 3) korelacja Pearsona r = 0,3 – przybliżenie przez z Fishera
r <- 0.3
c(korelacja_N = ((qnorm(0.975) + qnorm(0.80)) / atanh(r))^2 + 3)

# 4) regresja z 3 predyktorami – symulacja mocy testu dla x1
library(MASS)
S <- matrix(0.3, 3, 3); diag(S) <- 1        # predyktory skorelowane r = 0,3
moc_regresji <- function(n, b = c(0.2, 0.2, 0.2), R = 1000) {
  istotne <- replicate(R, {
    X <- mvrnorm(n, mu = rep(0, 3), Sigma = S)
    y <- X %*% b + rnorm(n)                  # reszty o wariancji 1
    summary(lm(y ~ X))$coefficients[2, 4] < 0.05
  })
  mean(istotne)                              # odsetek istotnych wyników = moc
}
set.seed(2026)
n <- c(150, 200, 250, 300)
setNames(sapply(n, moc_regresji), paste0("N=", n))

# 5) zapas na utratę 10% osób w teście t
c(rekrutacja_na_grupe = ceiling(64 / 0.9))
Wynik w konsoli R:
t_n_na_grupe
    63.76576
anova_n_na_grupe
         52.3966
korelacja_N
   84.92781
N=150 N=200 N=250 N=300
0.622 0.730 0.815 0.889
rekrutacja_na_grupe
                 72
Checklista analizy mocy
- Analiza dotyczy głównej hipotezy, a test jest ten sam, który wykonasz później.
- Wielkość efektu ma źródło: metaanaliza, SESOI albo uzasadniona konwencja.
- Podane α, moc, strona testu, program i funkcja.
- Liczebność zaokrąglona w górę i powiększona o zapas na utratę osób.
- Przy porównaniach wielokrotnych α skorygowane tak samo jak w analizie.
Pytania recenzentów
Czy mogę policzyć moc po badaniu?
Moc „obserwowana”, liczona z efektu uzyskanego w badaniu, jest prostą funkcją wartości p i nic nie dodaje do interpretacji (Hoenig i Heisey, 2001). Po badaniu podaj wielkość efektu z przedziałem ufności. Gdy wynik jest nieistotny, pomoże wpis hipotezy się nie potwierdziły.
Mam dostęp tylko do 40 osób na grupę. Co wtedy?
Zrób analizę wrażliwości: policz, jaki najmniejszy efekt wykryjesz z mocą 0,80. Dla 40 osób na grupę to d = 0,63. We wniosku napisz wprost, że mniejszych efektów badanie nie wykryje wiarygodnie.
Mam kilka hipotez. Którą wziąć do analizy mocy?
Policz liczebność dla każdej hipotezy głównej i przyjmij największą. Zwykle decyduje ta z najmniejszym spodziewanym efektem albo ta, która wymaga porównania podgrup. Jeśli w analizie poprawiasz α na wielokrotne porównania, użyj tej samej poprawionej wartości w analizie mocy. Hipotezy poboczne opisz jako eksploracyjne.
Moc 0,80 czy 0,90?
Wartość 0,80 to umowne minimum. Przy mocy 0,80 jedno na pięć badań prawdziwego efektu go nie wykryje. Jeśli wynik ma rozstrzygać o dalszym finansowaniu albo o wdrożeniu, przyjmij 0,90; dla d = 0,5 to 86 zamiast 64 osób na grupę.
Czym to się różni od liczenia próby do ankiety?
Analiza mocy dotyczy testowania hipotez. Gdy chcesz oszacować odsetek z zadaną dokładnością, liczysz margines błędu i liczebność próby. Wersję dla studentów opisujemy we wpisie ile osób przebadać do pracy magisterskiej.
Bibliografia
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), 33267. https://doi.org/10.1525/collabra.33267
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówBłąd II rodzaju (β) i moc testu
- PoradnikIle osób przebadać do pracy magisterskiej?
- Słownik wzorówd Cohena – wielkość efektu
- Słownik wzorówMargines błędu i liczebność próby
- PoradnikSekcja „Analiza statystyczna” w artykule – jak napisać
- Przykładowy raportTest t Studenta
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.