

Hipotezy się nie potwierdziły – co napisać w wynikach i dyskusji
Wynik nieistotny statystycznie to zwykły wynik badania, a nie błąd w pracy. Typowe pytanie z pracy dyplomowej: co napisać, gdy test wyszedł nieistotny, i jak to uczciwie opisać w wynikach i dyskusji?
W prostych słowachPromotor i recenzent oceniają, czy badanie jest dobrze zaplanowane i rzetelnie opisane, a nie czy „wyszło”. Nieistotny wynik opisujesz tak samo starannie jak istotny: statystyka, p, wielkość efektu i przedział ufności. Nie piszesz, że „różnic nie ma”, tylko że dane nie dały podstaw do takiego wniosku – i pokazujesz, jak duży efekt mógł się ukryć w Twojej próbie.
Przykład: Notatki czy Quizy?
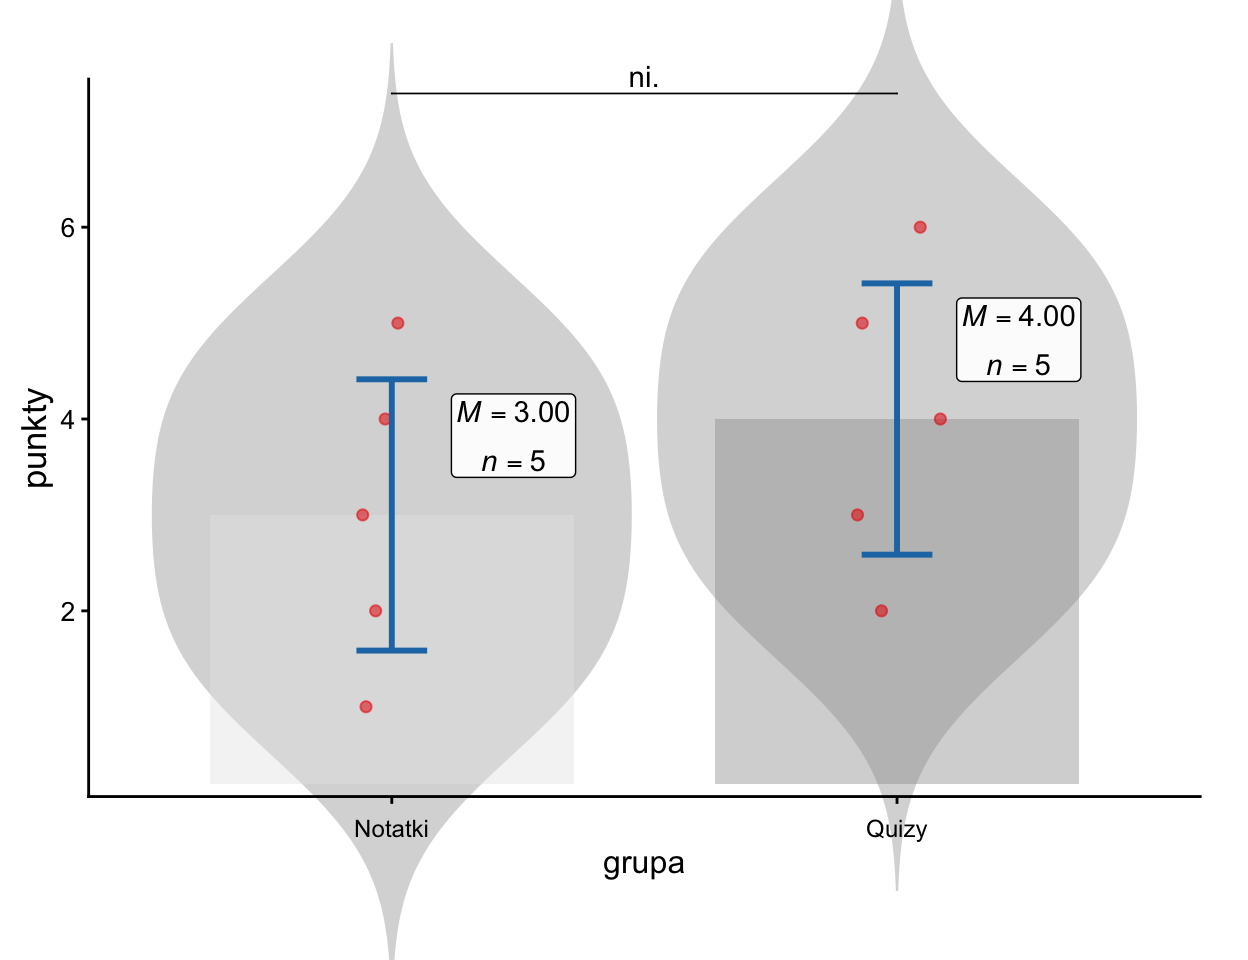
Student porównał punkty z kolokwium w dwóch grupach po 5 osób: jedna powtarzała materiał z notatek, druga rozwiązywała quizy. Hipoteza: quizy dają lepszy wynik. To ten sam układ co we wpisie test t Studenta – przykład, ale tym razem różnica średnich jest mniejsza (1 punkt zamiast 3).
| Grupa | Punkty | n | M | SD |
|---|---|---|---|---|
| Notatki | 1, 2, 3, 4, 5 | 5 | 3,00 | 1,58 |
| Quizy | 2, 3, 4, 5, 6 | 5 | 4,00 | 1,58 |
| Różnica | Quizy − Notatki | 10 | 1,00 | 95% CI [−1,31; 3,31] |
Test t Studenta daje t(8) = 1,00; p = 0,347; d = 0,63. Wynik jest nieistotny. Jednocześnie d Cohena = 0,63 to według umownych progów Cohena (1988) efekt średni. Oba fakty są prawdziwe naraz – i oba trzeba opisać.
Co napisać w rozdziale wyników
Zasada jest prosta: ten sam komplet liczb co przy wyniku istotnym (American Psychological Association, 2020) i jedno zdanie decyzji, sformułowane ostrożnie.
Gotowe zdanie: Osoby rozwiązujące quizy (M = 4,00; SD = 1,58) uzyskały średnio o 1 punkt więcej niż osoby powtarzające z notatek (M = 3,00; SD = 1,58), jednak różnica nie była istotna statystycznie, t(8) = 1,00; p = 0,347; d = 0,63; 95% CI dla różnicy [−1,31; 3,31]. Brak zatem podstaw do odrzucenia hipotezy zerowej; hipoteza 1 nie znalazła potwierdzenia.
| Zamiast | Napisz |
|---|---|
| „Przyjęto hipotezę zerową” | „Brak podstaw do odrzucenia hipotezy zerowej” |
| „Grupy się nie różnią” | „Nie stwierdzono istotnej statystycznie różnicy” |
| „Wynik prawie istotny (trend)” | Podaj dokładne p i wielkość efektu, bez etykiet |
| „Hipoteza została obalona” | „Hipoteza nie znalazła potwierdzenia w danych” |
Przedział ufności i wielkość efektu zamiast „brak różnic”
Wartość p mówi tylko, jak zaskakujący byłby taki wynik, gdyby prawdziwa różnica wynosiła zero. Nie mówi, że różnica wynosi zero. Brak dowodu na efekt nie jest dowodem jego braku (Altman i Bland, 1995). Więcej mówi przedział ufności dla różnicy średnich: od −1,31 do 3,31 punktu. Dane są więc zgodne zarówno z niewielką przewagą notatek, jak i z ponad trzypunktową przewagą quizów. Uczciwy wniosek brzmi: „badanie było za małe, żeby to rozstrzygnąć” (Cumming, 2014).
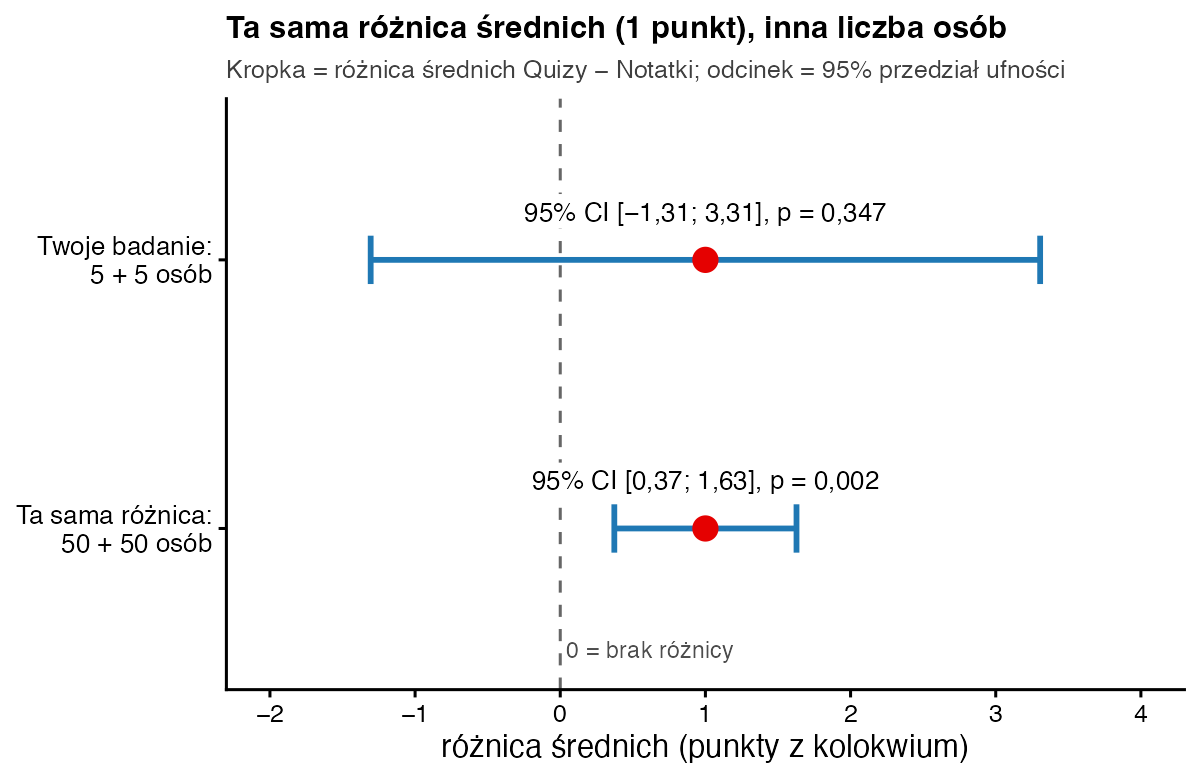
Jeśli naprawdę chcesz wykazać, że różnicy praktycznie nie ma, potrzebny jest osobny test równoważności z z góry ustaloną najmniejszą ważną różnicą (Lakens, 2017). Zwykły test t tego nie pokaże. Więcej o raportowaniu efektów znajdziesz we wpisie wielkość efektu – jak liczyć i raportować.
Moc testu post hoc – dlaczego nie
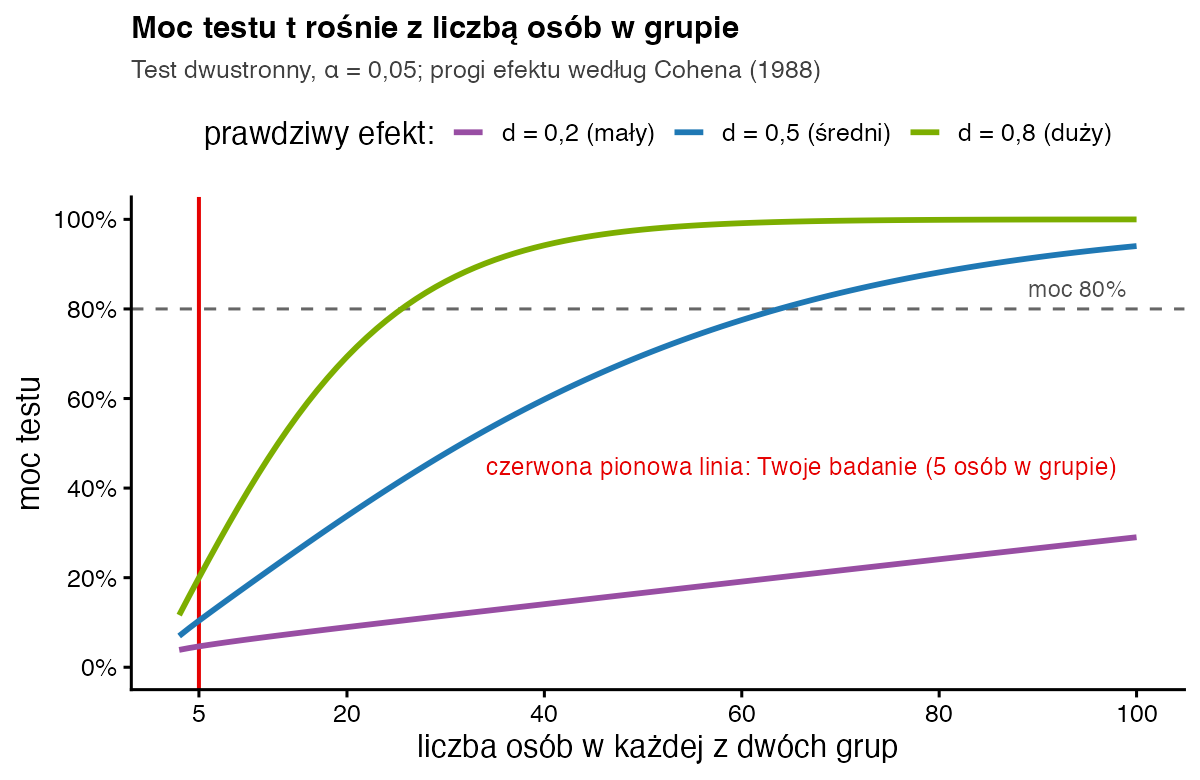
Wielu studentów słyszy: „policz moc obserwowaną”. W naszym przykładzie wyszłaby około 14%. Problem w tym, że taka moc to tylko inaczej przeliczona wartość p: nieistotny wynik zawsze da niską moc obserwowaną, więc nie dowiesz się niczego nowego (Hoenig i Heisey, 2001). Zamiast tego zrób jedną z dwóch rzeczy, o których piszemy w haśle błąd II rodzaju i moc testu:
- Analiza wrażliwości. Przy 5 osobach w grupie test miał 80% szans wykryć dopiero efekt d = 2,02 – czyli bardzo duży.
- Planowana liczebność. Do wykrycia efektu średniego (d = 0,5) z mocą 80% potrzeba 64 osób w każdej grupie. To konkretna wskazówka dla przyszłych badań – szerzej opisujemy to we wpisie ile osób przebadać do pracy magisterskiej.
Co napisać w dyskusji
- Przypomnij hipotezę i wynik jednym zdaniem, bez liczb z testu.
- Oceń wielkość efektu i jej niepewność: kierunek zgodny z hipotezą, efekt średni, szeroki przedział ufności.
- Porównaj z literaturą: czy inni autorzy uzyskali podobny kierunek efektu, na większych próbach?
- Podaj możliwe wyjaśnienia: mała próba, mało rzetelny pomiar, krótki czas interwencji, specyficzna grupa badanych, a dopiero na końcu – teoria.
- Opisz ograniczenia i rekomendacje: ile osób warto przebadać następnym razem i co zmienić w procedurze.
Gotowe zdania do dyskusji: Wbrew hipotezie 1 nie stwierdzono istotnej różnicy między grupami. Kierunek różnicy był jednak zgodny z oczekiwaniami, a jej wielkość odpowiadała efektowi średniemu. Szeroki przedział ufności wskazuje, że przy 5 osobach w grupie badanie mogło nie wykryć nawet umiarkowanej przewagi quizów. Wniosek o braku różnicy byłby więc nieuprawniony; rozstrzygnięcie wymaga badania na większej próbie (ok. 64 osób w grupie).
Pełny schemat dyskusji znajdziesz w poradniku dyskusja wyników w pracy magisterskiej, a zasady formułowania i testowania hipotez – w tekście weryfikacja hipotez w pracy magisterskiej.
Jak policzyć przedział ufności, efekt i analizę wrażliwości w R?
# Dane: punkty z kolokwium w dwóch grupach (po 5 osób)
notatki <- c(1, 2, 3, 4, 5)
quizy   <- c(2, 3, 4, 5, 6)

# 1) Test t Studenta: statystyka, p i 95% przedział ufności dla różnicy średnich
wynik <- t.test(quizy, notatki, var.equal = TRUE)
round(c(roznica = mean(quizy) - mean(notatki), t = unname(wynik$statistic),
        df = unname(wynik$parameter), p = wynik$p.value), 3)
round(as.vector(wynik$conf.int), 2)

# 2) Wielkość efektu d Cohena z 95% przedziałem ufności
d <- effectsize::cohens_d(quizy, notatki)
round(unlist(d[c("Cohens_d", "CI_low", "CI_high")]), 2)

# 3) Zamiast „mocy post hoc”: jaki efekt ten układ (5 + 5 osób)
#    wykryłby z mocą 80%? (analiza wrażliwości)
round(power.t.test(n = 5, power = 0.80, sd = 1)$delta, 2)

# 4) Ile osób w grupie trzeba, by wykryć d = 0,5 z mocą 80%?
ceiling(power.t.test(delta = 0.5, power = 0.80, sd = 1)$n)
Wynik w konsoli R:
roznica       t      df       p
  1.000   1.000   8.000   0.347
[1] -1.31  3.31
Cohens_d   CI_low  CI_high
    0.63    -0.66     1.89
[1] 2.02
[1] 64
Funkcja power.t.test z parametrem sd = 1 podaje efekt w jednostkach odchylenia standardowego, czyli wprost d Cohena.
Checklista: nieistotny wynik w pracy
- Podałeś statystykę testu, stopnie swobody, dokładne p, wielkość efektu i przedział ufności.
- Nigdzie nie ma zdań „przyjęto H0” ani „grupy się nie różnią”.
- Hipotezy są w pierwotnym brzmieniu – nie zmieniłeś ich po zobaczeniu wyników.
- Zamiast mocy obserwowanej podałeś analizę wrażliwości albo potrzebną liczebność.
- W dyskusji są wyjaśnienia, ograniczenia i konkretne rekomendacje.
Pytania, które zadają studenci
Czy promotor obniży ocenę, bo hipotezy się nie potwierdziły?
Nie powinien, bo ocenia się metodę i sposób opisu, a nie kierunek wyniku. Słabo wypada dopiero praca, w której nieistotny wynik jest ukryty, przemilczany albo „naciągnięty”.
Czy mogę zmienić hipotezę, żeby pasowała do wyników?
Nie. Dopisywanie hipotez po fakcie zniekształca wnioski. Zostaw pierwotne hipotezy, a nowe obserwacje opisz w osobnym podrozdziale jako analizy eksploracyjne.
Czy mogę dobrać jeszcze kilka osób, aż wyjdzie istotnie?
Dobieranie osób „do skutku” i ponowne testowanie zawyża ryzyko fałszywego alarmu (Simmons i in., 2011). Jeśli zbierasz dodatkowe dane, zaplanuj docelową liczebność z góry i napisz o tym w metodzie.
Bibliografia
- Altman, D. G., & Bland, J. M. (1995). Absence of evidence is not evidence of absence. BMJ, 311(7003), 485. https://doi.org/10.1136/bmj.311.7003.485
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- Słownik wzorówBłąd II rodzaju (β) i moc testu
- PoradnikDyskusja wyników w pracy magisterskiej
- Słownik wzorówPrzedział ufności dla różnicy średnich
- PoradnikAnaliza statystyczna w pracy magisterskiej krok po kroku
- Przykładowy raportCase study: praca magisterska z psychologii w SZTOS
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.